Redes autónomas#
Para ahorrar, la CDN incorporó un optimizador de tráfico que decidía cuántos usuarios debían llegar a un PoP a través de cada uno de sus ISP. Los circuitos de los ISP tenían costes distintos (algunos podían costar alrededor de un 30 % menos que otros) y, en ciertos periodos, la red funcionaba muy por debajo de su capacidad. El optimizador recalculaba el reparto de usuarios entre los ISP y desplazaba al mayor número posible hacia los proveedores más baratos si la ruta ofrecía un rendimiento suficiente. Funcionó bastante bien y bajó la factura de tránsito.
Una noche, el optimizador desvió todo el tráfico (todo el conjunto de prefijos cdn-eu) al ISP más barato del PoP de Fráncfort. A las 03:00, el ISP parecía una buena opción: la carga era baja y la latencia estaba por debajo del umbral. Según el objetivo del optimizador (minimizar el coste siempre que la ruta ofreciera un rendimiento suficiente), era la decisión óptima.
Pero la ruta que parecía buena a las 03:00 ya no lo era a las 09:00, cuando aumentó el tráfico. Con esa carga, la latencia del ISP barato empezó a fluctuar: la media era aceptable, pero el percentil 95, que es la métrica que le importa a un servicio de distribución de contenidos, era pésimo. El p95 del tiempo hasta el primer byte pasó de 40 a 90 milisegundos y se mantuvo ahí porque el optimizador no tenía ningún motivo para devolver a los usuarios a los otros ISP. Hizo lo que se le había indicado, pero las indicaciones eran incompletas: el margen admisible de variación de la latencia no figuraba entre las restricciones y nadie había simulado el plan con carga punta.
El optimizador funcionó correctamente, pero le faltaba una visión completa de la situación porque nadie la había definido. Los fallos de automatización que más miedo dan son los que se producen al tomar la decisión óptima, porque el sistema se comporta tal como se esperaba, pero la calidad de cualquier decisión depende de la información en la que se basa.
Este capítulo complementa los bucles desarrollados en la parte 5. Sobre los bucles deterministas anteriores (que siguen las reglas tal como las escribió una persona), añade cierta autonomía para elegir el plan adecuado mediante una capa de decisión con una arquitectura agéntica: los agentes se coordinan para resolver problemas de red como lo haría un equipo de ingeniería de redes. Así se completa la orquestación agéntica presentada en la sección Orquestación agéntica del capítulo 8.
Es un escenario apasionante que hoy evoluciona constantemente. En lugar de ofrecerte una guía de implementación (encontrarás referencias para ello al final del capítulo), este capítulo te ofrece un modelo mental para abordarlo y empezar a aprovechar el potencial de las redes autónomas.
Del bucle fijo a la decisión#
En todos los peldaños anteriores, una persona definía las acciones del bucle. Quien diseñaba el bucle decidía que había que conciliar una configuración que se hubiera desviado o retirar el tráfico de un ISP cuando su degradación superara un umbral. La máquina ejecutaba fielmente esas decisiones, que es para lo que sirve la automatización. En este peldaño, la persona deja de definir las acciones y pasa a definir los límites: las restricciones que el sistema nunca debe infringir y los objetivos que debe perseguir dentro de esos límites. El sistema elige la acción.
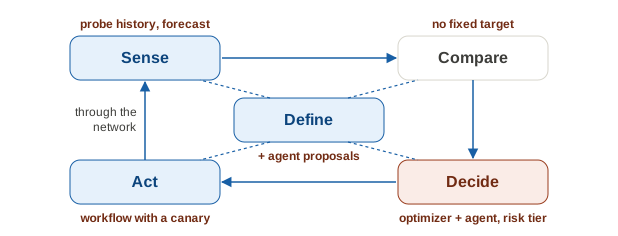
De las cinco etapas del capítulo 16, el cambio afecta sobre todo a una, Decidir, como muestra la Figura 18.1. La etapa Percibir consulta ahora el historial de las sondas y una previsión elaborada a partir de él. La etapa Comparar carece de una referencia fija porque no hay un único estado correcto con el que comparar, solo planes mejores y peores. En Decidir se concentra el trabajo nuevo: un optimizador y un agente de IA eligen un plan, y el nivel de riesgo determina si puede seguir adelante. Actuar sigue siendo el flujo de trabajo de cambio de siempre, que ahora empieza con un despliegue canario.
Es un cambio de fondo que modifica lo que puede salir mal. Puedes enumerar las formas en que falla un bucle determinista: revierte un cambio que debía mantener o retira y restablece repetidamente el tráfico de un ISP que funciona al límite. Una capa de decisión falla de formas que no habías previsto, porque su propósito es precisamente gestionar casos que no has programado de antemano. La falta de determinismo es el precio de esa generalidad y explica por qué los límites de la sección Qué puede decidir por sí solo son el tema central del capítulo.
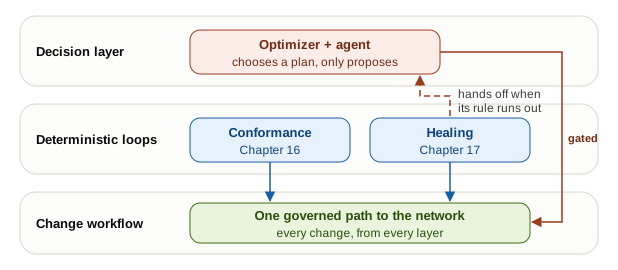
La disposición de las capas importa: la autonomía se apoya en los bucles fijos sin sustituirlos. Cuando la situación encaje en una regla determinista, úsala: se puede probar y explicar, es rápida y cuesta poco aplicarla. Se invoca al agente en los casos para los que no hay ninguna regla, y ni siquiera entonces actúa directamente. El agente hace una propuesta, que se somete a simulación y debe superar unos controles. Solo entonces se convierte en un cambio y pasa por el mismo flujo de trabajo de cambio que el de una persona.
Es fácil pasar por alto dos consecuencias de esta disposición en capas, y ambas importan en la operación de la red:
- Algo tiene que activar al agente, y esa activación también está sujeta a reglas. El bucle de autorrecuperación del capítulo 17 delega en el agente cuando su regla binaria ya no basta. Ocurre cuando el bucle quiere retirar el tráfico de un ISP, pero el nivel mínimo de servicio o la comprobación de capacidad se lo impiden: hay que sopesar objetivos contrapuestos y ningún umbral permite resolver la situación. También ocurre cuando se abre una ventana de optimización programada. El agente no recorre la red en busca de mejoras. Se le invoca para resolver una cuestión acotada.
- Como la autonomía ocupa la capa superior, un fallo en esa capa no interrumpe el servicio. Si el agente o el optimizador no están disponibles, los bucles deterministas siguen ejecutando el último plan aprobado: la red sigue ajustándose al estado previsto y recuperándose de los fallos. Solo deja de optimizarse hasta que la capa vuelve a estar disponible. Diseñar la autonomía como una extensión permite obtener esa degradación controlada sin trabajo adicional.
Los bucles de decisión son menos exóticos de lo que sugiere la palabra «autónomo», y puede que ya utilices alguno. Los controladores de redes inalámbricas reajustan por sí solos los canales y la potencia de transmisión (gestión de recursos radioeléctricos). Los controladores SD-WAN eligen una ruta para cada aplicación. En ambos casos, el fabricante ha creado un bucle de decisión que abarca un solo dominio. Merece la pena construir la capa de decisión de la plataforma de automatización de redes (NAP) cuando la decisión abarca varios dominios o fabricantes, o cuando te corresponde definir el objetivo, como ocurre con el coste en función de tus propios compromisos de tráfico contratado.
La Figura 18.2 muestra las tres capas: arriba, la capa de decisión; debajo, los bucles deterministas y, en la base, una única vía de acceso a la red sujeta a controles.
La capa de decisión contiene dos componentes muy distintos que examino por separado en la siguiente sección.
El modelo de dos componentes#
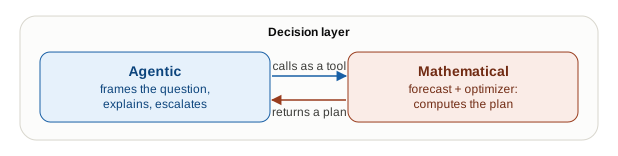
«La IA decide» no es una arquitectura. Toda decisión que requiere un plan en lugar de una regla se descompone en dos componentes muy distintos, con propiedades y riesgos diferentes. Uno calcula: pronostica qué ocurrirá y busca el mejor plan que cumpla las restricciones. El otro razona: decide qué pregunta plantear, qué restricciones se aplican hoy y si cabe fiarse de la respuesta. La Figura 18.3 muestra estos dos componentes en el interior de la capa de decisión de la Figura 18.2.
En la red de distribución de contenidos, los dos componentes funcionan así:
Matemático: pronostica el rendimiento de cada ISP a partir del historial de monitorización sintética recopilado en el capítulo 17 y resuelve un problema de optimización. Reparte a los usuarios de cada conjunto de prefijos entre los ISP disponibles para minimizar el coste, respetando el nivel mínimo de servicio, las tolerancias del objetivo de nivel de servicio (SLO) del consumidor y la capacidad de cada ISP. Aquí se hacen los cálculos en los que se basa la decisión. Es el componente más fiable de los dos porque está sujeto a restricciones y se puede probar. Puedes ejecutarlo con datos históricos reservados para pruebas y comprobar sus planes. Se parece más a un optimizador que trabaja con una previsión que a algo misterioso.
Agéntico: es la capa de razonamiento de la sección Orquestación agéntica del capítulo 8. Se basa en un Modelo de lenguaje de gran tamaño (LLM) y su función no es hacer los cálculos, sino dirigir el proceso de decisión. Formula el problema y obtiene el estado deseado de la Fuente de Verdad (SoT) y los datos operativos de Observabilidad. Decide qué restricciones se aplican en ese momento e invoca al optimizador como herramienta. Después interpreta el resultado, lo explica y lo somete a las salvaguardas. Se ocupa de las cuestiones confusas o mal definidas que un solucionador matemático no puede resolver: ¿tiene siquiera sentido optimizar en esta situación o conviene escalar el caso?
En el problema que resuelve el componente matemático hay una sola magnitud que minimizar. Todo lo demás son restricciones:
minimize   total_cost = sum over isp of bill(isp)

  bill(isp) = commit_price[isp]
            + overage_price[isp] x max(0, forecast_p95_load[isp] - commit_gbps[isp])

subject to:
  reachability:  users of a prefix ride only ISPs that carry that prefix
  floor:         active_isps(prefix) >= min_service_isps(prefix)
  capacity:      load(isp) <= capacity_gbps[isp] x safe_utilization
  performance:   forecast_p95_latency(prefix, isp) <= tolerance(prefix)
stability: apply a plan only when its cost gain clears a set marginEl coste es la única magnitud que se minimiza. La alcanzabilidad, el nivel mínimo de servicio, la capacidad y el rendimiento son restricciones de obligado cumplimiento: o se cumplen o no hay plan. La sección Qué puede decidir por sí solo convierte esa distinción en la salvaguarda central del capítulo. La otra mitad del componente matemático son los dos términos de la previsión, que se aprenden del historial de monitorización sintética. La fiabilidad del optimizador depende de la fiabilidad de esa previsión. Por eso, en la sección Aprender durante el funcionamiento se entrena el modelo de previsión con resultados medidos, y por eso las salvaguardas exigen siempre un despliegue canario antes de aplicar el plan del optimizador a toda la red.
Para calcular el coste no basta con multiplicar el tráfico por un precio. El tránsito suele facturarse según el percentil 95: el proveedor toma una muestra de tu tráfico cada cinco minutos durante un mes, descarta el 5 % de las muestras con valores más altos y usa el mayor valor restante para calcular la factura según el caudal contratado. Por eso, el optimizador trabaja con la previsión del percentil 95 mensual de cada ISP.
De ahí se derivan dos consecuencias. Las ráfagas breves que quedan dentro de ese 5 % superior no suponen ningún coste adicional, mientras que desviar tráfico de forma sostenida a un ISP barato puede elevar su percentil 95 por encima del caudal contratado y anular el ahorro. Con un par con el que intercambias tráfico sin pagos entre las partes ocurre lo contrario: el coste por bit es cero hasta que se satura el enlace.
Las matemáticas son conocidas. Es un problema de programación lineal, o de programación lineal entera mixta cuando el plan debe elegir ISP completos, y los solucionadores de código abierto como Google OR-Tools o PuLP pueden resolverlo a esta escala. La previsión también emplea aprendizaje automático, aunque de un tipo distinto al de los modelos de lenguaje que veremos más adelante en este capítulo: aprende patrones a partir de números en vez de palabras. Antes de intentar algo más ambicioso, puedes empezar con un modelo de series temporales con estacionalidad, creado con una biblioteca como Prophet, de Meta, y entrenado con el historial de las sondas.
Los proveedores de servicios resuelven a diario un problema parecido con un elemento de cálculo de rutas (PCE) que programa rutas de Segment Routing o RSVP-TE a través de su propia red troncal. La arquitectura es la misma: un solucionador que opera con restricciones, recibe mediciones y actúa a través de un controlador. Lo que cambia es el ámbito. Un PCE dirige el tráfico dentro de una red que controlas. En este capítulo lo dirigimos a través de redes de ISP que no controlas.
Y la variante para el borde de Internet ya se ha utilizado en producción a gran escala. Edge Fabric, de Facebook, y Espresso, de Google, figuran en las referencias de este capítulo. Ambos eligen por dónde dar salida al tráfico entre miles de pares y enlaces de tránsito en función del rendimiento medido, y ambos separan la decisión de los mecanismos de Border Gateway Protocol (BGP), como hacemos en este capítulo.
Mantener ambos componentes separados es una propiedad de seguridad (no una forma de simplificar el diagrama). Los números proceden del optimizador, que es determinista y auditable. El agente decide cuándo ejecutarlo y si se fía del resultado. Las restricciones de obligado cumplimiento las lee el optimizador de la intención, así que un agente que olvide el presupuesto de variación del retardo no puede eliminarlo. Los controles de la sección Qué puede decidir por sí solo delimitan el margen de decisión del agente. Así aprovechas la versatilidad de un agente sin hacer depender una decisión de encaminamiento de una inferencia sin explicar, porque el agente no puede inventarse las matemáticas del encaminamiento.
Vista así, la historia inicial se entiende de otra manera. El problema no fue que la inteligencia artificial (IA) actuara por su cuenta. Al optimizador se le dio un objetivo incompleto, el coste sin ninguna restricción sobre la variación del retardo, y la capa de decisión carecía de un control que exigiera una simulación. La solución afecta a ambos componentes: codifica el presupuesto de variación del retardo como una restricción que el optimizador deba cumplir y exige al agente que simule el cambio antes de proponerlo.
La misma división del trabajo sirve en entornos muy distintos de una red de contenidos. En una red de campus, la actualización de firmware de los 800 conmutadores del capítulo 12 necesita un plan por tandas. Un planificador, el componente matemático, agrupa los conmutadores en tandas según las reglas del libro: los edificios se abordan en secuencia y se empieza con un solo conmutador (capítulo 8), los dos miembros de un par redundante nunca entran en la misma tanda (capítulo 11) y cada tanda debe completarse dentro de la ventana de mantenimiento (capítulo 6).
Un agente define el alcance de la ejecución: consulta el calendario de cambios y las incidencias abiertas, decide qué edificios dejar para más adelante y explica el plan a quien debe aprobarlo en el equipo de ingeniería. En un centro de datos, un agente de capacidad consulta las tendencias de utilización, solicita una previsión y propone en qué pods hacen falta nuevos enlaces ascendentes antes del próximo trimestre, de nuevo para que una persona lo apruebe. En ambos casos, el solucionador se encarga de los cálculos y el agente delimita el problema y explica el plan.
La parte matemática es terreno conocido en ingeniería. La mayoría de las preguntas nuevas se plantean en la parte que corresponde a los agentes, y en la siguiente sección vamos a construirla.
Cómo construir la capa de agentes#
El modelo de dos componentes establece qué contiene la capa de decisión. Esta sección explica cómo construir la parte que corresponde a los agentes y responde, por orden, a cuatro preguntas: cómo colaboran varios agentes, dónde se ejecutan, qué modelo utilizan y cuánto cuesta ejecutarlo, y si los agentes aprenden. Cada respuesta se apoya en un bloque o en un patrón que ya hemos visto en el libro, porque un agente es un consumidor más de la NAP y no un nuevo tipo de plataforma.
Cómo colaboran los agentes#
Empieza con un solo agente. Un equipo pequeño suele empezar con una persona que hace un poco de todo, y vas incorporando a otras cuando el trabajo exige competencias distintas, un reparto diferente de responsabilidades u otra perspectiva. Con los agentes ocurre lo mismo. Un solo agente, con el optimizador y las herramientas de la NAP, puede encargarse de todo el proceso de decisión, y cada agente que añades aumenta el coste, la latencia y las posibilidades de fallo. Divide el trabajo solo cuando las funciones requieran herramientas distintas, privilegios distintos o una segunda opinión.
En la red de contenidos, el proceso de decisión se ejecuta una vez cada noche, en la franja de menor tráfico: vuelve a planificar cómo repartirá cada punto de presencia a sus usuarios entre sus ISP durante el día siguiente. En esta ejecución se dan los tres motivos para dividir el trabajo e intervienen tres agentes con funciones distintas:
- El planificador plantea la pregunta, consulta la intención efectiva y la previsión de cada ISP, ejecuta el optimizador y propone un plan. Es el único autorizado a presentar una propuesta.
- El analista de capacidad consulta los datos de utilización y la matriz de tráfico que proporciona Observabilidad y comprueba continuamente qué margen de capacidad tendrá cada ISP en el próximo pico de tráfico. Solo tiene permiso de lectura.
- El revisor contrasta el plan con las restricciones y las tolerancias de los consumidores para detectar qué ha pasado por alto el objetivo. Sus únicas opciones son aceptar el plan, rechazarlo o remitir la decisión a una persona.
Cada agente tiene funciones más limitadas que las que tendría un único agente generalista. Así se aplica el principio de mínimo privilegio a los agentes. Y el revisor es quien faltaba en la historia inicial. Cuando se le pide que compruebe el plan que utiliza el ISP barato, descubre que en la Fuente de Verdad no consta ninguna tolerancia a la variación del retardo para cdn-eu y señala esa carencia a una persona en vez de aprobar un plan imposible de verificar.
Cada agente también puede utilizar un modelo distinto según su función. El trabajo del analista es acotado y repetitivo, por lo que un modelo pequeño, rápido y barato lo hace bien. El planificador y el revisor sopesan las ventajas e inconvenientes de distintas opciones, por lo que utilizan un modelo más grande, más lento y más capaz. Es la misma decisión que tomas al formar un equipo con personal de ingeniería júnior y sénior: ajustas el coste al criterio que exige el trabajo. La sección Cómo elegir un modelo explica cómo tomar esa decisión.
Lo que convierte a cada uno en un agente y lo distingue de una simple instrucción al modelo es su definición. Las definiciones pertenecen a la capa de Orquestación. Al igual que las definiciones de flujos de trabajo del capítulo 11, son datos que se mantienen bajo control de versiones, se revisan como el código y sirven al Orquestador para iniciar cada agente. El trabajo en sí puede realizarse en cualquier bloque: el planificador trabaja en Orquestación, un agente que genera la configuración de un cambio a partir de plantillas y la envía a los dispositivos trabaja en Ejecución, y uno que investiga datos de telemetría trabaja en Observabilidad. El Listado 18.2 muestra la definición del revisor.
agent:
  name: plan-reviewer
  role: challenge a proposed egress plan against intent and tolerances
  model: approved/general-reasoning@2026-05    # pinned, never "latest"
  tools:                                       # MCP surfaces it may call
    - sot.read_effective_intent
    - observability.read_isp_health
    - simulation.run_whatif
  may_write: []                                # reviews only
  outputs: [accept, reject, escalate]
  budget: {max_tool_calls: 20, max_tokens: 60000, timeout: 5m}
invoked_by: [orchestrator]Cada campo responde a una pregunta que alguien hará más adelante: para qué sirve el agente, qué modelo y qué versión tomaron la decisión, sobre qué recursos podía actuar, qué resultados podía producir, cuánto podía gastar y quién podía iniciarlo.
La lista tools es lo más importante. Delimita el ámbito de actuación del agente: este solo puede actuar a través de las interfaces Model Context Protocol (MCP) que figuran en ella, así que la lista determina en qué bloques trabaja y sobre qué recursos puede actuar. Añadir una herramienta supone un cambio de privilegios y se revisa como tal.
La definición no se queda en un archivo. Cuando el Orquestador inicia el agente, convierte cada campo en un control externo al modelo que el agente no puede cuestionar:
modelse convierte en una ruta en la pasarela de modelos, que rechaza cualquier otro modelo o versión.toolsymay_writedelimitan el ámbito de actuación del agente. En cada llamada, cada servidor MCP comprueba ese ámbito con la identidad de la carga de trabajo correspondiente a la ejecución, descrita en el capítulo 13.budgetse traduce en contadores cuyos límites hace cumplir el marco. Al alcanzarse cualquiera de los límites, la ejecución termina y el caso se eleva para su revisión.outputsdefine el esquema del resultado de la ejecución. Se rechaza todo lo que quede fuera de él.invoked_byidentifica al único invocador que acepta el entorno de ejecución.
Las instrucciones indican al agente qué debería hacer. La definición determina qué puede hacer.
Una vez definidas sus funciones, los agentes aún tienen que colaborar. La sección Orquestación de agentes del capítulo 8 presentó el uso de un agente como una forma más de que el Orquestador coordine el trabajo. Aquí, varios agentes se coordinan entre sí. Hay tres formas habituales de hacerlo y la Figura 18.4 las ilustra con los mismos tres agentes.
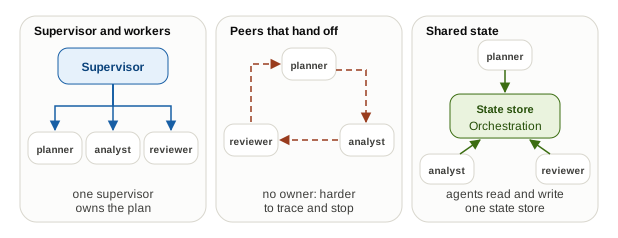
- Supervisor y trabajadores (Supervisor and workers). Un coordinador, el supervisor, divide la tarea, asigna cada parte a un agente trabajador y reúne los resultados. En su guía sobre la creación de agentes, Building effective agents, Anthropic lo denomina orchestrator-workers. Es la orquestación del capítulo 8, con un agente en cada paso. La responsabilidad del plan se concentra en un solo punto, por lo que es la forma de coordinación más fácil de auditar y detener.
- Agentes pares que se pasan el relevo (Peers that hand off). Cada agente termina su parte y pasa el trabajo al siguiente, o bien los agentes debaten hasta ponerse de acuerdo. Esto es coreografía y presenta las ventajas e inconvenientes de la coreografía que vimos en el capítulo 8: es flexible, carece de un único responsable y resulta más difícil seguir el rastro del trabajo. También puede ocurrir que dos agentes se devuelvan la misma pregunta una y otra vez sin llegar a un acuerdo y consuman tokens todo el tiempo.
- Estado compartido. Los agentes nunca se comunican directamente entre sí. Cada uno lee y escribe en un mismo registro, y el siguiente retoma lo que escribió el anterior. En la NAP, ese registro es el estado del flujo de trabajo que ya mantiene la capa de Orquestación: el planificador escribe ahí su borrador del plan, el analista añade sus observaciones y el revisor lee tanto el borrador como las observaciones. Solo la propuesta final sale de ese registro y se escribe en la Fuente de Verdad una vez superados los controles.
Usa por defecto la primera estructura, con el supervisor como flujo de trabajo en el Orquestador de la NAP. Cada paso de ese flujo corresponde a un agente. El flujo es duradero y se audita y gobierna como cualquier otro flujo de trabajo de cambio. Deja que un agente supervise a otros solo en investigaciones abiertas, cuyos pasos no se pueden conocer de antemano. Combina esta estructura con el estado compartido para que lo que produzcan los agentes quede en el almacén de estado de la capa de Orquestación y en el registro de auditoría, en vez de perderse en una conversación que nadie guarda.
Dos protocolos cubren estas conexiones, y la Figura 18.5 muestra la diferencia.
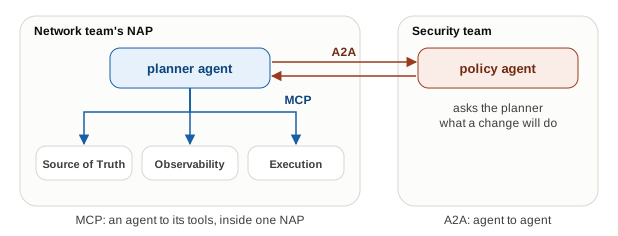
- MCP conecta a un agente con sus herramientas. Las herramientas son los bloques arquitectónicos de la NAP: la Fuente de Verdad, la Observabilidad y la Ejecución. Todos los agentes de este capítulo usan MCP.
- A2A (Agent2Agent Protocol) conecta a un agente con otro. Un agente publica una ficha que indica qué puede hacer y los demás le envían tareas (especificación). Dentro de una misma NAP, donde el Orquestador inicia todos los agentes, rara vez necesitas este protocolo. Lo necesitas cuando agentes desarrollados por equipos distintos o adquiridos a proveedores diferentes tienen que llamarse directamente entre sí, por ejemplo, cuando el agente del equipo de seguridad pregunta al planificador de la red qué efecto tendrá un cambio.
Elijas la estructura que elijas, ponle límites. Fija un número máximo de turnos, un presupuesto de tokens y un plazo para cada ejecución con varios agentes. Si se alcanza cualquiera de esos límites, escala el caso en vez de reintentar la ejecución. Los agentes que se ponen de acuerdo con demasiada facilidad entrañan un riesgo más sutil, que se trata en la sección Aprobaciones y desacuerdos.
Una vez definidos y coordinados los agentes, ¿dónde se ejecutan?
Dónde se ejecutan los agentes#
Un agente es un componente de la NAP y se ejecuta donde se ejecutan los demás componentes de la plataforma. La Figura 18.6 muestra la pila para una red distribuida entre dos regiones.
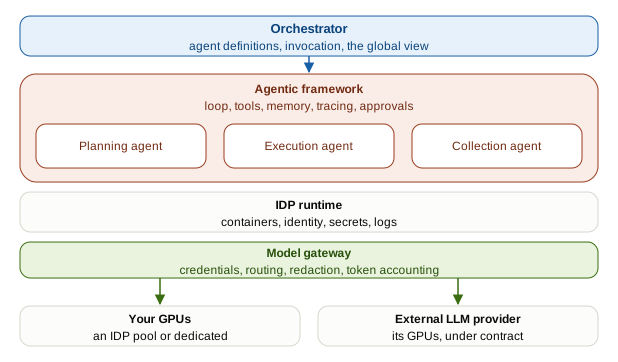
Lee la Figura de abajo arriba:
- Los modelos necesitan unidades de procesamiento gráfico (GPU), que constituyen un recurso independiente. Para ejecutar un modelo de lenguaje hacen falta GPU. Puedes usar tus propias GPU, ya sea un conjunto de GPU en la plataforma interna para desarrolladores (IDP) o hardware dedicado, o bien las de un proveedor externo de LLM al que accedas mediante su interfaz de programación de aplicaciones (API) o un despliegue privado. La sección Cómo elegir un modelo trata esta decisión. En cualquier caso, los agentes nunca llaman directamente a un modelo. Pasan por una pasarela de modelos de la NAP que centraliza las credenciales de los modelos, la fijación de versiones, el encaminamiento de cada solicitud al modelo adecuado, la ocultación de datos sensibles, el registro de actividad y el recuento de tokens.
- Los agentes se ejecutan en el entorno de ejecución de la IDP. Al igual que el resto de la NAP, cada agente se empaqueta, despliega y opera en la IDP del capítulo 11, con contenedores, una identidad de carga de trabajo como la del capítulo 13, secretos y registros. No necesita una plataforma especial.
- El marco de agentes aloja a los agentes. Se sitúa entre el entorno de ejecución y los agentes. Para ejecutar agentes en una red hace falta algo más que un marco para asistentes de programación. El marco debe proporcionar el bucle del agente, un registro de herramientas (las interfaces que expone MCP), estado y memoria, la pasarela de modelos, gestión de identidades y políticas, trazas, evaluación y aprobaciones humanas. Además, tiene que funcionar de forma coordinada con el Orquestador, no por su cuenta.
- El Orquestador está por encima de todos estos componentes. Guarda las definiciones de los agentes, inicia cada uno de ellos y mantiene la visión de conjunto.
Es fácil pasar por alto las GPU. Cuando usas un asistente alojado, el proveedor ejecuta el modelo en sus GPU y tú nunca las ves. Si decides ejecutar el modelo en tu propia infraestructura, por razones de residencia de los datos o de coste, te toca planificar la capacidad de esas GPU, presupuestarlas y organizar los turnos de guardia.
En una red de alcance mundial, la situación cambia. Con centros de datos y puntos de presencia en varios continentes, una única pila central de agentes constituye un punto único de fallo y queda lejos de los dispositivos. Es la decisión entre centralización y federación del capítulo 12, aplicada a los agentes, y el criterio es el mismo: ¿qué parte del trabajo de cada región se puede decidir solo con datos locales? Para un optimizador de borde, casi todo. Por eso la pila se ejecuta en cada región, cerca de los dispositivos y de los datos que lee. De ahí se derivan tres reglas:
- Toma las decisiones en cada región. Una partición de red entre regiones no debe impedir que cada región tome sus propias decisiones. Cada región conserva sus agentes, su estado y su último plan aprobado.
- Mantén los datos en su región. La pasarela de cada región aplica las reglas de residencia de los datos: qué modelos pueden acceder a las configuraciones y a la telemetría de esa región y dónde se ejecutan esos modelos.
- Centraliza la coordinación global. Las decisiones que afectan a varias regiones (por ejemplo, trasladar usuarios entre puntos de presencia de dos continentes) pasan por la vista global del Orquestador.
Los marcos evolucionan deprisa, así que toma estos nombres como una referencia de finales de 2026. LangGraph, del proyecto LangChain, representa cada agente como un grafo de pasos con un estado explícito. CrewAI organiza a los agentes en equipos con funciones asignadas. Los proveedores de modelos distribuyen sus propios SDK para agentes. Y un motor de flujos de trabajo duraderos, como Temporal, que aparece en la sección Panorama de soluciones del capítulo 8, puede alojar el bucle del agente como un flujo de trabajo ordinario. Ninguno ofrece por sí solo todo lo que figura en la lista anterior, así que cuenta con que tendrás que montar el marco a partir de varios componentes.
Las herramientas que se mencionan aquí son ejemplos vigentes en el momento de escribir este capítulo (a finales de 2026) y se citan con fines explicativos, sin que ello suponga una recomendación. Evalúalas teniendo en cuenta los conocimientos de tu equipo, tu NAP y el ritmo al que cambia cada proyecto.
No todos los agentes se ejecutan en tu infraestructura. El asistente de un proveedor o el agente de otra plataforma permanece fuera de la NAP y accede a ella a través del servidor MCP de la capa de Presentación del capítulo 9, sujeto a su Control de acceso basado en roles (RBAC) como cualquier otro consumidor. Ves sus llamadas a herramientas, pero no su razonamiento.
En la capa de decisión de este capítulo, el planificador, el analista y el revisor son pasos de un flujo de trabajo que se despliega en cada región y que ejecuta el Orquestador. Usa un marco dentro del paso si te ayuda a programar el agente. Evita que el marco se convierta en un segundo orquestador, con su propio estado y su propio registro de auditoría que nadie más consulta.
Cada agente de esa pila llama a un modelo. La siguiente decisión es qué modelo elegir.
Cómo elegir un modelo#
Los modelos no son intercambiables. Difieren en su capacidad para razonar sobre un problema de varios pasos, la fiabilidad con la que llaman a herramientas con argumentos válidos, el coste, la rapidez de respuesta y los lugares donde está permitido ejecutarlos. El modelo que elijas determina hasta dónde puede llegar un agente y cuánto pagarás por cada ejecución.
Si no sabes por dónde empezar, acota primero las opciones y después haz las pruebas. Hay tres fuentes que te ayudan a acotarlas. Las fichas de los modelos y las páginas de precios de los propios proveedores indican para qué se ha diseñado cada modelo, cuáles son sus límites y cuánto cuesta. En el caso de los modelos de pesos abiertos, Hugging Face aloja los modelos y ofrece para cada uno una ficha que detalla el uso previsto, las limitaciones, los datos de entrenamiento y los resultados de evaluación.
Las clasificaciones públicas ordenan los modelos mediante comparaciones a ciegas y pruebas estandarizadas. Úsalas para preseleccionar candidatos, sin tomarlas como un veredicto. Empieza con un modelo alojado de uso extendido en el asistente de solo lectura descrito en la sección Del Modo Sombra a producción. Guarda cada pregunta que el equipo de ingeniería le haga al asistente junto con la respuesta que el equipo haya considerado correcta. Ese registro se convierte en tu primer conjunto de evaluación.
Después, haz pruebas con tu propio trabajo. Las pruebas de referencia públicas miden la capacidad general de un modelo. Lo que necesitas saber es qué tal se desenvuelve en las decisiones que tú tomas. Crea un conjunto de evaluación a partir del historial de la automatización: ventanas de optimización y casos escalados en el pasado, con lo que decidió el equipo de ingeniería en cada caso y lo que ocurrió después. Unos cientos de casos son un buen punto de partida. Evalúa cada modelo candidato con ese conjunto en Modo Sombra y puntúa cuatro aspectos:
- Éxito de la tarea: ¿se habría aprobado su plan? ¿Era correcto?
- Precisión de las llamadas a herramientas: ¿llamó a la herramienta adecuada con argumentos válidos?
- Coste: tokens y dinero por decisión.
- Latencia: tiempo transcurrido desde el evento que inicia la ejecución hasta que hay una propuesta.
El mismo conjunto sirve de control en cada actualización. Ante la misma instrucción, una nueva versión del modelo puede razonar de forma distinta. Por eso, fija la versión en la definición del agente y vuelve a ejecutar las pruebas del conjunto de evaluación antes de cambiarla, igual que en el capítulo 11 se exige superar los controles antes de publicar cualquier versión de la NAP.
Rara vez un solo modelo es adecuado para todos los pasos. Un modelo generalista de gran tamaño compensa su coste cuando la tarea es abierta: el planificador formula la pregunta o el revisor busca qué aspectos ha dejado fuera el objetivo. Los pasos bien delimitados (por ejemplo, clasificar una alerta, extraer campos de un tique o resumir un registro) funcionan bien con modelos pequeños o especializados, que son más baratos, responden antes y pueden ejecutarse en tu propio hardware.
Encarga cada paso al modelo más pequeño que supere la parte del conjunto de evaluación que le corresponde. Los modelos de lenguaje pequeños con ajuste fino específico para redes siguen siendo, en su mayoría, objeto de investigación. Deja su evaluación para más adelante y mídeles el rendimiento con el mismo conjunto de evaluación que al resto de los candidatos. Y recuerda qué componentes prescinden por completo de los modelos de lenguaje: el predictor y el optimizador siguen siendo modelos matemáticos.
Decide después dónde se ejecutará el modelo, porque de ello depende adónde irán tus datos. Las configuraciones que envías fuera de tu red quedan fuera de tu control, así que elige con el mismo cuidado con el que elegiste dónde guardar el registro de auditoría. Es fácil confundir tres cuestiones distintas:
- Quién ejecuta el modelo. Un proveedor externo de LLM lo ejecuta en sus GPU y te vende acceso a través de una API pública o de un despliegue privado en tu entorno de nube. O lo ejecutas tú en tus propias GPU y te encargas de administrarlas.
- Qué tipo de modelo eliges. Solo puedes obtener un modelo propietario de quien lo desarrolla. En un modelo de pesos abiertos se publican los pesos obtenidos durante el entrenamiento, de modo que cualquiera, tú incluido, puede ejecutarlo. Los pesos abiertos te dan la opción de ejecutar el modelo por tu cuenta. Tú decides si lo haces y asumes cualquier carencia de calidad que revele tu conjunto de evaluación.
- Qué estipula el contrato. Si recurres a un proveedor, el contrato determina qué ocurre con tus datos: cuánto tiempo se conservan las instrucciones que envías al modelo, si se utilizan para entrenar modelos futuros y en qué región se procesan. Léelo como lo que es, un acuerdo de tratamiento de datos, igual que tu organización ya lee el contrato de cualquier servicio SaaS o IaaS: revisa la residencia de los datos, los plazos de conservación, los subencargados del tratamiento y qué ocurre con los datos al finalizar el contrato. Una API de LLM es un servicio en la nube más y se le aplican las mismas reglas que a los demás.
La clasificación de los datos del capítulo 13 (Figura 13.6) determina la elección en cada paso. Puedes enviar datos públicos e internos, como el estado y las previsiones de cada ISP, a un proveedor externo de LLM si el contrato excluye su conservación y su uso para entrenamiento. Los datos sensibles, como las configuraciones completas con secretos o las direcciones de clientes, se procesan en un modelo que ejecutas tú, o bien se oculta la información sensible antes de enviarlos fuera.
Elijas lo que elijas, los agentes acceden al modelo a través de la pasarela de modelos descrita en la sección Dónde se ejecutan los agentes. Así puedes cambiar más adelante dónde se ejecuta el modelo sin modificar los agentes.
Cada ejecución consume tokens, elijas el modelo que elijas. Con un proveedor externo de LLM, los tokens cuestan dinero. En tus propias GPU, consumen capacidad: cada token que gasta un agente ocupa tiempo de GPU durante el cual otro agente tiene que esperar. En ambos casos, los tokens explican la mayor parte de la latencia del agente y se acumulan más deprisa de lo que sugiere una demostración: en cada turno se vuelve a enviar toda la ventana de contexto, con las instrucciones, las definiciones de las herramientas y todo lo leído hasta ese momento. Estas prácticas reducen el consumo de tokens y se presentan en orden aproximado de mayor a menor ahorro:
- No le preguntes al modelo lo que puedes resolver con una regla. La arquitectura por capas ya se encarga de buena parte de ello: los bucles deterministas del capítulo 16 y del capítulo 17 resuelven los casos habituales y al agente solo le llegan los restantes. Durante una ejecución, cualquier tarea determinista, como una optimización, una simulación o una comprobación del esquema, se resuelve con una llamada a una herramienta, sin recurrir al razonamiento del modelo.
- Envía vistas en lugar de volcados. Para eso sirven las vistas específicas de cada contexto del capítulo 5. El planificador solicita los conjuntos de prefijos, los ISP y las tolerancias de una sola sede, sin necesidad de pedir el modelo completo de los treinta puntos de presencia.
- Haz que las herramientas devuelvan datos estructurados. Cuando una herramienta devuelve toda la configuración en ejecución, cada llamada consume tantos tokens como ocupa esa configuración. Si devuelve los campos normalizados que ha pedido el agente, consume solo una fracción.
- Reutiliza lo que permanece estable. Los proveedores cobran menos por un prefijo de entrada que se repite y el software que sirve el modelo en tus propias GPU también puede guardarlo en caché. Por eso, coloca primero las partes estables, como las instrucciones y las definiciones de las herramientas, y deja para el final las que cambian.
- Usa modelos pequeños para los pasos pequeños, como se ha descrito antes.
- Asigna un presupuesto a cada ejecución. El presupuesto del Listado 18.2 limita las llamadas a herramientas, los tokens y el tiempo. Si se alcanza alguno de esos límites, el caso se eleva al siguiente nivel.
Mide los tokens por decisión como indicador de nivel de servicio junto con la tasa de aceptación. Un aumento brusco tras cambiar las instrucciones de entrada o actualizar el modelo es una regresión, igual que un aumento brusco de la latencia.
Una vez elegido el modelo, todavía tiene que mejorar con el tiempo, lo que plantea la última pregunta de esta sección: ¿aprenden los agentes?
Aprendizaje durante la ejecución#
Los agentes sí aprenden, pero de forma distinta a las personas. Los pesos del modelo, que recogen lo aprendido durante el entrenamiento, permanecen fijos durante la ejecución: el mismo modelo responde a la siguiente petición tal como habría respondido a la primera. Lo que cambia es la información que le proporcionas, en tres niveles:
- Contexto, en cada ejecución: la intención, las tolerancias y los procedimientos operativos recuperados para esta decisión.
- Memoria, entre ejecuciones: un repositorio de decisiones anteriores, resultados y correcciones humanas que se consultan cuando surge un caso parecido. La próxima vez que el planificador se plantee mover cdn-eu en Fráncfort, leerá que, en una ocasión, quien revisó el plan elevó el caso porque faltaba una tolerancia a la variación del retardo en esa sede. Así es como un agente da la impresión de aprender durante la ejecución.
- Pesos, fuera de línea: se aplica el ajuste fino con casos seleccionados, se comprueba el resultado con el conjunto de evaluación y se publica una nueva versión que queda fijada, como ocurre con cualquier artefacto de la NAP.
La memoria es una entrada como cualquier otra, así que puede envenenarse: una corrección errónea o un texto que alguien haya introducido en un tique como parte de un ataque se convierte en una lección que el agente aplica la próxima vez. Trátala como la intención. Mantén un historial de versiones, registra quién o qué escribió cada entrada, permite que una persona revise lo que se escribe y haz que caduquen las entradas que nadie haya confirmado. El equipo de ingeniería también sigue haciendo ajustes, como en el capítulo 16: consulta el registro de decisiones de los agentes que mantiene la NAP y ajusta las restricciones, las herramientas y las instrucciones.
Por debajo de los agentes, los dos componentes de la capa de decisión aprenden de formas distintas, y es habitual confundirlas.
Los modelos matemáticos se entrenan. El modelo de previsión aprende del historial de monitorización sintética. Los modelos de coste y rendimiento del optimizador se ajustan a partir de los resultados medidos y del historial de la automatización del capítulo 14, que recoge los resultados reales de los planes anteriores. Estos modelos se reentrenan periódicamente y, lo que es más importante, se pueden evaluar: reserva un periodo del historial, pide al modelo que elabore un plan para ese periodo y compáralo con lo que ocurrió.
La misma comparación se hace en producción después de cada decisión. Registra lo que preveía el modelo para cada plan, el percentil 95 de la carga y la latencia por ISP, y contrástalo con las mediciones de las sondas y los datos de la siguiente factura. Es normal que haya errores aleatorios. Si el error tiende siempre en la misma dirección, hay un sesgo, y un modelo de previsión sesgado comete el mismo error en todos los planes. Cuando la desviación supera la tolerancia acordada para un ISP, los planes que trasladan tráfico a ese ISP vuelven a requerir aprobación hasta que se reentrene el modelo de previsión correspondiente. Para el resto de su trabajo, el agente conserva el nivel de autonomía que se ha ganado.
En general, la capa de agentes no se entrena: se influye en ella. Orientas su comportamiento mediante el contexto que recuperas para ella: la intención actual, las tolerancias vigentes, el límite inferior y los procedimientos operativos. También influyes mediante las herramientas que le proporcionas, las salvaguardas y los ejemplos, incluidas las correcciones que hace una persona cuando el agente eleva un caso. A menudo merece la pena aplicar un ajuste fino a un modelo de previsión especializado. Rara vez compensa hacerlo con la capa de razonamiento general cuando puedes conseguir el mismo efecto con un contexto mejor y herramientas más acotadas.
Hay una conexión invisible que recorre todo el libro y hace posible la autonomía. La fiabilidad de un modelo depende de la fiabilidad de los datos de los que aprende. Los datos con los que se entrenan y evalúan estos modelos proceden del registro de auditoría creado para la gobernanza: el historial de la automatización del capítulo 14 y la Cadena de procedencia (Provenance Chain) del capítulo 13. Ambos se introdujeron para responder a las preguntas de auditoría.
Juntos constituyen un registro etiquetado de lo que hizo la automatización y de los resultados que obtuvo, en el que se puede detectar cualquier manipulación. Ese es el corpus que necesitas para entrenar y validar un modelo de decisión de forma segura. La gobernanza que estableciste para cumplir la normativa es la misma que te permite operar con autonomía. Si prescindes de ella, entrenas el modelo con conjeturas sin etiquetar.
Los agentes ya están construidos, tienen un entorno donde ejecutarse y siguen mejorando. El resto del capítulo trata de cómo gestionarlos.
Gestionar los agentes como un equipo#
Gestionar agentes es gestionar un equipo a gran escala. Quien haya dirigido un equipo ya conoce las preguntas. ¿Cuánta confianza depositas en una persona recién incorporada? ¿Qué le permites tocar? ¿Cómo sabes qué está haciendo? ¿Quién da el visto bueno? ¿Qué haces cuando los especialistas de tu equipo discrepan contigo? ¿Qué documentación conservas? Los agentes plantean todas estas preguntas y la Figura 18.7 muestra que la mayoría de las respuestas están en los controles que ya hemos desarrollado en este libro.
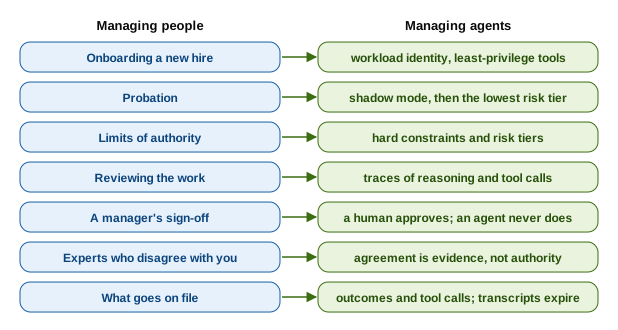
Las diferencias están en la velocidad y en el número (la responsabilidad sigue recayendo en las personas). Los agentes trabajan más deprisa que las personas y en mayor número, así que un error se repite antes de que nadie lo advierta. Las copias de un mismo agente comparten los mismos puntos ciegos. A un agente no se le pueden exigir responsabilidades, por lo que siempre hay una persona que responde en última instancia de cada control. Por eso, todos los controles de esta sección parten del principio de confianza cero que el capítulo 13 aplica a cualquier identidad: confía en lo que hizo el agente, no en lo que dice haber hecho. Las llamadas a herramientas y sus resultados constituyen el registro. El relato del propio agente sobre su trabajo es una afirmación que hay que comprobar.
La escala determina cómo llevarlo a la práctica. Por lo general, quien dirige un equipo tiene a su cargo un máximo de ocho o diez personas (he dirigido equipos y sé que en algunos entornos es difícil superar esa cifra). Aquí podrías tener a tu cargo más de cuarenta agentes, ¡y cada uno se ejecutaría en cada ventana de optimización de cada región! En cuanto los agentes superan en número a las personas, se acumulan los retrasos si alguien tiene que acordarse de hacer una revisión, conceder un permiso desde una consola o archivar un registro.
Solo puedes gestionar todo eso si lo tratas como código. Así, la NAP ejecuta ese código para cada agente en cada ejecución, y las personas revisan los cambios en el código en vez de revisar cada acción que realiza. Es la regla de gobernanza que estableció el capítulo 13, aplicada a los agentes: solo la lógica de los controles de seguridad requiere revisión humana. La Tabla 18.1 relaciona cada práctica de gestión de equipos con el código que la lleva a cabo.
| Práctica de equipo | Gestión de personas | Gestión de agentes |
|---|---|---|
| Incorporación | Alguien crea la cuenta y concede los permisos de acceso | La definición del agente (Listado 18.2) se integra tras su revisión. Solo al desplegarla se emite la identidad de la carga de trabajo y se conceden los permisos de uso de las herramientas |
| Límites de autoridad | Una persona responsable indica a quien tiene menos experiencia qué decisiones puede tomar | Los controles basados en niveles de riesgo y en políticas como código evalúan cada propuesta. El nivel máximo del agente figura en un campo de su definición |
| Supervisión del trabajo | Alguien lee los registros | Cada ejecución emite una traza e indicadores de nivel de servicio. Las alertas se activan en función de los objetivos |
| Evaluación del desempeño | Una conversación cada trimestre | El conjunto de pruebas de evaluación se ejecuta con cada nueva versión. A partir del historial, calculado con los registros de ejecución, se proponen ascensos y descensos de nivel |
| Aprobaciones | Una reunión | El nivel de riesgo determina el curso de cada propuesta: la aprobación es automática si entra dentro del nivel del agente. Una persona solo interviene si la propuesta se eleva para su aprobación |
| Registro de decisiones | Alguien archiva la decisión | La cadena de procedencia registra cada propuesta, llamada a herramienta y aprobación en el momento en que se produce |
| Baja | Alguien se acuerda de revocar el acceso | Al eliminar la definición, se revocan la identidad y el acceso a las herramientas y a la ruta hacia el modelo. Si un agente carece de responsable en el registro, se desactiva |
Dos tareas siguen en manos de las personas. Aprueban los cambios en el código: la definición de un nuevo agente, una lista de herramientas más amplia o el ascenso a un nivel superior. Y resuelven los casos que el código eleva para su revisión. Todo lo demás se ejecuta sin que nadie tenga que acordarse de hacerlo. Solo así se puede seguir el ritmo de los agentes.
Los cinco apartados siguientes abordan estas cuestiones por orden: la incorporación, los límites de autoridad, la supervisión del trabajo, las aprobaciones y los desacuerdos, y qué conviene archivar. Cada apartado identifica un control y cada control se ejecuta como código.
Incorporación de un perfil júnior: identidad y privilegios#
Quien se incorpora a la plantilla recibe una tarjeta que solo abre las salas a las que necesita acceder para trabajar. Un agente recibe el mismo trato desde el primer día y nunca obtiene la llave maestra: si accede directamente a los dispositivos, es cuestión de tiempo que se produzca un incidente de seguridad. El agente actúa como los demás componentes de este libro: utiliza interfaces sujetas a controles de gobernanza, con una identidad de alcance limitado, y todas sus acciones quedan auditadas.
El mecanismo consiste en un conjunto de interfaces de herramientas MCP, una por bloque arquitectónico. Cada una aplica el principio de mínimo privilegio. Una interfaz de herramientas MCP ofrece un conjunto de herramientas tipadas. En tiempo de ejecución, el agente elige cuáles invocar y en qué orden según el resultado de cada llamada. Un cliente Representational State Transfer (REST) sigue una secuencia fijada en el código (el apartado Tipos de API del capítulo 9 explica la diferencia entre REST y MCP). El Orquestador inicia este agente dentro de la NAP, por lo que utiliza las interfaces de herramientas de cada bloque. Un agente externo a la NAP entraría a través del servidor MCP de la capa de Presentación. Cada interfaz se expone como se describe en el capítulo 9 y su acceso se controla como exige el capítulo 13:
- La SoT: leer la intención declarada y la efectiva, y proponer una escritura sujeta a control, ya sea para aplicar una excepción de intención dinámica como la que se escribe en el capítulo 17 o para modificar la política declarada. Nunca se escribe directamente.
- Monitorización sintética y observabilidad: consultar el estado actual y el historial de cada ISP.
- Simulación (capítulo 10): antes de presentar cualquier propuesta, es obligatorio simular qué ocurriría en un modelo realista de la red.
- El flujo de trabajo de cambio: presentar una propuesta de cambio por la misma vía sujeta a controles de gobernanza que utiliza una persona, con la misma validación y las mismas garantías de reversión, sin saltarse nunca esa vía.
- El servicio de niveles de riesgo y políticas (apartado Clasificación del riesgo por niveles del capítulo 13): consultar a qué nivel corresponde un cambio propuesto para que el control determine si lo aprueba automáticamente o lo remite a una persona.
- Auditoría y procedencia: registrar cada propuesta, cada resultado de simulación y cada acción.
El agente, por tanto, no recibe poderes especiales. Se convierte en el tercer autor de intención, junto con la persona y el bucle de autorrecuperación. Los tres escriben sobre la misma intención y el agente es quien tiene más restricciones. Cuenta con una identidad de carga de trabajo, permisos limitados al mínimo privilegio y un registro de auditoría completo. Es el principio del capítulo 13 de que «la identidad es el nuevo perímetro», aplicado a un actor no humano. Todos estos mecanismos ya los conocemos. Son los bloques arquitectónicos de la Parte 2, expuestos como herramientas y sujetos a los controles de gobernanza de la Parte 3.
Esos privilegios tampoco quedan fijados el primer día, igual que ocurre con alguien que empieza. Se amplían de nivel en nivel de riesgo según el historial del agente y también pueden reducirse. La Figura 18.8 muestra cómo evolucionan. La curva es ilustrativa.
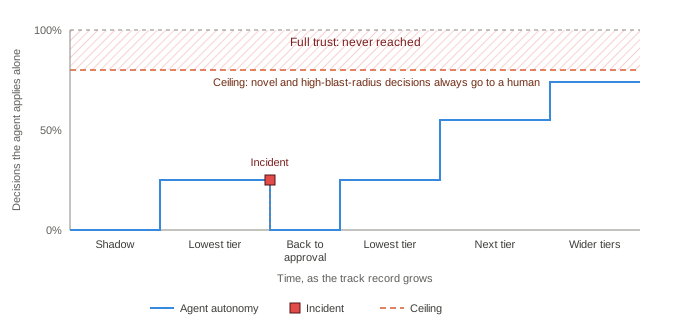
El agente empieza en Modo Sombra, sin tomar ninguna decisión por su cuenta, y se gana el nivel de riesgo más bajo cuando los planes que elabora en ese modo coinciden con los que habría aprobado el equipo de ingeniería. Si se produce un incidente, vuelve a necesitar aprobación para ese nivel hasta que se corrija la causa y mejore su historial. Cada nivel posterior se gana del mismo modo. Hay dos límites que nunca cambian. Las decisiones inéditas y las de gran alcance del impacto siempre pasan a una persona, y la confianza plena nunca aparece en el gráfico, por la misma razón por la que nadie del equipo de ingeniería, por mucha experiencia que tenga, aprueba su propio cambio. El apartado Del Modo Sombra a producción traduce esta curva en pasos concretos.
No confío plenamente en nadie, ni siquiera en mí. Sé que mis sesgos o el cansancio pueden influir en mi criterio y que puede faltarme la mitad del contexto. A las 02:00 suelen darse las tres cosas a la vez. Por eso pongo controles a mis propias decisiones: las importantes las consulto con la almohada y le pido a alguien que me lleve la contraria. Nunca me he concedido autonomía ilimitada. Tampoco voy a concedérsela a un agente.
Un agente basado en un LLM sí introduce riesgos que un bucle determinista no presenta. Los recoge OWASP Top 10 for LLM Applications. El apartado Elección de un modelo aborda dos de ellos, la divulgación de información sensible y el uso de un modelo comprometido, al decidir dónde se ejecuta cada modelo y fijar su versión. Hay otros dos que revisten especial importancia para la identidad y las herramientas del agente:
- Inyección de instrucciones. El agente lee descripciones de interfaces, líneas de registro y tickets, y cualquiera de ellos puede contener texto escrito para dirigir su comportamiento. Trata todo lo que lea como datos, nunca como instrucciones, y evita que una llamada a una herramienta dependa solo de texto libre.
- Envenenamiento de herramientas. Un servidor MCP es código que ejecutas con la identidad del agente. Revísalo, fija su versión y limita sus permisos como harías con cualquier otra dependencia.
Quienes se dedican a la ingeniería de redes añadirán su propia lista, porque en un rúter los errores de un modelo de lenguaje se manifiestan de otra forma:
- Sintaxis inventada. Un modelo puede generar un comando o una ruta Yet Another Next Generation (YANG) que parece válido, pero que en realidad no existe. Es una alucinación.
- Dialecto equivocado. El modelo mezcla la sintaxis de un fabricante con la de otro o utiliza una función que la versión del sistema operativo del dispositivo no admite.
- Configuración plausible pero incorrecta. La configuración es válida, pero hace algo distinto de lo previsto: una cláusula de un route-map en el orden equivocado o una lista de prefijos que admite un bit de más.
La respuesta de diseño es la que ofrece este libro desde el capítulo 4: el agente propone intención, nunca configuración. Las plantillas generan la configuración, las comprobaciones del esquema rechazan los campos inventados, el análisis de la configuración y la simulación detectan los errores que parecen plausibles y el despliegue canario detecta los que pasan inadvertidos. Un agente que escribe directamente en la interfaz de línea de comandos (CLI) se salta todos esos controles.
La identidad limita a qué puede acceder un agente. Una vez que accede, ¿qué decisiones se le permite tomar?
Qué puede decidir por su cuenta#
La cuestión no es qué puede decidir el agente, sino qué se le permite decidir por su cuenta. La respuesta está en unos límites fijos que dejan margen para adaptarse.
Lo primero y más importante es distinguir entre una restricción estricta y un objetivo flexible, porque el fallo del caso inicial fue pasar por alto esa distinción. El coste es un objetivo flexible: minimízalo. El nivel mínimo de servicio y las tolerancias de los SLO de los consumidores son restricciones estrictas: cúmplelas siempre y nunca las sacrifiques para mejorar el valor del objetivo. La regla de diseño es clara: incorpora el nivel mínimo y los SLO al optimizador como restricciones estrictas en vez de incluirlos como términos ponderados en la función objetivo.
Otros términos pueden pesar más que un término ponderado. Así es como un ahorro de costes suficientemente grande hace desaparecer el presupuesto de variación del retardo. Una restricción estricta no se puede compensar de esa manera. Si el presupuesto de variación del retardo de cdn-eu se hubiera incluido como restricción en vez de omitirse, el plan que usaba el ISP barato habría sido inviable y el optimizador nunca lo habría propuesto.
El origen de las restricciones importa tanto como la forma de codificarlas. El optimizador lee el nivel mínimo y las tolerancias de la intención efectiva en la SoT, no de la solicitud del agente. Después, antes de aplicar ningún cambio, el flujo de trabajo de cambio vuelve a comprobar que el plan los respeta. El agente puede añadir una restricción a una ejecución, pero nunca eliminar ninguna. Con dos comprobaciones independientes de la misma regla, cualquier agente que se comporte de forma incorrecta falla antes de llegar a producción.
Las demás salvaguardas son las que ya hemos definido a lo largo del libro, aplicadas ahora al agente. Los niveles de riesgo (sección Clasificación por niveles de riesgo del capítulo 13) determinan qué cambios puede aplicar el agente por sí solo y cuáles debe escalar. Un pequeño desplazamiento de un conjunto de prefijos de poco valor se aplica automáticamente. Un cambio que desplaza un conjunto grande de prefijos o se acerca al límite inferior se escala. Toda propuesta debe superar la simulación antes de convertirse en un cambio. Los límites al alcance del impacto del capítulo 12 acotan la parte de la red a la que puede afectar una sola decisión.
Hay una salvaguarda específica de los sistemas que toman decisiones en lugar de limitarse a reaccionar: deben evitar las oscilaciones. Un optimizador que recalcula el plan ante cualquier pequeña variación en las mediciones moverá prefijos de un lado a otro constantemente. Eso equivale a una fluctuación de rutas y por sí solo desestabiliza la red. Por eso, el agente solo modifica la red cuando la mejora prevista respecto al plan actual supera un margen significativo. También tiene limitada la frecuencia con la que puede intervenir. Un plan un 2 % más barato no justifica un cambio de enrutamiento. Uno un 30 % más barato que cumpla todas las restricciones, sí. La estabilidad también es una restricción.
El agente también debe saber cuándo abstenerse de decidir. Un pronóstico basado en datos de sondeo desactualizados o incompletos es una conjetura, y un optimizador que parte de una conjetura devuelve con seguridad un plan equivocado. Por eso, cada dato de entrada indica su antigüedad y, en caso de fallo, se bloquea la decisión. Si el historial de sondeos de un ISP supera la antigüedad máxima permitida o un punto de observación deja de enviar datos, el agente mantiene el plan actual y genera una alerta en vez de recalcularlo. Mantener la situación actual siempre es una decisión válida.
Vuelve al caso inicial con estas salvaguardas en vigor. Ahora que el presupuesto de variación del retardo de cdn-eu es una restricción estricta, el optimizador ni siquiera puede generar el plan que usa el ISP más barato. Ningún plan reduce el coste y respeta a la vez el presupuesto de variación del retardo. Por tanto, el optimizador no tiene ningún plan válido que devolver.
La simulación añade una segunda capa, aunque su alcance es limitado. Un simulador detecta de forma fiable las infracciones estructurales, como las de un plan que incumple el límite inferior o deja un prefijo sin ruta. No puede garantizar cuál será la variación del retardo de un ISP real durante el pico de tráfico de la semana que viene. Eso es más un problema de predicción que de simulación.
Por eso, la tercera capa es un despliegue por etapas. Aplica primero el nuevo plan a una fracción del tráfico afectado y observa la señal real de salud descrita en el capítulo 17 antes de aplicarlo al resto. Es la misma práctica de despliegue canario que el capítulo 11 aplica a las nuevas versiones de la NAP y de despliegue por oleadas que el capítulo 8 aplica a los cambios en la red. Gracias a la restricción, la simulación y el despliegue canario, un plan «óptimo según un objetivo incompleto» se descarta antes del despliegue o se detecta en cuanto empieza a causar daños.
Los límites solo funcionan si puedes observar cómo trabaja el agente dentro de ellos.
Cómo observar el trabajo#
Quien dirige un equipo a distancia no vigila cada pulsación de tecla, pero siempre puede ver qué se ha entregado, cómo y por qué. Con un agente hace falta la misma visibilidad, y el registro debe estar integrado en el sistema, porque ningún encuentro de pasillo permite hacerse una idea de cómo trabaja un agente.
Registra una traza de cada ejecución. La traza recoge la ejecución del agente, cada llamada al modelo con el modelo utilizado, su versión y los tokens de entrada y salida, cada llamada a una herramienta con sus argumentos y su resultado, y la salida final. Todo queda vinculado al registro de ejecución del flujo de trabajo de cambio. OpenTelemetry define convenciones semánticas para los tramos de traza de los agentes, aún en desarrollo, que permiten enviar estas trazas al mismo sistema que recibe las del resto de la NAP, el sistema de trazado distribuido del capítulo 12.
Las herramientas creadas para este fin, como Langfuse y Arize Phoenix, ambas de código abierto, o LangSmith, del proyecto LangChain, muestran cada ejecución como un árbol de llamadas a modelos y herramientas con sus tokens y su coste. La mayoría acepta trazas de OpenTelemetry, de modo que complementan el sistema de trazado de la NAP sin sustituirlo. La advertencia de Dónde se ejecutan los agentes también se aplica a estas herramientas.
El Listado 18.3 muestra una de estas trazas, la de la ejecución del revisor durante la ventana de costes, reducida a sus pasos.
run job-20260718-0258   agent plan-reviewer
model approved/general-reasoning@2026-05
02:58:10 invoked by orchestrator: review proposal p-4471
         (move cdn-eu onto local-c at dc-fra)
02:58:12 sot.read_effective_intent(cdn-eu)
         -> latency 40 ms, jitter: none set
02:58:14 observability.read_isp_health(dc-fra, 30d)
         -> local-c p95 jitter 18 ms at peak
02:58:21 simulation.run_whatif(p-4471)
         -> structural checks pass
02:58:25 escalate: "no jitter tolerance for cdn-eu;
         local-c jitters at peak; cannot verify the plan"
tokens 31,200 in / 1,150 out, 3 tool calls, 15 sCada línea responde a una pregunta que haría quien supervisa el trabajo: qué leyó el agente, qué ejecutó, a qué conclusión llegó y cuánto costó. Nada de esto exige dar por buena la explicación que ofrece el modelo sobre su propio razonamiento. Todo se puede comprobar.
Conserva las razones que da el agente en su salida, porque de ellas depende el compromiso de explicabilidad que se aborda más adelante en este capítulo. Pero no tomes el razonamiento intermedio del modelo como registro de lo sucedido. Es un relato, no una prueba. Los hechos constan en las llamadas a herramientas: qué leyó el agente, qué ejecutó y qué presentó.
Después, revisa el trabajo como lo haría quien dirige un equipo:
- Lee de principio a fin cada escalado y cada reversión.
- Revisa una muestra semanal de ejecuciones ordinarias para detectar desviaciones antes de que se reflejen en las cifras.
- Examina los casos atípicos: ejecuciones con un número inusual de tokens, con muchos más turnos de lo habitual o que hayan alcanzado el límite de presupuesto.
Configura alertas también para el comportamiento, además de los errores: un aumento de la tasa de errores en las llamadas a herramientas, ejecuciones que alcanzan repetidamente el límite de presupuesto o un agente que llama a una herramienta que nunca había usado. Si alguien con poca experiencia abre de repente el sistema de nóminas, le pides una explicación. Haz lo mismo con un agente que de repente lee secretos.
Observar el trabajo plantea la siguiente pregunta: ¿quién da el visto bueno y qué ocurre cuando los agentes y las personas discrepan?
Aprobaciones y discrepancias#
El agente nunca da la aprobación. La sección Controles y aprobaciones del capítulo 13 ya estableció que, si un cambio requiere autorización humana, debe autorizarlo una persona, porque un modelo no puede responder por la decisión.
Las discrepancias empiezan entre los propios agentes, y te interesa que así sea. La función del revisor es cuestionar al planificador, así que organiza un debate breve entre ambos: el planificador propone, el revisor examina el plan a la luz de las restricciones y las tolerancias y formula sus objeciones, y el planificador lo revisa. La guía de Anthropic lo llama patrón evaluador-optimizador (evaluator-optimizer). Limita el debate a unas pocas rondas. Si el revisor sigue rechazando un plan tras la última ronda, el plan no se despliega. Se escala a una persona junto con las dos posturas: los argumentos del planificador y la objeción del revisor. Ese es el resumen que necesita quien toma la decisión técnica.
El nivel de riesgo determina qué cambios necesitan aprobación humana, igual que en los cambios que presentan las personas. El agente revisor actúa como control, pero no da el visto bueno: puede bloquear un plan, pero no aprobarlo en nombre de una persona.
El caso más difícil es la discrepancia entre los agentes y una persona. Supón que el planificador, el analista y el revisor recomiendan sacar cdn-eu de tier1-a esta noche y que la ingeniera de guardia discrepa: sabe que el proveedor ha anunciado tareas de mantenimiento para mañana por la mañana en la ruta alternativa. Tres agentes coinciden y una persona discrepa. Aborda la situación como lo harías si tres especialistas cuestionaran tu postura: su coincidencia es un indicio, pero no les confiere autoridad. Dos preguntas determinan cuánto peso tiene.
- ¿Son independientes? Tres agentes que usan el mismo modelo y leen el mismo contexto equivalen a pedir la misma opinión tres veces. En el capítulo 17 solo podíamos confiar en el cuórum porque los puntos de observación fallaban de forma independiente. Aquí se aplica la misma regla. La coincidencia solo cuenta como más de un voto cuando los agentes difieren en el modelo o en los datos, o cuando uno de ellos tiene la función expresa de discrepar.
- ¿Qué indican las pruebas? Pide a los agentes que indiquen en qué basan su recomendación y registra el motivo por el que la ingeniera decide apartarse de ella. Si la ingeniera tenía razón, el motivo pasa a la memoria y quizá dé lugar a un nuevo dato de entrada: el calendario de mantenimiento de los proveedores. Si los agentes tenían razón, así consta en el registro y el acierto pasa a su historial de resultados.
En ambos casos, la persona decide y asume la responsabilidad de la decisión. Procura que sea fácil apartarse de la recomendación y que quede constancia de ello. Si apartarse de lo que recomiendan los agentes cuesta más que seguirlo, la gente deja de hacerlo. En la investigación sobre factores humanos, esto se denomina sesgo de automatización, y la vía de escalado solo existe sobre el papel.
A estas alturas, hay cuatro tipos de actores que pueden escribir cambios en la red: el personal de ingeniería, el bucle de conformidad del capítulo 16, el bucle de autorrecuperación del capítulo 17 y los agentes. Cuando dos de ellos persiguen resultados distintos, el orden de prioridad se fija de antemano para evitar discutirlo en tiempo de ejecución:
- Las restricciones estrictas prevalecen sobre cualquier actor automatizado. El límite inferior, las tolerancias de los SLO y la vía de gestión se respetan con independencia de quién solicite el cambio. Solo una persona con la autoridad que establece el capítulo 13 puede flexibilizar una de estas restricciones, y hacerlo supone modificar la política, no aplicar una excepción.
- La decisión explícita de una persona prevalece sobre la de una máquina dentro de esas restricciones y se registra junto con su justificación.
- Una excepción activa prevalece sobre la intención declarada mientras esté vigente. Puede tratarse de un drenaje de tráfico para la autorrecuperación o de un plan de agente aprobado que se registra como intención dinámica con fecha de caducidad. Cuando dos excepciones entran en conflicto, prevalece la que mantenga más capacidad en servicio hasta que una persona decida.
- La intención declarada es lo que restablece el bucle de conformidad una vez que han caducado todas las excepciones.
Este orden se puede hacer cumplir porque ningún actor automatizado escribe directamente en la red. Cada uno escribe o propone un cambio en la intención según lo que permita su nivel de riesgo, y el flujo de trabajo de cambio lo aplica. Los conflictos confluyen en un solo lugar, donde la titularidad de los campos descrita en el capítulo 5 determina quién puede escribir cada valor.
Cada aprobación, cada excepción y cada debate dejan constancia de lo ocurrido, lo que plantea la última pregunta: ¿qué conviene conservar?
Conversaciones o resultados#
¿Deberías registrar cada intercambio entre agentes, como si guardaras cada conversación de chat entre dos personas de la plantilla, o solo los documentos que producen? En el caso de las personas, una organización conserva las decisiones, los documentos y las aprobaciones, pero no cada conversación de pasillo. Con los agentes, hay que sopesar otros factores. El agente no tiene una privacidad que proteger, pero las transcripciones contienen todo lo que leen los agentes, incluidas las configuraciones y los prefijos de los clientes, de modo que heredan la clasificación que reciben esos datos según el capítulo 13. Y ocupan mucho espacio.
Distingue tres niveles de conservación:
- Siempre: el resultado (la propuesta, la decisión, la aprobación), cada llamada a una herramienta con sus argumentos y su resultado, y el modelo y la versión que hicieron cada llamada. Así se extiende a los agentes la Cadena de procedencia (Provenance Chain) del capítulo 13.
- Durante un plazo de conservación: guarda las transcripciones completas de los intercambios entre agentes y de los que mantienen con los modelos durante el tiempo necesario para investigar un incidente, por ejemplo, 30 días. Después caducan, salvo que haya que conservarlas por un incidente.
- Nunca como registro de la decisión: la transcripción muestra cómo llegaron los agentes a la decisión. No constituye la decisión en sí. Con la estructura de estado compartido que vimos antes, la decisión queda registrada en la Fuente de Verdad.
Los equipos que trabajan a distancia funcionan porque los traspasos de trabajo quedan por escrito y los resultados se guardan donde todo el equipo puede encontrarlos. Esa misma disciplina permite gestionar un equipo de agentes.
Con esto se completan los controles. La última sección los ordena, desde un primer agente en Modo Sombra hasta un equipo de agentes en producción.
Del Modo Sombra a producción#
A un ordenador nunca se le pueden exigir responsabilidades. Por tanto, un ordenador nunca debe tomar una decisión de gestión.
IBM training manual, 1979
Una decisión autónoma de encaminamiento determina por dónde circula el tráfico de personas reales. Lo que está en juego va más allá de la ingeniería. Para ejercer esa autonomía de forma responsable hacen falta tres compromisos:
Siempre hay una persona identificada que responde de la decisión. El agente propone y, dentro de sus límites, actúa, pero cuando en una auditoría o en la revisión de un incidente se pregunta quién responde de un cambio, la respuesta es una persona, nunca un modelo. El capítulo 13 estableció esta regla para las aprobaciones. También se aplica a la autonomía en general. A un modelo no se le puede convocar a una revisión ni exigirle que rinda cuentas, y tampoco puede asumir la responsabilidad de haber degradado un servicio.
Toda decisión es reversible. Una decisión del agente debe ser tan reversible como un desvío de tráfico para recuperar el servicio: debe tener un límite de tiempo, usar la operación confirmed-commit si la plataforma la admite y revertirse automáticamente si no se confirma o si empeora la situación. La autonomía sin un mecanismo rápido y automático de reversión permite cometer errores a la velocidad de una máquina.
Toda acción se puede explicar. El agente debe poder explicar por qué propuso un plan: cuál era el objetivo, qué restricciones había, qué datos utilizó y qué resultado obtuvo el optimizador. No es un mero detalle. Una acción que no se puede explicar tampoco se puede auditar, y si el agente deriva una decisión a una persona sin exponer su razonamiento, esa persona carece de fundamento para decidir. La capacidad de explicar las acciones es un requisito de seguridad, y una propuesta que no se pueda explicar no debería pasar a producción.
Este es el último peldaño de la Escalera de Confianza del capítulo 14, y hasta ahí hay un límite. Con el tiempo, el historial de resultados de la automatización da al agente más margen de actuación y le permite gestionar por sí solo más niveles de riesgo. Aun así, siempre se mantiene la vía para derivar decisiones a una persona, y por ella pasan siempre las decisiones con mayor alcance del impacto y las más novedosas. La autonomía automatiza los juicios que el historial de resultados justifica delegar, dentro de unos límites que siguen siendo responsabilidad de una persona.
Los proveedores de servicios reconocerán la escala. El TM Forum describe las redes autónomas mediante niveles que van de L0, totalmente manual, a L5, con plena autonomía en todos los servicios y dominios. ETSI ZSM especifica los bucles cerrados que permiten llevar esos niveles a la práctica. La Escalera de Confianza recoge la misma idea y mide el avance según el historial de resultados del propio equipo. El diseño de este capítulo se sitúa en la franja media-alta de esa escala: los bucles cerrados actúan por sí solos dentro de unos límites, y las personas se ocupan de todo lo que queda fuera.
Empieza por el peldaño más conservador de todos: el modo Sombra, el peldaño de simulación de la Escalera de Confianza del capítulo 14, aplicado a un agente. Pon en marcha toda la capa de decisión, con el optimizador y el agente, con un solo cambio respecto al funcionamiento autónomo en producción: el agente propone y siempre decide una persona. En cada ventana de optimización, el agente genera el plan que habría aplicado, y cada plan queda registrado junto a lo que hizo en realidad el equipo de ingeniería. No cambias nada en la red y averiguas dos cosas que ninguna revisión de diseño puede decirte: si los planes del agente coinciden con el criterio de tu equipo de ingeniería y en qué puntos difieren y por qué.
Esas comparaciones son las primeras entradas del historial de resultados de la automatización. Con ellas, el agente se gana por primera vez la facultad de actuar de verdad. Tras varias semanas de planes en Modo Sombra que una persona habría aprobado, le permites aplicar por sí solo los cambios del nivel de riesgo más bajo, respetando las garantías mínimas y con la protección del despliegue canario, sin pasar a ningún nivel superior. Si una red autónoma nunca ha funcionado en Modo Sombra, confiar en ella es un acto de fe, precisamente lo que este libro ha desaconsejado en todas las capas.
En la mayoría de los equipos, el primer agente es un asistente de solo lectura para el personal de ingeniería, no un optimizador. Para responder a preguntas como «¿por qué esta sesión BGP se cae y se restablece continuamente?» o «¿qué conmutadores de acceso siguen ejecutando la imagen antigua?», consulta la Fuente de Verdad y la Observabilidad y, quizá, ejecuta algunos comandos show de solo lectura a través del Ejecutor. No cambia nada. Es el agente adecuado para empezar por tres razones.
Solo necesita herramientas de lectura, así que lo peor que puede hacer es dar una respuesta equivocada a alguien del equipo de ingeniería que lee todas sus respuestas. Genera su propio conjunto de evaluación: cada pregunta, la respuesta que dio y si quien la consultó la consideró correcta. Y enseña al equipo qué supone operar agentes, desde las trazas y el coste de los tokens hasta la elección del modelo, antes de que ningún agente pueda tocar la red.
Evalúalo como evaluarías a alguien que acaba de incorporarse al equipo durante su primer mes. ¿Son correctas sus respuestas? ¿Reconoce que no sabe la respuesta cuando es así? ¿Cita las fuentes que ha consultado? ¿Ahorra tiempo al equipo de ingeniería? Fija el criterio antes de empezar, por ejemplo, que las respuestas citen sus fuentes y sean correctas en nueve de cada diez casos. No le concedas ningún permiso de escritura hasta que cumpla ese criterio.
Además, necesita muchos menos componentes de la NAP. La capa de decisión de este capítulo da por supuesta toda la plataforma: una Fuente de Verdad con la intención efectiva, interfaces MCP, niveles de riesgo, simulación y el flujo de trabajo de cambio. Un asistente de solo lectura únicamente necesita los bloques arquitectónicos que consulta, a los que accede mediante herramientas de solo lectura. Si todavía no los tienes, sigue este orden: primero la Fuente de Verdad y la Observabilidad de la Parte 2, después un agente de solo lectura que las consulte y, por último, los controles de la Parte 3 antes de que ningún agente pueda escribir nada.
El paso de un primer agente a un equipo de agentes consta de cuatro etapas que muestra la Figura 18.9. Hay algo que se mantiene en todas ellas: la vía para recurrir a una persona, el interruptor de emergencia y el mecanismo de respaldo siguen disponibles.
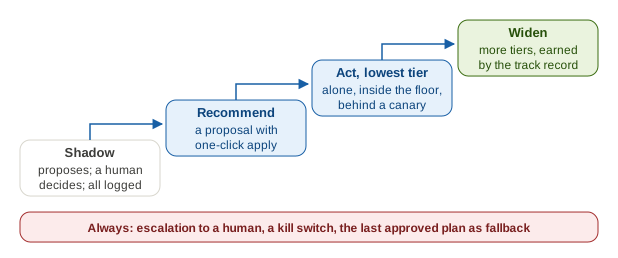
Empieza con un solo agente, una sola decisión y el Modo Sombra. Avanza a la siguiente etapa solo cuando el historial de resultados lo justifique y hazlo con un agente cada vez. Después, gestiona los agentes como el resto de la NAP:
- Mide su rendimiento. Incluye en los paneles de la NAP la tasa de aceptación de propuestas, la tasa de decisiones derivadas a una persona, la tasa de reversión y el consumo de tokens y la latencia por decisión, con sus respectivos objetivos, junto a los niveles de servicio del capítulo 12.
- Mantén un interruptor de emergencia. Uno por agente y otro para toda la capa de decisión. Al desactivar el agente o la capa, se vuelve al último plan aprobado. Es la degradación controlada que ya ofrece el diseño por capas.
- Publica versiones de los agentes como harías con el software. La versión del modelo, las instrucciones, la lista de herramientas y la instantánea de la memoria constituyen en conjunto una versión del agente. Todo cambio en cualquiera de esos elementos pasa por el flujo de trabajo de cambio, con el conjunto de evaluación como requisito para avanzar. La nueva versión funciona en Modo Sombra junto a la actual antes de sustituirla.
- Lleva un registro. Para cada agente constan el nombre de la persona responsable, la definición del agente, el nivel de riesgo más alto que tiene permitido, los resultados de su última evaluación y una fecha de revisión. Si un agente carece de responsable, se desactiva.
Con esa última regla se completa la analogía entre gestionar agentes y dirigir un equipo: cada agente tiene una persona que lo supervisa.
Resumen#
Las redes autónomas son complejas. Llevamos años oyendo hablar de ellas y solo hace poco han empezado a hacerse realidad. ¿Qué falta? Una disciplina que haga que la autonomía, además de inteligente, sea segura.
Las capacidades de la IA, disponibles desde hace años, combinadas con los últimos avances en los LLM y los marcos de desarrollo de agentes, han supuesto una gran revolución. Aun así, necesitan restricciones y una arquitectura de funciones cuidadosamente diseñada para aportar perspectivas distintas (por ejemplo, la de un optimizador matemático y la de un agente que razona) y adaptarse a objetivos operativos más sofisticados.
Este capítulo plantea una analogía entre gestionar agentes y dirigir personas. Estoy convencido de que hay más similitudes que diferencias, pero la amplitud de las relaciones humanas y la confianza construida durante siglos hacen que nos sintamos más cómodos con las personas. Sigues teniendo que responder de todo lo que decidan tus agentes, igual que responderías por un equipo que diriges. Eso exige delimitar con claridad la autoridad de cada cual, contar con aprobaciones y revisiones cuando hagan falta y hacer un seguimiento de todo el proceso para seguir mejorando.
Aquí termina la Parte 5 y, con ella, el libro. La red hace ahora tres cosas que no podía hacer cuando empezamos. Se ajusta a tu diseño de red, se adapta para proteger la experiencia de uso y propone optimizaciones dentro de unos límites. Todo sigue tus directrices. Sigues siendo quien responde de la red, pero ahora puedes dormir mejor sabiendo que seguirá haciendo lo que esperas de ella. Que la disfrutes.
Referencias#
- AI Engineering, Chip Huyen (O’Reilly, 2025). Desarrollo de aplicaciones a partir de modelos fundacionales. Abarca los agentes, la evaluación y los modos de fallo de los sistemas basados en LLM.
- Human Compatible: Artificial Intelligence and the Problem of Control, Stuart Russell (Viking, 2019). Examina cómo un objetivo mal especificado puede dar lugar a un resultado «óptimo pero equivocado», el fallo central de este capítulo, y defiende una autonomía con límites y con personas que rindan cuentas de sus decisiones.
- AI Agents: The Definitive Guide, Nicole Koenigstein (O’Reilly, 2026). Arquitecturas de agentes, uso de herramientas mediante MCP, seguridad y evaluación.
- Building AI Agents for Network Operations, Sif Baksh (Packt, 2026). Flujos de trabajo de NetOps basados en LLM que utilizan llamadas a herramientas y MCP, con mecanismos de aprobación, registro de actividad y pruebas piloto en modo de solo lectura.
- AI Agents in Action, Micheal Lanham (Manning, 2025). El desarrollo de sistemas multiagente con marcos como AutoGen y CrewAI y la memoria de los agentes constituyen la vertiente práctica de la sección Construcción de la capa de agentes.
- Machine Learning for Network and Cloud Engineers, Javier Antich (autoedición, 2023). Aprendizaje automático aplicado a las operaciones de red, desde la predicción hasta la detección de anomalías.
- Engineering Egress with Edge Fabric: Steering Oceans of Content to the World, Brandon Schlinker et al. (ACM SIGCOMM, 2017). Facebook aborda en producción el problema de este capítulo mediante la ingeniería de tráfico de salida, que tiene en cuenta el rendimiento de las conexiones de peering y de tránsito.
- Taking the Edge off with Espresso: Scale, Reliability and Programmability for Global Internet Peering, Kok-Kiong Yap et al. (ACM SIGCOMM, 2017). La infraestructura de peering definida por software en el borde de la red de Google elige la salida en función de las mediciones de rendimiento de las aplicaciones.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo