Redes con autorrecuperación#
En la misma CDN del capítulo 16, otro enlace de un ISP empezó a fallar, esta vez en el PoP de Ámsterdam (ya te dije que pasa muy a menudo). El ingeniero de guardia comprobó que, desde su punto de vista, todo estaba en orden: la configuración estaba sincronizada, las sesiones BGP estaban establecidas y así sucesivamente. El procedimiento de emergencia estaba claro: desviar el tráfico del circuito.
Sin embargo, aquel día, antes de desviar el tráfico, el ingeniero vio en la página de gestión de incidencias que una de las aplicaciones del servicio notificaba una pérdida de rendimiento. Relacionó ambos problemas y examinó lo que ocurría con el ISP del PoP desde distintos puntos de observación (otros PoP). Descubrió que la latencia entre los PoP a través de ese circuito había pasado de 40 a 130 milisegundos. Así encajaron las piezas: la red podía parecer en buen estado y, aun así, funcionar mal.
Lo revelador fue darse cuenta de que la información había estado ahí durante los cuarenta minutos que duró la degradación. Desde muchos de los otros PoP se podía reproducir la experiencia del usuario en la aplicación al conectarse a ese PoP a través de Internet. Así que bastaba con hacer esas mediciones y recoger los datos para deducir que el circuito del ISP tenía un mal día y localizar el problema (aunque las comprobaciones que se hacían entonces no lo ponían de manifiesto).
Este capítulo parte del bucle del capítulo 16. En el anterior, manteníamos la configuración alineada con la intención. Aquí mantenemos el buen funcionamiento del servicio cuando la configuración ya es correcta pero el servicio falla. ¿Cómo? Reproducimos la experiencia real del usuario y la observamos desde distintos puntos para detectar cuándo se degrada (antes de recibir un aviso de guardia o un tique de incidencia).
Es el segundo bucle de la parte 5 y aprovecha las mismas cinco etapas del capítulo 16.
Primero, distinguimos entre tener la configuración correcta y tener un servicio que funciona bien.
Cuando la configuración es correcta pero el servicio funciona mal#
Los sistemas complejos funcionan en modo degradado.
Richard Cook
El capítulo 16 terminó con un caso ambiguo que quedó sin resolver: un ISP operativo, bien configurado y que da servicio a los usuarios que le corresponden, pero con un rendimiento deficiente. Un ISP con un 4 % de pérdida de paquetes funciona en ese modo degradado. Para el bucle de conformidad, ese ISP está en buen estado, porque ni la configuración ni una entrada de la RIB indican la pérdida o la latencia. En este capítulo resolvemos el caso.
En este capítulo seguimos el caso de una red de distribución de contenidos y sus ISP, pero todo lo que veremos se aplica también a otras redes. En un centro de datos, si una malla de sondas entre racks detecta pérdidas en un enlace ascendente de un switch leaf, el mismo bucle desvía el tráfico de ese enlace. Para ello, aumenta su coste en BGP hasta que ECMP deja de utilizarlo. En una WAN, el encaminamiento de SD-WAN según la aplicación ofrece este mismo bucle como producto: sondas por camino, un umbral por aplicación y una política que desvía el tráfico. Si un producto ya ejecuta el bucle en su propio dominio, utilízalo. Implementa el bucle en la plataforma de automatización de redes (NAP) cuando la intención abarque varios fabricantes o dominios que queden fuera de la visibilidad del producto.
Ten presentes las dos preguntas. En el capítulo 16 nos preguntamos: ¿se ha desviado la configuración de la intención? En este capítulo nos preguntamos: ¿ha dejado de funcionar bien el servicio mientras la configuración seguía siendo correcta? Son fallos distintos que se detectan con sensores distintos. En el primer caso comparamos la configuración con un valor almacenado. En el segundo medimos lo que ocurre en el mundo real.
Una degradación parcial, en la que un camino sigue operativo pero rinde mal, pasa inadvertida para las dos defensas que suele tener una red. El mecanismo que comprueba si las sesiones siguen activas no da la alarma, porque busca la caída de un ISP o de una sesión y, durante una degradación parcial, todo sigue en pie. La comparación de configuraciones tampoco da la alarma, porque la configuración no ha cambiado. El ISP hace todo lo que se le ha pedido, solo que lo hace mal. Para detectarlo hay que medir el camino, no basta con inspeccionar el dispositivo. Y la red solo podrá medir el camino cuando tú le añadas esa capacidad.
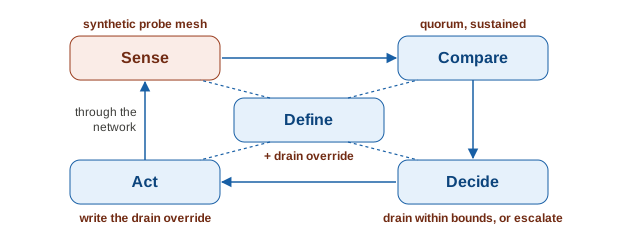
La Figura 17.1 muestra el bucle que construimos en este capítulo. Tiene las mismas cinco etapas que el de la Figura 16.1, con una nota junto a cada etapa que modificamos. En las secciones siguientes recorreremos las etapas una a una, empezando por el nuevo sentido que incorpora el bucle.
Monitorización sintética: el sentido que faltaba#
El sentido que faltaba es la monitorización sintética: las sondas activas generan tráfico de prueba y miden qué le ocurre, en vez de leer los contadores de un dispositivo. En el capítulo 7 construimos un conjunto amplio de herramientas de observabilidad, pero lo tratamos como un sistema principalmente pasivo: recoge lo que los dispositivos comunican sobre sí mismos. Cuando hay una degradación parcial en un ISP de tránsito, el dispositivo que la sufre no señala ningún problema porque, desde su punto de vista, todo está en orden.
Solo el tráfico que atraviesa el camino afectado sufre la pérdida de paquetes. Por eso, la única forma de detectar esa degradación es enviar tráfico por ese camino y medir qué le ocurre. La monitorización sintética pertenece al bloque de Observabilidad: las sondas son una entrada más del Recolector y sus resultados son una señal más que analiza Observabilidad, junto con los contadores y el estado de las rutas.
Esta tecnología es anterior a la mayoría de los sistemas de automatización y probablemente ya utilices parte de ella. Las sondas más sencillas son paquetes ICMP y UDP que permiten medir la alcanzabilidad, la pérdida de paquetes, la latencia y su variación. La mayoría de los routers pueden generar esas sondas y responder a ellas en el propio equipo mediante funciones como Cisco IP SLA o Juniper RPM. TWAMP (RFC 5357) estandariza la medición entre equipos de distintos fabricantes. Las sondas también pueden hablar el lenguaje de la aplicación: una petición Hypertext Transfer Protocol (HTTP) que mide cuánto dura la negociación TLS y cuánto tarda en llegar el primer byte mide lo que espera el usuario, más allá de lo que le ocurre a un paquete. Y adonde no llegan tus dispositivos pueden llegar las redes de sondas externas.
Las sondas tampoco son exclusivas de los ISP: sirven allí donde un camino pueda degradarse aunque todos los dispositivos sigan operativos. En un centro de datos, una malla completa de sondas entre racks localiza el enlace defectuoso que ningún switch señala. Pingmesh, de Microsoft, que encontrarás en las referencias del capítulo, lo hace a escala de centros de datos enteros. En un campus, una sonda que se ejecuta desde un equipo de prueba comprueba el estado del servicio en los controles que permiten pasar de una oleada a la siguiente en el capítulo 8.
En la conexión con la nube, mide el camino hasta una región del proveedor. Basta con construir una sola vez una cadena de medición común. Sus datos alimentan los controles entre oleadas, las herramientas de observabilidad del capítulo 7 y la evaluación de los niveles de servicio de la propia NAP en el capítulo 12, además del bucle de autorrecuperación que construimos en este capítulo.
Dos decisiones de diseño determinan si la medición tiene valor: desde dónde mides y qué envías.
Desde dónde mides. Un router no puede medir de forma fiable su propio enlace ascendente. Si el enlace falla, sus sondas sufren el mismo problema y el router carece de una referencia con la que comparar los resultados. Por eso se mide desde fuera: cada punto de presencia envía sondas a todos los demás a través de cada uno de sus ISP. El destino es un equipo que responde a las sondas en el punto de presencia remoto. Su dirección pertenece a un bloque que solo anuncia ese ISP, de modo que la sonda tiene que entrar por él.
El equipo que responde es un host dedicado o un reflector diseñado para realizar mediciones, como un reflector TWAMP asistido por hardware. Nunca se utiliza el propio router. Los routers limitan la tasa del tráfico dirigido a su propio plano de control y le dan menor prioridad. Una sonda que hace ping al router de un ISP indica pérdidas que nunca afectan al tráfico de los usuarios, que solo pasa por él.
Cada ISP se evalúa desde fuera, desde otros puntos de presencia que pueden seguir observándolo aunque el ISP falle. Con treinta puntos de presencia se forma una malla completa de gran tamaño, y ese tamaño es una ventaja: cuantos más puntos de observación independientes supervisen un ISP, más fiable será la evaluación de su estado.
No tienes que construir por tu cuenta toda la malla de puntos de observación. Las redes públicas de medición, como RIPE Atlas, y los servicios comerciales de monitorización sintética, como Catchpoint o ThousandEyes, que mantienen sondas en cientos de redes, te ofrecen puntos de observación fuera de tu infraestructura. Complementan tus propios puntos de presencia y son especialmente útiles para ver tus ISP tal como los ve la red de un usuario lejano, además de como los ven tus otras sedes.
Qué envías. Una sonda mide el camino que recorre, que no tiene por qué coincidir con el de la aplicación. La Figura 17.2 muestra la diferencia.
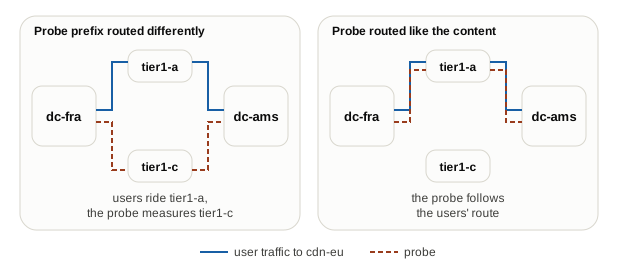
Si eres ingeniero de redes, verás dónde está la trampa. Entre ISP, el Border Gateway Protocol (BGP) elige el camino para cada prefijo de destino. Si envías una sonda a una dirección de un prefijo distinto del que aloja el contenido, puede salir o entrar por un ISP distinto del que utiliza el tráfico de los usuarios a los que representa. Así medirás con toda confianza un camino que esos usuarios nunca recorren. Por eso, cada equipo que responde a las sondas se sitúa en un prefijo para el que BGP elige el mismo ISP y el mismo camino que para el tráfico de contenidos al que representa.
La sonda también debe parecerse a ese tráfico en los demás aspectos. Si la red trata de forma distinta las clases DSCP, una sonda sin marcar mide una cola que la aplicación no utiliza. Usa el mismo protocolo y el mismo marcado que los flujos HTTPS a los que representa la sonda. Un sistema de monitorización sintética que no reproduce las características del tráfico al que representa es peor que no tener ninguno, porque da respuestas erróneas que parecen fiables.
La misma regla en un centro de datos. Dentro de un agregado de enlaces o de un grupo de caminos de igual coste, el camino no lo elige BGP. Lo determina, para cada flujo, una función hash aplicada a la quíntupla del paquete. Un flujo de sonda recorre un solo enlace del grupo y no dice nada de los demás. Varía, por tanto, uno de los campos que utiliza la función hash: mantén fijo el destino e incrementa el puerto de origen, con un flujo de sonda por puerto, hasta que por cada enlace haya pasado al menos un flujo. Una malla de sondas entre racks necesita ese barrido para localizar el único enlace con pérdidas en una red con ECMP.
Hay otra dimensión que determina qué representa una sonda: su familia de direcciones. Un ISP de doble pila transporta tráfico IPv4 e IPv6, a menudo por caminos internos distintos y con acuerdos de interconexión diferentes. Así, un mismo proveedor puede funcionar sin problemas con una familia y sufrir una degradación parcial con la otra. Una sonda mide la familia por la que se envía y no dice nada de la otra.
Por eso, la malla envía sondas por ambas familias, evalúa el cuórum para cada una por separado y también desvía el tráfico por familia: puedes retirar las rutas IPv6 de un ISP y mantener sus rutas IPv4 en servicio si el problema afecta solo a IPv6. Emitir un único diagnóstico sobre el estado de un ISP para ambas familias oculta las degradaciones que afectan solo a una de ellas, frecuentes en las redes reales.
Tres detalles determinan si las cifras significan lo que parecen indicar.
- Sincronización de los relojes. Para medir el tiempo de ida y vuelta no hace falta sincronizar los relojes. En cambio, para medir el retardo en un solo sentido, que te indica en qué dirección está el problema, los relojes deben estar sincronizados con suficiente precisión, normalmente mediante PTP o mediante el Network Time Protocol (NTP) con un ajuste cuidadoso de los relojes. TWAMP admite ambos tipos de medición.
- Definiciones comunes. Los RFC del IETF sobre métricas de rendimiento de Internet Protocol (IP) definen con precisión la pérdida y el retardo (RFC 7679 para el retardo en un solo sentido y RFC 7680 para la pérdida). Conviene adoptar esas definiciones para que, cuando dos herramientas indiquen «pérdida», se refieran a lo mismo.
- Valores de referencia. Compara cada lectura con el valor de referencia del propio camino. La latencia varía según la hora, y por eso los umbrales que veremos más adelante en este capítulo se definen en relación con los valores habituales.
Una vez que llegan mediciones fiables de cada ISP desde numerosos puntos de observación, la pregunta es cuándo darles crédito. La Figura 17.3 muestra la respuesta.
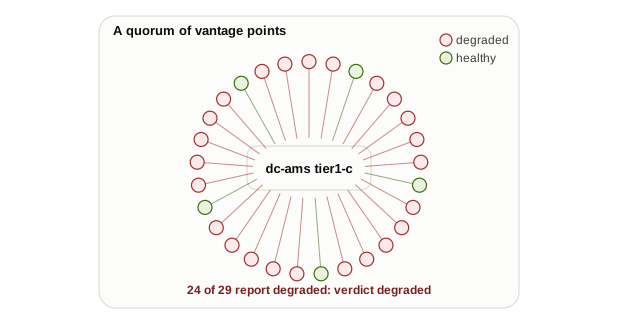
La respuesta es una regla de cuórum (quorum rule): considera degradado un ISP solo cuando coincida en el diagnóstico una fracción configurada de los puntos de observación remotos e independientes. Esa fracción es el cuórum. Si un solo punto de presencia detecta pérdidas hacia un ISP, es más probable que se trate de un problema en esa sede o de una anomalía puntual en el trayecto de una sonda que de un fallo real del ISP. Si un cuórum de sedes independientes detecta la misma degradación, ya tienes un dato sobre el propio ISP.
El cuórum convierte un conjunto de mediciones individuales con mucho ruido en un único veredicto fiable. Así, el bucle puede actuar sin que una persona tenga que comprobar si cada lectura tiene sentido. A esta escala, la fracción que elijas influye de verdad en el resultado. La sección De la señal a la decisión explica cómo fijarla. Con cuatro sedes y tres puntos de observación, el cuórum apenas tiene peso. Con treinta sedes, sí. Aplícalo siempre que una medición distribuida desencadene una acción automatizada, porque basta con que un solo punto de observación dé una lectura falsa para provocar una retirada innecesaria de tráfico.
El cuórum parte de un supuesto que conviene proteger: los puntos de observación fallan de forma independiente. Si varias de tus sedes comparten una conexión aguas arriba, ya sea un proveedor de tránsito o un punto de interconexión, muchos puntos de observación pueden coincidir por el motivo equivocado. La Figura 17.4 muestra el patrón que delata esa dependencia.
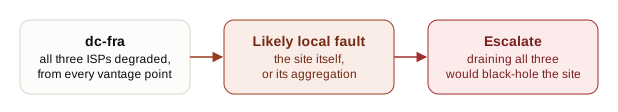
Si todos los puntos de observación detectan degradación al mismo tiempo hacia todos los ISP de una sede, casi con toda seguridad el fallo está en la propia sede o en su red de agregación. Es muy improbable que todos sus ISP fallen por casualidad a la vez. Retirar el tráfico de todos los ISP de la sede la dejaría incomunicada, así que el bucle escala la incidencia.
Los resultados de las sondas son un flujo de telemetría más. Recorren la misma cadena de recogida, normalización y almacenamiento que los demás flujos de telemetría. Al Recolector le da igual si una medición procede de un contador de dispositivo o de una sonda sintética. A gran escala, lo que debes vigilar es la malla, porque una malla completa de mediciones desde los puntos de observación hacia los ISP crece con el cuadrado del número de sedes.
Con treinta puntos de presencia, si cada uno sondea tres o cuatro ISP en cada uno de los demás, ya tienes varios miles de pares de origen y destino de sondeo. Con esa cardinalidad, tienes que equilibrar la frecuencia de recogida y el muestreo con los mismos criterios que aplica el Capítulo 7 a cualquier flujo de telemetría de gran volumen. Reduce la frecuencia de sondeo, selecciona una muestra de puntos de observación o introduce una jerarquía antes de que la malla supere la capacidad de la cadena.
Las sondas y el cuórum dan un veredicto. El siguiente paso es convertirlo en algo que permita actuar al bucle.
De la señal a la decisión#
El veredicto del cuórum todavía no es una decisión. Para convertirlo en una decisión hacen falta tres pasos. Cada uno protege frente a una situación en la que el bucle podría hacer más daño que bien.
Exige que la degradación persista. Una sola muestra con degradación, aunque la confirme el cuórum, indica un pico puntual, no una degradación sostenida del servicio. Exige que la degradación se mantenga durante varios intervalos consecutivos antes de darla por confirmada. Pongamos cifras: sondea cada ISP cada 30 segundos y exige que la degradación persista durante cuatro intervalos. Así, el bucle detecta una degradación real del servicio en unos dos minutos y descarta una muestra anómala aislada. Por el mismo motivo, un ingeniero de redes aplica esa misma histéresis para amortiguar las fluctuaciones de rutas. Esos dos parámetros, el intervalo de sondeo y el número de intervalos durante los que debe persistir la degradación, determinan por completo el equilibrio entre la rapidez de reacción y la frecuencia con la que reaccionas sin motivo. Los cuarenta minutos del caso inicial se reducen a dos, a costa de fijar en dos minutos el tiempo mínimo de detección.
Correlaciona el ISP degradado con el tráfico que realmente cursa. Lo que importa es el servicio, no el ISP en sí. El bucle identifica los conjuntos de prefijos y los usuarios cuyo tráfico pasa por el ISP degradado y, a partir de ahí, el tráfico de distribución de contenidos afectado. La decisión se basa entonces en que «el tráfico de estos usuarios pasa por un ISP degradado», no en que «un ISP tiene un 4 % de pérdidas».
Emite un evento de estado que el software pueda procesar, con los mismos datos para pasar de la alerta a la acción que especifica la sección Interfaz entre la alerta y la acción del Capítulo 7. Su estructura está pensada para la siguiente etapa, no para que lo lea una persona:
health_event:
  isp: dc-ams tier1-c
  family: ipv6
  verdict: degraded
  quorum: 24_of_29
  metrics: {loss_pct: 4.1, rtt_ms: 28, jitter_ms: 6}
  sustained_intervals: 4
  affected_prefix_sets: [cdn-eu]
  correlated_site_failure: false
  detected_at: 2026-07-16T09:42:00Z
Fijar el umbral a partir del cual se considera que un ISP está «degradado» es la cuestión central del diseño, y no depende solo del equipo de redes. El equipo que opera el servicio de contenidos sabe qué niveles de pérdida y latencia pueden tolerar sus usuarios antes de que les afecten. El equipo de redes no lo sabe.
Por eso, quien consume el servicio define qué se considera «malo»: el equipo que opera el servicio de contenidos fija su propia tolerancia mediante una interfaz de programación de aplicaciones (API) de autoservicio y la NAP la aplica. Aquí entra en la parte 5 la visión de la red como producto que presenta el Capítulo 15. La red es un servicio, el equipo de contenidos es su cliente y el comportamiento que obtiene el cliente cuando se retira tráfico constituye el acuerdo de nivel de servicio (SLA).
La API debe ser sencilla. En este caso, la sencillez también sirve de protección. No permitas que quien consume el servicio introduzca directamente valores numéricos. Ofrece niveles de tolerancia con nombre (sensibilidad baja, media y alta) que la NAP traduzca en umbrales concretos (porcentaje de pérdidas, latencia máxima y número de intervalos durante los que debe persistir la degradación) y almacene en la Fuente de Verdad (SoT). Un servicio de sensibilidad alta retira el tráfico de un ISP con un 2 % de pérdidas.
Un servicio sin garantías tolera un 8 %. Los niveles con nombre cumplen dos funciones a la vez. Evitan que el consumidor tenga que elegir cifras para las que carece de criterio. Además, acotan los valores de entrada, de modo que un cliente no pueda fijar un umbral extremo que provoque oscilaciones en la red o deje el servicio por debajo de su nivel mínimo. El producto ofrece opciones, no parámetros de ajuste, y todas las opciones son seguras.
La Tabla 17.1 ofrece un punto de partida que debes ajustar para cada servicio:
| Tolerancia | Pérdidas | Latencia por encima del valor de referencia | Intervalos consecutivos con degradación |
|---|---|---|---|
| Alta | 2 % | 20 ms | 3 |
| Media | 4 % | 40 ms | 4 |
| Baja | 8 % | 80 ms | 6 |
La Figura 17.5 muestra qué se consigue al ajustar el valor de la última columna. Las curvas son ilustrativas.
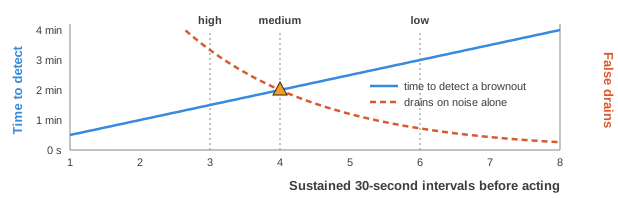
Cada intervalo adicional alarga la detección 30 segundos y reduce las retiradas de tráfico causadas por el ruido. El nivel medio se sitúa en el cruce de las curvas. El nivel alto reacciona antes y acepta más retiradas innecesarias.
Distingue los dos parámetros. La tolerancia de la Tabla 17.1 determina qué se considera degradación desde un punto de observación. El cuórum determina cuántos puntos deben coincidir para que el bucle dé por válida esa degradación. Con veintinueve puntos de observación, una mayoría simple de quince ya basta para que un solo punto equivocado resulte inofensivo. Una mayoría cualificada (por ejemplo, los 24 de 29 del evento anterior) tarda algo más en alcanzarse, pero descarta casi todo el ruido correlacionado. Elige en función del coste que tenga para el servicio una retirada de tráfico innecesaria: si el coste es bajo, utiliza la mayoría simple para reaccionar antes. Si es alto, espera a la mayoría cualificada.
El evento de estado ya indica qué ISP está degradado y a quién afecta. A continuación veremos cómo desvía el tráfico el bucle.
Autorrecuperación mediante una capa de intención dinámica#
Al igual que el evento de desviación del Capítulo 16, el evento de estado es un evento, no un informe. Lo emite la capa de Observabilidad y desencadena un flujo de trabajo de corrección en el Orquestador (Capítulo 8). Ambos bucles utilizan el mismo mecanismo para pasar el control mediante un evento. Para recuperar el servicio hay que desviar el tráfico. Cómo registra ese desvío el flujo de trabajo es la decisión de diseño central del capítulo: determina si este bucle coopera con el del Capítulo 16 o entra en conflicto con él.
El enfoque equivocado consiste en acceder al dispositivo y cambiar directamente la política BGP fuera de banda. Si lo haces, el bucle de conformidad del Capítulo 16, que sigue en marcha, recupera la configuración en ejecución, encuentra una retirada de tráfico que no figura en la intención declarada, la clasifica como desviación y la revierte. En cada ciclo, un bucle deshace lo que hace el otro.
El enfoque correcto consiste en usar una capa de intención dinámica: el mecanismo de autorrecuperación no modifica la intención declarada ni toca los dispositivos fuera de banda. Genera y registra de forma automática una excepción temporal (override) con un plazo de validez que indica, en el mismo modelo de intención que utiliza la persona, «por ahora, retira de dc-ams tier1-c el tráfico de cdn-eu». A continuación, la red se concilia con la intención efectiva (effective intent), que resulta de aplicar a la intención declarada todas las excepciones activas. El bucle del Capítulo 16 reconoce la retirada de tráfico como parte de la intención efectiva y la aplica en lugar de contrarrestarla. Los dos bucles funcionan juntos porque leen la misma combinación de intenciones, como muestra la Figura 17.6.
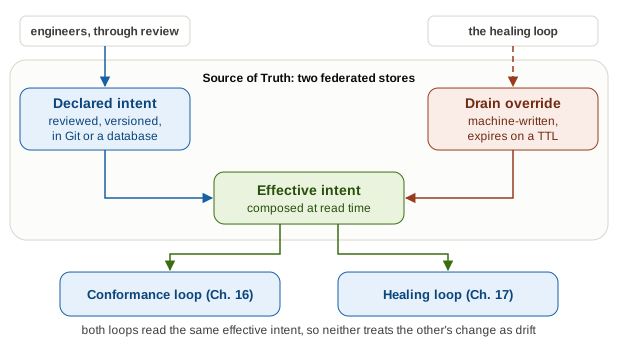
Las excepciones temporales forman un conjunto de registros breves, uno por cada retirada de tráfico activa. Se guardan junto a la intención declarada, pero fuera de ella. Las excepciones y la intención declarada suelen residir en almacenes distintos porque se comportan de manera diferente. La intención declarada cambia despacio, pasa por revisión y se mantiene bajo control de versiones, por lo que encaja bien en Git o en la Fuente de Verdad.
Las excepciones cambian deprisa, las escribe el software y tienen una vida corta, por lo que encajan en un almacén operativo diseñado para escribir registros y hacerlos caducar con rapidez. Ambos almacenes pertenecen al bloque de la Fuente de Verdad, como muestra la Figura 17.6. En el momento de la lectura, se combinan los datos de ambos para obtener la intención efectiva. Es la idea de federación del Capítulo 5, una vista única de varios almacenes, aplicada a la propia intención. El listado que aparece más adelante en esta sección muestra un registro de excepción temporal.
Esta combinación tiene un modo de fallo que debes prever desde el diseño. Si el bucle pierde el acceso al almacén de excepciones, no debe pasar sin aviso a usar solo la intención declarada: cancelaría de golpe todas las retiradas de tráfico activas y devolvería el tráfico a los ISP de los que acaba de apartarlo. La respuesta segura consiste en conservar la última intención efectiva conocida y emitir una alerta de que el almacén de excepciones no está disponible. Ante el fallo, el bucle mantiene el estado previo y en ningún caso levanta las restricciones.
Para entender qué significa «retirar el tráfico» en la práctica, hay que distinguir entre tráfico saliente y entrante, como hicimos en el Capítulo 16. Aquí, todo depende de esa distinción. El punto de presencia controla el tráfico saliente, es decir, el contenido que envía de vuelta a sus usuarios. Reduce la preferencia local o el peso de las rutas del ISP degradado y el propio mecanismo de selección de rutas del punto de presencia pasará enseguida esas respuestas a sus otros ISP.
En el tráfico entrante, las solicitudes que los usuarios envían a través de ese ISP, el punto de presencia solo puede influir. Puede hacer que el anuncio del ISP resulte menos atractivo repitiendo el AS en el AS-path o utilizando una comunidad que el proveedor de tránsito interprete y aplique. También puede retirar por completo el anuncio del prefijo de contenidos a ese ISP. Después, espera a que reaccione Internet.
Dos herramientas estándar hacen la mayor parte de este trabajo. La primera es la comunidad BGP bien conocida GRACEFUL_SHUTDOWN (RFC 8326), que pide al vecino que reduzca la preferencia de las rutas que ha aprendido de ti antes de que retires ningún anuncio. Así, el tráfico cambia de ruta antes de que se pierdan paquetes. La segunda es el conjunto de comunidades de acción que publica la mayoría de los proveedores de tránsito, como «repite el AS en los anuncios hacia esta región» o «no anuncies a ese vecino». Estas comunidades permiten dirigir el tráfico entrante con más precisión que la retirada del prefijo. Al generar la configuración, la excepción temporal de retirada de tráfico se traduce en el uso de estas comunidades.
Por tanto, retirar todo el tráfico de un ISP degradado exige dos acciones con distinto grado de certeza: un desvío inmediato y fiable del tráfico saliente que controlas y un intento más lento, sin garantías, de desviar el tráfico entrante que no controlas. Si das por hecho que el tráfico entrante cambiará de ruta con la misma rapidez y certeza que el saliente, es fácil que te sorprenda por dónde acaban entrando los usuarios.
Aquí se ve el valor de una regla que el Capítulo 16 siguió por adelantado: el bucle comparaba el estado de la red con la intención efectiva incluso cuando el conjunto de excepciones estaba siempre vacío. Ahora hay excepciones y no hace falta cambiar nada en el Capítulo 16.
Tres propiedades hacen que la excepción sea segura.
Sigue un orden. El bucle escribe primero la excepción. Después genera a partir de plantillas la configuración de drenaje y la aplica con los mismos mecanismos del capítulo 16: el flujo de trabajo de cambio del capítulo 11, con sus oleadas y su reversión, y el registro de auditoría del capítulo 13. Un drenaje autónomo pasa por los mismos controles que un cambio realizado por una persona, sin saltarse ninguno. Por eso, en parte, es seguro ejecutarlo sin supervisión. Escribir la intención antes de modificar el dispositivo evita una condición de carrera: si el bucle de conformidad se activase entre la aplicación del cambio y la escritura de la excepción, interpretaría momentáneamente el drenaje como una desviación de la configuración.
Tiene límites. El drenaje respeta el nivel mínimo de servicio. En el capítulo 16, ese mínimo era solo un dato del modelo. Aquí se convierte en un límite que el bucle hace cumplir. El bucle no drenará un ISP si eso deja a un conjunto de prefijos con menos ISP en buen estado de los que necesita como mínimo.
Además, tiene en cuenta la capacidad, una comprobación en la que insistirá cualquier ingeniero de redes. Drenar un ISP que funciona con un rendimiento degradado traslada el tráfico de sus usuarios a los demás. Si estos no pueden absorberlo, el remedio es peor que la enfermedad. Las sondas sintéticas no pueden medir ese margen, porque ni la pérdida de paquetes ni la latencia indican cuánto ancho de banda queda libre. Ese dato lo aporta la telemetría pasiva de utilización del capítulo 7: el bucle consulta los contadores de las interfaces y la matriz de tráfico junto con el veredicto de las sondas. Solo ejecuta el drenaje cuando los ISP restantes tienen margen para asumir el tráfico que se dispone a desviar. Si no lo tienen, escala el incidente en vez de trasladar la congestión sin avisar.
Sin embargo, el margen por sí solo no basta, porque los ISP no son intercambiables. Un proveedor de tránsito da acceso a todo Internet. Un operador con el que intercambias tráfico sin compensación económica solo ofrece rutas hacia sus propios clientes. Puede absorber el tráfico de los prefijos que alcanza, pero descartaría el resto. Para recibir el tráfico de un drenaje, un ISP debe cumplir dos condiciones: tener margen suficiente y ofrecer rutas a los destinos afectados. Si el ISP degradado es el único que llega a esos destinos, no hay ningún otro al que se pueda desviar el tráfico con seguridad. El bucle escala el incidente en vez de convertir una degradación parcial en una interrupción del servicio.
Se revierte sola y la medición continúa durante el drenaje. Al drenar un ISP se desvía el tráfico de los usuarios, lo que plantea una pregunta razonable: si ya no pasa tráfico por él, ¿cómo sabe el bucle cuándo se ha recuperado? La malla no depende del tráfico de los usuarios. Las sondas siguen enviando peticiones al equipo que responde en una dirección del espacio de ese ISP. Aunque se retire el prefijo de contenido, la ruta a esa dirección sigue pasando por el ISP. Los mismos puntos de observación que detectaron la degradación siguen vigilando el ISP mientras está fuera de servicio. Cuando coinciden, según la misma regla de cuórum y el mismo requisito de persistencia, en que el ISP lleva suficiente tiempo en buen estado, la excepción caduca y la intención efectiva vuelve a coincidir con la declarada. El drenaje se revierte solo. Nadie tiene que acordarse de deshacerlo seis semanas después.
La Figura 17.7 muestra cómo se comprueban los límites en Ámsterdam en dos días distintos, con el mismo ISP degradado.
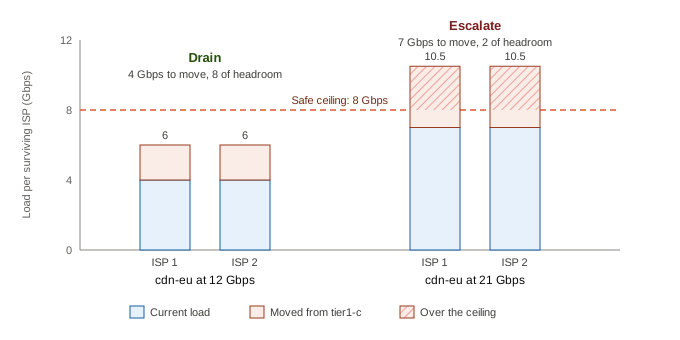
Para ver cómo se comprueban los límites, aplica las cifras del modelo. Los enlaces ascendentes de Ámsterdam siguen el mismo modelo que los de Fráncfort en el capítulo 16: la sede da servicio a cdn-eu a través de tres ISP con capacity_gbps: 10 cada uno. La NAP fija en el 80 % la utilización máxima segura de cada enlace, por lo que se pueden utilizar 8 Gbps en cada uno.
Supón que cdn-eu consume 12 Gbps, repartidos por igual a razón de 4 Gbps por ISP, y que el ISP degradado es tier1-c. Si lo drenas, los otros dos tendrán que absorber 4 Gbps. Cada uno tiene 4 Gbps libres (8 utilizables menos 4 en uso), es decir, 8 Gbps entre los dos. Por tanto, el bucle ejecuta el drenaje y cada ISP restante se estabiliza en 6 Gbps, por debajo de su límite.
Supón ahora que cdn-eu consume 21 Gbps, 7 por ISP. A cada ISP restante solo le queda 1 Gbps libre. Entre los dos suman 2 Gbps frente a los 7 que hacen falta. El drenaje los saturaría, así que el bucle escala el incidente. El ISP degradado es el mismo, pero la decisión es la contraria. La telemetría de utilización permite distinguir los dos casos.
Cada registro de excepción es pequeño y se describe a sí mismo. Forma parte del mismo modelo de intención que la capa declarada, de modo que el bucle puede leer ambos elementos en conjunto:
override:
  drain: dc-ams tier1-c
  prefix_set: cdn-eu
  family: ipv6
  reason: quorum-degraded
  quorum: 24_of_29
  created_at: 2026-07-16T09:42:07Z
  ttl: 30m
restore_when: healthy for 4 intervals by quorumEl registro es también un pequeño ejemplo del modelado de la capa técnica del capítulo 4: ningún producto lo incluye de serie. Tú diseñas el modelo, con el grado de detalle que necesites, para llevar el seguimiento de un tipo de intención de tu red.
El registro contiene todo lo que requieren las tres propiedades: qué se debe drenar, para qué conjunto de prefijos y por qué. El registro de auditoría conserva esa información. También recoge cuándo se escribió la excepción, su tiempo de vida y la condición que le pone fin. Ese tiempo de vida evita que la excepción siga vigente cuando ya no sea útil, como puede ocurrir con un drenaje manual sin documentar. La intención efectiva es el resultado de aplicar este registro al modelo declarado.
El tiempo de vida es un plazo renovable, no una cuenta atrás para poner fin al drenaje. Mientras el cuórum siga indicando que el ISP está degradado, el bucle renueva el plazo. Si deja de recibir las señales que necesita y no puede renovarlo, escala el incidente antes de que venza. La excepción se mantiene hasta que una persona decida qué hacer. Ante un fallo, se conserva el estado, la misma regla que se aplica al almacén de excepciones.
Esas tres propiedades también son las que permiten que el bucle actúe por su cuenta. El apartado Cumplimiento continuo y corrección de desviaciones del capítulo 13 establecía la regla, que ilustra la Figura 13.11: aplica la corrección automática solo cuando restablecer la intención no afecte al plano de reenvío y sea poco probable que el cambio haya sido deliberado. En los demás casos, avisa y espera. Un drenaje desplaza tráfico, así que no supera la primera prueba.
Por eso, en el capítulo 16, la regla para el encaminamiento era avisar y esperar. El drenaje como medida de autorrecuperación es una excepción deliberada por dos razones. La primera es que responde a un incidente, y un incidente no espera a que llegue una persona ni a que se abra una ventana de cambio. La segunda es que las tres propiedades permiten ejecutarlo con seguridad sin supervisión: el nivel mínimo de servicio y la comprobación de capacidad acotan el drenaje, y el drenaje se revierte solo.
El drenaje de un ISP es una de las muchas medidas correctivas que siguen este esquema. Estas son las que los equipos suelen automatizar primero, ordenadas aproximadamente de menor a mayor riesgo:
- Reactivar un puerto deshabilitado por un error cuando haya desaparecido la causa, si es conocida y benigna: acción automática.
- Drenar el tráfico de un enlace con un número creciente de errores de CRC o FEC que forme parte de un grupo ECMP o de un agregado de enlaces: acción automática, sujeta a las mismas comprobaciones de nivel mínimo de servicio y capacidad.
- Desactivar y volver a activar un puerto de acceso tras un fallo de 802.1X o DHCP en un único equipo terminal: acción automática, con un límite de frecuencia por puerto.
- Reiniciar una sesión BGP bloqueada que siga caída una vez vencido el temporizador: al principio, el bucle recomienda la acción. La ejecuta automáticamente cuando el historial de resultados lo justifica.
- Reducir el peso de un enlace sobrecargado: el bucle se limita a recomendar la acción hasta que el equipo confíe en el modelo de capacidad.
- Responder a una alarma de hardware (de un ventilador, una fuente de alimentación o un módulo óptico): el bucle se limita a recomendar la intervención. La reparación requiere una pieza de repuesto, así que el bucle drena el tráfico y abre una incidencia sin intervenir en el dispositivo.
Todas estas acciones se ejecutan con los mismos mecanismos: un evento de Observabilidad, un flujo de trabajo en el Orquestador y el Ejecutor. Esta categoría se denomina automatización basada en eventos. Event-Driven Ansible y StackStorm son dos ejemplos habituales.
Ese es el objetivo ideal. El resto del capítulo aborda lo que ocurre cuando algo sale mal.
Límites, riesgo y Escalera de Confianza (Confidence Ladder)#
Cuando una medida se convierte en un objetivo, deja de ser una buena medida.
Goodhart’s Law
La autorrecuperación marca el punto de este libro en el que la automatización empieza a hacer cambios en producción por su cuenta. Por eso merece más atención cómo falla que cómo funciona. Empecemos por el fallo del que advirtió Goodhart.
- Una recuperación que oculta la causa. El fallo más insidioso es que la recuperación funciona. Si un ISP sufre una degradación parcial todas las tardes y el bucle lo drena todas las tardes, el panel de control da a entender que el bucle cumple su cometido. En realidad, oculta un problema crónico del ISP que habría que comunicar al operador mediante una incidencia o tratar con el equipo de compras, en vez de repetir indefinidamente los drenajes automáticos. El bucle debe llevar la cuenta. Si drena varias veces el mismo ISP en un intervalo determinado, corresponde escalar el incidente. No tiene sentido seguir intentando la recuperación: al absorber el impacto en silencio, la propia automatización impide que alguien corrija la causa. Conseguir que el panel indique que todo va bien se ha convertido en el objetivo. Es la ley de Goodhart en acción.
- Oscilaciones. La histéresis debe actuar en ambos sentidos: drenar cuando la degradación se mantiene y restablecer el servicio cuando la recuperación también se mantiene. Sin ella, un ISP que ronde el umbral entrará y saldrá de servicio repetidamente, y cada transición provocará un cambio de encaminamiento que se hará sentir en toda la red. El requisito de persistencia del apartado De la señal a la decisión y un tiempo de espera deliberado antes de restablecer el servicio evitan que un ISP que funciona al límite se convierta en un metrónomo.
- Alcance del impacto. El nivel mínimo de servicio y la comprobación de capacidad imponen límites estrictos, no preferencias. Imagina un mal día en Internet, con varios ISP degradados a la vez. Un bucle que drene sin aplicar esos límites puede dejar a un conjunto de prefijos sin ninguna ruta o desviar su tráfico a un ISP que se sature de inmediato. El nivel mínimo y la comprobación de capacidad marcan la diferencia entre recuperar el servicio e interrumpirlo.
- Un diagnóstico equivocado. El sistema de autorrecuperación puede, sencillamente, equivocarse de causa. Si drenar un ISP no restablece el servicio, el problema no era ese ISP e insistir en el drenaje solo añade cambios inútiles. El bucle comprueba si el drenaje ha servido de algo observando si se recupera el servicio afectado. Si no se recupera, se detiene y entrega el incidente a una persona junto con todo lo que ha observado. El fallo correlacionado del apartado Monitorización sintética es otro motivo para detenerse: todos los puntos de observación detectan problemas a la vez hacia una misma sede. Un sistema de autorrecuperación que no sabe cuándo parar es una forma automatizada de agravar un incidente.
- Pérdida de sus propias señales. El sistema de autorrecuperación depende tanto de la malla de sondas como del mecanismo que combina las mediciones de los puntos de observación para emitir un veredicto por cuórum. Ambos pueden fallar. La regla es que, ante un fallo, el bucle actúe de forma segura: sin datos fiables no hay drenaje. Nunca se drena por una suposición. El bucle emite una alerta bien visible de que el sistema de autorrecuperación se ha quedado a ciegas, para que el operador sepa que ha perdido esa red de seguridad. También se supervisan la propia malla de sondas y el agregador, del mismo modo que en el capítulo 12 se supervisa la propia NAP. Un sistema de autorrecuperación incapaz de detectar que ha perdido sus propias señales es más peligroso que prescindir de la automatización, porque los operadores han relajado la vigilancia precisamente sobre aquello que ha dejado de funcionar.
El primer modo de fallo, la recuperación que oculta la causa, es interesante porque, cuando tu automatización enmascara incidencias de red al resolver problemas ajenos, el problema de fondo persiste y nadie lo soluciona. Le pasó a mi equipo: al revisar los registros, descubrimos que un ISP funcionaba muy mal. No habíamos abierto una incidencia porque nuestra automatización sorteaba el problema de ese operador. Más adelante, cuando otro ISP tuvo un mal día, los dos problemas coincidieron y la capacidad total se resintió.
Estos modos de fallo determinan dónde se sitúa la autorrecuperación en la Escalera de Confianza del capítulo 14: por encima de la conformidad. Hace algo más que mantener la red ajustada a un valor almacenado: modifica la red en respuesta a lo que ocurre en su entorno, sin preguntar primero. Eso es autonomía de verdad, y se gana con el historial de resultados de la automatización que vimos en el capítulo 14. ¿Con qué frecuencia acertó el veredicto del cuórum al identificar una degradación real? ¿Cuánto tiempo transcurrió desde la primera muestra que indicaba degradación hasta el drenaje? ¿Con qué frecuencia restableció el servicio un drenaje y cuántas veces hubo que revertirlo o escalar el incidente?
Compruébalo en un laboratorio antes de pasar a producción. Con netem, el módulo de control de tráfico de Linux, puedes introducir pérdida de paquetes y latencia en un enlace de una topología de containerlab. Basta con eso para observar cómo se alcanza el cuórum, cómo se ejecuta el drenaje y cómo caduca la excepción, todo ello sin sufrir una degradación real.
El punto de partida es el mismo que en el capítulo 16: detecta antes de drenar. La versión mínima viable consta de la malla completa, la regla de cuórum y el evento que informa del estado del servicio. El ingeniero de guardia recibe ese evento en forma de recomendación: «Un cuórum de 24 de 29 indica que tier1-c está degradado en dc-ams. Afecta a cdn-eu. Se recomienda el drenaje». El drenaje se ejecuta con una sola acción que confirma una persona. Solo con eso, los cuarenta minutos de silencio del relato inicial se habrían quedado en unos minutos hasta recibir una alerta y hacer clic, sin riesgo de que el bucle drenase nada por su cuenta.
Espera hasta que el historial de resultados de la automatización demuestre que los veredictos son fiables y los drenajes ayudan a recuperar el servicio. Solo entonces deja que el propio bucle escriba la excepción. Empieza por los conjuntos de prefijos menos críticos y respeta siempre el nivel mínimo de servicio y la comprobación de capacidad. Un equipo capaz de ver de forma fiable una degradación parcial mediante un cuórum ya ha recorrido buena parte del camino para corregirla.
Resumen#
Cada escenario de red exige un enfoque ligeramente distinto para los mecanismos de autorrecuperación. El requisito básico es poder introducir monitorización sintética (o aprovechar el tráfico de producción, si está disponible) para evaluar la experiencia real de quienes utilizan tu red.
En el escenario de la CDN, medir el rendimiento de un único circuito desde varios puntos de observación aporta información suficiente para aplicar una regla de decisión (por ejemplo, el veredicto por cuórum). Así puedes determinar cuándo algo no funciona como esperas y necesitas mitigar sus efectos, aunque el estado observado coincida con tu intención de red. El bucle comprueba continuamente si persisten las condiciones que justifican esa excepción de mitigación, y la excepción acaba desapareciendo.
El bucle cerrado del capítulo 16 hacía cumplir el estado deseado. En este capítulo incorporamos a la ecuación la tolerancia que fija una persona y actuamos en consecuencia: creamos una excepción a la intención a partir de una lógica definida por una persona. Esto está muy bien, pero se limita a una decisión binaria: drenar o no drenar, dentro de unos límites de seguridad. El capítulo 18 parte de aquí y presenta las redes autónomas, que resuelven un problema de optimización matemática con ayuda de la IA y de marcos de trabajo basados en agentes.
Referencias#
- Pingmesh: A Large-Scale System for Data Center Network Latency Measurement and Analysis, Chuanxiong Guo et al. (ACM SIGCOMM, 2015). Una malla completa de sondas que abarca los centros de datos de Microsoft: la versión para centros de datos de la monitorización sintética de este capítulo.
- Computer Networking Problems and Solutions, Russ White y Ethan Banks (Addison-Wesley, 2017). Encaminamiento, ingeniería de tráfico y medición a partir de sus principios fundamentales.
- Site Reliability Engineering, Betsy Beyer, Chris Jones, Jennifer Petoff y Niall Richard Murphy (O’Reilly, 2016). Los objetivos de nivel de servicio y la disciplina de actuar a partir de mediciones del estado del servicio, que sirven de base para la tolerancia que fija quien consume el servicio y para la decisión de iniciar la recuperación. (Texto completo disponible gratis en línea.)
- Feedback Control for Computer Systems, Philipp K. Janert (O’Reilly, 2013). Histéresis, amortiguación y estabilidad, las herramientas que evitan que el bucle de autorrecuperación ponga y quite de servicio repetidamente un ISP que funciona al límite.
- Internet Routing Architectures, 2nd Edition, Sam Halabi y Danny McPherson (Cisco Press, 2000). Control de rutas BGP e ingeniería de tráfico: los mecanismos que permiten drenar un ISP mediante la preferencia local, las comunidades y el control de los anuncios de rutas.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo