Automatización en bucle cerrado#
La red de distribución de contenidos (CDN) tenía treinta puntos de presencia (PoP) repartidos por todo el mundo. La arquitectura era prácticamente la misma en todos: cada uno se conectaba a la Internet pública a través de unos pocos ISP (3 o 4, además de unas cuantas interconexiones locales de peering). En condiciones normales, con la configuración predeterminada de Border Gateway Protocol (BGP), el tráfico de cada PoP se repartía entre todas las conexiones.
Un martes a las 02:00, un aviso despertó a la ingeniera de guardia. Algunos usuarios estaban experimentando un aumento de la latencia y pérdidas de paquetes en sus conexiones. Todos llegaban al PoP de Fráncfort por un mismo circuito de un ISP, tier1-a. ¿Por qué? No estaba claro. Para contener el impacto e investigar el problema sin presión, la ingeniera recurrió a una excepción conocida: se saltó la NAP y se conectó directamente al router para sacar el tráfico del circuito. Retiró el anuncio BGP del prefijo para desviar el tráfico y trasladó a los usuarios de tier1-a a otros circuitos (o a otros PoP).
Los errores cesaron de inmediato. Eso confirmó que el problema estaba en tier1-a y permitió a la ingeniera dar el aviso por resuelto y volver a dormir. En una red del tamaño de Internet es habitual que un enlace rinda por debajo de lo esperado durante un tiempo, así que sabía que el enlace se recuperaría por sí solo unas horas después, como así ocurrió.
Sin embargo, nadie llegó a deshacer aquel desvío de tráfico de emergencia, por «correcta» que hubiera sido la decisión. El cambio no figuraba en la intención ni lo había documentado la ingeniera para revertirlo más adelante. Desde entonces, quedó en el router.
Durante seis semanas, el PoP atendió a todos sus usuarios a través de dos de los tres ISP sin mayores problemas. Nada había dejado de funcionar y dos ISP bastaban para soportar la carga de un día normal con el rendimiento esperado. El bloque de Observabilidad no generó ninguna alerta porque los paneles indicaban que todo iba bien: las sesiones BGP estaban activas, el tráfico circulaba y no había errores. Sin embargo, según la Fuente de Verdad, tier1-a seguía activo, mientras que el estado real del router indicaba lo contrario. Nada comparaba ambos estados.
Un día, un evento en directo generó tráfico adicional hacia el PoP. El PoP estaba diseñado para absorber incluso ese volumen… con los tres ISP. Por desgracia, solo dos estaban activos y se saturaron. Durante 30 minutos, el percentil 95 del tiempo hasta el primer byte para el conjunto de usuarios del PoP pasó de 40 milisegundos a 180, y empezaron a llegar las quejas. Cuando la ingeniera se conectó al equipo para investigar, la solución era evidente: deshacer el cambio de emergencia. Así recuperó el servicio en 5 minutos. Pero los usuarios del PoP ya habían sufrido un impacto que podría haberse evitado.
Desviar el tráfico del circuito a las 02:00 fue la decisión correcta. Había una excepción conocida que permitía al personal de guardia actuar con más rapidez que el flujo de trabajo habitual de automatización, que exige revisión y aprobación. Lo que falló fue el proceso posterior: nadie volvió a conciliar el estado de la red con la intención tras el cambio. La desviación pasó por completo inadvertida para la NAP, y ese es un problema que resuelve la automatización en bucle cerrado.
En este capítulo construimos el primero y más básico de los bucles de control de la parte 5: el que mantiene la red en funcionamiento conforme a la intención declarada. Aquí presento el bucle de cinco etapas que desarrollaré en los capítulos siguientes. En este nos centraremos en comprobar que la configuración y el estado de las rutas se ajustan a la intención. Lo más divertido viene después.
El bucle cerrado como arquitectura#
La realimentación es un método para controlar un sistema reintroduciendo en él los resultados de su funcionamiento anterior.
Norbert Wiener
La mayoría de los proyectos de automatización de redes empiezan en bucle abierto. Se diseña un cambio, se valida y se despliega. El flujo de trabajo da el cambio por completado con éxito cuando el último dispositivo acepta la configuración. El bucle termina con el despliegue y nada vuelve a introducir el resultado en él. Nadie se encarga de comprobar si la red sigue en el estado previsto una hora después, una semana después o después de que otra persona toque un dispositivo. La historia del principio es la consecuencia natural de un bucle abierto: el cambio salió bien, nadie volvió a comprobarlo y la desviación pasó inadvertida.
En esta historia, el equipo es maduro: normalmente, todos los cambios pasan por la automatización. En un entorno brownfield que acaba de empezar a adoptar la automatización, es mucho más probable que se sigan haciendo cambios a la antigua, al margen del proceso habitual, incluso cuando ya existe un camino recomendado (Golden Path) para desplegarlos de forma automatizada. Ahí es donde compensa cerrar el bucle, porque así se detectan los cambios manuales que el camino recomendado aún no ha sustituido.
Un bucle cerrado no termina con el despliegue. Trata el cambio desplegado como una afirmación sobre el estado de la red y sigue contrastándola con la realidad. Consta de cinco etapas, que se muestran en la Figura 16.1:
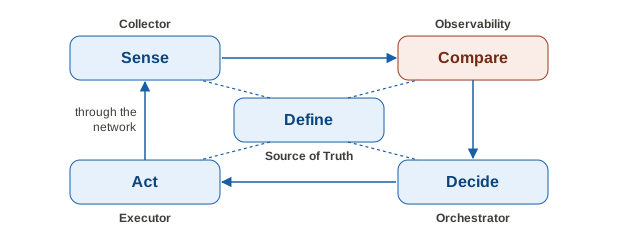
- Definir: expresa en la Fuente de Verdad, en forma de intención, cómo debería estar la red.
- Observar: consulta la red para averiguar qué está haciendo en realidad.
- Comparar: identifica dónde difieren la intención y la realidad.
- Decidir: elige qué hacer ante una diferencia: corregirla o consultar a una persona.
- Actuar: modifica la red mediante el mismo flujo de trabajo de cambio que utilizarías para cualquier otro cambio.
El ciclo no es nuevo. En 2003, la informática autónoma le dio el nombre de MAPE-K: monitorizar, analizar, planificar y ejecutar en torno a un conocimiento compartido (véase el trabajo de Kephart y Chess en las referencias de este capítulo). Las normas de telecomunicaciones sobre redes en bucle cerrado y redes autónomas se basan en él, y el IETF describe el mismo ciclo para las redes basadas en la intención en el RFC 9315. En este libro utilizo palabras más sencillas para las mismas etapas, y en la parte 5 recorremos el ciclo tres veces. Aquí las etapas mantienen la configuración conforme a la intención, en el capítulo 17 mantienen el servicio en buen estado y en el capítulo 18 sirven para elegir un plan.
De ello se desprenden dos consecuencias. Un primer despliegue, ya sea de una nueva sede, un nuevo ISP o un nuevo servicio, es simplemente la primera ejecución de la etapa Actuar en una red que aún no refleja esa intención. Y un equipo que cuenta con un excelente flujo de trabajo de despliegue pero carece de las etapas Observar y Comparar ha construido medio bucle. La mitad que falta es la que habría detectado el desvío de tráfico en Fráncfort.
El bucle no es un bloque arquitectónico nuevo. La Figura 16.1 identifica el bloque de la parte 2 que interviene en cada etapa: la Fuente de Verdad (SoT) almacena la intención (capítulo 4), el Recolector consulta la red y Observabilidad compara (capítulo 7), el Orquestador decide (capítulo 8) y el flujo de trabajo de cambio (capítulo 11) y el Ejecutor (capítulo 6) actúan. Lo que aporta la parte 5 es el cierre del bucle.
En las secciones siguientes recorreremos las etapas en orden, empezando por Definir.
Definir: modelar la intención de red#
La eficacia de un bucle cerrado depende de la calidad de la intención que toma como referencia. Si la intención solo existe en una página de una wiki o en la memoria de un ingeniero, el bucle carece de una referencia con la que comparar el estado de la red. El bucle empieza en la SoT y la primera decisión de diseño es qué modelar.
Modela la intención, no la configuración. En el capítulo 4 defendí esta idea en términos generales. La red de distribución de contenidos nos da un ejemplo concreto. La Fuente de Verdad no debería guardar «repetir el AS 3 veces en el AS-path de la interfaz X». Debería guardar la decisión que dio lugar a esa repetición, para que el bucle pueda distinguir entre un ISP al que se ha dado menos prioridad de forma deliberada y otro cuya prioridad se ha desviado de la prevista.
Modela la intención en las dos capas del capítulo 4: una intención de la capa de servicio que una persona declara de forma concisa y una intención de la capa técnica que se deriva de la primera mediante una expansión determinista. La Fuente de Verdad del capítulo 5 almacena ambas y permite consultarlas. El bucle compara la red en funcionamiento con la intención de la capa técnica obtenida tras la expansión. Por eso, la expansión debe ser determinista y estar bajo control de versiones: si una misma entrada puede producir resultados distintos, cada ejecución parecerá una desviación.
Una solicitud de servicio es breve. Alguien quiere añadir un punto de presencia, poner en servicio un nuevo ISP en uno de ellos o cambiar cómo se reparten los usuarios de una región entre los ISP que los atienden. La información que esa persona debería tener que aportar es igual de breve:
pop:
  site: dc-fra
  isps: [tier1-a, tier1-b, local-c]
class: standardEso es la intención de la capa de servicio: la entrada más pequeña que aún expresa una decisión. No dice nada sobre los valores de local-preference, las etiquetas de comunidad ni cuántos ISP deben seguir en servicio. Todo ello se deduce de la clase y del diseño.
Al expandir la solicitud se obtiene la intención de la capa técnica: la política de enrutamiento concreta de cada ISP que servirá para generar la configuración a partir de plantillas. También incluye un umbral mínimo de servicio, min_service_isps: un límite inferior estricto que indica cuántos ISP deben seguir transportando tráfico para un conjunto de prefijos. El Listado 16.2 lo muestra.
isp_uplink:
  site: dc-fra
  isp: tier1-a
  capacity_gbps: 10
  local_address: 203.0.113.2/30
  peer_address: 203.0.113.1
  advertise: [cdn-eu]
  egress_share: equal
  export_communities: [65000:100]
prefix_set:
  name: cdn-eu
  served_by: dc-fra
  min_service_isps: 2
tolerance: mediumEl modelo también contiene los datos en los que se apoyan tanto el bucle como los capítulos siguientes. Las direcciones proceden del IPAM a través de la federación de la Fuente de Verdad, por lo que también se detecta cualquier dirección que difiera de la asignada. Además, el modelo recoge la capacidad de cada enlace ascendente para la comprobación de capacidad del capítulo 17. Aquí, el umbral es solo un dato. En el próximo capítulo, cuando un mecanismo desvíe automáticamente el tráfico de los ISP, ese umbral pasará a ser un límite de obligado cumplimiento.
La Intención no solo define la configuración deseada. También expresa el resultado operativo que se pretende conseguir: qué ISP deben transportar el tráfico de un conjunto de prefijos y en qué proporción. Ambas perspectivas parten de los mismos datos. Supongamos que cdn-eu se sirve a través de los tres ISP de Fráncfort a partes iguales. Eso expresa una intención de configuración: anunciar el prefijo a través de cada uno. También expresa una intención operativa: repartir a sus usuarios entre los tres. No tienes que definir por separado el estado esperado de las rutas, porque se deduce del modelo. Así, en la sección Comparar disponemos de datos más concretos que tomar como referencia (el estado de las rutas).
Hay una característica de esta red que condiciona todo lo que viene después, así que conviene señalarla ya: un punto de presencia dirige el tráfico de los usuarios en dos sentidos y ejerce un grado de control distinto sobre cada uno:
- El punto de presencia controla el tráfico saliente, es decir, el contenido que envía a los usuarios en respuesta a sus peticiones. Su propia selección de rutas entre los ISP determina por qué enlace ascendente sale cada respuesta, mediante local-preference y otros atributos similares.
- En el tráfico entrante, es decir, en las peticiones que le envían los usuarios, solo puede influir. Son las demás redes las que eligen por qué ISP llegan al punto de presencia. Lo máximo que este puede hacer es volver un enlace ascendente más o menos atractivo mediante la repetición del AS en el AS-path, las comunidades o el anuncio selectivo de rutas, y esperar a que Internet reaccione.
El tráfico circula por los mismos ISP en ambos sentidos, de modo que un enlace ascendente en mal estado perjudica a ambos. Lo que cambia son las herramientas y el grado de certeza sobre el resultado. Cuando la autorrecuperación desvía el tráfico de un ISP, actúa en ambos sentidos, con distinto grado de certeza en cada uno.
Este bucle determina qué ISP utiliza un punto de presencia, pero no a qué punto de presencia llega un usuario. En una red global de distribución de contenidos, esa segunda decisión, la de asignar al usuario un punto de presencia cercano, se toma en un nivel superior mediante balanceo global de carga basado en DNS o mediante anycast. Esa capa es la herramienta más rápida cuando el problema afecta a todo un punto de presencia: basta con retirar la respuesta DNS o la ruta anycast para que los usuarios pasen al siguiente punto de presencia.
Esa capa queda fuera del alcance de este capítulo, pero el sistema es del mismo tipo: ejecuta los mismos bucles de ajuste a la intención, recuperación y decisión que se describen en esta parte, con su propia intención y su propio indicador de salud. Desviar el tráfico de un ISP permite mantener en buen estado un punto de presencia actuando desde dentro. Cuando ya no puedes recuperarlo, lo que haces es dirigir a los usuarios a otro punto de presencia.
La intención que hemos modelado en esta sección corresponde a la capa que declaran las personas. Son ellas quienes la redactan, la revisan y la mantienen bajo control de versiones. La autorrecuperación añade un segundo autor: una máquina que escribe otro tipo de intención en respuesta a lo que observa. Ambas intenciones se complementan, pero el diseño resulta más claro si se mantienen separadas.
Una consecuencia de modelar así la intención es que la mayoría de los cambios que pasan por el bucle modifican los datos, no el código, y se validan en consecuencia. Cuando añades un punto de presencia o pones en servicio un nuevo ISP, modificas los datos de la Fuente de Verdad y vuelves a ejecutar una expansión cuyas reglas siguen siendo las mismas y ya están probadas. El Ejecutor genera la configuración resultante con adaptadores que tampoco han cambiado.
Para ello hay que validar los datos, comprobar el esquema y verificar la integridad referencial: el ISP existe, tiene sus direcciones asignadas y se sigue respetando el nivel mínimo de servicio. No hace falta simular toda la red, porque el cambio no introduce ningún comportamiento nuevo en los dispositivos. La simulación (capítulo 10) se reserva para los cambios en las plantillas o en la lógica de expansión y para las configuraciones de alto riesgo, donde sí pueden aparecer comportamientos nuevos. Ajustar la profundidad de la validación a lo que ha cambiado permite resolver el caso habitual con la rapidez necesaria para ejecutar el proceso en bucle.
Una vez definida la intención, el bucle necesita ver qué está haciendo realmente la red.
Observar: leer la configuración y el estado de la red#
La mayoría de las automatizaciones se saltan la etapa de observación. Esta etapa requiere dos lecturas, no una. Utiliza la interfaz de gestión que ofrezca el dispositivo para acceder a la configuración y al estado en formato estructurado. El capítulo 10 compara estas interfaces. Al bucle le da igual cuál uses, siempre que le permita tanto enviar la configuración como leer lo que ocurre en la red.
La primera lectura recoge la configuración en ejecución: la política de encaminamiento para cada enlace ascendente a un ISP y cada conjunto de prefijos. Así respondes a la pregunta «¿se configuró el dispositivo tal como indicaba la intención?».
La segunda lectura recoge el estado operativo de las rutas: la mejor ruta que ha seleccionado el dispositivo para cada conjunto de prefijos, el valor de local-preference que se aplica en la práctica y el ISP por el que sale el tráfico. Así respondes a la pregunta «¿ha surtido efecto la intención?». Son preguntas distintas, y esa diferencia es la base de la siguiente sección.
Recuperar el estado es tarea del Recolector que vimos en el capítulo 7. En una red pequeña puedes programar una consulta de la configuración en ejecución y del estado de las rutas en cada ciclo, y pasar el resultado a la etapa de comparación. A gran escala, esa consulta resulta costosa. También es innecesaria, porque el estado de las rutas puede transmitirse a medida que cambia. BGP Monitoring Protocol (BMP) exporta la RIB de BGP de un router a un recolector conforme cambia, y una suscripción a gRPC Network Management Interface (gNMI) transmite el estado operativo de la misma forma. Así, la lectura deja de ser una consulta periódica y pasa a ser un flujo de cambios. Esto reduce la carga y acorta el tiempo que transcurre desde que aparece una desviación hasta que el bucle la detecta.
En ambos casos, al diseñar cómo escalar el sistema tienes que decidir con qué frecuencia comparar. Si lo dejas para el final, pasarás por alto los mismos compromisos que plantea la frecuencia de recogida para el resto de la telemetría del capítulo 7 y los que plantea el particionamiento en el capítulo 12.
Antes de que el bucle actúe a partir de lo que observa, unas comprobaciones previas confirman que es seguro hacerlo. Se ejecutan en dos momentos distintos:
- Antes de iniciar una ejecución. Los datos de la lectura están al día: todos los dispositivos incluidos en la ejecución han comunicado su estado dentro de la ventana de recogida. La Fuente de Verdad ha respondido y los registros que necesita la ejecución están completos. Además, nada impide actuar sobre los dispositivos: ningún otro flujo de trabajo los tiene reservados, no hay ninguna ventana de mantenimiento ni ningún cambio de emergencia pendiente de conciliación.
- Antes de modificar los datos. La modificación de la intención supera las comprobaciones de esquema y de integridad referencial de la etapa Definir, y tras el cambio se sigue respetando el nivel mínimo de servicio.
Si falla una comprobación previa, el bucle se detiene y genera una alerta. Nunca continúa con una corrección basada en datos de los que no puede fiarse. Por la misma razón, el punto de control de cada oleada del capítulo 8 considera que la ausencia de datos es un fallo e impide continuar.
Cada ciclo devuelve dos lecturas. La Observabilidad las convierte en dos comparaciones que describo a continuación.
Comparar: detectar desviaciones en dos niveles#
Confía, pero verifica.
Russian proverb
Aplicar la configuración y cumplir la intención son dos cosas distintas. Un bucle cerrado verifica ambas: al desplegar, confías, y con las dos comparaciones siguientes, verificas.
La comparación de la configuración normaliza la política en ejecución y busca diferencias respecto a la intención de la capa técnica, tal como la genera el adaptador del Ejecutor. La normalización importa porque comparar directamente la sintaxis de distintos fabricantes introduce ruido. La comparación utiliza el modelo normalizado del capítulo 7, lo que permite comparar «local-preference 100» entre sistemas operativos de distintos fabricantes sin que interfieran las diferencias de sintaxis. Una diferencia en este nivel indica una desviación de la configuración: la configuración del dispositivo ya no coincide con lo que indica la intención. En el sector se habla de cumplimiento de la configuración de referencia, y la mayoría de los productos de Fuente de Verdad ofrecen esta función.
La comparación del estado de las rutas busca diferencias entre la mejor ruta que ha seleccionado realmente la RIB y la que prevé la intención. Una diferencia en este nivel indica que se ha configurado la intención, pero no se ha cumplido: el tráfico no circula por donde prevé el diseño. La referencia para comparar es la intención operativa de la sección Definir: por qué ISP debe circular el tráfico de un conjunto de prefijos y en qué proporción. Por tanto, la comparación parte de un estado esperado concreto para las rutas, sin tener que adivinarlo.
La normalización es tarea del Procesador. Aquí se aplica a la configuración en vez de a las métricas y representa la mayor parte del trabajo en el nivel de configuración. Los fabricantes reordenan las líneas, insertan valores predeterminados que el ingeniero nunca ha introducido, generan un hash distinto de los secretos en cada lectura y dan a las interfaces nombres propios de cada fabricante. Antes de comparar la configuración en ejecución, conviértela en datos estructurados con un analizador basado en plantillas, como TTP o ciscoconfparse, o léela como modelo a través de OpenConfig. Después, compara solo las secciones que gestiona la plataforma de automatización de redes (NAP) (sí, puedes automatizar solo una parte de tu configuración).
Vuelve al caso de Fráncfort para ver la diferencia entre los dos niveles. Según la intención declarada, los tres ISP de Fráncfort dan servicio a la vez al conjunto de prefijos cdn-eu y se reparten sus usuarios por igual. Hace seis semanas, un cambio de emergencia desvió todo el tráfico de tier1-a hacia los otros dos ISP, que se repartieron su parte. Nadie revirtió aquel cambio.
- En el nivel de configuración, el bucle recupera la política en ejecución en Fráncfort y la compara con la intención. La intención indica que cdn-eu debe anunciarse por tier1-a para que reciba la misma cuota que los demás. En la configuración en ejecución, ese anuncio está retirado. La discrepancia aparece ya en el ciclo siguiente. El bucle informa de una desviación de la configuración en tier1-a de dc-fra.
- En el nivel del estado de las rutas, el bucle consulta por dónde circula realmente el tráfico de los usuarios de cdn-eu. La intención los reparte entre tres ISP. La RIB muestra que se reparten entre dos. Hay una discrepancia. El bucle informa de una desviación en el estado de las rutas de cdn-eu.
Cualquiera de las dos señales por sí sola habría detectado el desvío de tráfico de Fráncfort seis semanas antes. Entonces, ¿por qué insistir en usar las dos? Porque pueden fallar de forma independiente.
La configuración puede coincidir exactamente con la intención y, aun así, el estado de las rutas puede ser incorrecto. De repente, una red vecina da preferencia a otro ISP para llegar a Fráncfort, un proveedor de tránsito retira un prefijo o cambia un siguiente salto. Los anuncios siguen siendo los declarados y, aun así, el tráfico de los usuarios llega por el enlace ascendente equivocado o deja de llegar por completo. Si solo comparas la configuración, todo parece correcto. Solo el estado de las rutas revela el problema.
También puede ocurrir lo contrario: la configuración puede desviarse sin que el estado de las rutas lo refleje todavía. La intención de Fráncfort especifica cómo se deben redistribuir los usuarios cuando se desvía todo el tráfico de un ISP. Si esa política de redistribución se desvía de la intención, hoy no cambia nada, porque hoy no se está retirando tráfico de ningún ISP. Por eso, el estado de las rutas parece ajustarse a lo previsto. La desviación permanece latente en la configuración hasta que, la próxima vez que haya que desviar el tráfico de un ISP, los usuarios se redistribuyan de forma incorrecta. Hasta entonces, solo la comparación de la configuración permite detectarla.
Comparar la configuración te indica si el dispositivo se ha configurado según lo previsto. Comparar el estado de las rutas te indica si la intención se ha cumplido en la práctica. Necesitas ambas comparaciones porque cada una detecta precisamente lo que la otra pasa por alto, y cualquiera de esos puntos ciegos puede dar lugar a un fallo en producción.
Para el tráfico entrante, la propia RIB del router no sirve como referencia: lo que importa es cómo ve el resto de Internet tus anuncios. Puedes verlo en los recolectores públicos de rutas (p. ej., RIPE RIS y RouteViews) y en los servicios de consulta de rutas (looking glasses) de los proveedores. El bucle debe hacer dos comprobaciones. Cada prefijo debe ser visible a través de los ISP que, según la intención, deben anunciarlo. Además, su estado en la infraestructura de clave pública de recursos (RPKI) debe ser válido. Si una autorización de origen de ruta deja de coincidir con un anuncio, el prefijo pasa a ser inválido y las redes que filtran las rutas inválidas lo descartan sin avisar. Ninguna comparación en el propio dispositivo detectará jamás esa desviación.
La comparación del estado de las rutas tiene un límite, y será lo primero que preocupe a un ingeniero de redes. El reparto previsto es, en realidad, el reparto previsto en condiciones nominales. Si uno de los ISP de Fráncfort se cae y sus usuarios se redistribuyen entre los demás, la red se comporta como debe. Eso no es una desviación. Si la comparación marca cada caída de un ISP como una desviación, avisará al ingeniero de guardia en cada incidente real y en menos de una semana alguien silenciará los avisos. Eso es peor que no tener bucle. Por tanto, al comparar el estado de las rutas no basta con buscar a ciegas diferencias respecto al reparto nominal. Antes hay que responder a otra pregunta: ¿siguen siendo nominales las condiciones?
Parte de la respuesta se obtiene localmente y a bajo coste. Este bucle ya dispone de ella, porque al recuperar el estado puedes saber si la sesión con cada ISP está activa y si su siguiente salto es alcanzable. Pero para completar la respuesta falta saber si un ISP activo y bien configurado está cursando correctamente el tráfico de sus usuarios. Esa es la observación que falta en este capítulo. En el caso general, para distinguir un fallo real de un ISP de una auténtica desviación hace falta la señal sobre la salud del enlace que introduce el capítulo 17.
Hasta entonces, puedes aplicar una regla con tres casos. Si un ISP que funciona correctamente y es alcanzable no aparece en el reparto, hay una desviación. Si falta un ISP cuya sesión está caída, la retirada es la esperada. Queda el caso intermedio, que es ambiguo: un ISP sigue activo, pero su servicio se ha degradado. Para resolver ese caso escribí el Capítulo 17.
Otras dos reglas sencillas evitan que la comparación genere avisos innecesarios: compara por conjuntos de prefijos, en lugar de hacerlo prefijo a prefijo, y considera normal que el tráfico de un prefijo se reparta entre varios ISP. Señala solo las diferencias respecto al conjunto de ISP previsto o a la proporción de tráfico que debe recibir cada uno.
El mecanismo que ejecuta la comparación de forma periódica ya existe: es el bucle de cumplimiento continuo de la sección Cumplimiento continuo y corrección de desviaciones del capítulo 13. Este capítulo lo reutiliza y añade el segundo nivel de comparación. Cada ciclo emite un evento de desviación: un registro estructurado sobre el que la etapa siguiente puede actuar sin que una persona tenga que interpretarlo.
drift:
  device: dc-fra
  prefix_set: cdn-eu
  level: route_state
  expected_isps: [tier1-a, tier1-b, local-c]
  observed_isps: [tier1-b, local-c]
  tier1-a_reachable: true
  tier1-a_session: established
detected_at: 2026-07-14T02:14:09ZEl evento de desviación tiene un formato que permite a una máquina actuar sobre él. La capa de Observabilidad lo emite con los datos de alerta que una máquina necesita para iniciar una acción, tal como especifica la sección Interfaz entre alertas y acciones del Capítulo 7. El evento activa un flujo de trabajo de corrección en el Orquestador (capítulo 8), que decide si procede conciliar o alertar, como se describe en la sección siguiente. Los campos tier1-a_reachable y tier1-a_session acompañan al evento para que el flujo de trabajo pueda valorar si es más probable que se trate de una desviación o de una retirada justificada antes de avisar a nadie. La detección observa y notifica. La corrección decide y actúa. El evento de desviación pasa la información de una a otra.
La siguiente pregunta es qué hace el Orquestador con ese evento.
Decidir: conciliar o alertar#
Cuando se detecta una desviación, hay que decidir si se corrige automáticamente o se avisa a una persona para que intervenga. La sección Cumplimiento continuo y corrección de desviaciones del capítulo 13 ya estableció la regla, y la Figura 13.11 la ilustra. Corrige la desviación de forma automática solo si restablecer la intención no afecta al plano de reenvío y es poco probable que la desviación se deba a un cambio manual deliberado. En cualquier otro caso, avisa y espera.
El encaminamiento queda en el lado de mayor riesgo de esa regla. Durante un incidente, un ingeniero puede haber desviado deliberadamente el tráfico de los usuarios de un prefijo. Por eso, ante una desviación que afecte a las rutas, la respuesta predeterminada es avisar y esperar: indica al ingeniero de guardia de qué dispositivo y conjunto de prefijos se trata y cuáles son los ISP esperados y los observados. La conciliación vuelve a generar la configuración a partir de la intención y la envía de nuevo mediante el mismo flujo de trabajo de cambio, con la misma validación y las mismas garantías de reversión que en el cambio original. Como el envío se basa en la idempotencia, conciliar un dispositivo que ya está en el estado deseado no produce ningún cambio.
Que volver a aplicar la configuración no cambie nada es la diferencia fundamental entre los dos niveles de desviación. La desviación de la configuración tiene un remedio evidente: volver a generarla a partir de las plantillas y enviarla de nuevo. La desviación en el estado de las rutas a menudo carece de remedio, porque la configuración puede coincidir ya con la intención. Si cdn-eu no aparece en un ISP que funciona correctamente y está configurado para transportar su tráfico, volver a enviar exactamente la misma configuración no cambia nada. Los usuarios han pasado a otro ISP por un motivo ajeno a la configuración, como una ruta preferida que anuncia un vecino o la retirada de una ruta por parte de un proveedor de tránsito.
Los propios campos del hallazgo indican cómo responder. Si la sesión del ISP que falta está caída, la retirada de la ruta es legítima: indícalo y no generes ninguna alerta. Si el ISP funciona correctamente y aun así sus usuarios han pasado a otro, algo que la intención no contemplaba está prevaleciendo sobre el diseño. Escala el caso para que una persona decida si hay que modificar la intención. Si el ISP está operativo pero su servicio está degradado, te encuentras en el caso intermedio que solo el capítulo 17 permite resolver. Volver a enviar la configuración corrige la desviación de la configuración. La desviación en el estado de las rutas suele requerir una decisión más que una reparación.
La conciliación automática también tiene que convivir con las personas. Si a las 02:00 el bucle revierte la corrección del ingeniero de guardia mientras este sigue tecleando, el propio bucle provoca el incidente que debía evitar. La propia excepción conocida establece el acuerdo. Todo cambio directo que se haga al amparo de esa excepción queda registrado y pone en pausa la conciliación automática en los dispositivos afectados hasta que el cambio se incorpore a la SoT mediante la conciliación.
Cuando la propia NAP está caída, el procedimiento de acceso de emergencia de la sección Cuando la vía habitual está bloqueada del capítulo 11 sigue la misma regla. Sin esa coordinación, el bucle y el ingeniero de guardia modifican los mismos dispositivos con objetivos opuestos. Ese es el fallo por oscilación que se describe en la sección Límites y Escalera de Confianza (Confidence Ladder).
El momento de actuar forma parte del mismo problema. Un bucle que ejecuta una conciliación a las 14:00 de un martes está haciendo un cambio no programado, por muy correcto que sea. La NAP distingue los casos según su urgencia. La detección es continua. La conciliación automática es un cambio y está sujeta a los mismos controles: se ejecuta dentro de una ventana de mantenimiento o al amparo de una solicitud de cambio que ya cubra esa clase de desviación, conforme a las reglas de gobierno del capítulo 13. La autorrecuperación del capítulo siguiente es una excepción deliberada, porque responde a un incidente, tiene un alcance limitado y revierte sus propios cambios. La optimización del capítulo 18 se programa en ventanas por diseño. Detecta en todo momento y haz cambios cuando el proceso de gestión de cambios lo permita.
Una regla de diseño evita que este capítulo entre en conflicto con el siguiente: toma la intención efectiva como referencia para comparar y conciliar, sin limitarte a la capa declarada. Aquí ambas coinciden porque todavía no hay ningún otro mecanismo que modifique la intención. El capítulo siguiente añade un sistema que desvía el tráfico de un ISP hasta dejarlo sin tráfico y registra esa actuación como una excepción temporal, una segunda capa de intención. Un bucle que solo comparase el estado con la capa declarada interpretaría esa retirada de tráfico como una desviación y la revertiría. Los dos bucles se desharían mutuamente los cambios. Si implementas ahora la comparación con la intención efectiva, mientras la segunda capa está vacía, los dos bucles podrán funcionar juntos más adelante.
Una vez que el bucle ha decidido modificar la red, la última etapa consiste en hacerlo de forma segura.
Actuar: aplicar la intención de forma segura#
El bucle genera la configuración a partir de las plantillas y de la intención de la capa técnica, y la envía a los dispositivos. De esa generación se encargan los adaptadores del Ejecutor del capítulo 6: traducen la intención a la política de enrutamiento, las listas de prefijos y los parámetros de los vecinos en la sintaxis propia de cada sistema operativo de red.
Antes de enviar la configuración, hay una comprobación que cuesta poco y detecta toda una clase de errores: el análisis de la configuración. Una herramienta como Batfish lee las configuraciones generadas y determina cómo afectarán al enrutamiento, por ejemplo, qué prefijos recibirá cada ISP y qué rutas tendrán preferencia, sin tocar ningún dispositivo. Este análisis complementa la simulación del capítulo 10 y es lo bastante rápido como para ejecutarlo cada vez que el bucle llega a la etapa de actuación.
El proceso de envío prepara el cambio en el dispositivo, lo valida allí mismo si el sistema operativo lo permite y lo aplica. Cuando el sistema operativo lo admita, utiliza un commit con confirmación: el dispositivo aplica el cambio y lo revierte por sí solo si el bucle no lo confirma antes de que venza el plazo. Así se limita el alcance del impacto, igual que con la reversión durante la ejecución que se describe en el capítulo 6.
En un parque de dispositivos heterogéneo, los sistemas que carecen de esta función necesitan una alternativa: una instantánea previa al cambio y un mecanismo externo de reversión, como se explica en el capítulo 6. Todo el envío se ejecuta dentro del flujo de trabajo de cambio del capítulo 11, con los mismos puntos de validación y controles por oleadas que cualquier otro cambio.
La conciliación también tiene que respetar los límites físicos. BGP necesita volver a converger después de un commit. Si vuelves a verificar las rutas antes de que se estabilicen, verás una desviación aparente: el bucle persigue un estado que aún está cambiando. Por eso, el paso de verificación deja transcurrir una ventana de convergencia antes de volver a comparar. Su duración se calcula como la de cualquier ventana de conciliación en la sección Modelos de consistencia del capítulo 12: un múltiplo pequeño del intervalo de observación. El commit con confirmación mantiene la protección frente a un cambio fallido mientras la espera da tiempo al plano de control para estabilizarse.
El bucle también tiene parámetros: cuánto tiempo esperar antes de considerar real una diferencia, con qué frecuencia comparar y cuántos dispositivos incluir en cada oleada de conciliación. Al principio tienen valores fijos, que se afinan de dos maneras a partir del historial de la propia NAP. Los ingenieros los ajustan según lo que indica la NAP. Por ejemplo, si una clase de desviación se resuelve por sí sola en un solo intervalo de sondeo el 95 % de las veces, amplían el tiempo de espera para esa clase y dejan de emitirse avisos de guardia por esas desviaciones transitorias.
Parte de esos ajustes también puede hacerse mediante reglas dentro del bucle. En ninguno de los dos casos toma las decisiones un modelo. Eso se aborda en el capítulo 18. Aquí el bucle gana estabilidad porque tanto las personas como las reglas tienen en cuenta su historial.
Hasta aquí hemos visto qué hace el bucle. Para cerrar el capítulo, veremos qué queda fuera de su alcance y cómo adoptarlo de forma segura.
Límites y Escalera de Confianza#
El bucle cerrado de este capítulo ofrece una garantía importante y fácil de entender. Puede demostrar que la red en funcionamiento coincide con la intención declarada, tanto en la configuración como en el estado de las rutas, y mantener esa correspondencia en el tiempo. Esa era la garantía que hacía falta en el caso inicial y de la que entonces se carecía.
Sin embargo, tiene un punto ciego importante. Compara el estado de la red con la intención, pero la intención de red define los atributos de la red y deja fuera el nivel de servicio esperado. Un ISP puede ajustarse perfectamente a su intención: sus rutas se anuncian y se ponderan exactamente como indica el diseño, y el ISP atiende la proporción de usuarios que le corresponde. Aun así, puede perder el 4 % de los paquetes porque el proveedor que hay detrás está pasando una mala hora.
Para este bucle, el ISP funciona correctamente: la configuración es correcta, los usuarios se distribuyen según lo previsto y no hay desviación. Nada en la configuración ni en una entrada de la RIB revela una degradación parcial del servicio. Para detectarla, necesitamos medir el rendimiento del trayecto. Ese es el tema del capítulo 17.
El bucle puede fallar de varias formas que conviene tener presentes. Puede oscilar si entra en conflicto con alguien ajeno al bucle: un ingeniero introduce cambios manuales y la conciliación automática los revierte, de modo que cada uno deshace lo que hace el otro. La realimentación puede llevar al bucle a optimizar el parámetro equivocado, por ejemplo, a ampliar una ventana de espera hasta que una desviación real pase inadvertida. Y una conciliación que actúe con demasiada facilidad puede convertir la desviación de un solo dispositivo en una tormenta de conciliaciones que abarque todo el parque. Cada uno de estos fallos es un motivo para incorporar la automatización de forma gradual.
Ese recorrido gradual es la Escalera de Confianza del capítulo 14. La comprobación y el mantenimiento de la conformidad en bucle cerrado ocupan sus peldaños inferiores. Lo que justifica subir de peldaño es el historial de resultados de la automatización del capítulo 14: con qué frecuencia detectó el bucle una desviación real, con qué frecuencia señaló un estado transitorio como desviación y, una vez habilitada la conciliación, con qué frecuencia consiguió conciliar sin sorpresas. Mide también cuánto tiempo transcurre desde que aparece una desviación hasta que se genera la alerta. Es la cifra que más habría cambiado en el caso inicial.
Antes de usar el bucle en producción, comprueba que funciona en el entorno de simulación del capítulo 10. Introduce una desviación conocida en la red simulada, como una repetición indebida del AS en la ruta, la retirada de un prefijo o una reducción de la preferencia local. Confirma que el bucle la detecta en el nivel adecuado y que los valores que comunica, tanto el esperado como el observado, son los correctos. Después, introduce un fallo real de un ISP en la simulación: deja un ISP fuera de servicio y confirma que el bucle no señala ninguna desviación cuando sus usuarios se redistribuyen correctamente entre los demás. Si no pruebas el detector tanto con un cambio que sabes que es erróneo como con otro que sabes que es correcto, tarde o temprano dará una falsa alarma al equipo de guardia.
Entre las pruebas de laboratorio y el uso pleno en producción, ejecuta el bucle en producción en modo Sombra (Shadow Mode) durante unas semanas. Observa, compara y decide, deja constancia de lo que habría hecho y no cambia nada. Compara sus propuestas con lo que hicieron los ingenieros en la práctica. Cuando ambas cosas coincidan semana tras semana, tendrás el historial necesario para dejarle actuar.
Cuenta con muchos avisos en la primera ejecución. Si activas el bucle en una red existente, el primer día aparecerán cientos de diferencias, la mayoría antiguas e inocuas. Clasifícalas una sola vez como una lista de trabajo pendiente: si una diferencia es correcta, incorpórala a la intención. Si es incorrecta, corrige el dispositivo. Para las demás, suprime los avisos y asigna a cada caso un responsable y una fecha de caducidad. Si un bucle arranca con quinientos hallazgos abiertos, para la segunda semana ya nadie le hará caso.
Lo he hecho decenas de veces en muchos entornos y te recomiendo que te prepares para una larga lista de problemas de desviación. Aun así, si estableces un plan de mitigación que te permita ir corrigiéndolos de forma sostenida, a la larga tendrás éxito.
Nada de esto es exclusivo de una red de distribución de contenidos. En una red de campus, la comparación en el nivel de configuración comprueba si miles de switches de acceso cumplen la configuración de referencia. En lugar del estado de las rutas, se examina el estado de las VLAN y de 802.1X en los puertos de acceso. En un tejido de red de un centro de datos, la comparación en el nivel del estado de las rutas contrasta las sesiones BGP y las rutas EVPN con la intención definida para ese tejido. Muchos controladores también ejecutan una versión de este bucle en su propio dominio. Cuando un único controlador se encarga del dominio, utiliza su bucle. Utiliza el de la NAP cuando la intención abarque varios fabricantes o dominios.
¿Por dónde empezar? La Escalera de Confianza da siempre la misma respuesta: detecta antes de conciliar. El bucle cerrado mínimo viable consiste en volver a leer el estado de los dispositivos y hacer las dos comparaciones. Cada hallazgo se comunica a una persona y nada se corrige automáticamente. Ese único paso cubre la carencia que puso de manifiesto el caso inicial, la desviación silenciosa, sin riesgo alguno de que el propio bucle haga un cambio erróneo.
Este primer paso se completa cuando una desviación en un ISP genera una alerta en el plazo de un ciclo de comparación, tanto en el nivel de configuración como en el del estado de las rutas. Solo entonces debes activar la conciliación automática, y únicamente para las clases de desviación de menor riesgo que avale el historial de la automatización. Un equipo capaz de detectar las desviaciones de forma fiable ya lleva mucha ventaja al del caso inicial, aunque nunca llegue a automatizar una sola corrección.
Resumen#
El primer paso para mitigar el impacto de los cambios en tu red es reconocer que el porcentaje de cambios que pasarán por la NAP no llegará al 100 %. El bucle de cinco etapas ofrece un marco claro para reducir de forma continua la diferencia entre la intención y el estado real.
Empieza por definir la intención en la Fuente de Verdad y observar la configuración en ejecución y el estado de las rutas. A continuación, compara los datos reales con los previstos en ambos niveles, decide si procede conciliar o emitir una alerta y actúa en consecuencia a través del flujo de trabajo de cambio, como harías con cualquier otro cambio. Este proceso debe ejecutarse periódicamente. Nunca des por hecho que la intención y la realidad coinciden. Compruébalo.
Como es lógico, no vas a delegarlo todo en el bucle cerrado nada más ponerlo en marcha. Pruébalo. Gánate la confianza del equipo y sube por la Escalera de Confianza del capítulo 14 antes de permitir que el bucle concilie por sí solo. Al final del proceso, tu red estará mejor, más cerca de tu estado deseado.
Este bucle mantiene el estado real de la red alineado con la intención, pero tiene limitaciones. No puede detectar que los trayectos dentro de la red ofrecen un rendimiento deficiente, porque ni la configuración real ni la RIB contienen información sobre pérdidas de paquetes o latencia. El capítulo 17 amplía el bucle e incorpora la información que hace falta para automatizar esas decisiones.
Referencias#
- The Vision of Autonomic Computing, Jeffrey O. Kephart y David M. Chess (IEEE Computer, 2003). El bucle MAPE-K (monitorizar, analizar, planificar y ejecutar a partir de un conocimiento compartido) da origen a las cinco etapas que se aplican en la parte 5.
- Feedback Control for Computer Systems, Philipp K. Janert (O’Reilly, 2013). Valores de consigna, estabilidad e histéresis en los bucles de control de software.
- A General Approach to Network Configuration Analysis, Ari Fogel et al. (USENIX NSDI, 2015). El artículo sobre Batfish explica cómo deducir el plano de datos que produciría una configuración y detectar errores antes de enviar nada a los dispositivos.
- Infrastructure as Code, 2nd Edition, Kief Morris (O’Reilly, 2021). La intención declarativa, la conciliación y la desviación como cuestiones de primer orden.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo