La red como producto#
Un año después de la reunión de seguimiento que marcó un antes y un después para el equipo de Jordi en el capítulo 14, el equipo había conseguido un resultado impresionante: la plataforma de automatización de redes (NAP) automatizaba de principio a fin la incorporación de sucursales. Contaba con una interfaz de autoservicio fácil de usar para solicitar el alta de sedes, que ofrecía a quienes la solicitaban toda la información que necesitaban, un flujo de trabajo resiliente para desplegar cambios y un panel interno para supervisar el estado de la red en cientos de ubicaciones. El equipo estaba orgulloso de lo conseguido, y con razón.
Entonces, la empresa cerró la adquisición de otra cadena de tiendas: había que conectar a la red 120 tiendas nuevas en solo seis meses. Dados los buenos resultados anteriores, la persona responsable de infraestructura envió un único correo al equipo de redes: «Contamos con vuestra automatización para esto. ¿Por dónde empezamos?»
El equipo de redes se sentía seguro: podía automatizar el proceso porque la automatización ya estaba en marcha y había demostrado su eficacia en condiciones reales.
Pero la respuesta que llegó del área de negocio hizo que el equipo perdiera parte de esa confianza. No le preguntaban si era técnicamente posible automatizar el proceso. Querían saber cuál sería el SLA para la incorporación de tiendas, qué vía tendrían para escalar incidencias, si podrían consultar directamente el estado de las tiendas (sin tener que contactar con el equipo de redes), cómo podrían iniciar y controlar por su cuenta el proceso de aprovisionamiento de principio a fin y qué ocurriría con las tiendas que se incorporasen durante una incidencia en la NAP.
El equipo disponía de una automatización capaz de hacer el trabajo, pero no la ofrecía en términos que el área de negocio pudiera entender.
Este capítulo explica cómo pasar de «hemos creado una automatización que funciona» a «prestamos un servicio en el que otros equipos pueden confiar y basar sus planes».
El capítulo 11 ya abordó la NAP como producto cuya clientela eran los profesionales de ingeniería de redes. Este capítulo da un paso más y amplía el foco: la NAP es el medio por el que el equipo de redes ofrece la propia red como producto al resto de la organización, a equipos que nunca utilizarán la NAP directamente y a los que solo les importa el servicio que presta.
Este tema me apasiona. En una charla que di en AutoCon3 lo abordo desde la perspectiva de la automatización guiada por el diseño. La charla sirve como referencia complementaria para este capítulo.
De capacidad a producto#
La gente no quiere comprar una broca de un cuarto de pulgada. Quiere un agujero de un cuarto de pulgada.
Theodore Levitt
El capítulo 14 describió cómo los equipos transforman a quienes los integran, sus funciones y su forma de trabajar para que la automatización se convierta en una capacidad de la organización. Esa transformación es necesaria, pero no basta.
Una capacidad es algo que el equipo sabe hacer. Un producto es algo con lo que otros equipos (o, con el tiempo, entidades externas) pueden contar. La diferencia no radica en la calidad técnica: la NAP que permitió incorporar las tiendas era técnicamente excelente. La diferencia está en la relación entre quien presta el servicio y quien lo consume. A quien consume el servicio no le interesan los detalles internos de la NAP. Quiere resultados (por ejemplo, una VLAN desplegada y operativa).
Lo que entrega el equipo de redes ha cambiado. Antes de la automatización, el resultado de su trabajo era la configuración de dispositivos: un router aprovisionado, una VLAN extendida, una ACL aplicada. El propio dispositivo consumía esa configuración y el éxito se comprobaba al recibir respuesta a un ping o al verificar que una aplicación funcionaba. Con la automatización, el resultado cambia: el producto del equipo de redes es un servicio de red que consumen otros equipos.
Cada interacción con la red pasa de ser un ticket de cambio a ser una solicitud de servicio. Esto abarca aprovisionar una sucursal, ampliar un segmento para una nueva aplicación, aplicar una política de seguridad, conceder acceso temporal para una conferencia y añadir una conexión de peering en un punto de intercambio de Internet. La configuración de los dispositivos es el detalle de implementación. El servicio es lo que se entrega.
Tratar un servicio de infraestructura como producto no es nuevo en ingeniería de software: las interfaces de programación de aplicaciones (API) abstraen la infraestructura, y quien hace la llamada no sabe qué servidores atienden la solicitud ni le importa. Sin embargo, supone un cambio considerable para los equipos de redes, que históricamente han organizado su trabajo en torno a dispositivos, fabricantes y protocolos. Quien haya definido su identidad profesional por su destreza al configurar routers tiene que reorientarla hacia su capacidad para prestar servicios (el dilema de la persona experta que vimos en el apartado Crisis de identidad del capítulo 14). Quien domina el oficio tradicional es quien más necesita ese cambio de perspectiva, y quien lo asume por completo aporta más valor.
Este producto ya tiene su sitio en la Fuente de Verdad. El capítulo 4 definió una capa de servicio: el nivel de intención en el que quien tiene la responsabilidad del servicio indica qué se necesita, dónde y con qué características. Los patrones de diseño desglosan después esa intención en los objetos técnicos que necesita la automatización. Un servicio de red como producto es esa capa de servicio puesta a disposición de otros equipos.
Desde el punto de vista técnico, su interfaz reside en el bloque de Presentación descrito en el capítulo 9. Quienes consumen el servicio ven su contrato en la interfaz de autoservicio, en las operaciones que ofrece la API, en la integración mediante webhooks y en el modelo de acceso basado en roles. Este capítulo amplía el foco para pasar de la interfaz técnica al modelo organizativo y de negocio que la rodea. ¿Qué compromisos conlleva la interfaz? ¿Quién responde por ella cuando falla? ¿Cómo evoluciona el servicio? ¿Quién decide qué hará a continuación?
Si el servicio es el producto, la primera tarea es definirlo.
Definir el producto#
Un producto empieza por su interfaz: qué aporta quien lo consume, qué recibe a cambio y qué queda oculto. Si te equivocas al trazar ese límite, ya sea por exceso o por defecto, el servicio falla aunque la automatización que lo sustenta funcione.
Cuando los equipos intentan convertir la automatización de redes en servicios, aparecen una y otra vez dos tipos de fallo.
Exceso de exposición: la interfaz revela detalles de implementación y, para utilizarla, hay que entender el funcionamiento interno de la red. Un servicio de aprovisionamiento de sucursales que pide un identificador de VLAN, una máscara de subred y un número de área Open Shortest Path First (OSPF) no es un servicio: es una interfaz de línea de comandos (CLI) con un formulario web. Quien consume el servicio se encarga de coordinar las instalaciones de la cadena de tiendas. No sabe qué es un área OSPF ni tendría por qué saberlo.
Exceso de restricciones: la interfaz está tan limitada que solo admite los casos de uso concretos que previó el equipo de automatización de redes. Cualquier solicitud que se aparte de la plantilla exige tramitar una excepción. Si la persona que coordina las instalaciones necesita aprovisionar una tienda temporal con requisitos de conectividad distintos de los de una tienda permanente, no puede hacerlo en régimen de autoservicio. Abre un ticket. El ticket llega al equipo de automatización de redes. Las ventajas de la automatización no han llegado a esa persona.
Un contrato de servicio resuelve ambos tipos de fallo al definir la interfaz de forma explícita, con un alcance delimitado y un control de versiones. Tiene tres componentes, que se muestran en la Figura 15.1:
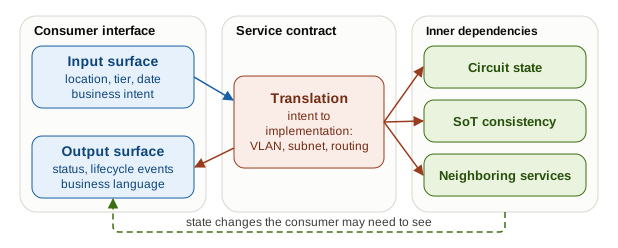
Interfaz de entrada: lo que proporciona quien consume el servicio, expresado en términos de negocio en lugar de términos de red (perdona que insista, pero esto es fundamental). Una solicitud de alta de sucursal requiere el nombre de la sede, una dirección física, una categoría de sede (estándar, pequeña o temporal) y una fecha de activación. No admite un identificador de VLAN. El contrato traduce internamente la intención de negocio a una implementación de red, y esa traducción es responsabilidad de la NAP. Así funciona la capa de servicio del capítulo 4: quien solicita el servicio rellena unos pocos campos de negocio y los patrones de diseño de la Fuente de Verdad (SoT) los desglosan en las VLAN, las subredes y los objetos de enrutamiento que necesita el Ejecutor.
Las definiciones de las categorías no son definitivas: una categoría temporal definida para un quiosco de venta no cubrirá las necesidades de un espacio temporal para eventos con otros requisitos de conectividad. Revisa la interfaz de entrada con los equipos que consumen el servicio con la misma frecuencia con la que revisas la hoja de ruta. Así, las categorías reflejarán los casos de uso reales en lugar de los que previó el equipo de automatización de redes al redactar el contrato.
Interfaz de salida: lo que observa quien consume el servicio, tanto si el proceso se completa con éxito como si falla. Una interfaz de salida bien diseñada muestra algo como «Error de activación: el operador aún no ha aprovisionado el circuito físico en esta dirección». Esto funciona mejor que «Error de despliegue en el paso 7 de 14: se ha rechazado el envío mediante gRPC Network Management Interface (gNMI) con el código de error 400». También puede indicar la fecha prevista de finalización, si hace falta intervenir y que el sistema volverá a intentarlo automáticamente cuando el circuito esté operativo. La automatización emite eventos observables del ciclo de vida en términos que entiende quien consume el servicio, más allá de indicar si el proceso ha tenido éxito o ha fallado. Esos mismos eventos alimentan una vista de estado que puede consultar quien consume el servicio, de modo que el equipo responsable de infraestructura nunca tiene que preguntar al de automatización de redes en qué punto se encuentra la incorporación de una tienda.
Dependencias internas, en la columna derecha de la Figura 15.1: aquello que el servicio supervisa internamente y que quienes lo consumen no deberían ver, pero que el equipo debe gestionar. El estado del circuito que comunica el operador. Los servicios vecinos que comparten infraestructura con este. La coherencia entre el registro de la nueva sede en la SoT y los registros de inventario en los que se basa la monitorización automatizada. Cuando el operador pone un circuito en mantenimiento, el equipo de automatización de redes necesita saber qué servicios se ven afectados y qué riesgo supone esto para el cumplimiento del objetivo de nivel de servicio (SLO). Quien consume el servicio puede necesitar saber cómo le afecta, pero no necesita conocer el detalle de implementación que ha causado el problema.
Una vez definido el contrato de servicio, ¿de qué depende el servicio?
Muchos equipos fallan al abordar las dependencias. Un contrato de servicio abarca más que el momento del aprovisionamiento. ¿Qué ocurre con el servicio cuando cambia la infraestructura que lo sustenta? Si una sucursal depende de un circuito para el que el operador ha programado tareas de mantenimiento, cabe prever un impacto en el SLO. ¿Quién conoce ese impacto, quién decide si hay que avisar al equipo de operaciones de la cadena de tiendas y quién se encarga de la comunicación si el mantenimiento se prolonga más allá de la ventana prevista? Para responder a estas preguntas, los servicios deben ser entidades de pleno derecho en la Fuente de Verdad.
El Capítulo 4 define la intención como el registro de cómo debe ser la red. La SoT conserva ese registro. En el modelo de producto, los servicios amplían esa intención hacia un nivel superior: además de indicar qué elementos de red están relacionados, especifican qué funciones de negocio prestan esos elementos y a quién.
Una SoT que modela dispositivos y circuitos pero no servicios no puede responder a la pregunta «¿A qué tiendas afecta el mantenimiento de este circuito?». Tampoco puede aportar los datos para los mapas de dependencias que permiten gestionar los cambios teniendo en cuenta los servicios. El bloque de Orquestación del Capítulo 8 depende de este grafo para coordinar las medidas correctivas. Un flujo de trabajo en bucle cerrado que responde al fallo de un circuito debe saber qué servicios están afectados antes de poder avisar a nadie o iniciar la recuperación adecuada.
La capa de servicio del Capítulo 4 realiza la expansión. El modelo de servicios del producto añade una capa más por encima: pasa de «¿Qué objetos técnicos deben existir?» a «¿Qué función de negocio prestan esos objetos y a quién?».
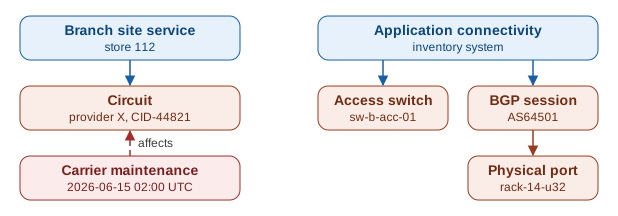
En la práctica, hay que modelar los servicios en la SoT junto con sus cadenas de dependencias. El servicio de una sucursal depende de un circuito físico, que a su vez depende de un proveedor con un historial de ventanas de mantenimiento. Un servicio de conectividad de aplicaciones depende de un conmutador de acceso y de una sesión Border Gateway Protocol (BGP), que a su vez depende de un puerto físico en una instalación concreta. Cuando cambia el estado de cualquier dependencia, el modelo de servicios se actualiza y se puede avisar a quien consume el servicio afectado en términos que entienda.
La Figura 15.2 muestra dos servicios del ejemplo de la cadena de tiendas modelados de este modo. El servicio de sucursal de la tienda 112 depende de un solo circuito. La conectividad de la aplicación del sistema de inventario depende de un conmutador de acceso y de una sesión BGP que, a su vez, depende de un puerto físico. Cuando el operador programa el mantenimiento del circuito, la SoT recorre la cadena en sentido ascendente e identifica el servicio afectado, el de la tienda 112, antes de que comience la ventana de mantenimiento.
Lo ideal es modelar así todos los servicios del catálogo, desde la activación de sucursales y el acceso temporal para eventos hasta la conectividad de aplicaciones, la ampliación del peering y la extensión de VLAN. Cada uno tiene un consumidor dentro del negocio, un ciclo de vida, dependencias y criterios que permiten definir qué significa que el servicio funcione correctamente o que falle.
Sin embargo, la mayoría de los equipos que construyen este modelo no parten de cero. La red existente ya cuenta con trescientas sucursales, años de cambios de configuración acumulados y una SoT que modela dispositivos y circuitos, pero no servicios. Antes de incorporar esas sucursales al modelo de servicios, hay que descubrir su estado real y conciliarlo con lo que la SoT da por cierto. Si la configuración en ejecución de una sucursal se ha desviado de su registro en la SoT, solo se podrá automatizar su gestión de forma segura una vez resuelta la desviación. La automatización aplica la intención tal como figura en la SoT y, si esa representación es incorrecta, aplicarla empeora la situación.
El descubrimiento y la conciliación son un paso previo imprescindible en los entornos brownfield: se lee el estado de los dispositivos y se compara con los registros de la SoT para identificar y resolver discrepancias. La sección Incorporación de entornos brownfield del Capítulo 4 detalla la secuencia. Es un trabajo poco vistoso y lleva tiempo, pero, si se omite, el modelo de servicios solo es válido para las sucursales aprovisionadas después de crear la NAP, que suelen representar una pequeña parte de la red existente.
Modelar los servicios en la SoT es necesario, pero no suficiente: el equipo también debe observarlos en el nivel adecuado. El bloque de Observabilidad del Capítulo 7 cierra el bucle: la observabilidad a nivel de servicio permite comprobar si el servicio funciona correctamente desde la perspectiva de quien lo consume. La observabilidad a nivel de dispositivo permite comprobar si la infraestructura subyacente funciona correctamente. Ambas son necesarias. Si el modelo de servicios carece de instrumentación en el nivel adecuado, quien consume un servicio puede percibir una degradación aunque todos los dispositivos subyacentes indiquen que funcionan correctamente.
Por bien definido que esté un servicio, tiene que importarle a alguien. Y el objetivo ahora es definir qué obtiene el negocio de ese servicio.
Alineación con el negocio#
La eficiencia es el argumento débil. El argumento tradicional a favor de la automatización de redes es la eficiencia operativa: menos tickets, aprovisionamiento más rápido y menores tasas de error. Es un argumento válido y sirve para justificar la inversión inicial, pero no basta para mantenerla. La eficiencia se mide respecto a la situación de partida. Un equipo que reduce el tiempo de aprovisionamiento manual de cuatro horas a cuarenta minutos ha aumentado su capacidad de trabajo. Quien aprobó el presupuesto hace tres años está satisfecho con el resultado, pero no se implica. Que el equipo de redes funcione mejor es positivo, pero no justifica una inversión adicional.
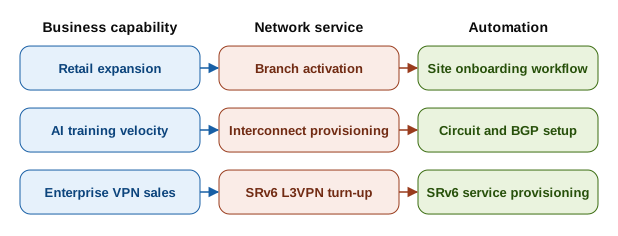
La capacidad es el argumento fuerte. La automatización permite lograr resultados de negocio que de otro modo serían imposibles o tendrían un coste prohibitivo. Tres ejemplos, uno por tipo de red, ilustran el argumento:
- La expansión de una cadena de tiendas. Incorporar 120 tiendas a mano en seis meses exige un equipo dedicado a esa tarea durante todo el periodo. A un ritmo aproximado de una tienda por persona y semana, desde la inspección de la sede y la coordinación con el operador hasta la configuración y la validación, hacen falta 120 semanas de trabajo de ingeniería: unas cinco personas dedicadas en exclusiva durante seis meses. El ritmo varía según el tipo de conectividad y el número de dispositivos, pero el orden de magnitud se mantiene. Con una NAP madura, el equipo existente realiza el mismo trabajo mediante flujos de trabajo en paralelo. Solo la automatización permite llevar a cabo la expansión a un coste aceptable.
- Clústeres de entrenamiento de IA. Una organización que entrena modelos de inteligencia artificial (IA) a gran escala depende de la rapidez con la que se aprovisionan nuevas interconexiones. Si poner en marcha un clúster de entrenamiento requiere dos semanas de trabajo manual en la red, la capacidad de trabajo del equipo de redes limita el ritmo al que el negocio puede realizar experimentos. Reducir ese tiempo a cuatro horas contribuye directamente a una capacidad que el negocio considera estratégica, y un equipo de redes que no sabe explicar esa relación está frenando al negocio.
- Activación de servicios de un proveedor. Un proveedor activa a mano cada L3VPN empresarial en su red troncal de Segment Routing over IPv6 (SRv6): asigna el identificador de segmento del servicio, configura la VRF y la sesión BGP con el equipo de borde del cliente y crea la política SRv6 para la clase de tráfico del cliente. Desde que se recibe el pedido hasta que el servicio está operativo transcurren cuatro semanas. Los competidores que generan, validan y aplican esa misma secuencia mediante un flujo de trabajo probado se comprometen a hacerlo en dos semanas en sus respuestas a las solicitudes de propuestas. Por mucha pericia técnica que tenga el equipo, no puede cerrar esa brecha, porque el límite lo impone el proceso manual en serie. Reducir el plazo de activación a tres días cambia lo que el equipo comercial puede prometer y, por tanto, los contratos que la empresa puede conseguir.
Ninguno de los tres ejemplos se basa en la eficiencia. Los dos primeros son argumentos de capacidad y el tercero es un argumento de ingresos. Los tres tienen cabida en la conversación sobre si conviene invertir en la NAP.
El orden del razonamiento importa. Cuando la automatización se diseña de abajo arriba, partiendo del dispositivo, la primera pregunta es «¿Qué podemos automatizar de la configuración de los routers?». A menudo cuesta explicar su valor para el negocio porque nunca se diseñó para lograr un resultado de negocio. Cuando se diseña de arriba abajo, partiendo del negocio, la primera pregunta es «¿Qué resultados requieren servicios de red fiables?». A partir de ahí se recorre el camino inverso, pasando por el diseño de los servicios hasta llegar a la automatización. Con este enfoque, el equipo puede relacionar su trabajo con las prioridades del negocio desde la primera conversación.
Un mapa de servicios de negocio hace explícita esta relación (ITIL denomina a esta práctica mapeo de servicios): vincula los servicios de red con las capacidades de negocio que hacen posibles. Para cada servicio de red, el mapa responde a tres preguntas. ¿Qué procesos de negocio dependen de él? ¿Cómo afecta al negocio que el servicio se degrade o falle? ¿Y qué sería posible si fuera más rápido, más fiable o estuviera disponible en autoservicio? La responsabilidad de este documento recaería en quien gestione la automatización de redes como producto. Es el principal instrumento para alinear la hoja de ruta de la automatización con las prioridades del negocio.
La Figura 15.3 muestra tres filas de un mapa de este tipo, una por cada ejemplo de esta sección.
Este cambio de enfoque resulta incómodo para muchos equipos de redes porque exige medir otras cosas. Las métricas operativas (por ejemplo, los tickets cerrados, la tasa de éxito de los cambios o el Tiempo medio de recuperación (MTTR)) están bajo el control del equipo y son fáciles de instrumentar. Lo mismo ocurre con las métricas de adopción del Capítulo 14, la proporción de autoservicio y la tasa de recurso a procedimientos manuales: ofrecen la perspectiva interna, es decir, si la gente utiliza la NAP.
Los resultados de negocio ofrecen la perspectiva externa: qué obtiene el negocio gracias a ese uso. Las métricas de resultados de negocio (el tiempo necesario para abrir una tienda o la latencia del aprovisionamiento de interconexiones como factor que influye en el rendimiento del entrenamiento) requieren colaborar con otras unidades de negocio y entender qué miden realmente esas unidades.
El equipo que mide su contribución al negocio en lugar de su excelencia técnica responde a una pregunta distinta cuando se habla de presupuestos. La pregunta ya no es «¿Con qué eficiencia hemos gestionado la red este trimestre?», sino «¿Qué resultados de negocio han dependido de la red este trimestre y qué habría fallado sin ella?». Es una pregunta más difícil de responder, pero es la que determina si la NAP recibe financiación para la siguiente fase.
De ahí se desprende el principio que Marty Cagan denomina «los resultados por encima de los entregables»: dar prioridad a la medición de los resultados que importan al negocio frente a las métricas operativas que solo importan al equipo de redes. Las métricas de eficiencia son datos de entrada. Lo que le importa al negocio son los resultados.
Este cambio de perspectiva también modifica lo que el equipo pide en los ciclos de planificación. Un equipo que afirma «hemos reducido el MTTR en un 40 %» informa sobre su propio rendimiento. Un equipo que afirma «podemos cumplir el calendario de expansión de la cadena de tiendas porque nuestra automatización de incorporaciones permite ejecutar veinticuatro activaciones simultáneas sin intervención manual» informa sobre lo que la empresa es capaz de hacer. Ambas afirmaciones pueden ser ciertas. Solo una de ellas es pertinente a la hora de decidir si se asigna personal al proyecto de expansión.
Si la empresa depende de un servicio, necesita compromisos en los que pueda basar sus planes.
Niveles de servicio para los servicios de red#
Cuando otros equipos dependen de una NAP que no ofrece compromisos de fiabilidad, es fácil confiarse. La plataforma funciona hasta que un día falla, y el equipo que la utiliza carece de datos en los que basar sus planes. Quien está al frente de infraestructura y programa la activación de veinte sucursales para el lunes por la mañana necesita respuestas antes del lunes. ¿Cuánto tardará cada activación? ¿Podrán ejecutarse las veinte en paralelo o tendrán que esperar en una cola? ¿Qué ocurre si una falla a mitad del despliegue y cómo lo comunicará la NAP?
Son preguntas sobre los niveles de servicio. El Capítulo 12 aplicó los indicadores de nivel de servicio (SLI), los SLO y los acuerdos de nivel de servicio (SLA) a la propia NAP. Esa misma jerarquía se aplica a los servicios que presta la NAP y funciona mejor si se construye de abajo arriba en tres pasos, como muestra la Figura 15.4.
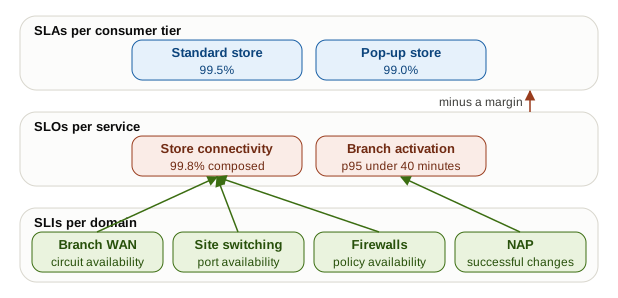
- SLI por dominio. Cada dominio de infraestructura mide los indicadores que controla: la disponibilidad de los circuitos y la pérdida de paquetes en la WAN de las sucursales, la disponibilidad de los puertos de conmutación en cada sede, la disponibilidad de las políticas de los cortafuegos y la tasa de éxito de los cambios de la propia NAP, descrita en el Capítulo 12. Cada equipo de dominio se responsabiliza de sus SLI y de los datos que los sustentan. Así se comparte la responsabilidad, tal como propone la sección Colaboración entre dominios del Capítulo 14.
- SLO por servicio. Un servicio depende de varios dominios, como muestra la cadena de dependencias de la Figura 15.2, por lo que su SLO se calcula a partir de los de esos dominios. Cuando los dominios están en serie, sus disponibilidades se multiplican: una tienda necesita su circuito (99,9 %), la conmutación de la sede (99,95 %) y su política de cortafuegos (99,95 %), por lo que el servicio de conectividad de la tienda puede comprometerse a ofrecer alrededor de un 99,8 %, nunca más de lo que permita su dependencia más débil. Las latencias se suman a lo largo de la cadena. Cada servicio fija sus propios SLO y cada categoría puede tener los suyos: la disponibilidad resultante para una tienda temporal con un solo circuito es menor que para una tienda estándar con un enlace de respaldo.
- SLA por categoría de consumidor. El compromiso con el consumidor se obtiene al restar un margen al SLO, como explica el Capítulo 12, de modo que ni siquiera agotar el presupuesto de errores supone incumplir lo prometido. La disponibilidad calculada para la conectividad de las tiendas es del 99,8 %. El SLA de las tiendas estándar garantiza un 99,5 % y el de las tiendas temporales, un 99,0 %.
Un SLA definido así nunca se basa en conjeturas. Cada una de sus cifras se puede rastrear hasta un SLI medido en un dominio concreto. Cuando empeora el SLI de un dominio, la NAP sabe qué SLO de servicio y qué SLA de los consumidores corren peligro.
La disponibilidad indica si se puede contar con el servicio. Otros dos niveles de servicio permiten planificar su uso:
Latencia de ejecución: tiempo que tarda el servicio en atender una solicitud, desde que se presenta hasta que se completa. Para la activación de una sucursal estándar, los plazos podrían ser los siguientes: acuse de recibo en treinta segundos, inicio del aprovisionamiento en cinco minutos y finalización en cuarenta minutos, como máximo en cada caso. Estas cifras definen qué significa que el servicio «funcione», más allá de que sea accesible.
Presupuesto de errores: frecuencia con la que el servicio puede fallar sin incumplir su SLO. Un servicio que completa con éxito el 99 % de las solicitudes semanales tiene un presupuesto de errores del 1 %. Si falla más del 1 % de las activaciones en una semana, algo va mal y el equipo debe revisar lo ocurrido. El rol de especialista en fiabilidad de redes (NRE) del Capítulo 14 define y defiende estos presupuestos. La regla de la ingeniería de fiabilidad de sitios (SRE) se aplica directamente: cuando se agota el presupuesto, los nuevos despliegues de automatización se suspenden hasta que se restablece la fiabilidad.
El último compromiso es la vía de escalado: a quién debe llamar el consumidor cuando el servicio falla o incumple su SLO y cuánto tardará en recibir respuesta. Una vía de escalado que conduce al buzón general del equipo de redes es una simple cola de incidencias. Hace falta un contacto, identificado por nombre o por función, con un compromiso de respuesta. También debe estar claro quién se hará cargo del fallo una vez recibido el aviso. En casi todos los incidentes se da uno de tres modos de fallo. Si se confunden, el incidente puede quedar sin atender al pasar de un equipo a otro. La Tabla 15.1 compara los tres.
| Modo de fallo | Síntoma | Responsable |
|---|---|---|
| Error de automatización: la lógica del flujo de trabajo es incorrecta | Falla siempre con una entrada concreta y funciona con otras | Responsable de desarrollo de automatización de redes |
| Fallo de la NAP: ha fallado el motor de ejecución, la SoT o la infraestructura de observabilidad | Fallo generalizado que afecta a la vez a varios servicios independientes | Responsable de ingeniería de plataformas de red |
| Fallo de red: ha fallado el dispositivo o el circuito subyacente | La automatización ha terminado sin errores, pero el estado de la red no ha convergido | Equipo de ingeniería de redes |
Los incidentes quedan sin atender cuando se solapan estas categorías. Si un flujo de automatización falla porque se ha rechazado el envío de configuración por gNMI, la causa podría ser un error de automatización (por ejemplo, un modelo de datos incorrecto), un fallo de la NAP (el proceso de trabajo del Ejecutor perdió la sesión) o un fallo de red (el dispositivo se reinició durante el envío). Diseña el proceso de respuesta a incidentes para que el diagnóstico inicial distinga entre estas categorías sin exigir al equipo que utiliza el servicio que sepa cuál corresponde a lo que ha ocurrido. Desde el punto de vista de la cadena comercial, la tienda se ha quedado sin conectividad. Determinar quién lo arregla y cuándo es asunto del proveedor, no de la cadena.
Una secuencia práctica para el diagnóstico inicial de cualquier fallo de automatización consta de tres pasos:
- Revisa los registros de automatización. ¿Ha notificado el flujo de trabajo un error? ¿Se repite al ejecutarlo con la misma entrada? Un fallo que se reproduce siempre con una entrada concreta apunta a un error de automatización. Un fallo intermitente apunta a otra causa.
- Comprueba el estado de la NAP. ¿Están fallando a la vez servicios independientes? ¿Funcionan correctamente el motor de ejecución, la SoT y la pila de observabilidad? Un fallo generalizado y simultáneo de servicios independientes es un fallo de la NAP, digan lo que digan los registros del flujo de trabajo.
- Comprueba el estado del dispositivo. ¿Ha recibido y aplicado el dispositivo la configuración prevista? ¿Coincide su estado con la configuración que envió la automatización? Si el flujo de trabajo ha terminado sin errores pero la red no ha convergido, el fallo está en la red.
Programa esta secuencia como los tres primeros pasos de un procedimiento operativo automatizado, de modo que el personal de ingeniería de guardia disponga ya del diagnóstico inicial cuando atienda el incidente.
La pregunta más incómoda de quien dirige la cadena de tiendas tiene una respuesta similar. No se da por hecho que las tiendas incorporadas durante un incidente de la NAP estén bien ni se auditan una por una. Los registros de ejecución y los datos de procedencia del Capítulo 13 identifican con exactitud en qué tiendas intervino la NAP mientras duró el incidente. La comprobación de desviaciones descrita en la sección Cumplimiento continuo y corrección de desviaciones del mismo capítulo vuelve a contrastar el estado de cada una con la intención. Solo las tiendas que no superan la comprobación requieren atención humana, y en cada caso se dispone del registro de lo que se ejecutó y de la configuración actual del dispositivo. Para un incidente de 40 minutos en plena expansión, el resultado es una lista corta, no 120 auditorías.
El modo de fallo de la NAP enlaza con la Parte 3: la fiabilidad de la NAP es un requisito previo para los SLA de los servicios. Un servicio no puede comprometerse a ofrecer una disponibilidad del 99,5 % si el motor en el que se ejecuta carece de un objetivo de fiabilidad. Los patrones del Capítulo 11 y del Capítulo 12, desde la publicación segura de versiones hasta un plano de control de alta disponibilidad y las métricas de estado, son los que dan credibilidad a los SLA de automatización.
Diseña la vía de escalado antes de que se produzca el incidente. Aclarar después del incidente a quién correspondía cada responsabilidad siempre resulta más difícil que acordar de antemano unos límites claros.
El alcance del impacto es otra cuestión de diseño que conviene tratar en esa misma conversación previa al incidente. Un error de aprovisionamiento manual afecta a una sola sede porque quien realiza la configuración se ocupa de una sede cada vez. Un error de automatización puede afectar a todas las sedes que coincidan con el patrón de entrada antes de que alguien advierta que algo va mal. No ralentices la automatización.
Incorpora al contrato de servicio límites de concurrencia y un despliegue por fases como decisiones expresas de seguridad, no como detalles de implementación. Piensa en un servicio de activación de sucursales que lanza una primera tanda de cinco despliegues, los valida antes de iniciar la siguiente y mantiene en espera cualquier tarea fallida hasta que una persona autoriza su continuación. No es un servicio lento. Su diseño limita el alcance del impacto.
Incluye ese límite en el contrato de servicio junto a la disponibilidad y la latencia de ejecución. Así, los equipos que utilizan la NAP saben tanto qué puede hacer como qué se negará a hacer para protegerlos. Quien dirige infraestructura confía más en la NAP, no menos, si sabe que detendrá un despliegue de cuarenta tiendas cuando falle la primera tanda de cinco, en lugar de ejecutar otros treinta y cinco despliegues con una plantilla defectuosa.
Los compromisos de nivel de servicio, los controles del alcance del impacto y un marco de diagnóstico inicial sientan las bases para una relación distinta con el gobierno de los cambios. En las organizaciones que aún aplican una gestión de cambios tradicional, es posible que cada cambio de red, incluidos los automatizados, se someta a un comité asesor de cambios (CAB) para su aprobación previa. Ese proceso se diseñó para un entorno en el que cada cambio es único, se prepara a mano y es impredecible: que la persona adecuada revise un cambio manual preparado por un miembro del equipo de ingeniería reduce realmente el riesgo, porque el criterio varía de una persona a otra.
Aplica esa misma revisión a un flujo de trabajo automatizado y no reducirás ningún riesgo. El flujo ya se ha diseñado, se ha probado antes de pasar a producción, se ha validado frente a la SoT, se ha limitado el alcance de su impacto y se ha ejecutado con éxito decenas de veces. La revisión solo añade latencia a una operación cuyo riesgo ya se había resuelto antes de su primera ejecución en producción.
La Parte 3 desarrolló la alternativa: el Capítulo 11 asigna el cambio estándar de ITIL al nivel de riesgo standard y el Capítulo 13 convierte las aprobaciones en controles de paso que la NAP hace cumplir. Esta sección justifica ambas medidas desde la perspectiva del producto.
El Patrón de automatización preaprobada (Pre-Approved Automation Pattern), que aplica el cambio estándar de ITIL a la automatización, resuelve este problema: se aprueba una sola vez el diseño del flujo de trabajo, sin tener que aprobar cada ejecución. Una vez que un flujo de trabajo de activación de sucursales ha superado las etapas de validación, ha recibido la aprobación de los equipos de ingeniería y operaciones y ha pasado a producción con sus restricciones de seguridad activas, sus siguientes ejecuciones no constituyen cambios nuevos que requieran otra aprobación. Cada una es una instancia de una operación ya aprobada y con límites definidos. Mediante la Escalera de Confianza (Confidence Ladder) del Capítulo 14, el flujo de trabajo se gana esa aprobación: pasa de las simulaciones a la ejecución supervisada y, por último, a la autonomía respaldada por su historial.
Desde el punto de vista de la gobernanza, la pregunta adecuada es «¿está esta ejecución dentro de los límites aprobados?», en lugar de «¿debería siquiera llevarse a cabo esta ejecución?». Un proveedor de servicios en la nube no exige que una persona apruebe cada nueva red virtual. El servicio se diseñó con restricciones, se probó y se aprobó una sola vez como servicio. Las solicitudes individuales de los clientes que se ajustan a los límites del servicio son simples solicitudes de servicio, no cambios que requieran revisión.
Una vez diseñados y aprobados debidamente, los servicios de automatización de redes deberían funcionar de la misma manera. El resto del capítulo describe el trabajo que justifica esa confianza: contratos de servicio explícitos, resultados observables, un alcance del impacto limitado y un procedimiento definido para clasificar y derivar los problemas cuando algo sale mal. Ese trabajo constituye la aprobación del cambio y se realiza una sola vez, en el momento adecuado, para agilizar la prestación del servicio.
Cumplir los compromisos tiene un coste. ¿Vale el servicio lo que cuesta?
Rendimiento, coste y retorno de la inversión#
La automatización tiene muchos costes recurrentes: la infraestructura de cómputo (para el motor de ejecución, el Orquestador y la pila de observabilidad), el almacenamiento (para los registros de la SoT, el historial de trabajos y la telemetría), el tiempo de ingeniería (para desarrollar, probar y mantener el código de automatización, junto con los correspondientes tokens de IA que se consumen como apoyo a esas tareas de programación), las licencias de herramientas (para los componentes comerciales de la NAP) y la carga de soporte cuando quienes utilizan el servicio notifican problemas o solicitan nuevas capacidades.
El retorno de la inversión (ROI) también es una cuestión real, y los equipos de redes que la eluden dejan las decisiones presupuestarias en manos de los equipos de finanzas y compras, que responderán con menos precisión. Tres dimensiones de coste y valor enmarcan la decisión:
Coste de la automatización: el coste total de construir y operar la NAP. Incluye la parte de los salarios de ingeniería imputable al desarrollo y mantenimiento de la NAP, los costes de infraestructura (cómputo, almacenamiento y redes para la propia infraestructura de automatización), las licencias de herramientas y los gastos generales de operación. Esta cifra se puede calcular y el equipo debería conocerla.
Coste del trabajo manual equivalente: lo que costaría prestar los mismos servicios sin automatización. Para la activación de sucursales, se multiplican las horas de ingeniería por sede por el coste por hora del personal de ingeniería y se suma el coste de los errores: los incidentes derivados de fallos manuales, medidos en términos de MTTR y de servicios afectados. En la expansión de la cadena minorista, el coste manual es lo bastante elevado como para justificar claramente la inversión en automatización. Para un servicio de bajo volumen que se aprovisiona dos veces al año, el cálculo es distinto.
Valor de las capacidades que se hacen posibles: los resultados de negocio que no se podrían alcanzar sin automatización. Es el componente más difícil de cuantificar y el argumento de mayor peso. Abrir ciento veinte tiendas en seis meses supone una ventaja en el mercado, además de una mejora de la eficiencia. Sin automatización, ese plazo es inalcanzable, sea cual sea el presupuesto de ingeniería. El equipo de redes que puede afirmar con claridad «el calendario de expansión de la cadena depende de nuestra NAP» participa en una conversación estratégica, no en una negociación presupuestaria.
Puede parecer difícil cuantificar algunos de estos factores, como el coste del trabajo manual equivalente o el valor que se hace posible, pero inténtalo de todos modos. A mí siempre me cuesta, pero con la práctica se mejora, y es una habilidad que tienes que desarrollar (en paralelo con las habilidades técnicas) para que tu estrategia de automatización tenga éxito.
En la expansión de la cadena minorista, las tres dimensiones se combinan así. La NAP cuesta unos 600.000 dólares al año: tres profesionales de ingeniería con un coste total de 180.000 dólares por persona, más 60.000 dólares en infraestructura y licencias. El trabajo manual equivalente para 120 tiendas suma 120 semanas de trabajo de una persona de ingeniería, unos 415.000 dólares al mismo coste total por persona, sin contar los incidentes que provocan los cambios manuales.
Si solo se consideran los costes, una única adquisición no amortiza la NAP. Dos factores cambian la respuesta. La NAP también da servicio a las 300 sucursales existentes y a todas las adquisiciones futuras, mientras que el coste manual se repite cada vez. Y la tercera dimensión es decisiva: no hay cinco profesionales de ingeniería disponibles durante seis meses, así que, sin automatización, las tiendas abren tarde y el coste real son los meses de ingresos que se pierden.
El coste es una vertiente de la decisión. La otra es el rendimiento del servicio, que no se resume en una sola cifra.
Tres ejes definen el espacio de diseño de cualquier servicio de automatización, y cada uno representa un compromiso que el modelo de producto obliga a hacer explícito. La Figura 15.5 los representa como un triángulo: acercar el servicio a un vértice lo aleja de los demás.
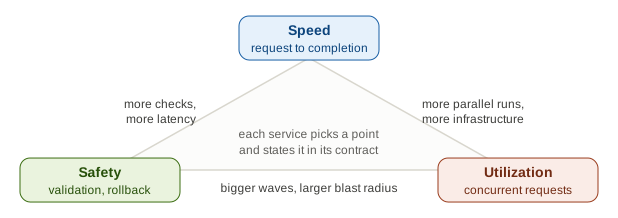
- Rapidez: ¿cuánto tarda el servicio desde que se presenta una solicitud hasta que se completa?
- Seguridad: ¿con qué fiabilidad evita el servicio empeorar la situación mediante la validación, las etapas de simulación y los mecanismos de reversión?
- Utilización: ¿cuántas solicitudes simultáneas puede atender la NAP sin que se degrade el servicio?
Estos ejes están en tensión. Maximizar la seguridad mediante validaciones exhaustivas y etapas de ejecución supervisada aumenta la latencia: un flujo de trabajo más seguro suele ser más lento. Maximizar la rapidez reduciendo las etapas de validación aumenta el riesgo. Maximizar el uso simultáneo del servicio exige una inversión en infraestructura que quizá no se justifique por el volumen real de solicitudes.
El enfoque de producto obliga a que estos compromisos queden explícitos en el contrato de servicio. Cuando la persona responsable de la infraestructura de la cadena minorista pregunta si es seguro realizar veinte despliegues simultáneos, la respuesta no es «funciona en las pruebas». La respuesta es una afirmación concreta sobre el diseño de la NAP. Ejecuta como máximo veinticuatro despliegues a la vez, cada uno tiene su propio mecanismo de reversión y Observabilidad confirma que el dispositivo ha convergido antes de que el trabajo se marque como completado. Quien afirma esto es un equipo que ha tratado estos compromisos como decisiones de diseño del producto.
La medición del ROI influye directamente en la priorización. Deja que los resultados de negocio más condicionados por las limitaciones de la red determinen qué automatizar a continuación. Lleva un registro de las solicitudes manuales que más tiempo de ingeniería consumen, de los servicios que fallan con mayor frecuencia al aprovisionarlos a mano y de las capacidades de negocio que están a la espera de que la red pueda darles soporte. Con esos datos puedes justificar las prioridades con argumentos que el negocio puede evaluar. El equipo que carece de esos datos defiende sus prioridades en función de lo que le resulta técnicamente interesante y, cuando se reparten los presupuestos, pierde terreno frente a los equipos que han cuantificado su impacto.
Priorización y hoja de ruta#
Si todo es importante, nada lo es.
Patrick Lencioni
Todos los equipos de automatización de redes se enfrentan una y otra vez a dos preguntas que rara vez reciben una respuesta formal: qué tareas automatizar a continuación y cuándo decir que no a una solicitud. El modelo de producto exige una respuesta formal a ambas. Estas son las categorías de priorización. Ordénalas por importancia, porque si todas las solicitudes son importantes, ninguna ocupa el primer lugar en la hoja de ruta:
Impacto en el negocio: ¿qué servicio, una vez automatizado, hace posible la capacidad de negocio de mayor valor? Para responder a esta pregunta, se parte del mapa de servicios de negocio de la sección Alineación con el negocio. Automatizar un servicio que permite sacar adelante una iniciativa estratégica del negocio tiene prioridad sobre automatizar otro que ahorra doce horas de ingeniería al año.
Frecuencia por esfuerzo: ¿con qué frecuencia se realiza esta tarea manualmente y cuánto tiempo de ingeniería requiere cada vez? Automatizar una tarea de cuatro horas que se realiza cada día laborable ahorra unas cuarenta veces más horas de ingeniería que automatizar una tarea semanal de treinta minutos. Las tareas manuales frecuentes que requieren un esfuerzo considerable en cada ocasión son los casos más claros para la automatización.
Reducción del riesgo: merece la pena automatizar algunas tareas aunque sean infrecuentes, porque el coste de un error humano es catastrófico. Merece la pena automatizar los cambios manuales en las relaciones de peering BGP que, si se configuran mal, provocan fugas de rutas que afectan a cientos de clientes, aunque esos cambios solo se realicen seis veces al año. La automatización se justifica por la eliminación de un modo de fallo con consecuencias inaceptables, no por el volumen de cambios que permite procesar.
Demanda de los equipos consumidores: ¿qué piden expresamente los demás equipos? La demanda de los equipos consumidores es un indicador imperfecto, porque a menudo piden lo que saben que es posible en vez de lo que más valor aportaría. Pero las solicitudes reiteradas de los mismos equipos para obtener la misma capacidad aportan información significativa sobre los puntos en los que la interfaz del servicio no se ajusta a los casos de uso reales.
Una lista de tareas de automatización pendientes trata las tareas aún sin automatizar como un equipo de producto trata los elementos pendientes de su producto: cada tarea tiene una prioridad, una estimación y criterios de aceptación claros que definen qué significa «terminada». «Terminada» no significa «la automatización se ha ejecutado correctamente en el laboratorio». Significa «la automatización ha superado las etapas de la Escalera de Confianza descritas en la sección Nueva gestión de cambios del Capítulo 14, está documentada y los equipos consumidores correspondientes pueden utilizarla en régimen de autoservicio». Las partes interesadas pueden consultar la lista para ver qué está previsto y planificar en consecuencia.
Comunicar la hoja de ruta importa más que la propia hoja de ruta. Compartir cada trimestre la hoja de ruta de automatización de redes con los equipos que dependen de ella genera confianza. Permite que el negocio entienda el trabajo del equipo de automatización. Los equipos consumidores pueden planificar su propio trabajo en función de lo que la NAP podrá y no podrá hacer el trimestre siguiente. También les da la oportunidad de aportar comentarios y plantear requisitos cuya existencia desconocía el equipo de automatización de redes.
Las opiniones de quienes usan los servicios y de las demás partes interesadas son la mejor fuente para decidir qué entra en la hoja de ruta. ¿Qué equipos solicitan más excepciones? ¿Qué resultados obligan a quien los recibe a interpretarlos a mano antes de actuar? ¿Dónde exige la interfaz formular una petición en términos de red cuando el usuario la plantearía en términos de negocio? Son señales sobre el producto. Recogerlas de forma sistemática permite que la hoja de ruta refleje lo que los usuarios necesitan, incluso cuando difiere de lo que el equipo de automatización supone que deberían querer.
Conviene fijar expresamente la frecuencia de las reuniones con las partes interesadas. Para la mayoría de los servicios basta con reunirse cada trimestre. Para los que están en desarrollo activo, cada mes. Su función va más allá de informar sobre el estado de los trabajos. Se revisa la hoja de ruta, se recoge la experiencia de quienes usan el servicio y se comunican los próximos cambios. Así es como una NAP se comporta como un producto que escucha a sus usuarios. Los equipos que omiten este paso gastan el presupuesto de este año en automatizar la solución al problema del año pasado.
Alguien debe responder de estas decisiones. Eso constituye una función propia.
La función de gestión de producto#
No todos los equipos necesitan una persona dedicada a tiempo completo a la gestión de producto. Pero cualquier programa de automatización maduro necesita que alguien asuma esa función.
En un equipo pequeño, quien lo dirige o asume el liderazgo técnico puede compaginar la gestión de producto con el trabajo técnico. Mantiene la lista de trabajo pendiente, dirige las reuniones con las partes interesadas y se encarga de las conversaciones sobre los objetivos del negocio. A esta escala bastan unas horas semanales para mantener la función.
A medida que crece la NAP, interpretar las necesidades externas para el equipo de ingeniería y explicar las posibilidades técnicas al negocio exige bastante más trabajo. Una NAP que presta servicio a diez equipos, con treinta servicios en producción y una hoja de ruta trimestral que obliga a negociar entre prioridades contrapuestas, ya no puede gestionarse como producto en unas horas a la semana. La función se convierte en un puesto a tiempo completo.
El puesto de responsable de producto de automatización de redes (Network Automation Product Manager) está surgiendo en organizaciones con programas de automatización maduros. Sus responsabilidades son las siguientes:
- Llevar la relación con las partes interesadas en nombre de la NAP. Es el contacto principal para los equipos usuarios y convierte sus necesidades en requisitos del servicio.
- Mantener el mapa de servicios de negocio y la lista de trabajo pendiente de automatización. Al establecer prioridades, tiene en cuenta tanto el impacto en el negocio como las posibilidades reales de ingeniería.
- Comunicar la hoja de ruta fuera del equipo y gestionar las expectativas cuando cambian las prioridades.
- Definir y seguir métricas de impacto en el negocio para que la dirección vea cómo contribuye la NAP a los resultados.
- Aportar la perspectiva de los usuarios en las conversaciones del equipo sobre prioridades, de modo que el trabajo de ingeniería responda a necesidades reales.
Este puesto no exige conocimientos profundos de redes. Sí exige entender qué puede entregar el equipo de automatización de redes, qué necesita el negocio y en qué coinciden o difieren ambas cosas.
La colaboración entre el responsable de producto de automatización de redes y los perfiles técnicos de la sección Nuevos roles en un mundo automatizado del capítulo 14 sigue un modelo habitual en las organizaciones que desarrollan productos de software. El responsable de producto (PM) decide qué construir y por qué. El personal de ingeniería de la NAP y el de desarrollo de automatización se encargan de cómo construirlo. El NRE se encarga de mantenerlo en buen estado en producción. Los desacuerdos entre ellos forman parte del modelo: el PM defiende las necesidades de los usuarios, ingeniería defiende la sostenibilidad de la NAP y esa tensión mejora las decisiones que tomaría cada parte por separado.
En algunas organizaciones de redes, introducir este puesto no técnico en un equipo de orientación técnica genera controversia. La preocupación tiene fundamento. Sin suficiente base técnica, el PM puede asumir compromisos que ingeniería no podrá cumplir. También le costará distinguir las peticiones sencillas de implantar de las que exigen cambios profundos en la NAP. La solución es concretar los límites de la colaboración.
Dos límites son innegociables. El PM solo puede prometer una fecha de entrega a alguien ajeno al equipo si el responsable de ingeniería ha dado el visto bueno al alcance y al plazo. Y el responsable de ingeniería puede vetar cualquier compromiso que dependa de cambios en la NAP pendientes de diseño o estimación. Sin estos límites, el puesto de PM introduce otro modo de fallo: se hacen promesas a las partes interesadas y el equipo de ingeniería se entera después. Quien pierde credibilidad es la NAP.
En las conversaciones de producto, el PM también se encuentra con los tres tipos de resistencia descritos en la sección Patrones de resistencia al cambio del capítulo 14. El experto veterano se resiste a ver la red como un producto porque siente que sus conocimientos pasan a ser un detalle de implementación. El éxito invisible se manifiesta cuando los usuarios dejan de comunicar problemas porque dan por hecho que nada cambiará. La automatización en la que solo confían sus autores se manifiesta como un servicio que termina correctamente sin mostrar qué ha hecho. Quienes reciben el resultado tienen que verificarlo a mano para confiar en él. Las respuestas son las mismas: dar al experto la responsabilidad de diseñar el contrato del servicio, hacer visible el éxito con métricas explícitas e incorporar transparencia a los resultados que entrega el servicio.
Un año después de iniciar su transición, invitaron a Jordi a una reunión del proyecto de integración de la cadena de tiendas. La persona que dirigía el equipo de negocio repasó el calendario de incorporaciones y señaló un periodo de seis semanas en el que debían entrar en servicio cuarenta tiendas a la vez. «¿Está preparada la automatización para eso?», preguntó. Jordi tenía la respuesta. La NAP podía procesar veinticuatro a la vez, pero la telemetría completa de una sede recién activada tardaba doce horas en llegar. Activar las cuarenta a la vez significaba que cuarenta sedes funcionarían medio día con una cobertura de observabilidad reducida.
Lo dijo sin rodeos, identificó el riesgo y propuso modificar la secuencia de altas. Podían repartir las activaciones a lo largo de tres días sin alargar el calendario general. El equipo de negocio aceptó. La conversación duró quince minutos porque Jordi entendía tanto la limitación técnica como sus consecuencias para el negocio. Traducir lo que hace la NAP a lo que experimenta el negocio es la función de gestión de producto, sea cual sea el título de quien la ejerce.
Esta función se aprecia mejor al seguir un servicio en el tiempo, desde la primera solicitud hasta su retirada.
Gestión del ciclo de vida del servicio#
La sección La función de gestión de producto enumera las responsabilidades del PM. Ahora veremos cómo se ejercen a lo largo de las cuatro etapas por las que pasa todo servicio de red: definición, entrega, operación y evolución. La escalera de adopción del capítulo 14 mide hasta qué punto un equipo confía en su automatización. Este ciclo de vida sigue un servicio desde la primera solicitud hasta su retirada. La Figura 15.6 muestra las cuatro etapas.
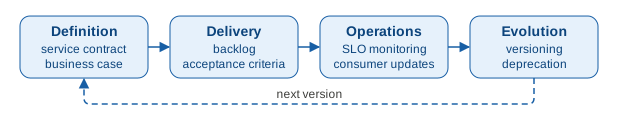
Definición
El PM empieza a trabajar en un servicio nuevo antes de que el equipo de ingeniería escriba una sola línea de código de automatización. Un equipo usuario llega con una petición: «necesitamos incorporar tiendas más deprisa» o «nuestro equipo de aplicaciones no puede aprovisionar segmentos de red sin abrir un ticket». En esta etapa, el PM convierte la petición en un contrato de servicio acotado con los tres componentes de la sección Definición del producto. ¿Qué aporta el usuario como entrada? ¿Qué puede observar como salida? ¿De qué depende el servicio que el usuario no debería tener que conocer?
Para llegar a ese contrato, el PM y el responsable de ingeniería se sientan juntos a negociar entre lo que necesita el usuario y lo que puede proporcionar la NAP. Entregar un documento de requisitos a ingeniería por sí solo no resuelve esa negociación.
El PM debe responder a «¿cuándo podemos darlo por terminado desde el punto de vista del usuario?». El responsable de ingeniería responde a esa misma pregunta desde el punto de vista de la NAP. La definición solo está terminada una vez contestadas ambas preguntas. Un contrato que satisface al usuario pero ignora los límites de la NAP obliga a rehacer trabajo durante la entrega. Uno que satisface a la NAP pero deja fuera las necesidades del usuario caerá en desuso tras el lanzamiento.
Antes de cerrar la definición, el PM sitúa el nuevo servicio en el mapa de servicios de negocio de la sección Alineación con el negocio. Así quedan explícitas su justificación y su prioridad, y se pueden evaluar los elementos pendientes con criterios uniformes. Si nadie puede explicar qué capacidad de negocio aporta o qué impacto tendría su ausencia, aún no se puede situar en el mapa ni está listo para definirse. Recomiendo empezar siempre por la conversación con quien usará el servicio o tenga interés en él. La conversación con ingeniería viene después, cuando hace falta.
Entrega
Una vez acordado el contrato de servicio, el PM gestiona el trabajo de automatización correspondiente durante el desarrollo. Redacta los criterios de aceptación en términos del usuario: «una sucursal estándar debe activarse en los cuarenta minutos siguientes al envío de la solicitud y emitir un evento en cada etapa». Un criterio como «el envío por gNMI al router de la sucursal termina sin errores» mide otra cosa. La diferencia importa. Los criterios centrados en la implementación pueden cumplirse aunque la experiencia del usuario falle: la configuración llegó al dispositivo, pero nadie avisó al usuario y este no sabe si la tienda ya está en servicio.
Durante la entrega, el PM se ocupa de toda la comunicación externa sobre plazos y alcance. El responsable de ingeniería toma las decisiones técnicas internas. Este reparto protege al equipo de lo que hace descarrilar tantos proyectos de automatización: las ampliaciones de alcance que llegan una vez acordado el contrato del servicio. Cada requisito nuevo tras la aprobación del contrato entra en la lista de trabajo pendiente y recibe su propia prioridad. La entrega en curso conserva el alcance pactado. Corresponde al PM mantener ese límite con los equipos usuarios. Si tiene que hacerlo el equipo de ingeniería, la relación con ellos se resiente. Una entrega cuyo alcance puede ampliar cualquiera en cualquier momento es una entrega que nunca se termina.
Operación
Al entrar el servicio en producción, el PM pasa de gestionar la entrega a mantener la confianza. Los niveles de servicio de la sección Niveles de servicio para los servicios de red definen los compromisos de disponibilidad, latencia de ejecución, presupuesto de errores y vía de escalado. El PM sigue esas métricas. El diagnóstico de fallos corresponde al NRE. El PM se encarga de comunicarse con los usuarios cuando una métrica se aproxima a su umbral o lo rebasa. Si un equipo descubre que lleva un tiempo fuera de su SLA al mirar un panel que nadie le había pedido vigilar, lo único que ha recibido es una métrica. Un SLA conlleva una relación, y el PM es quien la mantiene.
El PM también recoge la experiencia de los usuarios durante la operación. ¿Qué equipos presentan más solicitudes de excepción? ¿Qué resultados requieren una interpretación manual antes de que el usuario pueda actuar? Son datos sobre el producto. El PM los agrupa y los presenta al discutir la hoja de ruta con suficiente detalle para que ingeniería pueda actuar.
«Los usuarios están descontentos con las activaciones de sucursales» apenas da pistas sobre qué hacer. «Siete de las últimas doce solicitudes de excepción correspondían a sedes temporales que no encajan en ningún nivel definido, y las siete necesitaron al equipo de automatización de redes» sí permite actuar. Identifica una carencia concreta en las entradas del servicio y cuantifica su coste operativo.
Evolución
Si un servicio deja de evolucionar, se acumulan las diferencias entre aquello para lo que se diseñó y lo que los usuarios necesitan. El PM decide cuándo y cómo debe evolucionar a partir de la información recogida durante la operación y de los cambios en el mapa de servicios de negocio.
No todos los cambios tienen las mismas consecuencias operativas. Añadir un campo de entrada opcional o enviar un evento de salida con más información amplía el servicio. Quienes ya lo usan pueden seguir como hasta ahora y adoptar la novedad cuando quieran. En cambio, renombrar un campo obligatorio, eliminar un evento o alterar un compromiso del SLA rompe el contrato de quienes dependen de él. Antes de iniciar el cambio, el PM debe distinguir los dos casos porque siguen procesos distintos. Una ampliación llega como actualización menor. Un cambio incompatible exige una nueva versión, una vía de migración y un calendario de retirada que se comunique a los equipos usuarios antes del despliegue.
Muchos equipos tropiezan con el calendario de retirada. Es natural que ingeniería quiera retirar la versión anterior en cuanto la nueva sea estable. También es natural que los equipos usuarios quieran seguir en la versión de la que dependen hasta tener capacidad para migrar. El PM negocia la ventana entre ambas partes y asume con ellas un compromiso concreto: la fecha a partir de la cual la versión anterior dejará de tener soporte. La comunica con suficiente antelación para que los equipos puedan planificar la migración. Cuando se omite este proceso, se deteriora la confianza que debía generar el contrato. Si los usuarios descubren en producción un cambio incompatible, ha fallado la relación con ellos. Y eso cuesta más repararlo que un fallo técnico.
Si gestionas el servicio así, conservará en cada versión la confianza que su contrato buscaba merecer.
Resumen#
Ofrecer la red como un producto debería ser el objetivo último de la automatización de redes, aunque quizá nunca llegues a alcanzarlo por completo. Aun así, esa forma de pensar sigue siendo válida. La NAP debería exponer la red como cualquier otro servicio de infraestructura, teniendo en cuenta su complejidad interna y ofreciendo contratos claros en los que puedan apoyarse otros procesos del negocio.
Tratar la red como un producto exige un nuevo enfoque y una arquitectura sólida que cubra lo que un producto necesita. Hay que definir qué aporta al negocio, qué impacto tiene, qué nuevas capacidades ofrece y qué retorno produce la inversión. Aquí se aplica la terminología de niveles de servicio que ya conoces. También cuenta el ciclo de vida del propio servicio: definición, entrega, operación y evolución. Además, la NAP debe admitir acciones de automatización preaprobadas que puedan ejecutarse sin pedir aprobación humana cada vez.
La parte 5 se apoya en esta disciplina de producto para introducir la conciliación en bucle cerrado, las redes con autorrecuperación y, por último, las redes autónomas que optimizan su funcionamiento dentro de unos límites y con intervención humana mínima. Sin contratos ni niveles de servicio no puedes confiar en ningún sistema.
Referencias#
- Continuous Delivery, Jez Humble y David Farley (Addison-Wesley, 2010). Cómo construir cadenas de despliegue que permitan publicar versiones de forma fiable y con poco riesgo.
- The Site Reliability Workbook, Betsy Beyer, Niall Richard Murphy, David K. Rensin, Kent Kawahara y Stephen Thorne (O’Reilly, 2018). Guía práctica para definir SLO y presupuestos de errores, y para equilibrar fiabilidad y velocidad. La sección Niveles de servicio para los servicios de red aplica este modelo a los servicios que entrega la NAP. (Texto completo disponible gratis en línea).
- Empowered: Ordinary People, Extraordinary Products, Marty Cagan y Chris Jones (Wiley, 2020). Cómo organizar los equipos en torno a los resultados que deben conseguir. La función del responsable de producto de automatización de redes descrita en La función de gestión de producto se basa en este marco.
- Project to Product, Mik Kersten (IT Revolution, 2018). Por qué el trabajo organizado en proyectos pierde valor con el tiempo y el organizado en torno a productos lo acumula.
- Accelerate: The Science of Lean Software and DevOps, Nicole Forsgren, Jez Humble y Gene Kim (IT Revolution, 2018). Estudia la relación entre los comités de aprobación de cambios y una entrega más lenta, sin mayor estabilidad. Es la base del patrón de automatización preaprobada de la sección Niveles de servicio para los servicios de red.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo