Cambio cultural#
Jordi llevaba quince años trabajando como ingeniero de redes. Había ido ascendiendo en su carrera y, tras obtener la certificación CCIE, sentía que había llegado a lo más alto. Todo el mundo acudía a él cuando surgía un proyecto de redes importante, así que, al recibir una convocatoria de reunión titulada «Cambios en la estructura del equipo de redes», esperaba novedades sobre la plantilla que pudieran suponerle un merecido ascenso.
Te adelanto el desenlace: no fue así.
Su responsable le explicó que el equipo de redes pasaría a depender del área de Ingeniería de Plataformas y que el nuevo equipo se llamaría Ingeniería de Plataformas de Red. Tenían que adoptar una nueva forma de trabajar: dedicar más tiempo a construir y operar los sistemas de automatización que a las operaciones manuales. Y, para su sorpresa, su puesto pasó a llamarse «ingeniero de plataformas de red» y sus funciones también cambiaron.
Lo primero que hizo Jordi al llegar a casa aquel día fue buscar información sobre su nuevo puesto. La mayoría de los resultados le llevaban a ofertas de empleo en el ámbito de la nube y a infraestructuras de orquestación de contenedores (un terreno totalmente desconocido para él). Ni siquiera había escrito un script de diez líneas en Python y lo único que sabía de Git venía de unos blogs que había leído. No sabía si ilusionarse o echarse a temblar.
El tiempo pasó volando y, para finales de año, Jordi ya había puesto en producción dos flujos de trabajo totalmente automatizados que multiplicaron exponencialmente el impacto de su trabajo. Ganó confianza al colaborar con especialistas en ingeniería de software, revisar código y definir una estrategia de automatización de redes. Pero, a decir verdad, no era desarrollador de software. Era algo mejor: un ingeniero que entendía tanto la red como los sistemas que la operaban.
Este capítulo trata de esa transformación. No solo de la de Jordi, sino también de la de la organización. La tecnología que hemos visto en los capítulos 1 a 13 no funciona por sí sola. Hace falta gente con competencias, funciones y formas de colaborar distintas de las que tradicionalmente se han desarrollado en la ingeniería de redes. Acertar con la tecnología es difícil. Acertar con la transformación de la organización es aún más difícil, y es ahí donde más a menudo fracasan las iniciativas de automatización.
La crisis de identidad#
La única forma de encontrarle sentido al cambio es sumergirse en él, moverse a su ritmo y sumarse al baile.
Alan Watts
Aprender Git o Python es la parte fácil del cambio cultural. Lo más difícil es dar el paso: desprenderte de la identidad que has forjado a lo largo de años de dominio de la interfaz de línea de comandos (CLI).
La ingeniería de redes forjó su cultura profesional en torno a unos conocimientos que, hasta hace poco, eran difíciles de adquirir e imposibles de fingir. Entender cómo converge BGP cuando se produce un fallo. Diagnosticar cambios en la topología del árbol de expansión a las 02:00 (y sí, el protocolo de árbol de expansión se sigue usando mucho en producción). Leer una captura de paquetes y detectar una sutil discrepancia de MTU antes de que el equipo de aplicaciones haya terminado de registrar la incidencia. Son competencias técnicas exigentes que se adquieren tras años de práctica y que han dado lugar a identidades profesionales muy arraigadas.
La automatización altera la expresión más visible de esos conocimientos. Supongamos que una plataforma de automatización de redes (NAP) bien diseñada se ocupa del aprovisionamiento de VLAN, del refuerzo de la seguridad de la configuración y de la incorporación de dispositivos sin intervención manual. Quien ha dedicado años a dominar esas tareas a mano se enfrenta a una elección que parece contradictoria. Usar la automatización para sustituir aquello que se te da bien o resistirte a ella para proteger la competencia que te define.
Cuanto mejor dominas un oficio, más probable es que cualquier abstracción que oculte sus detalles te parezca una amenaza antes de que puedas verla como una herramienta. Quien conoce cada particularidad de la CLI de cada fabricante tiene un motivo perfectamente racional para resistirse a la capa de abstracción: se le pide que cambie un terreno que domina por otro que desconoce.
Hay una forma más positiva de verlo: la automatización no sustituye el conocimiento profundo de las redes, sino que amplía su impacto. Aprovecha ese conocimiento y lo aplica a otra escala. Quien domina la convergencia de BGP cobra más relevancia en un entorno automatizado, porque ahora puede aplicar sus conocimientos de forma continua mediante una automatización en bucle cerrado que hace cumplir sus directrices técnicas, sin tener que conectarse a un dispositivo por Secure Shell (SSH). Las competencias pasan de la ejecución al diseño o, dicho de otro modo, de ejecutar comandos a definir qué comandos se deben ejecutar y en qué condiciones.
Ese paso de «configuro redes» a «construyo sistemas que configuran redes» es la transformación cultural que ocupa el centro de este capítulo. Lo que falta no son competencias. Es un cambio de enfoque. La Figura 14.1 lo muestra.
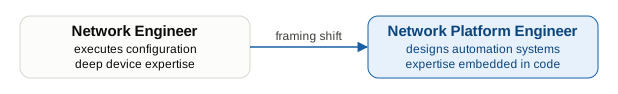
Quien supera con éxito esta transición siente curiosidad por entender cómo funciona la automatización y se responsabiliza de ella hasta conseguir que resuelva las tareas de operación de la red tan bien como lo haría por su cuenta. Quien da ese paso más y pasa de usar la automatización a definirla sale ganando. Hay muchos aspectos en juego: cómo pasa la configuración de la intención al dispositivo, cómo se propaga un fallo o cómo se recupera el sistema. Esa curiosidad es la actitud que permite culminar la transición con éxito. Pero esto debería resultarte familiar. También antes de la automatización la curiosidad distinguía a los mejores profesionales de la ingeniería de redes: querían entender el protocolo, no solo seguir la receta.
Puedo contarte el momento en que lo vi claro y decidí volcarme en el desarrollo de software. Un compañero y yo estábamos investigando un problema con un agente SNMP y llegamos a la conclusión de que el fallo estaba en el propio agente. Lo habitual para mí era abrir una incidencia con el fabricante, pero mi compañero me enseñó a depurar el agente (era de código abierto) y a dar con una corrección que podíamos usar de inmediato mientras la enviábamos al proyecto para que se incorporara a una versión. Aquello cambió mi idea de lo que era capaz de hacer.
Esa curiosidad se traduce en un impacto de una magnitud que nadie puede alcanzar trabajando a mano por su cuenta. Un solo flujo de trabajo automatizado que se ejecute correctamente en ochocientos conmutadores hace en minutos más trabajo del que un equipo podría completar en una semana de ventanas de cambio manuales. Ese flujo no ha sustituido a quien lo creó. Ha multiplicado el alcance de su trabajo. Sus conocimientos están ahora integrados en un sistema que funciona mientras duerme, resuelve las tareas rutinarias de forma sistemática y libera tiempo del equipo de ingeniería para los problemas que aún requieren criterio profesional. Ni el mayor dominio de la CLI en operaciones manuales permitiría alcanzar semejante capacidad de actuación.
La automatización de redes hace más que acelerar el aprovisionamiento. Plasma en código los conocimientos de quienes la construyeron. Esa comprobación de una sesión BGP que se escribe en diez minutos encierra quince años de experiencia en operaciones. La comprobación se ejecuta correctamente tanto si quien la escribió está de guardia como si está de vacaciones o ya se ha jubilado. La automatización no retiene a esa persona. Conserva lo que sabe. Esa distinción importa cada vez que alguien con mucha experiencia deja un equipo y la organización se pregunta cuánto conocimiento colectivo se ha llevado consigo.
En el Capítulo 1, entre las barreras a la automatización figuraban el miedo al cambio y el desajuste entre las competencias disponibles y las necesarias. Esas barreras no desaparecen porque un responsable reorganice el equipo. Hay que prestar atención expresa a cómo se definen las funciones, cómo se desarrollan las competencias y cómo transmite la organización que, en el nuevo modelo, el conocimiento profundo de las redes vale más, no menos.
La crisis de identidad suele empezar ahí: el puesto tiene un nombre nuevo que quien lo ocupa todavía no sabría definir y la propia organización aún está averiguando cómo apoyar a quien desempeña esa función.
Nuevos perfiles profesionales en un mundo automatizado#
La pregunta más contraproducente que puede hacerse un equipo al iniciar la transición hacia la automatización es «¿qué puestos de trabajo van a desaparecer?». Resulta más útil preguntarse «¿qué perfiles profesionales están surgiendo y qué se necesita para desempeñar esas funciones?».
La mayoría de los perfiles profesionales evolucionan en lugar de desaparecer. Lo que cambia es dónde se concentra el valor. La persona que dedicaba ocho horas al día a tramitar solicitudes de cambios manuales conserva su puesto. Lo que desaparece son esas ocho horas de tramitación. El tiempo que se libera puede dedicarse a tareas de mayor valor o, si el equipo no dirige activamente la transición, acabar generando fricciones dentro de la organización.
Los siguientes perfiles aparecen de forma recurrente en los equipos que han completado la transición con éxito. Se trata de perfiles profesionales (distintos de los roles de acceso del Capítulo 9): quien ocupe cualquiera de estos puestos puede tener el rol de ingeniero del capítulo 9, que permite escribir flujos de trabajo, o el rol de operador, que permite solicitar su ejecución.
Ingeniero de plataformas de red: Quien ocupa este puesto asume la responsabilidad técnica de la NAP como producto de ingeniería. La NAP abarca el diseño del esquema de la Fuente de Verdad (SoT), los flujos de trabajo de cambio que validan y despliegan cambios en la red, las cadenas de CI/CD que prueban y publican el código de la propia NAP, la pila de observabilidad de la red y los contratos de interfaz entre los bloques de automatización. Este perfil es el equivalente en redes del equipo de productividad de desarrollo que opera la plataforma interna para desarrolladores (IDP) del capítulo 11: construye y mantiene el sistema que otros profesionales de ingeniería utilizan para operar la red. El puesto está directamente relacionado con el trabajo de arquitectura de los capítulos 4 a 10 y con los patrones de ingeniería de plataformas del Capítulo 11.
Ingeniero de fiabilidad de redes (NRE): El modelo de ingeniería de fiabilidad de sitios (SRE), concebido para servicios de software a gran escala, es aplicable a la automatización de redes con adaptaciones importantes. Quien ejerce de NRE adapta los principios de SRE a las operaciones de red: define objetivos de nivel de servicio para la NAP y sus flujos de trabajo de cambio, diseña procesos de respuesta a incidentes para los fallos de automatización y mantiene presupuestos de errores que equilibran el ritmo de incorporación de nuevas funciones con la estabilidad operativa. Cuando una automatización en bucle cerrado actúa de forma incorrecta a las 03:00, el NRE es la persona responsable de haber preparado de antemano el procedimiento operativo para ese modo de fallo.
Arquitecto de red: Este perfil se aleja cada vez más de los dispositivos y se acerca a la intención. Quien desempeña esta función define cómo debe ser la red: los modelos de intención en la Fuente de Verdad, los patrones de diseño que aplicará la automatización y las políticas que rigen la topología y el direccionamiento. Dedica menos tiempo a la CLI de los dispositivos y más al diseño de esquemas, a la revisión de la arquitectura con otros equipos y a evaluar cómo las decisiones de diseño limitan o posibilitan la automatización. El Capítulo 4 describe la capa de intención, que es su principal responsabilidad.
Ingeniero de datos de red: La automatización en bucle cerrado, las redes con autorrecuperación y la operación autónoma (que se tratan en los Capítulos 16 a 18) dependen de datos operativos de alta calidad. Quien desempeña esta función crea y mantiene los flujos de datos que alimentan los sistemas de Observabilidad, define los esquemas que permiten actuar a partir de la telemetría y responde de la calidad de los datos en los que se basan las decisiones automatizadas. Esta función conecta el bloque arquitectónico de Observabilidad del Capítulo 7 con los patrones de bucle cerrado de la Parte 5.
Desarrollador de automatización de redes: Quien desempeña esta función escribe el propio código de automatización: la lógica de integración, la orquestación de flujos de trabajo, los marcos de validación y las herramientas de las que depende la NAP. Puede venir de la ingeniería de software, haberse integrado en el equipo de automatización de redes y haber aprendido lo suficiente sobre redes para trabajar con soltura, o bien venir de la ingeniería de redes y haber aprendido lo suficiente sobre desarrollo de software para trabajar con eficacia. Ambos caminos funcionan. La diferencia principal con el perfil de ingeniería de plataformas de red está en el alcance: quien desarrolla la automatización aporta funciones concretas de automatización, mientras que quien se encarga de la plataforma responde del sistema en el que se ejecutan.
Muchas organizaciones agrupan estas funciones bajo un único título, «ingeniero de automatización de redes». Esa denominación general funciona bien en equipos pequeños. A medida que crece la NAP, las distintas especialidades imponen límites reales: la persona que destaca en el diseño de esquemas y contratos de interfaz quizá no sea la más indicada para asumir la responsabilidad de la fiabilidad de la NAP durante las guardias.
La mayoría de los equipos crecen siguiendo la misma secuencia. Empiezan con una o dos personas de perfil generalista que desarrollan y operan la NAP a la vez que se ocupan de la red. Cuando varios equipos dependen de la NAP, el trabajo se reparte: una persona se responsabiliza de la propia NAP y otras crean flujos de trabajo sobre ella.
Cuando la NAP pasa a tener su propio turno de guardia, la fiabilidad se convierte en una función por derecho propio. Los perfiles de arquitectura y datos llegan al final, cuando el uso de los modelos de intención y de la telemetría está tan extendido que hace falta alguien que se responsabilice de ellos. Cuando la NAP ya da servicio a muchos equipos, alguien asume también la gestión del producto, que se describe en el Capítulo 15.
El papel tradicional de quien opera la red se reduce, pero no desaparece. Lo que desaparece es la ejecución repetitiva: el aprovisionamiento manual, las sesiones de CLI para atender cada ticket y los flujos de trabajo en los que una persona se limita a ejecutar scripts. El criterio que hay detrás (saber cuándo algo va mal, detectar lo que la automatización ha pasado por alto y decidir cómo actuar ante un incidente ambiguo) sigue siendo valioso y pasa de la ejecución rutinaria al aseguramiento de la calidad y a la responsabilidad de resolver los casos escalados.
La Figura 14.2 muestra hacia dónde se desplaza el valor: de la ejecución repetitiva hacia el diseño, la fiabilidad, los datos y la responsabilidad sobre la NAP. La mayoría de quienes trabajan en ingeniería no seguirán una única flecha. Seguirán la que coincida con lo que ya despierta su curiosidad.
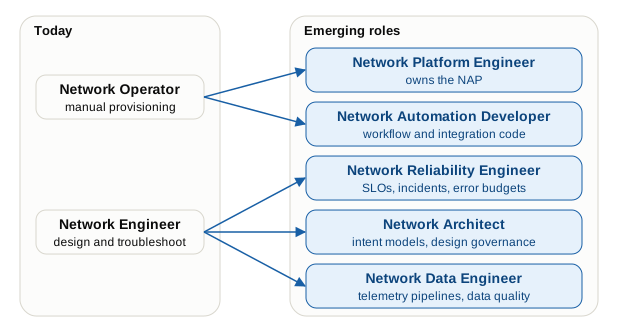
Saber adónde se puede llegar es la parte fácil. La siguiente cuestión es cómo ayudar a las personas a llegar hasta allí.
El camino de la transformación#
Durante esta transformación, las organizaciones suelen caer en dos errores. El primero es esperar que toda persona que se dedica a la ingeniería de redes pase a desarrollar software. El segundo es pensar que quienes se dedican a la ingeniería de software pueden responsabilizarse de la automatización de redes sin conocimientos básicos de redes. Ambos planteamientos fallan por el mismo motivo: dan por hecho que para trasladar las competencias de un ámbito a otro basta con proponérselo, cuando hace falta práctica.
El perfil de ingeniería en T#
El concepto de perfil de ingeniería en T, popularizado por Tim Brown en IDEO y adoptado ampliamente por organizaciones de ingeniería de plataformas y DevOps, da nombre al modelo de trabajo que funciona. En el eje vertical, un conocimiento profundo de un ámbito. En el horizontal, conocimientos generales que abarcan buena parte del otro. Sin simetría. Sin una segunda especialización completa. Una asimetría productiva. La Figura 14.3 muestra los dos perfiles, uno como reflejo del otro.
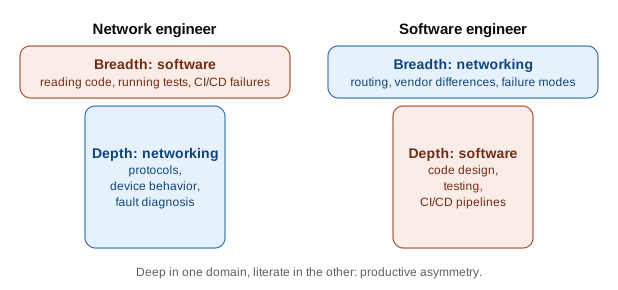
Quien pasa de la ingeniería de redes a la ingeniería de plataformas de red necesita conocimientos de software suficientes para leer, depurar y modificar tanto código (por ejemplo, en Python) como datos en distintos formatos (por ejemplo, YAML). También necesita comprender los flujos de trabajo con Sistema de control de versiones (VCS), analizar los fallos de las cadenas de CI/CD y colaborar en el diseño de esquemas. No necesita diseñar estructuras de datos desde cero ni optimizar la complejidad de los algoritmos. Lo que necesita es soltura para aplicar las prácticas de desarrollo de software, más que una segunda carrera profesional en ingeniería de software.
Quien pasa de la ingeniería de software a la automatización de redes necesita conocer las redes con suficiente profundidad para entender por qué BGP tarda lo que tarda en converger y cómo se propagan los cambios de topología del árbol de expansión. Necesita saber qué significa «consistencia eventual» en una tabla de enrutamiento distribuida y por qué una automatización que funciona en el laboratorio puede fallar en producción debido a las diferencias entre fabricantes. No necesita una certificación CCIE ni experiencia equivalente. Necesita una base suficiente para hablar con conocimiento de causa con especialistas en redes y reconocer cuándo sus supuestos son erróneos.
En última instancia, el perfil en T permite crear interfaces bien definidas entre ámbitos: cada persona entiende lo suficiente del lenguaje de la otra para comunicarse con claridad, depurar problemas en común y tomar decisiones conjuntas sin necesitar a alguien que traduzca cada conversación.
El perfil en T no es un objetivo fijo. Evoluciona con la función que se desempeña. Lo importante es identificar, para cada persona, el eje de profundidad y el de amplitud, y diseñar itinerarios de aprendizaje que respeten ambos.
Cuando Jordi envió su primera solicitud de incorporación de cambios de automatización, quien la revisó, del equipo de ingeniería de software, dejó once comentarios: nombres de variables, errores sin gestionar, una prueba que solo cubría el caso en que todo salía bien. Su primera reacción fue ponerse a la defensiva. Llevaba quince años configurando redes correctamente. La segunda fue cerrar la pestaña del navegador. La tercera fue volver a leer los comentarios, despacio, como si fueran errores de interfaz de un dispositivo con el que nunca había trabajado. Para la tercera solicitud de incorporación de cambios, Jordi ya dejaba preguntas en los comentarios en vez de explicaciones. La persona que revisaba su código pasó a colaborar con él. Pasar de dominar un ámbito a ser principiante en otro y adquirir de nuevo un dominio experto no resulta cómodo. Pero así es la transición.
Los comentarios aportan información, sea cual sea la forma en que se expresen. Quien lee los comentarios de una revisión como datos sobre el código, en vez de tomarlos como juicios sobre su competencia, aprende más deprisa.
El perfil en T plantea una pregunta evidente sobre su eje vertical: ¿con qué profundidad sigue siendo necesario conocer las redes?
El debate sobre los fundamentos#
La pregunta surge en todos los equipos que están adoptando la automatización: ¿sigue siendo importante conocer los protocolos a fondo? ¿Sigue mereciendo la pena obtener la certificación CCIE u otra equivalente? Sí, pero de otra manera.
Los fundamentos de redes no pierden importancia en un mundo automatizado. Se aplican de otra manera. Quien no entiende cómo converge BGP no puede diseñar una automatización fiable de BGP en bucle cerrado. Quien no entiende cómo funciona el árbol de expansión no puede construir un entorno de simulación que reproduzca fielmente los modos de fallo de la topología de producción. La capa de automatización se apoya en la red. Que funcione correctamente depende de la fidelidad con que su modelo represente el comportamiento de la red, y esa fidelidad depende de lo bien que conozcan los protocolos subyacentes quienes construyen el modelo.
Lo que cambia es el itinerario de aprendizaje. El itinerario tradicional de certificación (estudiar la teoría, aprobar el examen y aplicar lo aprendido en producción) es válido, pero hay alternativas. Partir del problema ha demostrado ser al menos igual de eficaz: empieza con un problema operativo real, desarrolla la automatización que lo resuelva y aprende el comportamiento concreto del protocolo o el principio de diseño que exige el problema. Las certificaciones acreditan conocimientos que ya se tienen, pero aportan más valor cuando se obtienen después de adquirir algo de práctica que cuando se obtienen antes.
Una certificación de redes sigue siendo un buen indicio de que se conoce la materia a fondo. En un mundo automatizado, indica precisamente el tipo de conocimiento profundo del que depende la automatización. Lo que ya no indica por sí sola es que se esté al día en la operación de redes: saber configurar dispositivos a mano sigue siendo necesario, pero ya no basta.
Junto a los itinerarios tradicionales de redes han surgido certificaciones específicas de automatización que acreditan las competencias del eje horizontal del perfil en T: buenas prácticas de control de versiones, diseño de interfaz de programación de aplicaciones (API) y fundamentos de las cadenas de CI/CD. Complementan el conocimiento profundo de los protocolos, pero no lo sustituyen.
La profundidad de los conocimientos sigue importando. Lo que ha cambiado es la rapidez con la que se puede desarrollar el eje horizontal, porque los asistentes de inteligencia artificial (IA) ya escriben gran parte del código.
El efecto de la IA en las competencias necesarias#
Los asistentes de programación con IA han cambiado considerablemente lo que se necesita para empezar a desarrollar software en el ámbito de la automatización de redes. Quien no sepa escribir de memoria una clase en Python ya puede dar instrucciones a un asistente hasta obtener código que funcione para tareas rutinarias de automatización: analizar la salida de los dispositivos, generar plantillas de configuración o escribir scripts básicos de integración. Así es más fácil empezar. Hacerlo bien sigue siendo igual de exigente.
La ayuda de la IA no sustituye al criterio profesional: saber cuándo no conviene ejecutar una automatización y diagnosticar un fallo que se manifiesta de forma inesperada. Tampoco sustituye al razonamiento arquitectónico que permite encajar un flujo de trabajo concreto en el diseño general de la NAP descrito en los Capítulos 4 a 13. Un asistente de IA generará código que supere las pruebas que se te haya ocurrido escribir. No te dirá qué pruebas se te han olvidado.
Trata el código de automatización generado por IA como tratarías el de una persona competente que aún tiene poca experiencia en ingeniería. Revísalo. Pruébalo. Entiéndelo lo suficiente para poder depurarlo. Hazte responsable de él. En cuanto la automatización llega a producción, respondes de ella, hayas tecleado tú cada línea o no.
Las herramientas de IA evolucionan más deprisa de lo que cualquier libro puede reflejar. Puede que algunas de las funciones descritas aquí hayan quedado desfasadas cuando leas esto. Los principios de fondo siguen siendo válidos sean cuales sean las herramientas disponibles en cada momento: el código generado por IA exige la misma revisión que cualquier otra contribución y que alguien se responsabilice de él en la misma medida, y la asistencia de la IA no sustituye el criterio de ingeniería.
¿Cuánto necesitas saber realmente de programación? Lo suficiente para leer y entender código ajeno, diagnosticar y corregir fallos habituales, adaptar la automatización existente a nuevos requisitos y tomar decisiones fundamentadas al revisar código. El objetivo es que sepas desenvolverte con el código en el trabajo operativo, sin que necesites el nivel de quien se dedica profesionalmente al desarrollo. El listón está por encima de «sé usar una herramienta de CLI». Está por debajo de «sé diseñar un sistema distribuido desde cero».
Itinerarios de desarrollo de competencias#
El perfil en T indica a qué aspirar. Un itinerario de desarrollo indica qué aprender primero y en qué orden. Ambos dependen del punto de partida de cada profesional, al igual que el primer hito que demuestra que la transición está dando resultado.
En los equipos que están haciendo la transición se observan dos itinerarios de desarrollo concretos.
Para quienes pasan de la ingeniería de redes a funciones de plataforma y automatización, un orden práctico de aprendizaje empieza por los fundamentos de Python: primero leer y depurar, luego escribir. A continuación vienen los flujos de trabajo y las buenas prácticas de control de versiones con un VCS, el conocimiento de las cadenas de CI/CD necesario para diagnosticar sus fallos y el diseño de esquemas YAML y JavaScript Object Notation (JSON). Conviene centrarse en leer y depurar código existente antes de generar código nuevo. El primer hito significativo es poder decir «he depurado un fallo en una automatización ajena y he entendido por qué se produjo», algo que demuestra mucho más que «he escrito un script».
Para quienes pasan de la ingeniería de software a la automatización de redes, un orden práctico de aprendizaje empieza por los fundamentos de Internet Protocol (IP) y por estudiar un protocolo de enrutamiento con suficiente profundidad para razonar sobre sus modos de fallo. Después viene el modelo de confianza operativa que explica la cautela de quienes trabajan en ingeniería de redes: basta un comando equivocado para dejar fuera de servicio una red de producción de formas que rara vez están al alcance de un fallo en una aplicación web. El último paso es acompañar al personal de ingeniería de redes durante los incidentes en producción y observar cómo trabaja. El primer hito significativo es «sé qué teme quien está a cargo de una red y por qué», algo que importa más que la teoría de redes.
A los seis meses de iniciar su transición, Jordi alcanzó el primer hito del itinerario de ingeniería de redes al encontrarse con una traza de excepción de Python de cuarenta líneas en un flujo de trabajo en producción que había escrito otra persona. Su primer impulso fue reenviársela a la persona del equipo que se ocupaba de la ingeniería de software. En vez de hacerlo, empezó a leerla desde el principio, línea por línea, como solía leer una tabla de enrutamiento. En la línea 23 estaba el supuesto sobre la red que había provocado el fallo: el código daba por hecho que la sesión BGP se encontraría en un estado concreto. Para cualquiera que hubiera configurado BGP a mano, aquel supuesto tenía todo el sentido y a nadie se le había ocurrido que hiciera falta una prueba para comprobarlo. Lo corrigió él mismo. La traza había dejado de ser ruido. Se había convertido en un mapa.
Ambos itinerarios desembocan en el mismo terreno común, que muestra la Figura 14.4: el trabajo que ninguna de las dos disciplinas puede hacer por sí sola.
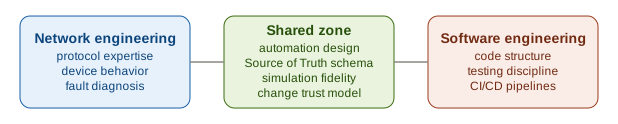
Los itinerarios de aprendizaje solo funcionan cuando la organización les hace sitio. La mejor manera de aprovechar el tiempo de aprendizaje es participar en el trabajo de la otra disciplina.
Las rotaciones planificadas entre equipos aceleran el proceso: sitúan a ambos grupos en circunstancias en las que deben aprender trabajando codo con codo con el otro equipo. Una persona del equipo de ingeniería de redes se integra dos semanas en el equipo de software y otra del equipo de software pasa dos semanas de guardia con el de ingeniería de redes. Más que cualquier formación reglada en la otra disciplina, lo que importa es el vocabulario compartido y el respeto mutuo que permiten que la colaboración perdure.
A los dos años de iniciar su transición, Jordi se integró durante tres meses en el equipo de infraestructura en la nube. La rotación estaba planificada y su responsable se la había propuesto como un experimento de desarrollo profesional. Jordi aceptó con escepticismo. El equipo de infraestructura en la nube no pensaba en dispositivos ni en protocolos. Pensaba en lo que las aplicaciones daban por hecho que la red les proporcionaría. Esos supuestos nunca se ponían por escrito y a menudo eran erróneos.
La automatización que Jordi desarrolló a su regreso fue la primera versión creada por el equipo que modelaba la intención de red desde la capa de aplicación hacia abajo, en vez de partir de la capa de dispositivos hacia arriba. También fue la automatización más fiable que habían puesto en producción hasta entonces. Ni Jordi ni su responsable lo habían previsto. La rotación no había formado a Jordi en ingeniería de infraestructura en la nube. Le había dado una nueva perspectiva sobre algo que ya conocía a fondo, y ese cambio de perspectiva es, en la práctica, lo que significa pensar en términos de arquitectura.
Tres meses después de regresar, Jordi organizó una sesión informal para su equipo en la que contó lo que había observado sobre cómo los equipos de aplicaciones modelaban sus supuestos acerca de la red. Asistieron seis personas del equipo de ingeniería. Dos de ellas cambiaron el diseño de sus siguientes flujos de trabajo de automatización a partir de lo que contó Jordi. La rotación no solo había transformado a Jordi: a través de él, también había cambiado la forma en que otras personas del equipo de ingeniería entendían el problema. Cuando alguien comparte de manera deliberada lo que ha aprendido, el aprendizaje se multiplica.
Nada de aquello ocurrió por casualidad. Su responsable planificó la rotación y se aseguró de que Jordi pudiera dedicarle ese tiempo.
Para responsables de ingeniería y de equipo: la documentación y las buenas intenciones no bastan para que se produzca la transformación de competencias descrita en esta sección. Hay que reservar tiempo para aprender, porque el aprendizaje no puede depender solo de los ratos libres que deje una jornada repleta de tareas operativas. Hace falta seguridad psicológica: el personal de ingeniería necesita poder equivocarse en entornos donde un error tenga pocas consecuencias, y para eso necesita acceso a un laboratorio y tiempo reservado para experimentar. También hace falta que la dirección respalde la transformación de forma visible y deje claro que el nuevo modelo valora el conocimiento profundo de las redes.
Los equipos que fracasan en esta transformación casi nunca son los que carecen de herramientas o de planes. Son aquellos en los que el personal de ingeniería siente que se espera que aprenda nuevas competencias después de terminar su «trabajo de verdad».
Esas mismas tres condiciones determinan si un equipo adopta la automatización que desarrolla, cuestión que se aborda en la sección Cómo fomentar la adopción.
Herramientas para la práctica#
Las herramientas que siguen están ordenadas por prioridad para quien inicia la transición desde la ingeniería de redes. En cada etapa, el objetivo es adquirir la soltura suficiente para aportar al equipo y reconocer cuándo algo va mal. El dominio de la herramienta puede llegar después. La Figura 14.5 muestra la secuencia en forma de pirámide: cada capa se apoya en la que tiene debajo.
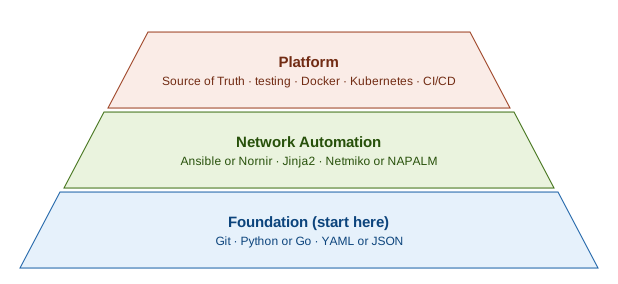
Capa básica (empieza por aquí):
- Git: el punto de partida imprescindible. Aprende a hacer commits, crear ramas, abrir solicitudes de incorporación de cambios y resolver conflictos de fusión. Todo lo demás en la NAP depende de las buenas prácticas de control de versiones. Aprende a usar Git antes que cualquier herramienta de automatización.
- Python o Go: céntrate en leer y depurar código existente antes de escribir código nuevo. El primer hito es leer una traza de excepción y entender qué te indica, no escribir una clase desde cero.
- YAML o JSON: son los lenguajes de configuración de la mayoría de las herramientas de automatización de redes. Para trabajar con Ansible, NetBox y la mayoría de las cadenas de CI/CD, necesitas entender la estructura, la sangría y los tipos de datos.
Python es hoy el lenguaje predominante en la automatización de redes, pero no es la única opción válida. Go se usa cada vez más para desarrollar herramientas en las que el rendimiento es crítico y componentes de la NAP, y los conceptos que se aprenden al escribir scripts son aplicables a otros lenguajes. El esfuerzo que dedicas a aprender los fundamentos de Python te da una base de programación que más adelante puedes ampliar a otros lenguajes. Los modelos mentales siguen siendo válidos con independencia del lenguaje que utilice cada herramienta.
Capa de automatización de redes:
- Ansible: es la herramienta de ejecución más implantada en entornos de red. Aprende a trabajar con playbooks, inventarios y roles, y a entender la precedencia de las variables. Cubre la mayoría de los casos de uso de automatización del aprovisionamiento y de la configuración.
- Jinja2: es el motor de plantillas que se utiliza con Ansible y en la mayoría de los flujos de trabajo de generación de configuraciones. Entender cómo se genera la configuración a partir de plantillas y datos variables es esencial para gestionar la configuración a escala.
- Netmiko o NAPALM: Netmiko automatiza la interacción con la CLI por SSH en dispositivos heredados. NAPALM ofrece una capa de abstracción para dispositivos de distintos fabricantes: se usan las mismas llamadas para leer el estado y sustituir la configuración, tanto si el dispositivo dispone de una API como si solo admite SSH. En la mayoría de las bases de código de automatización de redes existentes encontrarás una de estas herramientas o ambas.
- Nornir: es un marco de automatización nativo de Python que gestiona las conexiones, la ejecución de tareas y el paralelismo en grandes inventarios de dispositivos. Mientras que Ansible oculta Python tras una abstracción, Nornir permite trabajar directamente con el lenguaje, por lo que se adapta mejor a flujos de trabajo complejos que requieren un control total desde el código.
Esta lista recomienda qué herramientas aprender, no cuáles utilizar. Muchas tienen limitaciones que se hacen visibles al trabajar a escala, y una NAP bien diseñada las encapsula tras interfaces más claras. Entender cómo funcionan, incluidos sus modos de fallo y sus casos límite, te permite decidir con criterio cuándo utilizarlas, cuándo sustituirlas y a qué prestar atención cuando se comportan de forma inesperada en producción.
Capa de plataforma:
- Fuente de Verdad: aprende a fondo una implementación de la Fuente de Verdad. Entender el diseño de esquemas, la interacción con la API y cómo la automatización lee datos de la SoT y vuelve a escribir en ella te permite relacionar las herramientas de ejecución con el modelo arquitectónico del Capítulo 4 y del Capítulo 5.
- Pruebas: aprende a escribir pruebas para el código de automatización. El primer paso que aporta valor no es escribir pruebas nuevas, sino entender qué cubren las existentes y qué dejan sin comprobar.
- Fundamentos de Docker: aprende lo suficiente para ejecutar un entorno de desarrollo local, entender qué es una imagen de contenedor y leer un archivo de Compose. No necesitas aprender a orquestar contenedores, solo lo necesario para que la preparación del entorno deje de frenarte.
- Fundamentos de Kubernetes: cada vez es más habitual que los componentes de la NAP (el Orquestador, la pasarela de API y la pila de observabilidad) se ejecuten en Kubernetes como cargas de trabajo en contenedores. No necesitas administrar un clúster, pero al depurar problemas de la NAP tendrás que recurrir a menudo a habilidades como leer un manifiesto de despliegue, entender los reinicios de los pods y consultar los registros de un contenedor en ejecución.
- Cadena de CI/CD: saber leer y entender las definiciones de las cadenas de CI/CD, diagnosticar fallos e identificar en qué punto de la cadena se ha producido cada fallo. Aprender a escribir cadenas desde cero viene después.
El orden importa más que las herramientas concretas. Quien domina Git y sabe depurar código Python aporta más a un equipo de automatización de redes que quien ha instalado todas las herramientas pero no conoce ninguna a fondo. Ese conocimiento se adquiere al usarlas, no al instalarlas.
Con los asistentes de programación basados en IA sigue siendo imprescindible dominar estas herramientas. Quien no sabe leer el código que ha generado con sus instrucciones tampoco puede depurarlo, revisarlo ni explicar a una parte interesada por qué la automatización ha actuado como lo ha hecho. Los fundamentos anteriores permiten usar la asistencia de la IA con seguridad.
Las competencias técnicas son la mitad de la transformación. La otra mitad consiste en conseguir que el equipo confíe en lo que construye y lo utilice.
Cómo fomentar la adopción#
Conseguir que un equipo empiece a usar la automatización plantea un problema distinto al de lograr que la desarrolle y la mantenga como una capacidad de la organización. Ambos requieren atención y cada uno exige algo distinto. Esta sección aborda el primero: cómo conseguir que un equipo dé los primeros pasos y supere los obstáculos previsibles que frenan a la mayoría de los programas de automatización antes de que alcancen la escala necesaria para sostenerse por sí mismos.
La adopción sigue una escalera de tres peldaños: probar, ampliar y sostener. Cada peldaño tiene su propio criterio de éxito, como muestra la Figura 14.6.
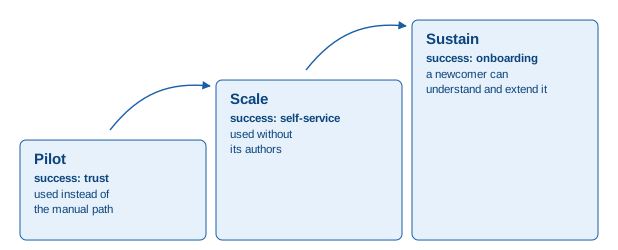
Probar consiste en demostrar, mediante un piloto, que la automatización funciona al menos en un caso de uso con fiabilidad suficiente para que el equipo confíe en ella. El criterio de éxito es la confianza, no la cobertura ni el volumen de código. ¿Usa el equipo de verdad esta automatización en lugar del proceso manual? Si la respuesta es «casi siempre, pero para los cambios importantes seguimos haciéndolo a mano», el piloto no ha tenido éxito.
Ampliar consiste en extender la automatización a más casos de uso y a más profesionales de ingeniería. El criterio de éxito es el autoservicio: ¿puede usar la automatización el personal de ingeniería que no la desarrolló sin tener que consultar a quienes la crearon? Si solo pueden operar la NAP quienes la construyeron, no se ha conseguido ampliar su uso. La dependencia de la intervención manual simplemente ha pasado de la CLI del dispositivo a la herramienta de automatización.
Sostener consiste en que la automatización perdure cuando ya no estén quienes la crearon. El criterio de éxito es la incorporación: ¿puede alguien que acaba de incorporarse al equipo de ingeniería entender, modificar y ampliar la automatización existente sin que el equipo original tenga que explicársela? Si la respuesta es no, se sigue dependiendo de personas clave, aunque se disponga de mejores herramientas.
Cuenta con que el equipo irá más despacio antes de ganar velocidad. La Figura 14.7 muestra cómo evoluciona su ritmo de trabajo. Las curvas son ilustrativas.
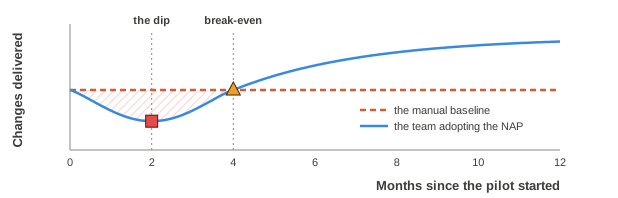
Durante el piloto, el equipo desarrolla la automatización y sigue haciendo cada cambio a mano, por lo que saca adelante menos trabajo que antes. Es durante ese descenso cuando se cancela la mayoría de los programas: si quien dirige el equipo mide su rendimiento en el segundo mes, verá que el equipo ha perdido velocidad. Explícalo antes de empezar el piloto, acordad en qué mes esperáis recuperar el nivel anterior y tomad esa fecha como referencia para medir el progreso.
Patrones de resistencia al cambio#
En cada peldaño surge resistencia, y esa resistencia es previsible. Hay tres tipos que se repiten con frecuencia suficiente para anticiparlos, cada uno con una respuesta que funciona:
La persona más experta se resiste. Quien ocupa el puesto de mayor rango en el equipo de ingeniería gracias a su profundo conocimiento del trabajo manual se convierte en la voz más crítica con la automatización. Es una reacción racional. El cambio amenaza su posición, su trayectoria y su identidad profesional más que las de cualquier colega con menos experiencia. Lo que funciona es poner el desarrollo de la automatización en sus manos. Quien diseña el primer flujo de trabajo de automatización desde esa posición tiene interés en que funcione. Si recibe una NAP ya terminada y la orden de usarla, tendrá motivos para buscarle fallos.
El éxito es invisible. La automatización que funciona no genera tickets ni actividad visible. Solo se ven los fallos. Un equipo que haya automatizado con éxito el aprovisionamiento de VLAN puede pasar meses sin ver indicios del valor que aporta la automatización, porque el indicio serían cientos de tickets que nunca llegaron a abrirse. Para contrarrestarlo hay que incorporar mecanismos de medición con ese fin: registrar el tiempo de aprovisionamiento antes y después, contar los incidentes evitados, medir la mejora del Tiempo medio de recuperación (MTTR) y mostrar esas cifras a las partes interesadas, que de otro modo solo ven la automatización cuando falla. La sección Métricas de adopción enumera las cifras que conviene seguir.
Solo confían en ella quienes la crearon. Quienes desarrollaron la automatización la usan. El resto del equipo tiene acceso, pero no la usa porque no se fía de lo que no entiende. La automatización produce resultados correctos, pero no permite ver qué hace ni por qué. El resto del equipo prescinde de ella porque el proceso manual, por lento que sea, al menos se entiende. La respuesta consiste en incorporar la transparencia a la propia automatización: registros de auditoría, trazas de ejecución paso a paso, mensajes de error claros y modos de simulación que muestran qué ocurriría antes de que se ejecute nada. La comprensión da paso a la confianza. Si un sistema de automatización no puede explicar sus propias acciones, solo lo adoptarán quienes lo crearon.
La sección Cómo generar confianza del Capítulo 2 estableció las bases de la confianza en la automatización: lo que hace que un sistema inspire confianza suficiente para usarlo son cuatro cualidades, que sea predecible, fiable, fácil de usar y comprensible (no las funcionalidades adicionales).
Una respuesta solo sirve si puedes comprobar si ha funcionado. Para eso necesitas cifras.
Métricas de adopción#
La adopción no se puede medir contando scripts o líneas de código. Las siguientes métricas permiten comprobar si los equipos están adoptando de verdad la automatización:
- Porcentaje de autoservicio: porcentaje de cambios ejecutados sin la intervención directa del equipo de automatización de redes. Un porcentaje de autoservicio alto significa que los equipos de aplicaciones, los de seguridad y los demás usuarios de la NAP pueden utilizarla de forma autónoma.
- Tasa de acceso manual: con qué frecuencia el personal de ingeniería prescinde de la automatización para acceder directamente a los dispositivos y por qué lo hace. Algunos accesos manuales están justificados (la automatización aún no cubre ese caso). Otros apuntan a una falta de confianza. Registrar los motivos importa tanto como contar los accesos.
- Tiempo de puesta en producción de nuevas automatizaciones: cuánto tiempo transcurre entre «esto habría que automatizarlo» y «esto ya está funcionando en producción». Los ciclos largos indican que hay obstáculos en el proceso que restan al equipo incentivos para automatizar más tareas.
- Tiempo de incorporación: cuánto tarda alguien que se incorpora al equipo en hacer su primera aportación significativa a la automatización. Mide a la vez la calidad de la documentación, la claridad del código y las dificultades para configurar el entorno.
El equipo de Jordi siguió las cuatro métricas durante su primer año con la NAP. Al principio, el 12 % de los cambios se hacía en autoservicio, el personal de ingeniería prescindía de la NAP unas 30 veces al mes, un flujo de trabajo nuevo tardaba tres meses en pasar de la solicitud a producción y alguien recién incorporado necesitaba seis semanas para poner en producción su primera aportación.
Doce meses después, el 64 % de los cambios se hacía en autoservicio, los accesos manuales habían bajado a 6 al mes (casi todos para tipos de dispositivos que la NAP aún no cubría), un flujo de trabajo nuevo tardaba tres semanas y quien se incorporaba ponía en producción su primera aportación en dos semanas como máximo. Ninguna de estas cifras cuenta scripts ni líneas de código. Cada una indica si la gente confía lo suficiente en la NAP como para usarla.
Para obtener la mayoría de estas cifras no hacen falta encuestas: la NAP ya las registra. En cada solicitud constan la identidad de quien la presenta y el registro de ejecución (Capítulo 13), y la cobertura del Camino recomendado (Golden Path) y el tiempo hasta recibir respuesta, descritos en el Capítulo 11, miden esa misma adopción desde la perspectiva de la NAP. Un acceso manual se manifiesta como una desviación de la configuración sin una solicitud que la justifique. Estas métricas complementan las cuatro métricas de entrega que Accelerate convirtió en referencia: frecuencia de despliegue, plazo de entrega, tasa de fallos de los cambios y tiempo de restablecimiento del servicio. El tiempo de puesta en producción es el plazo de entrega de una nueva automatización, y el porcentaje de autoservicio indica si esa rapidez beneficia a quienes la pidieron.
Cómo sostener la automatización#
Llegar al tercer peldaño de la escalera de adopción, el de sostener la automatización, no resuelve por completo el problema. Incluso cuando la automatización llega a producción y se gana la confianza del equipo, necesita el apoyo activo de la organización para seguir funcionando bien a medida que el equipo crece, el código envejece y quienes la desarrollaron pasan a otras funciones. Las prácticas de esta sección abordan un reto distinto al de la adopción: no cómo empezar, sino cómo perdurar. Los temas, por orden, son lo que los equipos de redes heredan de DevOps y Agile, la documentación y la recopilación del conocimiento, la gestión de cambios y las cuestiones éticas que plantea la autonomía.
El legado de DevOps y Agile#
Los patrones que se describen en este capítulo no surgieron en la ingeniería de redes. Tomaron forma a lo largo de la década anterior en organizaciones de ingeniería de software, primero en las operaciones web (el movimiento DevOps) y después en el desarrollo de productos (las metodologías ágiles).
DevOps abordó la tensión estructural entre los equipos de desarrollo, que querían entregar software con rapidez, y los equipos de operaciones, que necesitaban preservar la estabilidad. El resultado fue la integración de las prácticas de desarrollo y operaciones, de modo que la fiabilidad de los despliegues pasó a ser una responsabilidad compartida. En la automatización de redes existe la misma tensión entre quienes desarrollan la automatización y quieren entregar nuevos flujos de trabajo y quienes se ocupan de las operaciones de red y necesitan estabilidad en producción. El legado de DevOps se aplica directamente: responsabilidad compartida sobre la automatización, pruebas automatizadas antes del paso a producción y análisis posteriores a los incidentes que permiten mejorar el sistema sin buscar culpables.
La misma tensión se da en otros ámbitos, además del desarrollo y las operaciones. El cambio cultural descrito en este capítulo no es exclusivo de un equipo. La automatización de redes que aporta un valor significativo a la organización siempre afecta a otros ámbitos: la aplicación de políticas de seguridad, la gestión de la infraestructura en la nube y los flujos de trabajo de prestación de servicios. Muchas iniciativas de automatización de redes tropiezan precisamente con los roces entre las partes de la organización responsables de esos ámbitos.
El problema es estructural. Por lo general, NetOps, SecOps y CloudOps han desarrollado por separado sus propias capacidades de automatización, con distintos esquemas para sus Fuentes de Verdad, distintas rutinas de gestión de cambios y distintas cadenas de herramientas que se solapan, pero no se integran entre sí. Aunque cada sistema funcione correctamente en su propio ámbito, desconoce los cambios que han hecho los demás. La interrupción del servicio que abre la sección Colaboración entre ámbitos es el desenlace habitual cuando nadie diseña expresamente la automatización entre ámbitos.
Las metodologías ágiles abordaron un problema distinto: cómo aportar valor de forma incremental en sistemas complejos sin tener que especificarlo todo de antemano. En automatización, el equivalente es la escalera de adopción descrita antes: poner en marcha un piloto que funcione antes de intentar abarcarlo todo, ampliar la cobertura en sucesivas iteraciones y asegurarse de que cada incremento funcione antes de empezar el siguiente. Parece obvio, pero choca con la forma tradicional de definir el alcance de los proyectos de red: completar el diseño antes de cualquier despliegue y alcanzar una cobertura total antes de cualquier uso en producción.
Aprender de la cultura de la ingeniería de software consiste en aplicar las soluciones que desarrolló a lo largo de una década de retos organizativos similares, en vez de adoptar su vocabulario. El error que conviene evitar es la adopción puramente terminológica: hay equipos que rebautizan su proceso de cambios como «CI/CD», llaman «sprints» a su planificación trimestral y se declaran organizaciones DevOps mientras conservan todos los hábitos que esos movimientos pretendían erradicar. La señal es un equipo con flujos de trabajo de cambio automatizados que todavía tiene que esperar cuatro semanas a que el comité asesor de cambios (CAB) apruebe cada cambio que quiere ejecutar. El vocabulario ha cambiado. La cultura sigue igual.
El hábito de DevOps que más importa para que la automatización perdure es el menos vistoso: dejar por escrito el porqué.
Cultura de aprendizaje y documentación#
La automatización que no se documenta muere con quien la creó. El patrón se repite cada vez que la persona que creó un flujo de trabajo de automatización crítico deja el equipo.
En automatización, la dificultad de documentar es más un problema de arquitectura que de redacción. La documentación que se escribe a posteriori, por separado de la propia automatización, casi siempre está incompleta y tiene muchas probabilidades de quedarse obsoleta. La documentación integrada en la automatización perdura: esquemas que se describen a sí mismos, resultados de simulaciones que explican lo que ocurre y código lo bastante claro como para que su lectura resuelva la mayoría de las dudas. También incluye los registros de decisiones de arquitectura (ADR), que recogen las decisiones menos evidentes: por qué se eligió ese diseño frente a las alternativas y qué restricciones le dieron forma.
Un ADR es un documento breve, normalmente un archivo Markdown que se guarda en el repositorio del VCS junto al código de automatización y que recoge una única decisión importante. Expone el contexto que hizo necesaria la decisión, las opciones consideradas, la opción elegida y las consecuencias que se derivan de ella. Michael Nygard popularizó el formato, hoy muy extendido en la ingeniería de software. La comunidad de ADR mantiene herramientas y plantillas en adr.github.io.
La mayoría de las plataformas que alojan repositorios muestran Markdown con formato de forma nativa. Así, un ADR guardado en el mismo repositorio que la automatización está siempre a un clic del código que explica, comparte con él el control de versiones y aparece en el historial de solicitudes de incorporación de cambios. Si alguien pregunta «¿por qué está estructurado así?» tres años después de que se marchara quien lo escribió, la respuesta está en el ADR. Sin él, la respuesta es «nadie lo sabe» o una reconstrucción a partir de
git blameque rara vez está completa.
La práctica de equipo que lo hace posible consiste en evaluar la documentación como criterio de calidad al revisar la automatización, en lugar de tratarla como una tarea pendiente antes de cerrar el tique. Un flujo de trabajo de automatización sin un modo de simulación claro, sin resultados de auditoría legibles y sin documentación sobre cómo se comporta en caso de fallo está incompleto: esas capacidades son parte de lo que hace que la automatización sea fiable.
Un año después de iniciar su transición, Jordi empezó a trabajar en pareja con una ingeniera júnior sin experiencia en redes. Ella le preguntó por qué la automatización comprobaba si había una sesión BGP activa antes de eliminar un vecino, en vez de limitarse a ejecutar el comando de eliminación. Jordi había escrito esa comprobación en diez minutos y nunca la había documentado. Le explicó el motivo. Eliminar un vecino que todavía anuncia rutas crea un agujero negro de tráfico hasta que converge el protocolo de enrutamiento, lo que en una red de campus suele tardar treinta segundos o más. Una interrupción así es inaceptable en un flujo de trabajo de aprovisionamiento.
Mientras se lo explicaba, se dio cuenta de que la comprobación tenía una segunda implicación que no había plasmado en el código. Dejó ambas por escrito. Tres semanas después, la ingeniera júnior detectó un error de lógica en la segunda. Al enseñárselo, Jordi había mejorado la automatización más allá de lo que había conseguido con su razonamiento inicial. No se lo esperaba. A partir de entonces, le ocurrió cada vez que volvió a hacerlo.
La documentación recoge las decisiones una a una. Con los años, las lagunas se acumulan.
Captura del conocimiento y código abierto#
El problema de la memoria institucional se agrava con el tiempo. En una organización que lleva tres años automatizando y tiene una rotación de personal considerable, se acumulan muchas decisiones sin documentar, plasmadas en código que nadie del equipo actual comprende por completo.
Las prácticas que reducen este riesgo forman parte del proceso de trabajo. Revisiones de código con transferencia obligatoria de conocimiento: quien revisa el código y no entiende por qué se escribió así carece de criterio para aprobarlo. Trabajo en pareja en tareas de automatización, con la transferencia de conocimiento como objetivo principal junto con la entrega. Registros de decisiones de arquitectura para las decisiones de diseño menos evidentes, que se mantienen como documentos vivos y recogen los motivos por los que la NAP tiene su forma actual.
Cada una de estas prácticas también facilita el relevo de la persona que más sabe, y ese es uno de sus objetivos. El Capítulo 8 lo cuenta desde la perspectiva de quien ocupa ese puesto: ser la única persona que conoce la secuencia parece una garantía de estabilidad laboral hasta que se convierte en el motivo por el que nadie puede asignarte un trabajo más interesante. Plasmar ese conocimiento en el flujo de trabajo y en los registros de decisiones es lo que permite a quien lo aporta seguir creciendo.
El ritmo del desarrollo asistido por IA introduce una variante específica de este problema. Cuando el equipo de ingeniería usa herramientas de IA para generar con rapidez código de automatización, el código puede funcionar lo bastante bien para producción sin que nadie lo comprenda a fondo. Nadie en el equipo sabe del todo por qué se ha estructurado así, qué casos límite se tuvieron en cuenta o qué supuestos incorpora.
El código funciona hasta que deja de hacerlo y, cuando falla, hay que empezar a depurarlo desde cero. Para mitigar el riesgo, hay que tratar ese código como el de una persona júnior del equipo, tal como describe la sección Efecto de la IA en las competencias necesarias. El código generado por IA requiere la misma revisión y el mismo traspaso de responsabilidad que el de cualquier otra persona que contribuya, además de documentación sobre lo que el proceso de generación dejó implícito.
Las herramientas de código abierto para la automatización de redes te ayudan a empezar porque reducen los conocimientos previos necesarios: muchas organizaciones comparten vocabulario y patrones. Un equipo que trabaja con herramientas de código abierto hereda la experiencia del conjunto de la comunidad en depuración, diseño y operación. Muchas veces, cuando el equipo se encuentra con un problema, la comunidad ya lo ha documentado. Contribuir a su vez, aunque sea con pequeñas correcciones o mejoras en la documentación, refuerza la capacidad del equipo para aprovechar esa base de conocimiento (y aporta la satisfacción personal de ayudar indirectamente a los demás). Así, lo que empezó como una elección técnica se convierte también en una capacidad de la organización.
El conocimiento permite seguir entendiendo la automatización. La gestión de cambios determina hasta dónde puede actuar por sí sola.
Una nueva gestión de cambios#
La automatización no elimina la gestión de cambios. La transforma. La Parte 3 estableció los mecanismos: el Capítulo 11 asigna el cambio estándar de ITIL al nivel de riesgo standard y el Capítulo 13 convierte las aprobaciones en controles que la NAP hace cumplir. Esta sección aborda la vertiente organizativa: cómo se gana un equipo el derecho a confiar en esos mecanismos.
La gestión tradicional de cambios en la red se articulaba en torno a ventanas de cambio programadas, revisiones manuales y cadenas de aprobación explícitas, porque cada cambio era una operación manual a cargo de una persona que podía equivocarse. El proceso servía para ralentizar el paso de la decisión a la ejecución e introducir puntos de control donde alguien pudiera detectar errores.
La automatización cambia el perfil de riesgo. Un cambio automatizado ya se revisó al escribir la automatización (y no en el momento de ejecutarla), se prueba antes de llegar a producción y genera un registro de auditoría de forma automática. Los argumentos para congelar los cambios durante cuatro semanas antes de una operación rutinaria de aprovisionamiento pierden fuerza cuando esa misma operación se ha ejecutado trescientas veces en el último año sin un solo fallo.
El paso a una gestión de cambios apoyada en la automatización se gana poco a poco. El patrón Escalera de Confianza (Confidence Ladder) da nombre a esa progresión: la automatización se gana la autonomía por etapas. Una automatización nueva se ejecuta primero en modo de simulación y muestra de antemano lo que haría sin aplicar cambios. Tras suficientes simulaciones satisfactorias con revisión humana, se gana el paso a la ejecución supervisada: los cambios se aplican con monitorización activa y con alguien del equipo de ingeniería preparado para intervenir. Tras suficientes ejecuciones supervisadas satisfactorias que no hayan requerido intervención, se gana el paso a la ejecución autónoma para esa clase de cambio, con supervisión humana por excepción.
La idea de graduar la autonomía no es nueva. La investigación sobre factores humanos describe niveles de automatización desde el trabajo de Sheridan y Verplank (1978), y Parasuraman, Sheridan y Wickens (2000) los convirtieron en un modelo de referencia para decidir hasta dónde puede actuar una máquina por sí sola. En los términos de la Parte 3, al subir por la escalera, las solicitudes de un flujo de trabajo pasan de requerir las aprobaciones del nivel high a contar con la aprobación previa del nivel standard.
La gestión de cambios apoyada en la automatización se gana. No basta con declararla. Un equipo que anuncia el paso a la ejecución autónoma sin haber completado las etapas de simulación y de ejecución supervisada no ha reducido el riesgo. Lo ha ocultado. La Escalera de Confianza solo funciona si cada etapa se completa con honestidad, basándose en el historial real de ejecución en vez de en una decisión de política interna o en la confianza de un responsable en que la automatización probablemente funcione bien.
Este proceso refleja el criterio de confianza que aplica quien tiene buen juicio técnico al trabajar con una persona júnior: la autonomía se gana demostrando fiabilidad. No se concede de entrada para retirarla tras un fallo.
La Escalera de Confianza es un modelo organizativo. Necesita un equivalente técnico: una NAP que registre las pruebas que hacen del paso de un peldaño al siguiente una decisión documentada en lugar de un acto de fe. Ese equivalente es el historial de ejecución de la automatización. Para cada tipo de flujo de trabajo, la NAP registra de forma continua cómo evoluciona la tasa de éxito, desglosada por tipo de dispositivo, fabricante, sede y clase de cambio. También registra los modos de fallo observados y su frecuencia, el alcance del impacto de cada ejecución anterior y el tiempo de recuperación cuando falla un flujo de trabajo.
La Tabla 14.1 ilustra el formato con un historial concreto: el del flujo de trabajo de alta de VLAN en el campus al cabo de seis meses.
| Métrica | Valor |
|---|---|
| Tipo de flujo de trabajo | vlan-add |
| Ejecuciones en producción | 2140 |
| Tasa de éxito | 99,81 % |
| Fallos | 4 (la comprobación de integridad de la SoT rechazó 3 ejecuciones y la cuarta se revirtió tras llegar a 3 dispositivos) |
| Alcance máximo del impacto observado | 3 dispositivos (un incidente) |
| Tiempo medio de recuperación | 6 minutos |
| Días desde el último fallo | 47 |
Con este historial, el equipo puede pasar de la ejecución supervisada (alguien del equipo de ingeniería supervisa cada ejecución y está preparado para intervenir) a la ejecución autónoma (el flujo de trabajo se ejecuta sin revisar cada ejecución y genera alertas automáticas si la tasa de éxito cae por debajo del umbral). El historial aporta las pruebas que permiten tomar esa decisión a partir de una evaluación del riesgo, sin recurrir a conjeturas. La organización no decide confiar en una automatización. La NAP demuestra que la automatización se ha ganado esa confianza.
Las pruebas determinan hasta dónde llega la autonomía. Queda por resolver quién responde por la automatización cuando falla.
Implicaciones éticas y humanas#
La automatización completa cambia el reparto de responsabilidades de formas que el sector aún no ha terminado de resolver.
Cuando alguien del equipo de ingeniería ejecuta un cambio que provoca una interrupción del servicio, la responsabilidad está clara: una persona tomó una decisión. Cuando un sistema de automatización ejecuta un cambio que provoca una interrupción del servicio, la cadena de responsabilidades es más larga y más difícil de reconstruir. Pasa por quienes escribieron la automatización, la aprobaron y configuraron el mecanismo que la activa, y por la persona responsable de aprobar la política de ejecución autónoma. Los marcos jurídicos y organizativos que regulan estas responsabilidades siguen en desarrollo.
La IA hace aún más acuciante esta cuestión. Piensa en un sistema de orquestación guiado por IA que toma por sí solo una decisión de encaminamiento, como se describe en el Capítulo 18. La cadena entre la intención humana y la acción en la red incluye ahora una capa de razonamiento, y no puedes auditarla del mismo modo que auditas el código determinista. Un sistema de IA puede elegir la acción correcta por razones que el equipo de ingeniería que lo desplegó no había previsto. También puede elegir una acción equivocada por esas mismas razones. Cuando la automatización se equivoca, resulta difícil responder a la pregunta «¿quién es responsable?».
Esto no significa que haya que evitar el funcionamiento autónomo. Significa que hay que definir el alcance de las acciones autónomas, las condiciones que requieren intervención humana y el registro de auditoría que permite revisar lo ocurrido tras un incidente con el mismo rigor con que se diseña la propia lógica de automatización. Hay dos principios aplicables en cualquier nivel de madurez. Las acciones autónomas deben tener límites: la automatización sabe qué no está autorizada a hacer y se detiene. Además, el sistema siempre debe poder explicar qué hizo, por qué lo hizo y qué habría hecho de otra manera.
Lo más difícil es determinar quién responde cuando la automatización pasa del dominio de un equipo al de otro.
Colaboración entre dominios#
Toda organización que diseñe un sistema producirá un diseño cuya estructura será una copia de la estructura de comunicación de la organización.
Melvin Conway
El equipo de redes había dedicado seis meses a desarrollar una automatización fiable para el aprovisionamiento de reglas de cortafuegos. El equipo de seguridad había hecho lo mismo para aplicar las políticas de los grupos de seguridad. Los dos sistemas funcionaban. Los dos habían superado sus pruebas piloto. Los dos estaban en producción.
Entonces, el equipo de redes volvió a segmentar una zona del campus para aislar un nuevo conjunto de dispositivos IoT. El cambio se automatizó, se revisó y se ejecutó correctamente conforme a la Fuente de Verdad de la red. Cuarenta minutos después, el motor de políticas del equipo de seguridad empezó a registrar infracciones: el segmento nuevo no existía en la Fuente de Verdad de seguridad, así que el tráfico que procedía de él no coincidía con ninguna política aprobada y se descartaba en silencio.
Ninguna de las dos automatizaciones tenía errores. La automatización de redes ejecutó el cambio de red previsto. La automatización de seguridad aplicó la política de seguridad prevista. El fallo fue que no compartían ningún modelo. La interrupción duró cuatro horas, durante las cuales el personal de ingeniería de ambos equipos reconstruyó a mano la información que los dos sistemas de automatización deberían haber compartido.
Dos equipos, dos sistemas de automatización y ningún dato compartido: la ley de Conway se cumplía al pie de la letra. La solución es en parte organizativa y en parte arquitectónica. Esta sección trata ambos aspectos, por este orden: cómo equilibrar la estandarización con la autonomía de cada dominio, cómo compartir datos y mantener la ejecución federada, y cómo reunir a especialistas de distintos dominios para resolver un mismo problema.
Estandarización frente a autonomía#
Todo programa de automatización entre dominios se encuentra con la misma tensión. El equipo responsable de la capa compartida quiere estandarizar porque la estandarización permite compartir herramientas. Los equipos de cada dominio quieren autonomía porque sus requisitos no encajan del todo en un estándar.
Una solución que funciona es el patrón Camino pavimentado (Paved Road), desarrollado en la comunidad de ingeniería de plataformas, con una contribución destacada de Netflix. El equipo responsable de la capa compartida construye un camino bien iluminado y bien cuidado que resulta más fácil seguir que esquivar. No prohíbe las alternativas. Tampoco obliga a nadie a seguirlo. Hace que el buen camino sea el más fácil y acepta que algunos equipos se aparten de él por motivos legítimos.
Camino pavimentado y Camino recomendado (Golden Path) son dos nombres para la misma idea. Netflix popularizó el primero y Spotify, el segundo. Este libro emplea ambos con dos alcances distintos. El Camino recomendado del Capítulo 11 es la ruta que sigue el personal de ingeniería al utilizar una NAP concreta. El Camino pavimentado aplica la misma idea un nivel más arriba: es la capa compartida sobre la que trabajan los equipos de varios dominios.
Hay una pregunta sobre el reparto de responsabilidades que surge una y otra vez: ¿quién se encarga de la frontera entre la red como conjunto de elementos físicos y protocolos y la red como objeto de automatización? Quien ejerce la ingeniería de redes responde del diseño de la red, del comportamiento de los protocolos y de que el modelo de intención sea correcto. Quien ejerce la ingeniería de plataformas de red responde de la NAP que implementa esa intención. En la práctica, estos límites se difuminan continuamente, y los equipos más eficaces tratan esas responsabilidades como compartidas y definen vías claras para elevar los problemas.
Toda vía para elevar un problema necesita un punto de llegada. Los programas de automatización entre dominios se estancan sistemáticamente cuando, por encima de los equipos de cada dominio, no hay una única persona con responsabilidad última y rango de dirección o vicepresidencia. Sin esa figura, el equilibrio entre los estándares y la autonomía queda sujeto a una negociación entre iguales con prioridades contrapuestas, y al equipo de la capa compartida se le pide que resuelva conflictos para los que carece de autoridad. Designa a esa persona antes de diseñar la arquitectura compartida. Sin ella, la arquitectura no puede funcionar.
El reparto de responsabilidades determina quién arbitra. La arquitectura determina qué se puede compartir.
Datos compartidos y ejecución federada#
La cuestión arquitectónica de fondo en la colaboración entre dominios es si la automatización debe converger en un único sistema compartido o seguir federada entre las herramientas de cada dominio.
El patrón que funciona a escala combina ambas opciones. Una capa de datos compartida y una ejecución federada. Una Fuente de Verdad compartida que almacena la intención común a varios dominios (topología de red, política de seguridad, asignación de recursos en la nube) con un esquema y un modelo de acceso coherentes. Una ejecución específica de cada dominio para cada tipo de infraestructura (la red del centro de datos, los cortafuegos, las redes en la nube) que lee de la capa de datos compartida y escribe en ella los resultados. La Figura 14.8 muestra esta estructura.
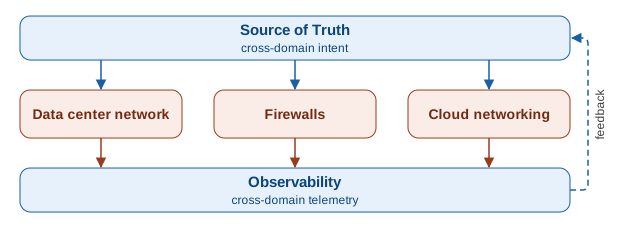
Esta arquitectura permite que las herramientas de cada dominio evolucionen de forma independiente y conserven el contexto compartido que requieren los flujos de trabajo entre dominios. La alternativa, un único sistema de automatización para todos los dominios, fracasa sistemáticamente por las diferencias en los requisitos y en los ritmos de cambio, y por las disputas internas sobre qué equipo marca con sus prioridades la hoja de ruta del sistema.
Esta decisión arquitectónica está directamente relacionada con los patrones de escalado del Capítulo 12. Un modelo de ejecución federada con una capa de datos compartida tiene requisitos específicos de consistencia. La capa de datos debe ofrecer suficiente consistencia para coordinar un cambio de política de seguridad con su aplicación en la red. También debe tener un acoplamiento lo bastante débil como para que un cambio en la red no se bloquee a la espera de que se sincronice la infraestructura en la nube.
La arquitectura hace posible la automatización compartida. Las personas aún tienen que construirla juntas.
Colaboración integrada#
Coordinar a los equipos de distintos dominios mediante comités no produce una buena automatización entre dominios. Produce reuniones. Lo que da lugar a una automatización que funciona es la colaboración integrada: especialistas de distintos dominios trabajan codo con codo en problemas concretos de automatización, sin limitarse a sesiones periódicas de revisión.
Un modelo práctico es el equipo multidisciplinar: tres especialistas, uno en ingeniería de redes, otro en seguridad y otro en la nube, reciben el encargo de desarrollar conjuntamente una capacidad concreta de automatización entre dominios durante un periodo definido. El equipo se responsabiliza tanto de la entrega como del funcionamiento posterior de lo que construye. Al trabajar codo con codo, los especialistas de cada dominio adquieren un conocimiento práctico de las restricciones de los demás, sin traspasos de trabajo ni intermediarios que tengan que traducir lo que dice cada equipo.
Los equipos multidisciplinares solo funcionan cuando sus integrantes pueden dedicarse a la misión del equipo. Si cada integrante sigue asumiendo toda la carga de trabajo de su equipo de origen, el supuesto equipo multidisciplinar es un comité con otro nombre. Para que la automatización entre dominios funcione, la dirección debe comprometerse a proteger el tiempo de quienes integran el equipo. Sin esa protección, el equipo acaba tomando el camino más fácil: cada persona hace el trabajo que encaja con su función habitual en su dominio y la integración entre dominios nunca llega a materializarse.
Los objetivos de nivel de servicio (SLO) compartidos entre dominios formalizan esta colaboración. Cuando un flujo de trabajo automatizado cruza los límites de un dominio, un solo equipo no puede responder por la fiabilidad que se espera del flujo de extremo a extremo. Definir SLO compartidos exige que ambos equipos conozcan los modos de fallo del otro y acuerden cómo se repartirán la responsabilidad por los resultados. La sección Niveles de servicio para servicios de red del Capítulo 15 muestra cómo formularlos a partir de los indicadores de nivel de servicio (SLI) de cada dominio. ¿Quién responde de un fallo de automatización que se originó en un cambio de red y se manifestó como una infracción de la política de seguridad? La respuesta no puede ser «la primera persona a la que el sistema de gestión de incidencias asigne el caso».
Resumen#
Los aspectos técnicos representan la mitad de los retos que plantea desarrollar y adoptar una estrategia de automatización de redes. La otra mitad es organizativa y tiene que ver con las personas que la desarrollarán, la utilizarán y la harán evolucionar más allá de la primera fase de adopción. Para muchas organizaciones que llevan años operando redes, esto puede suponer una sacudida que rompa con su forma habitual de trabajar y de relacionarse con otros equipos.
El personal de redes tiene que entender que se trata de una evolución (en TI vivimos en constante evolución). Aprender exige cierto esfuerzo, pero la recompensa es enorme por el impacto que cada persona puede lograr al aplicar sus conocimientos a la escala que permite la automatización. Sus funciones cambiarán, pero sus conocimientos de redes seguirán siendo necesarios para diseñar y revisar lo que hace la automatización. Esta transformación es gradual, y el perfil de ingeniería en T demuestra que un pequeño cambio puede bastar para desenvolverse con eficacia en este nuevo entorno. Además, las tecnologías asistidas por IA facilitan la transición, porque los detalles de bajo nivel que antes llevaba más tiempo aprender son ahora mucho más accesibles.
Un nivel más arriba, la organización debe estar preparada para fomentar la adopción de la automatización entre el personal, superar la resistencia al cambio y crear un ciclo de retroalimentación constructivo. Así, los resultados de las iniciativas de automatización de redes hablarán por sí solos y permitirán financiar el ascenso al siguiente peldaño de la Escalera de Confianza hacia etapas de mayor madurez.
El problema no es nuevo. El movimiento DevOps ya demostró el valor de la colaboración entre desarrollo y operaciones en otros entornos de TI, y la ingeniería de redes no es distinta en absoluto (solo llega tarde, como de costumbre). La NAP tiene que ofrecer mecanismos de integración que permitan colaborar a los distintos equipos, de modo que esa colaboración sea sistemática y no dependa de la buena voluntad.
El Capítulo 15 explora una nueva vertiente de la dimensión organizativa: cómo ofrecer la red como producto, de forma similar a como ya se aplica el patrón de infraestructura como servicio, para fomentar la interacción con las partes interesadas y aumentar el impacto global de la red en la estrategia de negocio.
Referencias#
- The Phoenix Project, Gene Kim, Kevin Behr y George Spafford (IT Revolution, 2013). Relata en forma de novela una transformación DevOps.
- The DevOps Handbook, Gene Kim, Patrick Debois, John Willis y Jez Humble (IT Revolution, 2016; 2.ª edición, 2021). Presenta las tres vías (flujo, retroalimentación y aprendizaje continuo) y los análisis posteriores a los incidentes sin búsqueda de culpables en los que se basan los apartados de este capítulo sobre el legado de DevOps.
- Team Topologies, Matthew Skelton y Manuel Pais (IT Revolution, 2019). Describe los equipos alineados con un flujo de valor, los equipos de plataforma y los equipos facilitadores. Este marco sustenta los modelos de colaboración entre dominios y de equipos integrados del apartado Colaboración entre dominios.
- Accelerate: The Science of Lean Software and DevOps, Nicole Forsgren, Jez Humble y Gene Kim (IT Revolution, 2018). Presenta las cuatro métricas clave (frecuencia de despliegue, tiempo de entrega de los cambios, tasa de fallos de los cambios y tiempo de restablecimiento del servicio) que sirven de base cuantitativa para las métricas de adopción del apartado Métricas de adopción.
- Change by Design, Tim Brown (HarperBusiness, 2009; edición revisada en 2019). Presenta el modelo del perfil de ingeniería en T y el enfoque del pensamiento de diseño en los que se basan los itinerarios de desarrollo de competencias del apartado Itinerario de transformación.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo