Seguridad, gobernanza y cumplimiento#
Llegó una auditoría de seguridad. En una revisión de cumplimiento de PCI, los auditores habían examinado el historial de cambios del cortafuegos de los últimos seis meses. Su petición era concreta: «Para cada cambio del cortafuegos necesitamos saber quién lo autorizó y a qué ticket estaba asociado. También necesitamos pruebas de que se validó el despliegue y de cuál era el estado de la red antes y después».
Los miembros del equipo se miraron unos a otros. Gracias a la plataforma de automatización de redes (NAP), había aumentado el número de cambios procesados (847 en ese periodo). La mayoría había salido bien: se habían hecho validaciones previas y posteriores, se habían revertido cambios cuando hacía falta y no se habían producido incidentes. Aun así, no podían responder a esas preguntas.
Los registros de los flujos de trabajo recogían las ejecuciones, pero omitían quién había solicitado el cambio. La Fuente de Verdad mostraba el estado deseado actual, pero carecía de un historial fechado de los cambios anteriores. Los dispositivos registraban los comandos de configuración aplicados, pero no las validaciones previas y posteriores. Por último, el sistema de ITSM no vinculaba los tickets con las ejecuciones que habían desplegado los cambios. Correlacionando la información de los cuatro sistemas podían reconstruir, con cierto esfuerzo, qué había pasado. Las otras preguntas seguían sin respuesta: «¿Quién lo autorizó?», «¿se validó?», «¿cuál era el estado anterior?».
Reconstruir las pruebas llevó tres semanas. Seis ingenieros dejaron de lado sus tareas para dedicarse a ello, porque urgía obtener la certificación de seguridad. Por suerte, todo había funcionado como se esperaba. El único perjuicio fue el tiempo perdido y el retraso en responder a los auditores. Pero el problema estaba claro: aquella auditoría de seguridad no sería la última.
La seguridad es un proceso, no un producto.
Bruce Schneier
La NAP había cumplido su cometido. Faltaba la arquitectura de gobernanza que permitiera demostrarlo.
El capítulo 11 explicó cómo hacer funcionar la automatización y el capítulo 12 cómo hacer que escale. Aquí nos centramos en qué hace falta para confiar en ella: quién puede crear un cambio y autorizarlo, qué políticas lo limitan y qué registro inmutable permite auditarlo.
Incorpora la seguridad desde el principio. En el capítulo 2 vimos lo difícil que resulta añadir después propiedades que afectan al diseño. Una NAP que nace sin identidad de carga de trabajo tendrá que incorporar la emisión de credenciales a cada flujo. Rastrear a posteriori una ejecución sin registro de auditoría es una pesadilla. Incluye la seguridad entre los criterios para dar por terminado el trabajo en la NAP desde el primer flujo.
En mi experiencia, la seguridad y la gobernanza son los aspectos más descuidados de la automatización de redes. También son los más difíciles de incorporar a posteriori. No los dejes para más adelante.
Empezaremos por las preguntas de los auditores, porque cada control del capítulo responde a una de ellas.
Las preguntas de una auditoría#
Los auditores del ejemplo inicial querían saber cuatro cosas de cada cambio: quién lo autorizó, a qué ticket correspondía, si se validó antes del despliegue y cómo estaba la red antes y después. Cuando una consulta a la NAP responde a esas preguntas para cualquier cambio, podemos confiar en ella en el sentido que damos aquí a esa palabra.
Detrás de las cuatro preguntas hay una regla. Para cada acción automatizada debe ser posible identificar a la persona que la originó, la autorización concreta y un registro verificable, incluso si un agente de inteligencia artificial (IA) tramitó la solicitud. La Figura 13.1 muestra la cadena que lo hace posible.
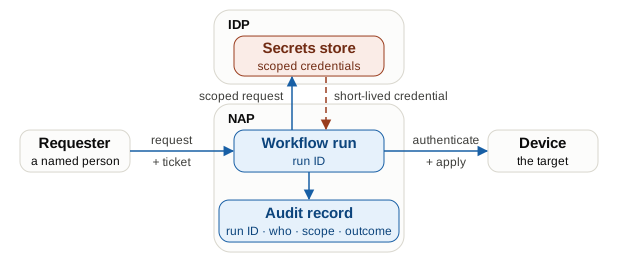
El registro de auditoría vincula a quien solicita el cambio con la ejecución del flujo, el alcance de las credenciales y la acción sobre el dispositivo. Eso es lo que necesita quien audita el sistema. El registro identifica quién pidió el cambio, quién lo autorizó, quién lo aplicó y qué ocurrió realmente. Para conseguirlo colaboran varias funciones, entre ellas el almacén de secretos de la plataforma interna para desarrolladores (IDP) y la ejecución del flujo en la NAP. El capítulo 11 delimita ambas responsabilidades. Esa división se mantiene en todo el capítulo: la IDP proporciona las funciones de seguridad y la NAP las utiliza para desplegar cambios de red.
Cada pregunta encuentra respuesta en una de las etapas del recorrido del capítulo 11, descrito en la sección Un cambio de red de principio a fin. La Tabla 13.1 sitúa cada pregunta en ese recorrido y sirve de guía para el resto del capítulo.
| Pregunta | Etapa del cambio | Controles | Sección |
|---|---|---|---|
| ¿Quién lo pidió y quién actuó? | La solicitud y todos los pasos siguientes | Identificación del solicitante, identidad de carga de trabajo, credenciales de alcance limitado, mínimo privilegio | Identidad: quién actúa |
| ¿Estaba permitido? | Intención y promoción | Nivel de riesgo, controles de política como código, revisión de la intención y aprobación del despliegue | Política: qué puede cambiar |
| ¿Se validó? ¿Se ejecutó lo que se había validado? | Validación, simulación y promoción | Comprobaciones de desarrollo seguro, artefactos firmados y cadena de procedencia (Provenance Chain) | Integridad: qué se ejecutó realmente |
| ¿Cuál era el estado antes y después? | Ejecución, verificación y registro | Instantáneas, registro de auditoría que revela alteraciones y comprobaciones de desviaciones | Evidencias: cómo demostrarlo |
| ¿Qué ocurre si algo sale mal? | Cualquier etapa | Contención y procedimientos de respuesta si la NAP se ve comprometida | Respuesta: cuando algo sale mal |
Seguiremos la tabla de arriba abajo. Para terminar, veremos las cinco etapas que conviene implantar primero para alcanzar un nivel de seguridad mínimo viable.
Identidad: quién actúa#
La identidad es lo primero porque todos los demás controles dependen de ella. Si un control desconoce quién ha presentado el cambio, no puede exigir la separación de funciones. Sin una identidad, un registro de auditoría se queda en una línea de texto. Veremos por qué la automatización rompe el modelo tradicional y cómo construir otro paso a paso. Empezaremos por el origen de cada cambio y la identidad de carga de trabajo de cada ejecución. Después veremos la autenticación y la autorización, los modelos de control de acceso y el mínimo privilegio. Terminaremos con los secretos que siguen a cargo de la NAP, los datos que debe proteger y el aislamiento entre usuarios de entornos compartidos.
En la operación tradicional, quien inicia sesión en un dispositivo responde del cambio que aplica. El dispositivo anota la identidad y el cambio en una sola línea. La automatización de redes cambia el problema de seguridad. En una NAP bien implantada, ninguna persona debería iniciar sesión en el dispositivo. Lo hace un flujo de trabajo, a menudo con una cuenta de servicio compartida. El registro de auditoría recoge la ejecución, pero deja sin aclarar quién la pidió, qué tenía autorización para hacer o si el cambio se mantuvo dentro de esos límites.
Ahora quien se autentica es la NAP y quien responde del cambio es la persona o el proceso que le dio la orden. Vincular ambos exige una decisión de diseño explícita: registrar la cadena completa desde la autorización humana hasta el cambio en el dispositivo, pasando por la ejecución.
Con los agentes de IA resulta aún menos evidente. Puede que quien solicite la acción ni siquiera sea una persona. Aun así, debes poder remontarte hasta quien definió la lógica de orquestación del agente y responde de ella.
En la seguridad de la automatización, la identidad constituye el nuevo perímetro. Para aplicarla, empieza por averiguar de dónde procede cada ejecución.
El punto de partida determina cómo se registra el origen humano. Un cambio llega a la NAP por tres vías:
- Una solicitud a través de la capa de Presentación. Alguien del equipo de ingeniería u operaciones la envía mediante un formulario, la interfaz de programación de aplicaciones (API) o la interfaz de línea de comandos (CLI), como explica el capítulo 9. La capa de Presentación autentica a esa persona y registra junto a la solicitud su identidad y el ticket de cambio. El cambio de cortafuegos del capítulo 11 llegó por esta vía, desde un formulario de ITSM.
- Un evento que inicia el flujo dentro de la NAP. Una fusión en la Fuente de Verdad, un commit en un repositorio de intención, una programación horaria o un evento inicia el flujo de trabajo de cambio sin que nadie rellene un formulario. Así comienzan la corrección de desviaciones y los flujos en bucle cerrado. El origen humano queda en quienes crearon y aprobaron la fusión o el commit. Si la ejecución está programada o responde a un evento, es la persona responsable del flujo que aprobó la política que permite ejecutarlo sin supervisión.
- Un agente que actúa en nombre de una persona. Un agente de IA envía la solicitud mediante la misma API, a menudo a través de Model Context Protocol (MCP). Una credencial propia del agente no debe ocultar quién hizo la petición. La solicitud lleva ambas identidades: la del agente que actúa y la de la persona a la que representa. El registro de auditoría identifica a ambos. El alcance del agente nunca supera al de la persona.
Las dos primeras vías suelen confluir. En el capítulo 11, la solicitud de Presentación se convirtió en una propuesta en la Fuente de Verdad. La fusión puso en marcha el flujo. La ejecución registra tanto a quien envió la solicitud como a quien la revisó y la fusionó. Hay que conservar las dos identidades. El mismo control de entrada que rechaza solicitudes anónimas rechaza cualquier evento sin origen humano identificable, como un webhook procedente de una fusión que nadie aprobó.
Sea cual sea su origen, la ejecución necesita una identidad propia.
Identidad de carga de trabajo#
El capítulo 11 incluye la identidad de carga de trabajo entre las capacidades que cabe esperar de la IDP. Cada carga de trabajo demuestra quién es al arrancar y recibe credenciales limitadas a esa ejecución. Nunca toma prestadas las credenciales de una persona ni usa una cuenta de servicio compartida. Aquí veremos qué añade la NAP: el alcance de cada credencial, dónde se hacen respetar sus límites y el identificador que vincula la ejecución con todos los recursos sobre los que actuó.
La alternativa explica por qué importa. Una cuenta de servicio compartida tiene una credencial. Si se filtra, da acceso a todo lo que alcanza la NAP: cada dispositivo, toda la Fuente de Verdad (SoT) y todos los artefactos. No puedes restringirla a una sede. Nunca caduca. Rotarla exige coordinar todos los flujos que la utilizan. El registro de auditoría atribuye la acción a «la cuenta de automatización», sin identificar la ejecución, el solicitante ni la autorización. La identidad de carga de trabajo resuelve los cuatro problemas. La credencial tiene un alcance limitado, dura poco, se emite para cada ejecución y permite remontarse hasta la solicitud humana que la originó.
La identidad de carga de trabajo nace con la ejecución. Uno de los eventos anteriores llega a la NAP y el Orquestador inicia el flujo de trabajo de cambio. Sus procesos de ejecución funcionan como cargas de trabajo en el entorno de contenedores de la IDP. Dos partes dan fe de la identidad. El entorno de contenedores sabe qué carga ha iniciado. El Orquestador sabe qué flujo, qué versión y qué ejecución concretos está procesando esa carga. En la variante GitOps, un commit en el repositorio de intención inicia una cadena de CI/CD de la IDP. El proceso que ejecuta la cadena da fe de sus etapas de la misma manera. El capítulo 11 describe las dos variantes.
Esa acreditación sigue el patrón de identidad de carga de trabajo con OpenID Connect (OpenID Connect workload identity, OIDC). OIDC añade una capa de identidad al marco de autorización OAuth 2.0. Permite que el almacén de secretos confíe en afirmaciones sobre la identidad de una carga de trabajo sin compartir con ella un secreto estático. El proveedor de identidad del entorno de ejecución firma un JSON Web Token de corta duración (JWT, RFC 7519). El token contiene declaraciones sobre la carga y la firma permite detectar cualquier alteración.
Los entornos de contenedores lo hacen de forma nativa para cada carga mediante tokens de cuenta de servicio. Solo hace falta registrar una vez la URL del emisor en la política de confianza del almacén de secretos. Los sistemas de CI, como GitLab CI, GitHub Actions y Jenkins, hacen lo mismo para los trabajos de sus cadenas de CI/CD. El Orquestador añade las declaraciones propias de la ejecución: el flujo y su versión, el identificador de ejecución y el alcance que necesita.
El Listado 13.1 muestra, a modo de ejemplo, el JWT que presenta una ejecución al iniciarse. Contiene las declaraciones del entorno de ejecución firmadas sobre el proceso que ejecuta el trabajo, además de la identidad de la ejecución y el alcance solicitado.
{
  "iss": "https://runtime.corp.com",
  "sub": "vlan-add:1.3",
  "jti": "job-20260316-0117",
  "iat": 1773619200,
  "exp": 1773619320,
  "scope": {
    "sot":    "read:site=bldg-b",
    "device": "write:site=bldg-b",
    "store":  "write:artifact-type=network-change"
  }
}La declaración sub identifica el flujo y su versión. La declaración jti identifica la ejecución. Las declaraciones de alcance expresan límites, pero por sí solas no los imponen. Una declaración como device: write:site=bldg-b solo restringe el acceso si se hace cumplir en el recurso. El punto donde se aplica el límite es distinto para la SoT y para los dispositivos.
- La SoT limita las lecturas en su propia capa de autorización. El atributo de sede de la declaración se convierte en un filtro obligatorio en todas las consultas. El flujo solo puede leer registros etiquetados con
site=bldg-b. Para ello, el modelo de datos de la SoT debe incluir la sede como atributo de cada registro. Es el mismo mecanismo de delimitación por atributos que utiliza la sección Entornos compartidos y aislamiento y que hace posible el capítulo 4. - Los dispositivos no pueden imponer límites que desconocen. La mayoría autentica credenciales, pero carece del concepto de «sede». El control se desplaza un paso atrás, al momento de emitir la credencial. El almacén de secretos solo emite credenciales para dispositivos cuyo atributo de sede en la SoT coincide con el declarado. Suele emitir una cuenta temporal TACACS+ o RADIUS limitada al grupo de dispositivos de la sede. Un flujo limitado a bldg-b nunca recibe una credencial válida fuera de bldg-b.
El alcance efectivo del token depende del más débil de estos dos controles. Por eso el almacén de secretos contrasta el alcance solicitado con el máximo registrado para el flujo antes de emitir nada.
La Figura 13.2 muestra todo el intercambio, desde el evento inicial hasta la revocación.
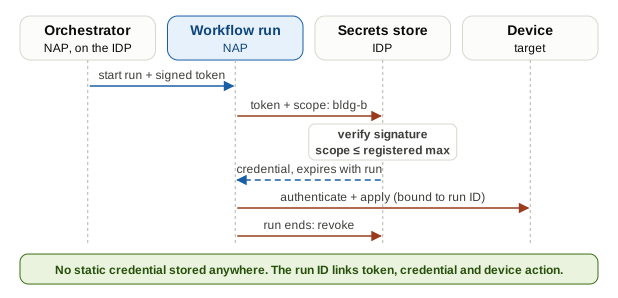
La ejecución presenta el JWT con el alcance que necesita. El almacén de secretos verifica la firma, comprueba el alcance frente al máximo registrado para el flujo y devuelve una credencial que caduca al terminar la ejecución. La vigencia del JWT (120 segundos en el Listado 13.1) solo debe cubrir el intercambio. La credencial tiene su propio plazo de validez. Cuando la ejecución finaliza o se cancela, se revoca la credencial. La única relación de confianza duradera es la que se configura una vez entre el entorno de ejecución de la IDP y el almacén de secretos.
La IDP se encarga de casi todo este intercambio. Una decisión corresponde al equipo de automatización de redes: el máximo registrado, es decir, el mayor alcance que podrá solicitar cada flujo. Se fija una vez, al dar de alta el flujo, y se guarda en la política del almacén de secretos. Por ejemplo, el flujo vlan-add puede escribir en los switches del campus, pero nunca en los routers del núcleo. En cada ejecución pide un alcance más reducido, como un solo edificio. El almacén de secretos rechaza cualquier solicitud que supere el máximo. Es el almacén quien impone el límite, de modo que ni un fallo en el flujo ni la manipulación de una ejecución permiten obtener más permisos.
Calcula entre una y dos semanas de trabajo de integración para el primer flujo y unas horas para cada uno de los siguientes. Si el almacén de secretos pertenece al equipo de productividad de desarrollo, el plazo suele duplicarse. Registrar el emisor del entorno de ejecución, aprovisionar el servicio que custodia los secretos y definir los primeros alcances pasan por el proceso de cambios de ese equipo. Tenlo en cuenta al planificar. El trabajo técnico es sencillo. Lo que lleva tiempo es coordinarse.
No todos los orquestadores ni todos los entornos de ejecución emiten tokens OIDC. Algunas versiones antiguas de AWX alojadas en infraestructura propia, ciertas configuraciones de Jenkins y los procesos de ejecución desarrollados a medida carecen de esa función. Como alternativa, un pequeño intermediario de identidad autentica el proceso con un mecanismo compatible (p. ej., un token de API por trabajo o un certificado TLS de cliente) y lo intercambia por un token aceptado por el almacén de secretos.
Si partes de una cuenta de servicio compartida, migra los flujos de uno en uno. Durante dos a cuatro semanas, ejecuta cada flujo migrado junto con los que aún utilizan esa cuenta. Revócala solo cuando hayas migrado el último. Si la rotas antes, dejarán de funcionar todos los que dependan de ella. Documenta las fechas. El registro de auditoría mezclará ambos tipos de entradas durante ese periodo y quien lo audite querrá saber por qué.
El identificador también hace observable la ejecución. Si diseñas primero su identidad, obtienes la correlación entre sistemas sin coste añadido. El jti se propaga como contexto de traza (el mecanismo de trazas distribuidas del capítulo 12) por cada sistema que utiliza el flujo: la consulta a la SoT, la escritura en el almacén de artefactos y el cambio en el dispositivo. Quien investiga un incidente ya no tiene que correlacionar cuatro sistemas por marcas de tiempo y confiar en que los relojes coincidan. Consulta el identificador de ejecución y obtiene toda la cadena causal. En el capítulo 7 vimos cómo la correlación convierte los datos recogidos en respuestas. La identidad de carga de trabajo la incorpora al diseño. En Evidencias: cómo demostrarlo veremos por qué es también lo que permite pasar del simple registro a la auditoría.
La identidad de carga de trabajo te dice quién actúa. Aún queda por decidir qué puede hacer con esa identidad.
Autenticación y autorización#
La autenticación indica quién actúa. La autorización determina qué puede hacer. Quienes trabajan con TACACS+ conocen bien la distinción: iniciar sesión correctamente no da permiso para ejecutar cualquier comando. La automatización necesita esa misma separación. Una ejecución con una credencial válida y sin límites de autorización puede hacer todo lo que admita el dispositivo. El registro de auditoría solo demuestra que se aceptó una credencial. No demuestra que la operación respetara su alcance. Veremos dos formas de expresar los permisos, mediante roles y atributos, y la regla que se aplica a ambas: el mínimo privilegio.
Autorizar la automatización exige modelar los permisos de forma explícita. ¿Qué flujos pueden leer la SoT? ¿Cuáles pueden escribir en ella? ¿Cuáles pueden enviar configuraciones y a qué grupos de dispositivos? ¿Cuáles pueden promover artefactos de un entorno a otro? Este modelo evoluciona al crecer la NAP. Somételo al mismo control de versiones y a las mismas revisiones que el código. Revísalo en cuatro momentos de la vida de cada flujo, como muestra la Figura 13.3.
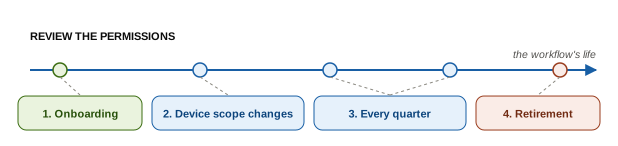
- En el alta. Define su alcance al registrarlo. No esperes a que se ejecute en producción con permisos predeterminados excesivos.
- Cuando cambie el conjunto de dispositivos de la NAP. Una sede nueva, un grupo de dispositivos nuevo o la retirada de una región hacen que los límites de los permisos dejen de coincidir con la infraestructura.
- Como mínimo, cada trimestre. Enumera los permisos que no se hayan utilizado durante el periodo. Si un permiso lleva 90 días sin usarse, el flujo ha dejado de estar activo o recibió permisos demasiado amplios. En ninguno de los dos casos se justifica conservarlo.
- En la retirada. Revoca los permisos en cuanto retires el flujo. Los permisos sin uso con credenciales activas amplían la superficie de ataque.
Una vez identificados los permisos, ¿cómo los expresamos?
Control de acceso basado en roles y en atributos#
El control de acceso se aplica tanto a las personas como a los flujos. Para las personas sirven los roles del capítulo 9: el personal de ingeniería escribe y publica los flujos, el de operaciones solicita ejecuciones y una misma persona puede tener distintos roles según el entorno. Para los flujos, los dos modelos habituales se basan en roles o en atributos. La Figura 13.4 los compara en un mismo flujo.
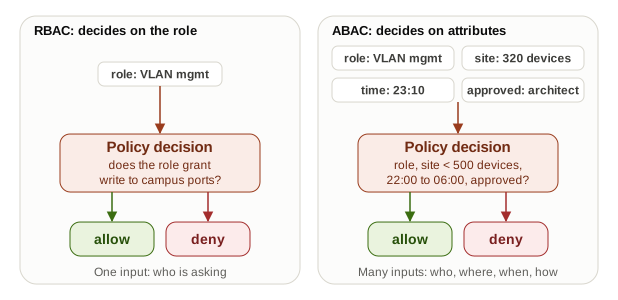
El Control de acceso basado en roles (RBAC) asigna permisos a roles y roles a flujos o usuarios. Un flujo clasificado como «gestión de VLAN del campus» recibe el rol de gestión de VLAN. Este le permite escribir la configuración de los puertos de los switches de las sedes del campus y leer los registros pertinentes de la SoT. RBAC es fácil de implantar, auditar (la definición del rol recoge sus permisos) y revocar (al retirar el rol desaparecen todos sus permisos a la vez).
Los roles de RBAC son estáticos. Un flujo tiene el rol de gestión de VLAN o carece de él. No puede tenerlo solo en ventanas de mantenimiento, solo en sedes por debajo de cierto tamaño o solo si alguien de arquitectura de red ha aprobado el cambio previamente. Estas restricciones dependientes del contexto necesitan el Control de acceso basado en atributos (ABAC).
ABAC evalúa los permisos en el momento de la solicitud. Aplica una política que tiene en cuenta los atributos del flujo solicitante, la operación solicitada, el recurso de destino y las condiciones del entorno. Una política podría decir: «Un flujo con el rol de gestión de VLAN puede enviar cambios de configuración a los switches del campus en sedes con menos de 500 dispositivos, entre las 22:00 y las 06:00, hora local, si alguien de arquitectura de red ha aprobado el cambio». Permite expresar más matices, pero cuesta más determinar los permisos efectivos. En un momento dado dependen de los valores de varios atributos que quizá no estén a la vista.
Empieza con RBAC por su sencillez y facilidad de auditoría. Introduce ABAC para restricciones concretas que realmente dependan del contexto y cuando tu equipo tenga la madurez operativa necesaria para gestionar la complejidad de esas políticas. Si basta con RBAC, evita usar ABAC como lenguaje de políticas de propósito general. Cada dimensión adicional dificulta el diagnóstico de problemas.
Elijas el modelo que elijas, el principio que determina el alcance de cada permiso es el mismo.
Mínimo privilegio#
El mínimo privilegio consiste en dar a cada componente de automatización exactamente los permisos que necesita para su tarea. Es el equivalente para los permisos del patrón de mamparos (Bulkhead) del capítulo 12. Un mamparo limita un fallo operativo a la parte de la NAP que sirve a una sede. El mínimo privilegio limita un fallo de seguridad al alcance de los permisos de un flujo.
Un flujo que lee datos de la SoT no necesita permiso de escritura. Aun así, hay equipos que se lo conceden «por si lo necesita más adelante» o porque «es más fácil configurarlo todo de una vez». Un error en ese flujo, o una versión comprometida, podría corromper los datos de los que dependen todos los demás flujos.
Un flujo que aprovisiona dispositivos en la sede A no necesita credenciales para la sede B. Si se las das para todo el inventario porque «confiamos en el flujo», una ejecución defectuosa podrá acceder a dispositivos que nunca debió tocar.
La identidad de carga de trabajo hace cumplir este principio mediante tres alcances anidados, como muestra la Figura 13.5.
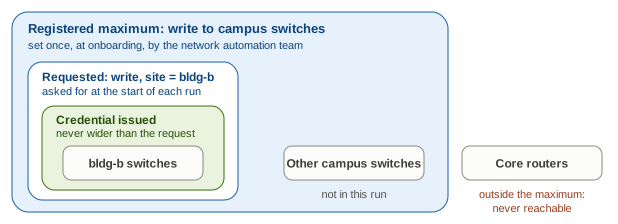
El máximo registrado forma el límite exterior y se fija una vez por flujo. Cada ejecución solicita un alcance menor y la credencial que emite el almacén de secretos nunca excede lo solicitado. Una ejecución de vlan-add para el edificio B solo recibe credenciales para el grupo de dispositivos de ese edificio. Pida lo que pida, los routers del núcleo quedan fuera de su alcance.
Puede parecer que el mínimo privilegio ralentiza las operaciones. Hay más alcances y permisos que definir, y más trabajo cada vez que se da de alta un flujo. El esfuerzo es real. La alternativa es que una sola credencial comprometida o una ejecución defectuosa pueda afectar a todo lo que la NAP alcanza. Esa disciplina se amortiza la primera vez que limita el impacto de un incidente que de otro modo habría llegado a toda la red.
El mínimo privilegio condiciona el diseño desde el primer día. Determina cómo se definen los flujos, cómo se delimita el alcance de las credenciales y cómo se organiza el modelo de permisos. Incorporarlo a una NAP diseñada sin él exige rediseñarla. No basta con cambiar la configuración.
Aplica el mínimo privilegio también a los dispositivos. Si la NAP es la única vía para introducir cambios, haz que sea la única vía de entrada. Las ACL del plano de gestión solo admiten conexiones del grupo de procesos de ejecución del Orquestador y de los servidores de salto de emergencia. El servidor AAA acepta únicamente las cuentas por ejecución de la NAP y las de emergencia. Cualquier otro inicio de sesión genera una alerta y la comprobación de desviaciones detecta lo que haya cambiado. Sin esos controles, «nadie inicia sesión en el dispositivo» es una mera convención, y a las 03:00 las convenciones se rompen.
Las credenciales temporales y de alcance limitado eliminan la mayoría de los secretos de la NAP. Algunos permanecen.
Gestión y ciclo de vida de los secretos#
Un secreto en un repositorio de Sistema de control de versiones (VCS) queda expuesto a todos los usuarios del repositorio. Si está en el archivo de configuración de un ejecutor retirado, permanece en los discos que no se hayan borrado. Si llevas dos años sin rotarlo, también lo conservan quienes tuvieron acceso en ese periodo y ya han dejado la organización. Ninguno de ellos sigue siendo secreto.
El almacén de secretos pertenece a la IDP. Elegir el producto corresponde al equipo de productividad de desarrollo. Puede ser un gestor de secretos alojado en infraestructura propia como HashiCorp Vault, el gestor de un proveedor de nube o un sistema empresarial de gestión de accesos privilegiados. El capítulo 11 enumera qué pedirle. Si la elección recae en ti, empieza por aquello con lo que ya se integren de forma nativa tu Orquestador y el entorno de ejecución de la IDP.
El modelo es sencillo. La configuración de la NAP no guarda secretos. El almacén los genera en tiempo de ejecución, con el alcance de la operación que los necesita, y caducan cuando esta termina. Una credencial sigue requiriendo atención a largo plazo: la que usa la NAP para autenticarse ante el propio almacén de secretos. Haz que sea la credencial que se gestione con más cuidado, tenga el alcance más restringido y se rote con mayor frecuencia.
El equipo de automatización de redes gestiona el ciclo de vida de las credenciales de las que depende la NAP. Lleva un registro de los tipos en uso y del alcance de cada uno, de cuándo se rotaron, de los flujos que los utilizan y del procedimiento de rotación. Guarda esa información en el manual de operaciones de la NAP. No la confíes a la memoria de una persona.
Una regla evita el atajo más común: si puedes hacer una copia de seguridad de un sistema y copiarla a otro lugar, ese sistema no es un almacén de secretos. Un equipo que guarda las credenciales de los dispositivos en la base de datos de su SoT porque esta tiene control de acceso puede aprenderlo por las malas. Basta con que una copia rutinaria acabe en almacenamiento compartido para que cualquiera que pueda abrir el archivo lea todas las credenciales. Un almacén de secretos registra cada lectura, emite credenciales con caducidad y puede revocar una al instante. Una copia de una base de datos no hace nada de eso.
Por qué la Fuente de Verdad no debe guardar secretos#
En el capítulo 4 establecimos que la SoT modela la referencia a un secreto y nunca el secreto en sí. La tentación es comprensible. Una contraseña cabe en un campo y la SoT ya contiene todos los demás. Hay tres razones para descartar ese atajo:
- La SoT es el sistema más consultado que tienes. Todos los flujos, paneles y agentes la consultan y su diseño facilita la lectura. Un almacén diseñado para que todo el mundo pueda leerlo es un mal sitio para guardar lo único que casi nadie debería poder leer.
- La rotación se convierte en una migración de datos. Si la contraseña es un campo, cambiarla cada 90 días obliga a reescribir la intención periódicamente. Cada copia obsoleta y cada vista en caché conservan entonces una credencial que ya no funciona.
- Los registros de auditoría tienen necesidades opuestas. Para la intención necesitas un historial inmutable que nadie pueda editar. Es justo lo que no conviene para un secreto que deberás poder borrar si se ve comprometido.
El último punto tiene una consecuencia que suele pasar inadvertida: un artefacto generado y la intención necesitan plazos de conservación distintos. Un artefacto con una credencial activa necesita lo contrario del historial permanente de la intención. Genéralo, úsalo y descártalo. Evita que pase por registros, cachés, comparaciones de cambios o historiales de cambios. Si guardas configuraciones generadas para una auditoría, guárdalas sin secretos y audita las referencias.
Las instantáneas previas al cambio son la excepción que confirma la regla. Para revertir un cambio hace falta la configuración completa del dispositivo, con sus secretos. Por eso no se pueden ocultar en la instantánea como en la copia de auditoría. Trátala como un dato sensible. Cífrala, registra todas las lecturas y consérvala solo mientras dure el plazo para revertir el cambio. El registro de auditoría guarda una copia con los secretos ocultos y el hash de la instantánea, sin la instantánea original.
Algunos productos de Fuente de Verdad ofrecen almacenamiento de secretos integrado. Cifran las credenciales en su propia base de datos con una clave que aporta el usuario. Eso evita que queden en texto claro en las copias de seguridad. El modelo de gobernanza de este capítulo exige además registrar cada lectura, caducar las credenciales automáticamente y revocarlas de forma selectiva. Ese cifrado por sí solo no proporciona estas funciones.
Las credenciales son los datos más sensibles que maneja la NAP. También hay otros que proteger.
Protección de datos#
La automatización de redes maneja datos sensibles por diversos motivos. Las configuraciones pueden contener claves precompartidas, cadenas de comunidad de Simple Network Management Protocol (SNMP), políticas de encaminamiento que revelan la topología y dependencias entre servicios de carácter comercialmente sensible. La telemetría puede incluir metadatos sobre patrones de tráfico, actividad de usuarios o relaciones entre elementos de infraestructura que, en algunas jurisdicciones, están sujetos a la normativa de protección de datos.
Clasifica la información que maneja la NAP según su sensibilidad. La mayoría es pública o interna. Solo una pequeña parte es sensible, como muestra la Figura 13.6.
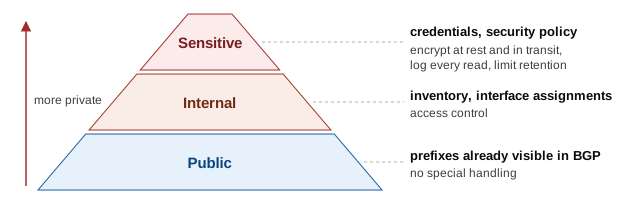
- Los datos públicos, como los prefijos que ya figuran en las tablas de Border Gateway Protocol (BGP), no necesitan un tratamiento especial.
- Los datos internos, como el inventario de dispositivos y las asignaciones de interfaces, requieren control de acceso.
- Los datos sensibles, como las credenciales de dispositivos y las configuraciones de políticas de seguridad, requieren cifrado en reposo y en tránsito, registro de accesos y plazos de conservación limitados.
El cifrado actúa en dos niveles y una NAP que maneja secretos necesita ambos. En reposo se cifran el almacén de artefactos, los datos de la SoT y el registro de auditoría. En tránsito, todas las conexiones entre componentes de la NAP, con los dispositivos y con los sistemas externos usan TLS con certificados verificados. Que los datos permanezcan dentro de tu red no basta en ninguno de los dos casos.
Un atajo que parece seguro es prescindir de TLS entre componentes de la NAP porque comparten una VLAN de gestión. Hasta que alguien captura paquetes para diagnosticar un problema de latencia. Esa captura contiene tokens del almacén de artefactos, configuraciones generadas con comunidades SNMP y claves BGP, y la identidad de cada solicitante. Y se queda semanas en una estación de trabajo. TLS protege los datos en tránsito. La amenaza incluye a cualquiera que pueda capturar tráfico en la red de gestión, esté donde esté el perímetro.
La protección anterior mantiene los datos fuera del alcance de personas ajenas a la NAP. Cuando la NAP sirve a varios equipos, la frontera entre ellos exige el mismo cuidado.
Entornos compartidos y aislamiento#
A medida que la NAP presta servicio a más equipos, aislar a quienes comparten sus recursos pasa de ser una comodidad organizativa a constituir una frontera de seguridad. Si solo hay un equipo, un flujo defectuoso supone una molestia para ese equipo. Si hay varios, puede degradar a la vez el rendimiento de la base de datos para los flujos de todos los demás. Es lo que se conoce como el efecto del «vecino ruidoso».
Algunos componentes de los que depende la NAP pertenecen a la IDP y sirven a toda la organización: el almacén de secretos, el de artefactos, las bases de datos de observabilidad y, a menudo, los paneles (capítulo 11). El equipo de productividad de desarrollo diseña su aislamiento. A ti te corresponde pedirlo.
La Figura 13.7 compara dos formas de separar a los equipos que comparten el servicio.
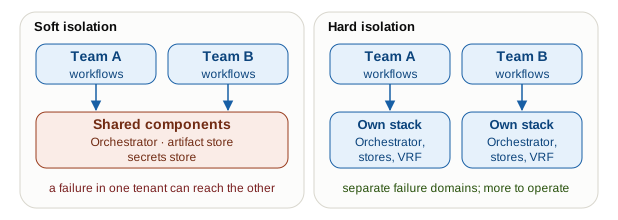
El aislamiento lógico permite compartir la infraestructura manteniendo entornos separados. Es más sencillo de operar y basta para muchas organizaciones. El riesgo es que un fallo en los flujos de un equipo afecte a componentes compartidos: el Orquestador, el almacén de artefactos o el de secretos. El aislamiento estricto asigna instancias de infraestructura independientes a cada equipo. Elimina ese riesgo, pero aumenta considerablemente el trabajo de operación. En la red, suele implicar VRF o VLAN distintas para el plano de gestión, interfaces físicas de gestión separadas y dominios de credenciales de dispositivos independientes. La separación va más allá de desplegar el software por separado.
Empieza por el aislamiento lógico. Pasa al estricto únicamente si una norma exige de forma explícita la separación física o si un incidente por el efecto del vecino ruidoso ha provocado un incumplimiento medible del objetivo de nivel de servicio (SLO) que el aislamiento lógico no permite resolver. Anticiparte a ambas condiciones añade trabajo y coste para cubrir un riesgo que la organización aún no ha sufrido.
Dividir la infraestructura deja pendiente otro problema más detallado. Un dispositivo físico puede contener a la vez configuración y telemetría de varios equipos. La NAP debe decidir qué tiene permiso para ver cada uno.
Un router del núcleo del campus con VRF-A para una unidad de la organización y VRF-B para otra produce un único flujo de telemetría, una única instantánea de configuración y un único historial de cambios. Quien pueda consultar el dispositivo o leer sus datos en el almacén de observabilidad verá todas sus interfaces, todas las entradas de las tablas de encaminamiento y todos los eventos de configuración. Si la NAP muestra la instantánea completa a cualquiera de las dos unidades, revelará la topología, los metadatos de tráfico y la configuración de la otra. En un cortafuegos compartido, la política de A puede contener entradas de ACL que revelen qué servicios utiliza B. También puede revelar políticas de encaminamiento sensibles por motivos de competencia comercial o por requisitos de protección de datos.
Usa el atributo de los datos como unidad de aislamiento. La SoT asigna una unidad propietaria a cada interfaz, VRF, política y registro de servicio. Al atender una consulta o ejecutar una acción, la NAP evalúa ese atributo en cada registro que toca el flujo. Si una ejecución del equipo A consulta el estado del dispositivo, recibe solo los registros de interfaces de VRF-A. Si el auditor del equipo A consulta el cumplimiento, recibe solo las entradas del historial relativas a cambios en VRF-A. Ambos equipos comparten el dispositivo, pero cada uno tiene su propia vista de los datos. Sin ese alcance por atributo desde el diseño, la única forma de conseguir aislamiento real es dedicar un dispositivo a cada unidad. Eso suele ser inviable en un campus que ha consolidado la infraestructura precisamente para compartirla.
El alcance por atributo aísla los datos, pero deja pendiente el acceso concurrente. Cuando dos equipos tienen flujos dirigidos al mismo dispositivo, la reserva temporal por dispositivo del capítulo 8 los serializa. Así, el segundo espera unos segundos en lugar de esperar a que el primero termine toda la verificación.
La identidad indica a la NAP quién actúa y a qué puede acceder. La decisión de si debe realizarse este cambio concreto corresponde a la política.
Política: qué puede cambiar#
Una identidad autorizada todavía puede solicitar un cambio inconveniente o uno que requiera otra revisión. La política distingue los dos casos. Empezaremos por la decisión que determina las demás: el nivel de riesgo de cada solicitud. Después veremos los controles y las aprobaciones, cómo evolucionan las políticas y cómo mantener su coste lo bastante bajo para que nadie intente eludirlas.
Clasificación por niveles de riesgo#
Los cambios requieren distintos grados de escrutinio. Modificar la descripción de una interfaz tiene un riesgo distinto al de abrir una nueva ruta hasta los servicios de autenticación mediante una regla de cortafuegos. Si aplicas todos los controles a ambos, cada cambio soportará la máxima carga, sea cual sea su riesgo real.
Los niveles, sus nombres y los controles de la Tabla 13.2 son un ejemplo que coincide con la política de despliegue del capítulo 11. Tu organización fijará sus propios límites. Lo que se conserva es el mecanismo: la NAP calcula un nivel para cada solicitud y ese nivel determina los controles.
El capítulo 11 estableció la regla de partida: el riesgo se evalúa por solicitud. La definición del flujo declara un risk_tier como mínimo e identifica la política que debe cumplir cada solicitud. Una regla de cortafuegos que encaja en la política de seguridad, por ejemplo un nombre DNS conocido en un puerto estándar, se mantiene en standard. Si queda fuera, pasa a high. El nivel determina los controles, como muestra la Tabla 13.2.
| Control | standard | high |
|---|---|---|
| Revisión de la intención | Ninguna: la política ya aprueba el cambio | Un colega distinto del solicitante |
| Aprobación del despliegue | Ninguna: se promueve al superar los controles | Manual, en la ventana de mantenimiento |
| Ticket de cambio | Cambio estándar que la NAP abre y cierra | Cambio normal con aprobación previa al despliegue |
| Comprobaciones de seguridad | Bloqueantes para secretos e incumplimientos de política. Las demás son asíncronas | Todas bloqueantes |
| Evaluación de la política | Resultado en caché con un TTL corto | Evaluación nueva en cada ejecución |
| Despliegue (Listado 11.4) | Parar al alcanzar un 5 % de dispositivos con fallos. Conservar las oleadas correctas | Parar ante el primer fallo y deshacer todas las oleadas |
Bastan dos niveles para ilustrar el modelo. Muchas organizaciones añaden un tercero, por ejemplo critical, para cambios en el núcleo o en la propia política de seguridad, con un revisor adicional y una oleada canaria. Es un nivel más en la política de despliegue y una columna más en esta tabla.
El nivel es la decisión de seguridad más importante y lo calcula la NAP. El solicitante nunca lo elige. Si pudiera clasificar su propio cambio como standard, podría eludir todos los controles de la tabla. La NAP calcula una clasificación inicial a partir de tres campos que toda solicitud aporta a la entrada:
- El flujo de trabajo, por ejemplo firewall-rule-add o vlan-add.
- El alcance de destino, expresado como número de dispositivos o como límite de sede.
- El dominio de configuración (política de seguridad, política de encaminamiento o datos operativos), que se declara una vez en la definición del flujo.
Con esos tres campos, la NAP clasifica la solicitud sin necesidad de interpretar su contenido. Una regla de cortafuegos que abarca más de una sede es high por definición. Una VLAN en los puertos de acceso de una sede se mantiene en standard. El flujo puede añadir una comprobación del contenido, como hace el del cortafuegos del capítulo 11 al contrastarlo con la política de seguridad. Esa comprobación solo puede elevar el nivel. Si falta algún campo, la NAP rechaza la solicitud en la entrada. Asignarle standard por defecto equivaldría a prescindir de la clasificación.
Un conjunto de reglas o un asistente de IA puede deducir los campos por el solicitante. Un cambio en una ACL permite deducir el flujo y el dominio de configuración. El alcance depende de los dispositivos que referencian esa ACL. Antes de usar un valor inferido en el control de entrada, valídalo contra las definiciones de los flujos. Si una solicitud high se trata por error como standard, se omiten todos los controles anteriores.
Una solicitud solo puede referirse a un flujo dado de alta, de modo que la clasificación crece con las incorporaciones. El nivel mínimo y el dominio de configuración de cada flujo se revisan al publicarlo. Si la NAP ya ejecuta flujos sin niveles, asigna a cada flujo activo su nivel y su dominio, revísalos con el equipo de seguridad y solo entonces activa el bloqueo en el control de entrada. Si lo activas antes, retendrás a la vez todas las solicitudes sin clasificar y habrás provocado tú mismo una interrupción del servicio.
El nivel determina qué controles corresponden. La siguiente cuestión es cómo hacerlos cumplir.
Controles y aprobaciones#
En el capítulo 11 presentamos el camino recomendado (Golden Path): un recorrido bien documentado y con buen soporte para los flujos habituales. El camino recomendado es una medida de protección. Facilita actuar correctamente y hace incómodo apartarse de lo previsto, pero no lo impide. Quien lo conoce puede presentar un cambio que ignore sus convenciones, quizá por falta de tiempo o porque su flujo tenga diferencias legítimas.
Los controles obligatorios funcionan de otra manera. Si un flujo rechaza los cambios sin referencia a un ticket válido, tener prisa no permite saltarse ese control. Si una política bloquea el despliegue de un artefacto que no ha superado la simulación, la confianza personal en el cambio tampoco basta para continuar. El cambio supera el control o se detiene. Lo que distingue el control obligatorio es que resulta ineludible.
El patrón Control de política como código (Policy-as-Code Gate) expresa las reglas de gobernanza como comprobaciones ejecutables dentro del flujo de cambio. Cada requisito que deba cumplirse, más allá de una mera recomendación, debería convertirse en un control que el flujo evalúe automáticamente y que los revisores no puedan anular. El control aplica la misma regla a cada cambio, con independencia de quién revise o del trabajo que tenga. También se puede auditar: su definición está bajo control de versiones, su ejecución deja una entrada en el registro y su decisión forma parte del historial de procedencia del artefacto. La política como código es una práctica consolidada. Su motor más habitual es Open Policy Agent, un proyecto graduado de la Cloud Native Computing Foundation (CNCF).
Un ejemplo muy común es la protección de ramas de un VCS. Cada cambio debe pasar por una solicitud de incorporación que cuente con aprobación humana y supere las comprobaciones.
El conjunto de controles de política como código materializa la gobernanza. Cuando aparece un nuevo requisito normativo, añades o modificas un control, revisas su definición mediante el proceso habitual de revisión de código y lo despliegas como cambio versionado en la configuración de políticas de la NAP.
Los controles hacen cumplir reglas que puede comprobar una máquina. Algunas decisiones todavía requieren una persona.
El capítulo 11 sitúa dos puntos de aprobación en el recorrido de un cambio. Al presentar la propuesta en la Fuente de Verdad, otro ingeniero revisa la intención para comprobar que el cambio es el correcto. En la promoción, la aprobación del despliegue permite publicar el artefacto validado durante la ventana prevista. La Tabla 13.2 indica qué solicitudes requieren estas aprobaciones. Ambas funcionan como controles: la NAP retiene la solicitud, la marca como pendiente, avisa a quien debe aprobarla y solo continúa cuando queda registrada la identidad de esa persona.
Los marcos de cumplimiento suelen exigir otros dos controles. Implanta ambos como funciones automáticas de la NAP:
- Separación de funciones: quien presenta un cambio no puede aprobarlo. La persona que revisa la intención siempre es distinta del solicitante. La NAP registra la identidad del solicitante y rechaza cualquier aprobación de esa misma identidad.
- Principio de los cuatro ojos: las solicitudes
highrequieren la aprobación de dos personas distintas. Una revisa la intención y otra aprueba el despliegue. Ninguna es la solicitante. La NAP retiene la ejecución hasta registrar ambas aprobaciones. Las aprobaciones caducan. La autorización para la ventana del sábado no debería seguir siendo válida un mes después.
Un control concreto hace cumplir estas reglas. Su ausencia explica la carencia de la historia inicial. El control change-ticket-reference valida que cada despliegue en producción tenga un ticket de cambio aprobado por una persona distinta de quien lo presentó. La Figura 13.8 sigue una solicitud de la capa de Presentación hasta el control y de vuelta.
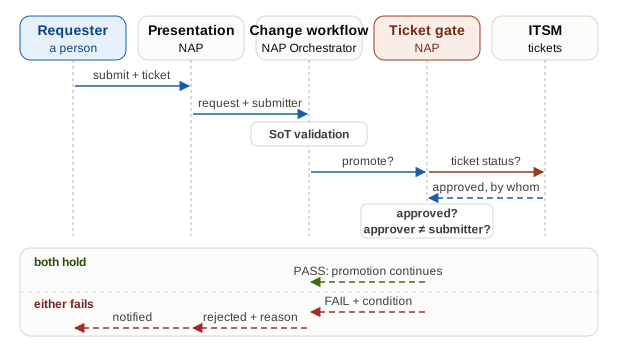
Para una solicitud standard, el ticket es el cambio estándar que abrió la propia NAP. El control verifica que existe y que referencia la política preaprobada. Para una solicitud high, comprueba su aprobación en el sistema de ITSM. Si el cambio se inicia dentro de la NAP, por ejemplo al fusionar una propuesta en un repositorio de intención, no hay un formulario que incluya el ticket. La referencia viaja en los metadatos de la fusión o del commit y pasa la misma comprobación.
El control aplica las mismas condiciones, la misma consulta y la misma regla de rechazo a todos los cambios del flujo, los presente quien los presente y por urgentes que parezcan. El mensaje de error forma parte de los requisitos de diseño. Si solo dice «incumplimiento de política», el solicitante tendrá que preguntar al equipo de automatización de redes qué condición ha fallado. La NAP se construyó precisamente para evitar ese traspaso de trabajo.
Incorpora con cuidado los agentes de IA a este proceso. Un agente no debería aprobar cambios. La rendición de cuentas exige identificar a una persona. Ante la pregunta «¿quién autorizó el cambio?», responder «un modelo» es insuficiente. La IA carece de una cadena de responsabilidad y de capacidad para responder ante el regulador. Tampoco puedes citarla a la revisión de un incidente. Úsala para ayudar a quienes aprueban, manteniendo en sus manos la decisión.
Lo difícil es decidir qué cambios necesitan aprobación. Si te equivocas, el control se convierte en un cuello de botella, como ocurre en la mayoría de las organizaciones. Los comités de control de cambios son donde la automatización viene a morir. El fallo es silencioso: el flujo funciona, el control es correcto y el cambio sigue tardando una semana.
La NAP automatiza las aprobaciones. Si tu comité asesor de cambios (CAB) se reúne semanalmente para autorizar el alta de una VLAN, la NAP ya es más lenta que el proceso manual al que sustituyó. El cambio estándar de ITIL resuelve ese problema. El capítulo 11 lo asocia al nivel standard y el capítulo 15 lo generaliza como patrón de automatización preaprobada (Pre-Approved Automation Pattern).
Suelo repetir este ejemplo. Los proveedores de nube pública, como AWS o Azure, aplican este principio de cambios preaprobados en la red superpuesta. Cuando solicitas un nuevo servicio de red, por ejemplo una VPC, pasa directamente a producción sin que nadie tenga que aprobarlo. Es un servicio acotado con suficiente seguridad para ofrecerlo así.
La regla es sencilla: los cambios que respetan límites claros siguen adelante automáticamente. La revisión y la aprobación humanas se concentran en la lógica que define esos límites. Esto simplifica el proceso y multiplica el valor de cada revisión, porque modificas esa lógica con mucha menos frecuencia de la que la aplicas. Define la cobertura mínima de los controles y el impacto máximo que puede tener un cambio sin revisión. Después deja que el sistema funcione. De lo contrario, desaprovecharás parte del valor de la automatización.
La urgencia pone a prueba los modelos de aprobación. Por eso las vías de emergencia necesitan su propia gobernanza. La sección Cuando el camino está bloqueado del capítulo 11 describe dos:
- La vía de emergencia mantiene los controles automáticos y reduce el número de personas que intervienen. El responsable de guardia concede ambas aprobaciones, lo que suspende la separación de funciones solo para ese cambio. El control humano se completa a posteriori. Otro ingeniero repite la revisión de la intención el siguiente día laborable. La NAP la mantiene pendiente hasta entonces.
- El acceso mediante el Procedimiento de acceso de emergencia permite operar fuera de la NAP, por lo que sus controles también son externos. Las credenciales se guardan en una caja fuerte distinta del almacén de secretos de la IDP, ya que un fallo de esta puede dejar la NAP fuera de servicio (capítulo 12). Solo las personas designadas pueden retirarlas. Cada uso genera una alerta y deja constancia en un registro independiente que permite detectar alteraciones. Tras cada uso se rotan las credenciales y se concilia la Fuente de Verdad antes de que la NAP vuelva a actuar sobre esos dispositivos.
Cuenta los usos de ambas vías. Si un equipo recurre a la de emergencia todas las semanas, o tiene un cambio estándar que aún no reconoce como tal o su proceso de revisión es demasiado lento para su trabajo.
Las aprobaciones y los controles plasman la política vigente. Mantenerla al día también exige trabajo.
Gestión del ciclo de vida de las políticas#
Las políticas cambian. Una política de seguridad escrita para un solo centro de datos puede resultar inadecuada cuando la organización opera en tres jurisdicciones. Quizás también haya que sustituir una política de gestión de cambios anterior a la automatización que exige validar a mano cada cambio de configuración. La nueva política puede distinguir los que han superado las validaciones automáticas de los que no.
Revisa las políticas en cuatro circunstancias:
- Cambia un requisito normativo. Una versión nueva de PCI DSS, la entrada en otra jurisdicción o una obligación contractual nueva pueden exigir añadir un control o modificar su rigor.
- Aumentan los falsos positivos de un control. Si rechaza demasiados cambios legítimos, puede estar mal definido o haber dejado de ajustarse a los flujos. Revisa la definición del control. Evita enseñar a los ingenieros a sortearlo.
- Un incidente revela una carencia. Si un control existente debería haber detectado el problema, refuérzalo. Si ningún control lo cubría, añade uno.
- Llega la revisión trimestral programada. Los controles de flujos retirados son código muerto. En un motor de políticas introducen dudas sobre qué reglas se aplican realmente. Si esperas a que haya un hallazgo de auditoría o un incidente, ya llegas tarde.
Gestiona las definiciones de políticas con el mismo control de versiones y la misma disciplina de revisión que el código. Una definición de política es código: expresa una regla, la NAP la ejecuta y modificarla tiene consecuencias operativas. Una política que cambia sin revisión o que solo existe en una página de la wiki no se puede hacer cumplir desde la NAP. Prueba también las políticas como pruebas el código. Para cada una, incluye pruebas unitarias con un cambio que deba aceptar y otro que deba rechazar. Antes de que una versión nueva empiece a bloquear, ejecútala en modo informativo para registrar qué habría bloqueado.
El control de versiones dota a la propia gobernanza de un registro de auditoría. Para cualquier fecha, el equipo de cumplimiento puede consultar qué versión estaba activa y qué exigía.
Todos estos controles tienen un coste. La última cuestión es cómo conseguir que respetarlos cueste menos que eludirlos.
Cómo conseguir que aplicar los controles cueste menos que eludirlos#
Los controles de seguridad introducen pasos: superar una comprobación, obtener una credencial, pasar un control. Con veinte ejecuciones por hora, treinta segundos de evaluación de políticas por ejecución apenas se notan. Con mil ejecuciones simultáneas, determinan la capacidad de procesamiento de la NAP. Una aprobación de una hora es aceptable para tres solicitudes al día. En una actualización de firmware con trescientas solicitudes, obliga a procesarlas en serie.
La Figura 13.9 muestra lo que ocurre al aumentar el volumen. Las curvas son ilustrativas.
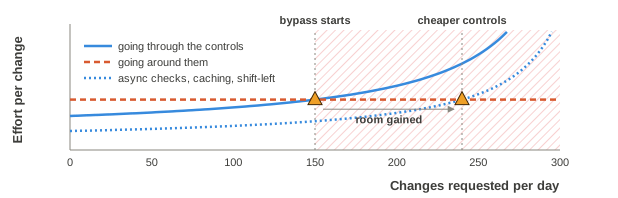
Cuando el volumen crece, la fricción incentiva los atajos. Un equipo que necesita ir más deprisa de lo que permiten los controles encontrará algún modo: desactivar una comprobación, reutilizar credenciales compartidas o aprobar en bloque sin leer. Cada atajo recupera el riesgo que el control debía eliminar. Conserva el rigor del control y reduce el coste de aplicarlo hasta que cueste menos seguirlo que evitarlo. Si el camino más fácil es eludirlo, el control ha fracasado, diga lo que diga la política.
Tres mecanismos reducen el coste y desplazan a la derecha el punto de cruce de la Figura 13.9. La Tabla 13.2 indica qué niveles aplican los dos primeros:
- Comprobaciones asíncronas y síncronas. Si un fallo debe detener el cambio, la comprobación se ejecuta de forma síncrona y bloqueante. Si solo aporta información, como un hallazgo de baja gravedad en una dependencia o un aviso de estilo en una política, se ejecuta de forma asíncrona e informa sin bloquear. Mezclar los dos tipos en una lista indiferenciada impide saber qué fallos hay que corregir ya y cuáles pueden esperar al siguiente ciclo de trabajo.
- Caché de decisiones de política. Puedes guardar en caché una política cuyo resultado sea idéntico en todas las solicitudes del mismo flujo. El TTL, es decir, su plazo de caducidad, es un parámetro de seguridad: un cambio de política puede tardar ese tiempo en llegar a todos los puntos de control. Elígelo a propósito. Evita tomar por defecto el valor más largo que reduzca los fallos de caché.
- Seguridad desde las primeras etapas (shift-left security). Cuanto antes detectes un problema, menos cuesta corregirlo. Si un control previo al commit detecta un secreto en el equipo del ingeniero, corregirlo lleva segundos. En CI ya cuesta una ejecución de la cadena. Tras el despliegue exige responder a un incidente. Empieza por las comprobaciones más rápidas y baratas: controles antes del commit para secretos e incumplimientos evidentes, controles de CI para análisis más detallados y revisión de dependencias, y controles de despliegue para validar el cumplimiento al final.
Una NAP con varias regiones añade otro coste: mantener la coherencia. Una política que solo se aplica en una región es una sugerencia en todas las demás. Define las políticas de forma centralizada en el VCS y distribúyelas a los agentes que las aplican en cada región por la misma cadena de CI/CD que cualquier artefacto de la NAP. El plazo desde el commit hasta que todos los agentes aplican la nueva versión es un parámetro de seguridad. Durante ese plazo, distintas regiones evalúan versiones distintas. Mídelo y mantenlo lo bastante corto para que el equipo de seguridad pueda determinar la exposición. Un agente con una versión desactualizada deja un hueco de seguridad silencioso.
La política decide si un cambio puede seguir adelante. Da por hecho que se despliega aquello que se revisó. Ahora comprobaremos ese supuesto.
Integridad: qué se ejecutó realmente#
Incluso un cambio autorizado y aprobado puede desplegar algo que nadie haya revisado: una plantilla modificada después de la revisión, una dependencia comprometida en la imagen del ejecutor o una etapa de construcción que haya inyectado código. Los controles de integridad cierran esa brecha. Esta sección explica de dónde proceden los artefactos de la NAP, qué comprobaciones añade el ciclo de vida de desarrollo seguro a la cadena de construcción y cómo el patrón Cadena de procedencia reúne toda esa información en un único registro.
No puedes confiar en el código que no hayas creado tú por completo.
Ken Thompson
Nadie escribe todas y cada una de las líneas de la NAP, así que los controles de integridad te permiten confiar en el código que no has escrito. Los propios artefactos de la NAP forman una cadena de suministro de la que depende la seguridad. Una plantilla de configuración genera la configuración de red mediante un motor de plantillas y una fuente de datos. Si cualquiera de los dos se ve comprometido, la configuración generada también lo estará. La imagen de un contenedor que ejecuta el flujo de trabajo de automatización contiene una imagen base, un conjunto de paquetes instalados y el código del flujo de trabajo. Si la imagen base tiene una vulnerabilidad conocida, cada ejecución del flujo de trabajo en ese contenedor queda expuesta a ella.
El ataque a SolarWinds (2020) es un caso conocido de ataque a gran escala contra la integridad de una cadena de suministro. Los atacantes modificaron el sistema de construcción que generaba el software Orion de SolarWinds e introdujeron una puerta trasera en actualizaciones de software legítimas y firmadas que después se distribuyeron a unos 18 000 clientes. El artefacto estaba firmado, superó las comprobaciones de integridad y se entregó a través de un canal oficial de actualizaciones. Los atacantes habían comprometido el proceso de construcción, antes de todas las verificaciones que realizaban los clientes. Una NAP que firma sus artefactos pero no verifica la integridad del entorno de construcción que los generó presenta la misma superficie de ataque.
Ambas plataformas tienen una cadena de suministro. La IDP construye el software de la NAP: sus imágenes y paquetes. La NAP genera los artefactos de configuración de red. Los mecanismos que se describen a continuación se aplican a ambas. El almacén de artefactos y su servicio de firma suelen pertenecer a la IDP. A la NAP le corresponde firmar los artefactos de configuración que genera y verificarlos antes del despliegue.
Se aplican tres líneas de defensa:
Firma de código: cada artefacto que consume la NAP lleva una firma criptográfica que demuestra que lo produjo una identidad concreta y que no se ha modificado desde entonces. Si una plantilla se modifica después de la firma, ya sea por una actualización legítima que no se volvió a firmar o por un cambio malicioso, no supera la verificación y no se utiliza.
Procedencia: cada artefacto lleva un registro que indica de dónde procede, cuándo se generó y qué proceso lo produjo. Cuando un artefacto pasa al estado de aprobado para producción, puedes rastrear su origen hasta el commit o el cambio en la Fuente de Verdad que dio lugar a su creación. También puedes identificar la ejecución del flujo de trabajo que lo generó, las etapas de validación que superó y la persona que aprobó su promoción.
El análisis de dependencias se ejecuta junto con las demás comprobaciones de desarrollo que se describen en la siguiente sección.
El marco de referencia del sector para la firma y la procedencia es SLSA (Supply Chain Levels for Software Artifacts), una especificación abierta desarrollada originalmente en Google. Define niveles de integridad de la cadena de suministro que van desde una construcción documentada que genera un registro de procedencia hasta construcciones herméticas y reproducibles con procedencia verificada.
En una NAP se aplica dos veces: al software de la propia NAP, que construyen las cadenas de la IDP, y a cada artefacto de cambio, que genera una ejecución del flujo de trabajo de cambio. El nivel 2 de SLSA es un objetivo práctico en ambos casos. Un servicio alojado, una cadena de procesamiento o el Orquestador genera el artefacto y una declaración firmada de su procedencia. Así puedes verificar que procede del proceso y de la fuente declarados. Utiliza el formato de declaración de SLSA como lista de comprobación del contenido que debe tener tu registro de procedencia, sea cual sea la herramienta que lo genere.
La firma y la procedencia protegen los artefactos. El código que los genera necesita sus propias comprobaciones.
SSDLC para la automatización#
El propio código de automatización necesita el mismo ciclo de vida de desarrollo seguro que cualquier software que opere en un entorno sensible. El ciclo de vida de desarrollo seguro de software (SSDLC) aplicado a la automatización añade cuatro comprobaciones. Todas se ejecutan antes de promover cualquier artefacto. Las tres primeras se ejecutan en la cadena de CI que construye el código de automatización. La última se ejecuta en el flujo de trabajo de cambio, sobre la configuración generada a partir de plantillas:
Detección de secretos: se analiza cada commit en busca de patrones que indiquen la presencia de credenciales, como claves de API, contraseñas, claves privadas o tokens. Una coincidencia bloquea la construcción del artefacto hasta que se elimina el secreto y se limpia el historial. Un secreto registrado en el VCS es visible para cualquiera que tenga acceso al repositorio y permanece en el historial después de corregir el archivo. Herramientas como TruffleHog y detect-secrets se ejecutan como hooks de pre-commit o como pasos de CI.
Análisis estático: se examina el código de automatización sin ejecutarlo para detectar patrones problemáticos conocidos, como una plantilla que genere una ACL con comodines o un script vulnerable a la inyección de código. En Python, bandit cubre los casos habituales en segundos. En la automatización de redes hay un riesgo adicional que las herramientas de propósito general pasan por alto: la inyección en plantillas Jinja2. Un valor mal formado en la SoT puede romper la estructura de una plantilla y permitir accesos no previstos, así que comprueba que se imponen restricciones cada vez que se inserta una variable:
{{ data.vlan_id | int }}fuerza la conversión a entero, mientras que{{ data.description }}inserta la cadena tal cual.Análisis de dependencias: se contrasta cada paquete, colección y biblioteca con bases de datos de vulnerabilidades. Un CVE de gravedad alta bloquea el proceso. Los hallazgos de menor gravedad son informativos. Dependabot y Renovate automatizan esta tarea: supervisan los manifiestos de dependencias y abren solicitudes de incorporación de cambios cuando una dependencia tiene una vulnerabilidad conocida, dentro del flujo habitual de revisión de código. Una dependencia que era segura cuando se escribió el flujo de trabajo puede tener una vulnerabilidad conocida seis meses después, por lo que el análisis se ejecuta tanto durante la construcción como de forma periódica.
Validación previa al despliegue: antes de que el artefacto pase al estado de aprobado para producción, una última comprobación valida la configuración generada a partir de plantillas frente al esquema de la política de seguridad. Una regla de cortafuegos que permita el tráfico desde cualquier origen a cualquier destino infringe la política aunque la plantilla la haya generado correctamente a partir de los datos de la SoT que la solicitaban.
Las comprobaciones del SSDLC constituyen el tercer pilar de las pruebas. No sustituyen las pruebas funcionales del capítulo 11 ni las pruebas de resiliencia del capítulo 12. Detectan lo que esas pruebas pasan por alto: un secreto registrado en el VCS, una ACL con comodines que la plantilla genera correctamente o una dependencia con un CVE conocido.
Cada una de estas comprobaciones produce un resultado. El siguiente patrón reúne esos resultados en un único registro.
El patrón Cadena de procedencia#
Sin una cadena de procedencia, la laguna que ilustra el relato inicial es inevitable: la NAP puede dejar constancia de que se hicieron cambios, pero no de la cadena de autorización, validación y promoción que los precedió.
El patrón Cadena de procedencia reúne todos los mecanismos de la cadena de suministro y de validación en un único registro trazable. Cada artefacto que la NAP conserva en el almacén de artefactos tiene un registro de procedencia que responde a cuatro preguntas: ¿quién lo generó, cuándo, a partir de qué entradas y mediante qué proceso?
La idea procede de las declaraciones de conformidad de la cadena de suministro de software y aquí se aplica a los cambios de red. in-toto, un proyecto que ha alcanzado el nivel de graduado en la CNCF, registra cada paso de una cadena de suministro de software en forma de metadatos firmados y verifica toda la cadena antes de la instalación. SLSA define qué información de procedencia debe generar cada construcción. La NAP añade la parte correspondiente a la red: las aprobaciones, el resultado del despliegue y el vínculo con la configuración en ejecución en el dispositivo.
En el caso del cambio en el cortafuegos, la cadena es la siguiente. La solicitud de la persona responsable del cambio se convierte en una propuesta en la Fuente de Verdad. El martes, otra persona del equipo de ingeniería revisa la intención e integra la propuesta. La integración desencadena una ejecución del flujo de trabajo de cambio que genera la regla a partir de la plantilla, ejecuta los controles de validación y la simulación, y firma el artefacto con la identidad del ejecutor.
El registro de procedencia recoge la propuesta, quién la solicitó, quién la revisó, el ID de la ejecución y cada control superado, con sus marcas de tiempo. El sábado, una segunda persona del equipo de ingeniería aprueba el despliegue justo antes de la ventana de cambio. Al registro se añaden la identidad de quien lo aprobó, el ticket y la hora. A continuación, cada oleada añade el dispositivo y su resultado: primero la unidad en espera y después la activa.
La cadena se lee en sentido inverso, desde el dispositivo hasta la solicitud, y cada eslabón responde a una de las preguntas de auditoría. La Figura 13.10 muestra cómo se lee.
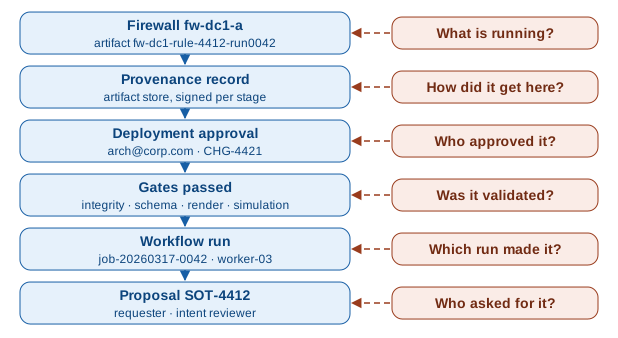
El campo clave del registro es el ID del artefacto que se escribe en la configuración del dispositivo durante el despliegue, por ejemplo fw-dc1-rule-4412-run0042: vincula el dispositivo con todo lo demás. Ese ID suele figurar en un comentario estructurado de la configuración generada (por ejemplo, ! artifact: fw-dc1-rule-4412-run0042 en sintaxis de tipo IOS), en un campo de descripción de una interfaz de gestión o en un evento de syslog que se emite durante el despliegue y que el sistema de auditoría correlaciona.
El mecanismo depende de lo que admita el sistema operativo del dispositivo. El requisito es siempre el mismo. Puedes consultar el ID del artefacto actual de cualquier dispositivo del parque y utilizarlo para recuperar el registro completo del almacén de artefactos. Esa es la consulta que el equipo de auditoría PCI necesitaba hacer y no pudo ejecutar: «Muéstrame todos los cambios realizados en fw-dc1-a en los últimos seis meses, quién autorizó cada uno y qué validación superó».
El registro no necesita un formato complejo. Cada etapa de la ejecución añade su entrada (el nombre de la etapa, una marca de tiempo, el hash del artefacto antes y después de la etapa y la identidad que la ejecutó) y firma el registro acumulado antes de que empiece la siguiente etapa. Basta con una lista plana de entradas por etapa y una cadena de firmas.
La integridad garantiza que la NAP despliegue lo que ha validado. Las evidencias te permiten demostrárselo más adelante a alguien que no estaba allí.
Evidencias: cómo demostrarlo#
Las evidencias convierten todo lo anterior en respuestas. Esta sección explica qué requisitos debe cumplir un registro de auditoría, cómo lo vincula el mapa de cumplimiento con una norma y en qué consiste el cumplimiento continuo: demostrar que la red sigue ajustándose a lo aprobado mucho después del cambio.
Todos los datos necesarios para aclarar la laguna del relato inicial estaban disponibles: los registros de los dispositivos, los registros de los flujos de trabajo, el estado de la Fuente de Verdad y los tickets. Nada los relacionaba entre sí, y relacionarlos a mano llevó tres semanas.
La auditabilidad no es lo mismo que el registro de eventos. Al registrar eventos se deja constancia de cada uno por separado, y la auditabilidad genera registros que puede correlacionar, consultar e interpretar alguien que no estaba presente cuando ocurrieron los eventos.
El registro de auditoría de cada acción de automatización debe cumplir tres requisitos:
Permitir detectar manipulaciones: cualquier modificación posterior del registro debe poder detectarse. Esto se consigue con almacenamiento de escritura única y comprobaciones criptográficas de integridad (se firma cada registro o se incorpora su hash a una cadena). Un registro de auditoría que también pueden modificar quienes administran las configuraciones de los dispositivos no es fiable.
Ser completo: no debe haber lagunas. Queda constancia de cada cambio que realiza la NAP. También de cada decisión de aprobación y de cada evaluación de un control de políticas. Quien audite una fecha concreta encontrará una relación completa de todas las acciones de automatización de ese día.
Admitir consultas: el registro responde a preguntas concretas. ¿Qué ha cambiado en el dispositivo X en los últimos 90 días? ¿Qué flujos de trabajo se han ejecutado con autorización de la persona Y en los últimos 30 días? ¿En qué estado se encontraba la sede Z en el instante indicado por una marca de tiempo concreta? Son consultas forenses y la infraestructura de auditoría debe responderlas.
El registro de la cadena de procedencia materializa los tres requisitos: está firmado, solo admite adiciones, existe para cada cambio automatizado y puede consultarse por ID de ejecución, dispositivo, solicitante o intervalo de tiempo. Un equipo que cree un registro de auditoría desde cero debería empezar por ahí, con las tres propiedades como criterios de aceptación.
Envía los registros de auditoría y las alertas de seguridad de la NAP al SIEM (sistema de gestión de información y eventos de seguridad) del equipo de seguridad. Así, la retirada de una credencial de emergencia o una verificación de firma fallida aparece junto a los demás eventos de seguridad, no solo en los paneles del equipo de automatización de redes.
Con el registro de auditoría en marcha, la petición del equipo auditor se resuelve con una consulta en lugar de una investigación de tres semanas. Para cada uno de los 847 cambios, el equipo auditor quiere conocer la identidad que lo autorizó, el ticket, las pruebas de validación y el estado anterior y posterior. Basta una consulta, como artifact-store query --device-group firewall --since 2025-07-01 --include provenance.
Devuelve 847 registros, cada uno con el ID de ejecución, el solicitante, el ticket, el resultado de la simulación, la persona que dio la aprobación, el resultado del cambio y el artefacto que permite rastrearlo hasta su solicitud. La instantánea previa al cambio del capítulo 11 muestra «el estado anterior», y la verificación posterior al cambio muestra «el estado posterior». La auditoría que exigió tres semanas de trabajo de seis profesionales de ingeniería ahora se completa en una tarde.
Existen soluciones listas para usar con registros que permiten detectar manipulaciones. Rekor de Sigstore y Trillian conservan registros firmados en un árbol de Merkle que solo admite adiciones y en el que puede detectarse cualquier modificación. El almacenamiento de objetos de escritura única (WORM), como S3 Object Lock o MinIO, es más sencillo, aunque su interfaz de consulta es más limitada.
El registro de auditoría responde a las preguntas de quien realiza la auditoría. El mapa de cumplimiento le indica qué preguntas debe hacer.
Mapa de cumplimiento#
La mayoría de los equipos no documenta la correspondencia entre los requisitos de una norma y su implementación en la NAP. Los controles existen: controles de simulación, flujos de aprobación, análisis de dependencias y registros de auditoría. Pero el equipo auditor no dispone de ningún documento que indique que, para el código de automatización, el control de análisis de dependencias en CI da cumplimiento al «requisito 6.3.3 de PCI: proteger todos los componentes del sistema frente a vulnerabilidades conocidas».
El mapa de cumplimiento cubre esa laguna. Para cada control normativo aplicable, indica qué función, control de paso o registro de la NAP lo implementa, dónde se encuentran las pruebas y quién se encarga de su mantenimiento. Es un documento vivo, que se actualiza cuando cambian los controles, la NAP o la normativa. El equipo auditor lee el mapa, examina las pruebas en la ubicación indicada y confirma o cuestiona la implementación. Así, la auditoría es abordable. Pedir al equipo auditor que lea el código de la NAP y deduzca qué controles implementa no lo es.
La Tabla 13.3 muestra el formato con una sola entrada:
| Campo | Valor |
|---|---|
| Control | Requisito 6.5.1 de PCI DSS v4.0 |
| Requisito | Los cambios en los componentes de los sistemas de producción siguen procedimientos documentados: motivo, impacto en la seguridad, aprobación por las partes autorizadas y pruebas |
| Implementación en la NAP | En cada cambio constan la identidad del solicitante (Identidad: quién actúa) y un ticket aprobado (Controles y aprobaciones). La cadena de procedencia registra los controles superados y quién dio la aprobación (El patrón Cadena de procedencia) |
| Ubicación de las pruebas | artifact-store query --device-group cde --include provenance devuelve todos los cambios con el solicitante, el ticket, los controles superados y la persona que dio la aprobación |
| Responsables | Equipo de automatización de redes (arquitectura del registro de auditoría) y equipo de seguridad (revisión trimestral) |
| Frecuencia de revisión | Extracción trimestral para presentar los datos en la auditoría y alertas continuas si algún registro de cambio carece de una entrada de procedencia |
La ubicación de las pruebas se expresa mediante una consulta ejecutable, no mediante una descripción de dónde buscar (esta distinción es fundamental). Quien pueda ejecutar la consulta y leer el resultado puede realizar la auditoría sin que esté presente el equipo de automatización de redes. Sin esa consulta, cada auditoría se convierte en un proceso manual y complejo en lugar de consistir en una serie de consultas que el equipo auditor puede ejecutar por su cuenta.
El registro de auditoría y el mapa demuestran qué ocurrió en el momento de cada cambio. El cumplimiento también debe mantenerse entre cambios.
Cumplimiento continuo y corrección de desviaciones#
El capítulo 16 desarrolla el bucle cerrado completo para tratar las desviaciones: compara la configuración en ejecución y el estado de las rutas con la intención y decide si procede conciliar el estado o emitir una alerta. Esta sección aborda la desviación como problema de seguridad y presenta la regla que determina cuándo puede corregirla la automatización por sí sola.
La Desviación de la configuración es la divergencia gradual entre el estado deseado registrado en la SoT y el estado real de la red en funcionamiento. La provocan los cambios manuales realizados fuera de la NAP, las reversiones que no llegaron a completarse y los dispositivos cuyo comportamiento difiere del previsto en una ejecución de automatización.
La desviación es un problema tanto de seguridad como de operación. La postura de seguridad de la red solo está garantizada en la medida en que la configuración en ejecución coincida con el estado autorizado registrado en la SoT y conforme a las políticas. En cuanto el dispositivo se aparta del diseño de una regla de cortafuegos concebida para permitir un tráfico concreto, deja de saberse qué permite esa regla. Puede que la lista de control de acceso que se revisó y aprobó ya no sea la que controla el acceso. No puedes afirmar que la red mantiene una postura de seguridad que no puedes verificar.
En el capítulo 11 se comprueba si hay desviaciones antes de cada oleada de un cambio. El cumplimiento continuo cubre los intervalos entre oleadas: el bloque de Observabilidad compara periódicamente el estado en ejecución con el estado deseado. Cuando detecta una desviación, la NAP elige entre dos opciones según el tipo de política. Como muestra la Figura 13.11, dos preguntas determinan la decisión: ¿afectaría al tráfico restablecer el estado deseado? ¿Podría alguien haber hecho el cambio a propósito?
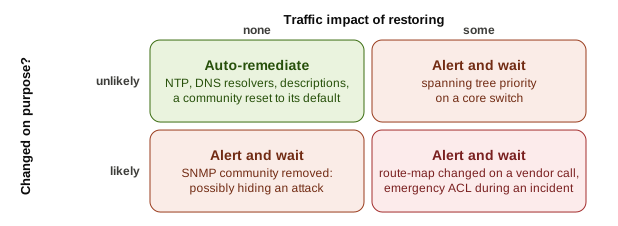
De la matriz se desprenden dos opciones:
Corrección automática: restablece el estado deseado sin intervención humana. Úsala cuando el restablecimiento no afecte al tráfico y sea poco probable que alguien haya modificado el estado a propósito: servidores Network Time Protocol (NTP), resolvedores DNS, descripciones de interfaces y cadenas de comunidad SNMP que hayan vuelto al valor predeterminado del fabricante. Si una cadena de comunidad se ha eliminado por completo, el caso es distinto: su eliminación puede indicar que un atacante está desactivando la monitorización, así que emite una alerta. La corrección automática exige un alto grado de confianza en la definición de la política, porque aplicar una política obsoleta o errónea para corregir una desviación aleja aún más al dispositivo del estado correcto.
Alerta y espera: avisa al equipo de operaciones y espera a que una persona tome la decisión. Usa esta opción para todo lo que afecte al plano de reenvío o que alguien haya podido modificar a propósito fuera de la NAP. Puede que durante una llamada al servicio de soporte del fabricante se haya modificado un mapa de rutas BGP para resolver un problema en curso. Revertir el cambio haría que el problema reapareciera. Una ACL de un cortafuegos puede incluir un cambio de emergencia realizado durante un incidente. Revertir la prioridad del árbol de expansión en un conmutador de núcleo sin comprender la topología puede desencadenar una reconvergencia. La contrapartida es el tiempo de respuesta.
Una NAP que corrige automáticamente todas las desviaciones por igual acabará restableciendo una configuración que se había modificado por un motivo que la plataforma desconocía.
La validez de las pruebas presupone que se puede confiar en el sistema que las genera. La última sección explica qué hacer cuando no se puede confiar en él.
Respuesta: cuando algo sale mal#
Los incidentes de seguridad ocurren. En dos tipos de incidentes interviene la NAP: aquellos en los que la NAP debe ayudar a contener una intrusión y aquellos en los que se ve comprometida la propia NAP. El primer caso requiere contención automatizada. El segundo requiere un procedimiento operativo redactado antes de que ocurra el incidente.
Cuando la NAP está implicada en un incidente, el tiempo de respuesta importa. Si no se revoca de inmediato una credencial comprometida de un flujo de trabajo, se pueden seguir realizando cambios con ella. Si un dispositivo aislado por el equipo de seguridad sigue recibiendo actualizaciones automatizadas, las recibe de un proceso que podría estar comprometido.
La NAP debería poder ejecutar tres acciones de contención sin intervención humana en respuesta a un evento de seguridad:
Revocación de credenciales: se revocan de inmediato todas las credenciales activas asociadas a una ejecución comprometida, a una cuenta de servicio comprometida o a una identidad marcada como sospechosa. Se pone fin a las ejecuciones que usan esas credenciales y se rechaza toda nueva ejecución que solicite esa identidad hasta que se resuelva el incidente.
Aislamiento del dispositivo respecto de la automatización: si se marca un dispositivo durante un incidente, se retira de todas las colas de flujos de trabajo, se marca como no disponible para nuevas ejecuciones y se rotan sus credenciales de gestión. El dispositivo no se da de baja. Se pone en cuarentena, fuera del alcance de la NAP, hasta que en la revisión del incidente se decida restablecer el acceso.
Reversión automatizada: si una ejecución comprometida ha introducido cambios, pero la propia NAP sigue intacta, la NAP vuelve a la última configuración que se sabe que era correcta. La reversión utiliza la Cadena de procedencia para localizar el último estado anterior al incidente y aplicarlo mediante una ejecución aislada y verificada. Cuando no está claro cuánto tiempo duró el compromiso, como en un ataque a la cadena de suministro que avanza poco a poco durante semanas, la Cadena de procedencia aporta el historial en el que basar el análisis. Aun así, ningún sistema automatizado puede elegir por sí solo el estado al que conviene volver: primero hay que delimitar el incidente mediante un análisis forense humano. Si las sospechas recaen sobre la NAP o sobre la IDP que la sustenta, detén primero toda la automatización y efectúa la reversión mediante el procedimiento de acceso de emergencia, sin pasar por la NAP.
Cada acción de contención también avisa a dos equipos a la vez: el de automatización de redes, que conoce la NAP, y el de seguridad, que dirige la respuesta al incidente. La Figura 13.12 muestra la secuencia.
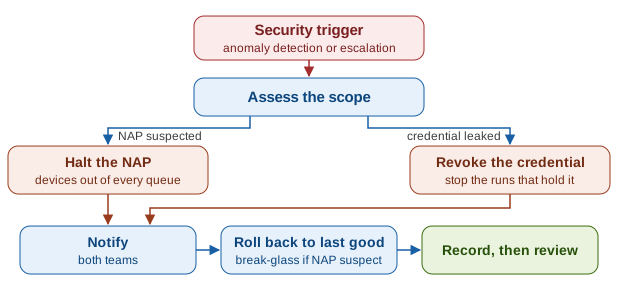
La contención parte del supuesto de que se puede confiar en la NAP para responder al incidente. A veces, el componente comprometido es la propia NAP.
Procedimientos operativos para cuando la NAP se ve comprometida#
¿Quién vigilará a los propios vigilantes?
Juvenal
La NAP vigila la red. Esta sección trata de quién vigila la NAP. El incidente más difícil de afrontar para una NAP es aquel en el que la propia plataforma es el componente comprometido. La superficie de ataque de una red abarca los dispositivos y las conexiones del plano de gestión con esos dispositivos. La superficie de ataque de una NAP incluye todo lo anterior, además del Orquestador, el almacén de artefactos, el almacén de secretos, los agentes de ejecución de la cadena de despliegue y todas las definiciones de flujos de trabajo del repositorio del VCS. Tres de esos componentes pertenecen a la IDP, así que redacta el procedimiento operativo con el equipo de productividad de desarrollo.
Un Orquestador comprometido puede programar ejecuciones no autorizadas. Un almacén de artefactos comprometido puede servir artefactos modificados que parecen legítimos, pero contienen puertas traseras. Un agente de ejecución comprometido puede interceptar credenciales durante una ejecución de la cadena de despliegue y exfiltrarlas. Ninguno de estos casos presenta indicios evidentes en las operaciones de red: la NAP parece funcionar y los cambios parecen aplicarse correctamente.
No sabes cuándo lo necesitarás, pero el procedimiento operativo para cuando la NAP se vea comprometida debe estar listo antes del incidente. Abarca cuatro fases:
Detección: ¿cómo confirma el equipo de automatización de redes que el compromiso afecta a la NAP o a la IDP que la sustenta y no solo a un sistema sobre el que actúan? Entre los indicios se encuentran las ejecuciones que no corresponden a ninguna solicitud registrada, los artefactos que carecen de cadena de procedencia o cuya cadena no supera la verificación de firmas, las credenciales emitidas a identidades de flujos de trabajo que no están en ejecución y los cambios en dispositivos que no figuran en el registro de auditoría.
Contención: detén de inmediato todas las operaciones de la NAP. Especifica de antemano en el procedimiento quién tiene autoridad para hacerlo: en pleno incidente, la decisión no puede esperar a que se reúna un comité. En la mayoría de las organizaciones, detener la NAP requiere autorización a nivel de CISO o de vicepresidencia, así que el procedimiento identifica a la persona autorizada de antemano para tomar la decisión a cualquier hora y señala a quién recurrir si no se la puede localizar. Revoca todas las credenciales activas de la NAP. Bloquea las escrituras en el almacén de artefactos. Antes de tocar nada más, conserva el registro de auditoría, el registro de cada ejecución y los registros de la cadena de despliegue de la IDP: la investigación depende de ellos.
Preservación de evidencias: antes de restaurar, borrar o reconstruir cualquier componente comprometido, captura su estado para el análisis forense. Si reconstruyes un agente de ejecución que se utilizó para exfiltrar credenciales, pierdes el estado de la memoria y del sistema de archivos que necesita la investigación. La contención y la preservación de evidencias se llevan a cabo en paralelo, sin esperar a que termine una para iniciar la otra.
Recuperación: restaura cada componente a partir de un estado que se sepa correcto. Empieza por el almacén de secretos, el almacén de artefactos y los agentes de ejecución de la cadena de despliegue de la IDP, en ese orden, y continúa con los componentes de la propia NAP. Renueva todas las credenciales de la NAP en el orden que marcan sus dependencias. Antes de volver a habilitar los despliegues en producción, verifica de nuevo cada artefacto del almacén cotejándolo con su cadena de procedencia. La recuperación termina cuando una ejecución completa de un flujo de trabajo de cambio a través de la NAP restaurada genera un registro de auditoría sin anomalías que el equipo de seguridad puede verificar.
Un equipo que carezca de este procedimiento tendrá que redactarlo durante el incidente, el peor momento para pensar con claridad en los límites de seguridad de la NAP. Redacta ahora una versión básica. Una sola página de instrucciones ayuda a tu equipo a actuar con decisión cuando hace falta.
Hasta aquí he explicado el modelo completo, pero pocos equipos pueden implantarlo de una sola vez, así que ahora te ayudaré a empezar por los componentes fundamentales.
La postura de seguridad mínima viable#
Ya conoces la arquitectura de seguridad completa. Si tu NAP ya despliega cambios, ¿por dónde empiezas? Por las cinco etapas de la Figura 13.13. Cuatro se implementan en la NAP. Una, la eliminación de las credenciales estáticas, corresponde a la IDP. Cada una subsana una carencia que puso de manifiesto el caso del inicio del capítulo. Siempre que puedas, sigue este orden.
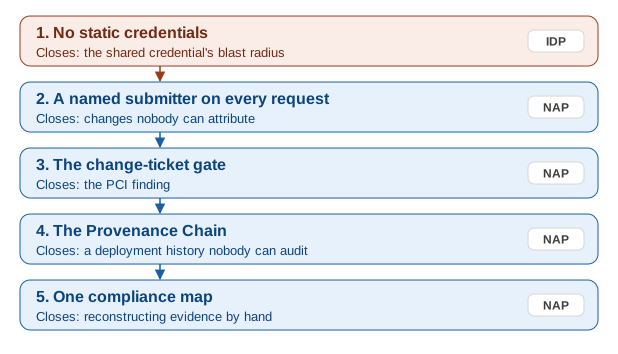
Sin credenciales estáticas (IDP). Ni la configuración de los agentes de ejecución de la cadena de despliegue o de los procesos de trabajo del Orquestador, ni las variables de entorno, ni los repositorios contienen claves de API, tokens o contraseñas. Cada ejecución obtiene su credencial del almacén de secretos de la IDP. Sobre esta base se apoyan los controles por ejecución: una NAP que utiliza una única credencial estática compartida no puede limitar el alcance de las credenciales a cada ejecución, revocarlas de forma selectiva ni generar un registro de auditoría que permita distinguir una ejecución de otra. Esta etapa termina cuando una auditoría completa de la configuración de los agentes de ejecución de la cadena de despliegue, los almacenes de variables de entorno y el historial del VCS no encuentra ningún dato que forme parte de una credencial.
Cada solicitud identifica a quien la presenta (NAP). Cada solicitud incluye una identidad nominal y autenticada. La NAP rechaza cualquier solicitud que carezca de ella, sea cual sea su contenido. Sin este control, el registro de auditoría deja constancia de que se hizo un cambio, pero no de quién lo solicitó, y el hallazgo de PCI queda abierto: en el origen de la cadena de autorización debe figurar una persona identificada por su nombre. Para una solicitud
standard, basta con identificar a quien la presenta para darla por aprobada, porque la política que la clasificó ya la aprobó de antemano. Esta etapa termina cuando el registro de auditoría de cada solicitud incluye la identidad autenticada de quien la presentó y ninguna ejecución puede iniciarse sin ella.El control del ticket de cambio (NAP). El control descrito en Controles y aprobaciones pasa a ser obligatorio: ningún despliegue en producción puede continuar sin un ticket válido y aprobado por alguien distinto de quien presentó la solicitud. Para una solicitud
standard, el ticket es el del cambio estándar que la propia NAP abre y cierra. Si este control hubiera existido para los 847 cambios del cortafuegos, cada registro habría incluido automáticamente la referencia del ticket y la identidad de quien lo aprobó, y el hallazgo se habría cerrado. Para responder al equipo auditor con una sola consulta hace falta la etapa 4. Esta etapa termina cuando a cada despliegue en producción del registro de auditoría le corresponde un ticket aprobado que la NAP puede verificar sin que nadie tenga que cruzar datos entre sistemas a mano.La Cadena de procedencia (NAP). Cada artefacto que obtiene la aprobación para producción lleva un registro de procedencia firmado en el que constan la solicitud, las etapas superadas, la identidad de quien lo aprobó y el resultado del despliegue. Cada configuración desplegada en un dispositivo lleva el ID de su artefacto. Con esta cadena, la petición del equipo auditor se resuelve con una sola consulta. Esta etapa termina cuando se puede consultar cualquier dispositivo del parque para obtener el ID de su artefacto actual y ese ID permite recuperar del almacén de artefactos la cadena de autorización completa sin tener que cruzar más datos.
Un mapa de cumplimiento (NAP). Las etapas 1 a 4 establecen los controles. El mapa de cumplimiento los vincula con la normativa aplicable a la organización. Empieza por elaborar el mapa para un solo marco: PCI DSS, SOC 2 o NIST CSF. Si no te corresponde aplicar ninguna normativa, empieza por NIST CSF: es el que menos depende de un marco concreto, el que se corresponde más directamente con los controles de este capítulo, y tanto PCI DSS como SOC 2 parten de bases similares. Escribe las consultas que permitan al equipo auditor obtener las evidencias sin ayuda del equipo de automatización de redes. Esta etapa termina cuando una persona externa que realice la auditoría puede reproducir todas las evidencias de los controles de un marco utilizando únicamente el mapa de cumplimiento y la interfaz de consulta de la NAP.
Tres referencias externas sirven de punto de partida para implantar o auditar esta postura de seguridad. OWASP Top 10 CI/CD Security Risks se corresponde directamente con las superficies de ataque que presenta una NAP y describe, en términos que permiten al equipo de ingeniería actuar de inmediato, la inyección en la cadena de despliegue, los controles insuficientes sobre las credenciales, la configuración insegura de los sistemas y los riesgos de la cadena de suministro. CIS Controls v8 propone un orden de implantación por prioridad para un conjunto más amplio de controles, con grupos de implementación que permiten a un equipo pequeño empezar por los controles de mayor impacto. NIST Cybersecurity Framework aporta el vocabulario para comunicar la postura de seguridad de la NAP a la dirección y al equipo auditor. La lista de OWASP indica por dónde empezar, CIS Controls ayuda a ordenar el trabajo y NIST CSF indica cómo informar sobre él.
Si tu organización debe cumplir un marco concreto, la etapa 5 es obligatoria. En caso contrario, utiliza un marco como referencia en lugar de tratarlo como un requisito. Quienes redactaron PCI DSS, SOC 2 y NIST CSF dedicaron años a determinar qué caracteriza a unos controles sólidos. Utilizar uno de estos marcos como lista de comprobación, incluso sin una auditoría externa a la vista, permite subsanar lagunas en el análisis que pasarán inadvertidas a un equipo que elabore desde cero su propio inventario de controles. El valor de un marco reside menos en el certificado que en recordarte algo evidente que se te había pasado por alto.
La arquitectura completa va más allá de estas cinco etapas: incluye ABAC para imponer restricciones que dependen del contexto, análisis de seguridad en el SSDLC, playbooks de respuesta a incidentes y aplicación distribuida de políticas. Pero una NAP que haya alcanzado la etapa 3 ya resuelve el hallazgo del caso inicial, porque en cada uno de los 847 cambios constan la referencia del ticket y la identidad de quien lo aprobó. En la etapa 5, la NAP está lista para su primera auditoría externa sin tener que reconstruir las evidencias de urgencia.
Resumen#
La NAP ya está construida y se adapta a escenarios complejos. Pero ¿puedes confiar en ella desde el punto de vista de la seguridad y la gobernanza? O, dicho de otro modo, ¿puedes demostrarlo (la pregunta típica de una auditoría)?
La base es una IDP segura que gestiona adecuadamente las credenciales y los artefactos. La NAP se apoya en esa gestión y la adapta al entorno de red mediante una Cadena de procedencia clara.
A continuación, las operaciones de seguridad comienzan por identificar la solicitud (quién la formuló, quién la revisó y quién la aprobó) y asignarle el nivel de riesgo que le corresponde para actuar en consecuencia.
A menudo se pasa por alto la seguridad al diseñar la NAP, e incorporarla después resulta costoso. Intégrala desde el principio y establece una postura de seguridad mínima viable que te dé una base sólida para seguir avanzando. Merece la pena y, llegado el momento, podrás presentar pruebas.
Con una NAP sólida, fiable y digna de confianza, la parte 4 centra la atención en las personas que la rodean.
Referencias#
- Securing DevOps, Julien Vehent (Manning, 2018). Seguridad en las cadenas de CI/CD: secretos, registros de auditoría y análisis de dependencias.
- Zero Trust Networks, Evan Gilman y Doug Barth (O’Reilly, 2017). La seguridad basada en la identidad, el modelo en el que se basa la sección Identidad: quién actúa.
- Security Engineering, 3rd Edition, Ross Anderson (Wiley, 2020). Principio de mínimo privilegio, separación de funciones y registros de auditoría. (Texto completo de acceso gratuito en línea.)
- The Phoenix Project, Gene Kim, Kevin Behr y George Spafford (IT Revolution, 2013). Explica cómo una gobernanza que pone trabas lleva a eludir los controles y cómo surgen así los atajos que el diseño propuesto en este capítulo evita.
- Investments Unlimited, Helen Beal, Bill Bensing, Jason Cox, et al. (IT Revolution, 2022). Una novela sobre la auditoría y el cumplimiento normativo como formas de gobernanza automatizada.
- in-toto: Providing farm-to-table guarantees for bits and bytes, Santiago Torres-Arias, Hammad Afzali, Trishank Karthik Kuppusamy, Reza Curtmola y Justin Cappos (USENIX Security Symposium, 2019). El artículo que fundamenta in-toto y que, junto con SLSA, sirve de base al patrón Cadena de procedencia. (Texto completo de acceso gratuito en línea.)
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo