Escalabilidad y fiabilidad#
El equipo de redes dedicó tres semanas a planificar una actualización de firmware de gran envergadura: 800 conmutadores de campus (de tres fabricantes distintos) en una ventana de mantenimiento de 00:00 a 06:00.
El equipo contaba con una plataforma de automatización de redes (NAP) de eficacia probada, con la que ya había realizado actualizaciones similares (aunque de menor envergadura). Para acelerar el proceso, configuró 48 procesos de trabajo para ejecutar las tareas de actualización en paralelo.
Tal como estaba previsto, la automatización se puso en marcha a las 00:00. A las 03:20 ya habían terminado 47 de los 48 procesos de trabajo: 787 conmutadores se habían actualizado correctamente. Ya casi podían irse a dormir. Sin embargo, un proceso de trabajo seguía en ejecución… En el Orquestador figuraba como activo y no había saltado ningún error, así que aún quedaba esperanza. Pero el problema era sutil. Uno de los dispositivos no respondía a los comandos de gestión, pero tampoco había rechazado la conexión de forma explícita. Por tanto, el proceso de trabajo seguía a la espera de que la conexión se estableciera o fallara.
Un solo dispositivo bloqueaba por completo un proceso de trabajo. Los demás dispositivos asignados a ese proceso seguían en la cola, a la espera de su turno, sin que el equipo de redes pudiera verlo. No se supervisaba la longitud de la cola del proceso ni había ninguna alerta (no era raro tener que esperar a que algunos dispositivos terminaran).
Cuando la ventana de mantenimiento llegó a su fin a las 06:00, se canceló la tarea. Doce dispositivos seguían con la versión anterior del firmware sin que siquiera se hubiera intentado actualizarlos, porque un dispositivo que no respondía había bloqueado el proceso de trabajo que tenían asignado. El día siguiente se dedicó al diagnóstico. El equipo intentó averiguar qué le ocurría al dispositivo que fallaba y, sobre todo, por qué también había fallado la actualización de los demás dispositivos si no compartían ninguna característica con él. No estaba claro que todos tuvieran asignado el mismo proceso de trabajo y, como el fallo era distribuido, resolverlo exigía correlacionar datos de distintas fuentes que nunca se habían consultado conjuntamente.
Todo seguía en marcha: los flujos de trabajo de la NAP, los procesos de trabajo de la plataforma interna para desarrolladores (IDP) y la cola. Faltaba la práctica de ingeniería de fiabilidad que se introduce en este capítulo: cómo gestionar de forma controlada las situaciones de degradación. Cuando un proceso de trabajo se quede bloqueado, reasigna a otro las tareas en cola. Si no es posible reasignarlas, genera una alerta cuando el tamaño de la cola no varíe y correlaciona estas incidencias para facilitar el diagnóstico.
En el Capítulo 11 presenté una NAP ideal en condiciones normales. Aquí quiero que te plantees qué podría salir mal en condiciones reales (muchas cosas, a decir verdad): fallos parciales, cargas de trabajo concurrentes, dependencias lentas y los numerosos errores ambiguos que producen los sistemas distribuidos.
El capítulo se organiza en torno a tres temas principales:
- La escalabilidad plantea cómo responde la NAP al aumento de la carga de trabajo: más dispositivos y más flujos de trabajo concurrentes.
- La fiabilidad plantea cómo se comporta la NAP cuando algo sale mal.
- La excelencia operativa te permite saber que la NAP sigue funcionando.
Estos tres aspectos se refuerzan entre sí. Una NAP que escala bien pero falla de forma impredecible sigue siendo un problema. Y, retomando lo que vimos en el Capítulo 2, para generar confianza tienes que prepararte para (casi) todo.
Los puntos de aprobación humana se tratan en el Capítulo 13, junto con la gobernanza. El historial de la automatización, que vincula las evidencias de la NAP con el modelo de confianza de la organización, se trata en el Capítulo 14, junto con el cambio cultural.
Empecemos por los fundamentos: qué entendemos por escala y qué tres decisiones determinan cómo crece cada componente.
Fundamentos de la escalabilidad#
Plantéate primero por qué hacen falta estos patrones. Una red de 200 dispositivos a cargo de una sola persona del equipo de ingeniería no necesita fragmentar los procesos de trabajo ni particionar la capa de datos. El procesamiento secuencial es lento, pero basta. A pequeña escala, la complejidad de un sistema distribuido cuesta más de lo que aporta: estos patrones hacen falta a gran escala (no intentes resolver esa complejidad antes de tiempo). Pero ¿qué entendemos por escala?
Estos son los umbrales de escala a partir de los cuales dejan de servir los enfoques más sencillos:
Con unos cientos de dispositivos, el procesamiento secuencial funciona. Un solo proceso de trabajo tarda entre unos minutos y varias horas en recorrer una lista de dispositivos, según la operación. El paralelismo ayuda, pero no es imprescindible.
Con unos miles de dispositivos, el procesamiento secuencial deja de ser aceptable para las operaciones con plazos ajustados. Una ventana nocturna de actualización de firmware puede quedarse corta para una ejecución secuencial. Se hace necesario ejecutar varios procesos de trabajo en paralelo, lo que introduce los problemas de coordinación y gestión de fallos que se abordan en este capítulo.
Con decenas de miles de dispositivos, la recuperación de datos se convierte en un cuello de botella, independientemente del paralelismo en la ejecución. A esta escala, consultar el inventario completo (todos los dispositivos, interfaces, cables y conexiones) en una sola base de datos puede llevar muchos minutos. Los procesos de trabajo encargados de la ejecución permanecen inactivos a la espera del resultado de la consulta de inventario que necesitan para poder siquiera iniciar su tarea. A esta escala, para que el sistema funcione correctamente en un plazo razonable, es necesario fragmentar la capa de datos o adoptar un mecanismo de actualización de datos basado en eventos.
Estos umbrales no son exactos. Dependen de muchas variables: la implementación de la Fuente de Verdad, los tiempos de respuesta de la interfaz de programación de aplicaciones (API) de los dispositivos, la topología de la red o la naturaleza de los flujos de trabajo que se ejecutan. El campus que nos sirve de ejemplo, con 800 conmutadores de tres fabricantes, se sitúa en el segundo umbral. El procesamiento secuencial es demasiado lento para las operaciones masivas con plazos ajustados, como demuestra la actualización de firmware del relato inicial, así que hacen falta procesos de trabajo en paralelo. Los patrones de coordinación y gestión de fallos de los apartados Patrones de escalado e Ingeniería de fiabilidad se aplican directamente a este caso.
La fragmentación de la capa de datos y el consumo de datos de la Fuente de Verdad basado en eventos corresponden al tercer umbral: merece la pena entender ambas técnicas, pero la NAP del campus no las necesita. Las decisiones de diseño que a pequeña escala parecen opcionales se vuelven obligatorias a gran escala. Los equipos que las posponen acaban teniendo que incorporar una arquitectura distribuida a una NAP que no se diseñó para ello. Es un trabajo costoso y propenso a errores.
Distingue dos momentos. Diseña desde el principio pensando en estos patrones: interfaces bien definidas entre componentes, ejecución asíncrona desde que se recibe una solicitud y límites explícitos para la propagación de fallos. Hacerlo cuanto antes sale más barato y tiene una influencia enorme en la NAP (mayor que la del propio código). Implementa los patrones cuando cruces el umbral correspondiente (no antes): la fragmentación, la federación y los flujos de eventos suponen código que luego tendrás que ejecutar y depurar. Si diseñas así la NAP, una futura ampliación de capacidad se convierte en una tarea de configuración. Sin ese diseño, cada ampliación puede obligarte a reescribir el código.
La primera de las tres decisiones es la que más condiciona la estructura: en cuántos puntos se toman decisiones.
Centralización frente a federación#
La optimización prematura es la raíz de todos los males.
Donald Knuth
La elección entre centralización y federación depende menos de la tecnología que de los modos de fallo que la organización pueda tolerar. Un equipo que pueda aceptar una caída global del Orquestador como un incidente infrecuente del que es posible recuperarse puede mantener el modelo centralizado durante más tiempo. Un equipo que opere en varias regiones geográficas con ventanas de mantenimiento independientes adoptará antes la federación.
Esta decisión afecta a todos los componentes de la arquitectura. Veámoslos uno a uno, empezando por aquel en el que más se aprecia la disyuntiva.
Orquestador. En un Orquestador centralizado, las decisiones se concentran en un único punto: todos los procesos de trabajo le comunican su estado, toda la información de estado se guarda en el mismo sitio y un solo componente toma todas las decisiones de planificación. Es fácil entender cómo funciona. Cuando algo sale mal, no hay duda sobre dónde buscar el fallo: el Orquestador funciona o no funciona. Cuando hay que depurar un flujo de trabajo, toda la información de estado pertinente está en un mismo lugar.
El modo de fallo de la centralización también está claro: el Orquestador es un cuello de botella y un punto único de fallo. A gran escala, el volumen de actualizaciones de estado procedentes de miles de procesos de trabajo concurrentes puede saturar la capacidad de procesamiento de un único Orquestador. Una caída del Orquestador o una partición de la red aísla a todos los procesos de trabajo a la vez.
Por su parte, el modelo federado distribuye la toma de decisiones: cada controlador regional o de dominio se encarga de su propia parte del inventario de dispositivos y del conjunto de procesos de trabajo. El fallo de un controlador federado solo afecta a la parte que tiene asignada. Los demás controladores siguen funcionando. El máximo volumen de trabajo que puede procesar por unidad de tiempo es mayor porque el sistema escala horizontalmente (patrón de escalado horizontal, scale-out pattern).
El coste se paga en consistencia. En un modelo federado tienes que agregar la información de estado de varios controladores para tener una visión global de las tareas en ejecución, las completadas y las fallidas. Un cambio que abarque varios dominios federados exige coordinación entre ellos. La federación rara vez falla con una caída evidente. Suele fallar por pequeñas incoherencias en el estado distribuido, difíciles de detectar y costosas de resolver.
La Figura 12.1 compara ambos modelos a medida que aumenta la carga. Las curvas son ilustrativas.
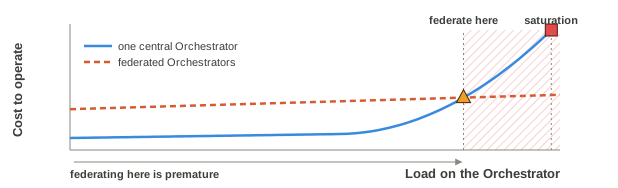
La recomendación es sencilla: empieza con un modelo centralizado. Pasa a un modelo federado solo cuando encuentres un cuello de botella concreto y medible. La federación añade complejidad antes de que la escala lo justifique: hay que distribuir el estado, mantener la consistencia entre dominios y reunir información de varios controladores para depurar los problemas. A gran escala compensa asumir esa complejidad, pero en una NAP que aún no ha demostrado necesitarla, no compensa.
Yo también he caído en esa trampa. Me pidieron una red que abarcara varias nubes y diseñé algo de lo que me sentía muy orgulloso: una red troncal de tipo fabric con Border Gateway Protocol (BGP) que abarcaba varias nubes, con encaminamiento dinámico en toda la red y preparada para cualquier topología que deparase el futuro. Luego se la presenté a quienes iban a usarla. Solo necesitaban que unas pocas sedes se comunicaran entre sí, y eso no iba a cambiar. Al final construimos conexiones punto a punto, automatizadas de extremo a extremo, que cumplían todo lo que se había pedido. La fabric era una respuesta elegante a una pregunta que nadie había hecho.
Entonces, ¿cuándo deberías plantearte la federación?
Dos señales justifican la federación. La primera es que la capacidad de planificación se sature bajo carga: el trabajo entra en la cola más deprisa de lo que el Orquestador puede distribuirlo, incluso después de ajustar su rendimiento. La segunda es un requisito de fiabilidad geográfica que un diseño centralizado no puede cumplir, como ocurre cuando varias regiones con ventanas de mantenimiento independientes deben seguir funcionando si pierden la conexión entre sí. Sin una de esas dos señales, federar es una optimización prematura en el sentido que le da Knuth. El coste de mantener el diseño centralizado demasiado tiempo es un proyecto de refactorización. El coste de federar demasiado pronto es un sistema distribuido cuya complejidad supera la capacidad del equipo para operarlo.
Los procesos de trabajo del Orquestador son la parte más sencilla y suelen ser los primeros en distribuirse. Como explica la sección Separación del plano de control y el plano de datos, estos procesos no mantienen estado de coordinación, así que agruparlos por regiones no cambia quién se responsabiliza de cada trabajo: sigue siendo un único Orquestador. Antes de federar el propio Orquestador, responde a una pregunta: ¿hay algún flujo de trabajo que abarque dispositivos de más de un dominio federado y, en ese caso, qué Orquestador se hace cargo del estado del trabajo si uno de los dominios pierde la conectividad en plena ejecución?
Los demás componentes se enfrentan a la misma decisión y cada uno tiene su propio modo de fallo cuando se federa.
Fuente de Verdad. Federar la Fuente de Verdad (SoT) plantea una cuestión de consistencia que no se da al federar el Orquestador. Si el registro de un mismo dispositivo existe en dos particiones regionales y se modifica en una de ellas, ¿cuánto tarda la otra en reflejar el cambio? ¿Y qué ocurre si un flujo de trabajo lee de una partición mientras se actualiza el registro de referencia en la otra? El Capítulo 5 describe el modelo de consistencia de la Fuente de Verdad. Ese modelo es la restricción que determina hasta qué punto se puede federar la Fuente de Verdad.
Al federar la capa de datos se adopta una de las dos arquitecturas de la Figura 5.4 del Capítulo 5. La elección determina qué garantías de consistencia se heredan: la arquitectura centralizada ofrece una vista única, pero solo garantiza la consistencia eventual, mientras que la distribuida mantiene la consistencia fuerte en cada dominio, a costa de que los consumidores tengan que consultar varios sistemas y coordinar los eventos de cambio.
Se aplica el mismo consejo que para el Orquestador: empieza con una arquitectura centralizada y pasa un dominio a la arquitectura distribuida solo cuando mantenerlo en la Fuente de Verdad central se convierta en un obstáculo. Puede ocurrir, por ejemplo, si una fuente es demasiado grande o cambia demasiado deprisa para mantenerla sincronizada, o si hay una dependencia de disponibilidad que no puedes aceptar. Antes de federar, responde a una pregunta: si un flujo de trabajo de la región A lee el registro de un dispositivo mientras hay una escritura en curso sobre ese registro en la región B, ¿con qué datos actúa el flujo de trabajo y son aceptables para la operación que realiza?
Observabilidad. La capa de Observabilidad es donde más claramente compensa federar, porque la mayoría de sus decisiones son locales. Para detectar un problema dentro de un centro de datos no hacen falta datos de otro. Dota, por tanto, a cada región o sede de su propia pila, capaz de recopilar y almacenar datos, emitir alertas y validar una oleada por sí sola, y centraliza solo las cuestiones que requieren una visión de conjunto: las tendencias en todo el parque de dispositivos, la correlación entre regiones y la planificación de capacidad. Cada pila regional sigue funcionando aunque las demás pilas o la vista central estén fuera de su alcance. Además, sus datos acaban llegando a la pila central.
El coste está en la coordinación. Alguien tiene que mantener la coherencia entre las pilas regionales en cuanto a esquema, reglas de alerta y retención de datos, y la vista central solo agrega aquello en lo que las regiones se han puesto de acuerdo. El otro coste es la latencia al reunir los datos: una consulta que sí necesita la vista central tiene que esperar a que la telemetría cruce el límite de la región. Antes de federar, responde a una pregunta: ¿qué decisiones necesitan datos de más de una región y depende de alguna de ellas la validación que realiza el Orquestador después de cada oleada?
Presentación. La API suele ser el último componente que se federa, porque los usuarios quieren un único punto de entrada. Los puntos de acceso regionales pueden situarse delante de la API. La primera pregunta que debes responder es esta: si se envía una solicitud en la región A, ¿puede la región B hacer un seguimiento de ella, aprobarla o cancelarla? Cada solicitud debe tener una única región responsable. De lo contrario, dos regiones pueden aprobar o cancelar el mismo cambio.
Evalúa cada componente por separado, con sus propios requisitos de consistencia y modos de fallo. La NAP no es una capa única que deba federarse o mantenerse centralizada en su conjunto. El caso de la Observabilidad permite formular una pregunta aplicable a todos los componentes: ¿qué proporción de su trabajo puede realizar cada parte solo con datos locales? Cuanto mayor sea esa proporción, más resiliencia y capacidad de escalar aporta la federación. Cuanto menor sea, más pagarás en coordinación para obtener poco a cambio.
Si no puedes responder a la pregunta de un componente, ese componente aún no está listo para federarse.
La federación determina en cuántos lugares se toman decisiones. La siguiente decisión es dónde termina la toma de decisiones y empieza la ejecución del trabajo.
Separación del plano de control y el plano de datos#
Una NAP preparada para escalar separa la toma de decisiones de la ejecución. El plano de control decide qué flujo de trabajo se ejecuta, de qué dispositivo se encarga cada proceso de trabajo y si una oleada ha superado la validación. El plano de datos ejecuta las operaciones: inicia sesión en los dispositivos, envía la configuración y recopila telemetría. Pero ambos planos crecen de forma independiente. El volumen de decisiones aumenta con el número de flujos de trabajo y el volumen de trabajo, con el número de dispositivos, de modo que una NAP que puede escalar cada plano por separado absorbe el crecimiento allí donde se produce.
La cuestión de la centralización que se plantea en la sección anterior se aplica a cada plano por separado. El plano de datos suele distribuirse primero porque es el primero que lo necesita: los procesos de trabajo deben estar cerca de los dispositivos a los que acceden y no mantienen estado de coordinación, de modo que distribuirlos por regiones cuesta poco. El plano de control también puede federarse, más adelante y con mayor cautela. Distribuyas lo que distribuyas, comprueba primero las dependencias: un componente regional que necesita hacer una llamada síncrona a un componente central para actuar no ha ganado independencia. Si divides así la NAP, obtienes un monolito distribuido, con toda la complejidad de un sistema distribuido y ninguna de sus ventajas en cuanto a resiliencia, porque cuando falla el centro siguen fallando todos los componentes.
Los términos «plano de control» y «plano de datos» proceden del ámbito de los sistemas distribuidos y aquí tienen un significado distinto del que tienen en arquitectura de redes, donde se refieren, respectivamente, al procesamiento de los protocolos de encaminamiento y al reenvío de paquetes por hardware.
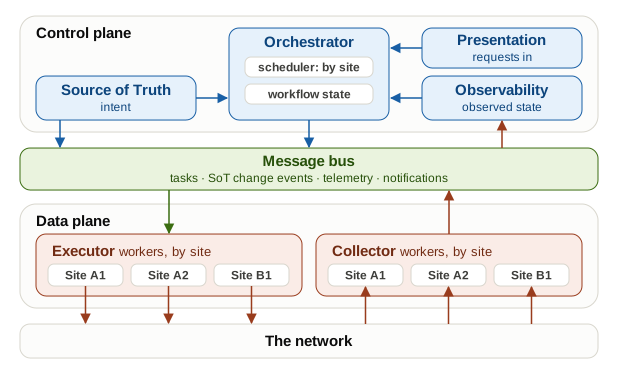
La Figura 12.2 muestra a qué plano pertenece cada componente de la NAP.
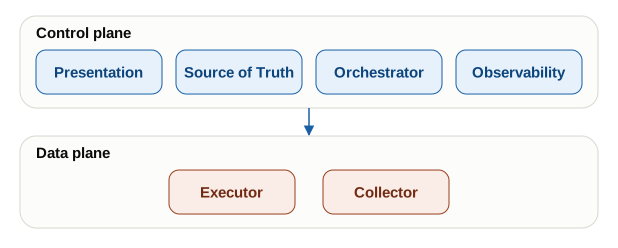
- Plano de control: la Presentación y el Orquestador. La Presentación recibe las solicitudes y se las entrega al Orquestador. El Orquestador planifica los flujos de trabajo, asigna tareas a los procesos de trabajo, lleva el seguimiento del estado de los flujos y evalúa los criterios de finalización. Actúa a partir de la intención que obtiene de la Fuente de Verdad y de la información que la capa de Observabilidad le proporciona sobre lo que ha ocurrido realmente. Mantiene estado y necesita consistencia: debe saber con exactitud qué procesos de trabajo están ocupados, en qué dispositivos ha terminado el trabajo y qué flujos siguen en curso. De lo contrario, se producen errores de planificación.
- Plano de datos: los procesos de trabajo del Ejecutor y del Recolector. Los procesos de trabajo del Ejecutor envían la configuración a los dispositivos y recuperan artefactos del almacén de artefactos. Los del Recolector recopilan telemetría. Un proceso de trabajo es una instancia en ejecución de un componente, por lo que para ampliar la capacidad se añaden procesos de trabajo, no componentes. Cada operación es independiente de las demás, así que el plano de datos no mantiene estado de coordinación. También es donde se concentra el volumen de trabajo: con decenas de miles de dispositivos, ejecuta muchas más operaciones por segundo de las que planifica el plano de control.
Entre ambos planos hay una cola de trabajo que gestiona el Orquestador: este pone las tareas en la cola y sigue adelante, y los procesos de trabajo las recogen a su propio ritmo. La sección Patrones de escalado explica en detalle cómo funciona la cola.
Separar los planos contiene los fallos del plano de datos: un grupo de procesos de trabajo que han dejado de funcionar, un pico de telemetría o un dispositivo que rechaza conexiones. Ninguno de estos fallos impide que el plano de control evalúe la situación del sistema y planifique nuevas tareas. La separación también permite escalar horizontalmente el plano de datos añadiendo procesos de trabajo sin tener que modificar el plano de control. Por su parte, el plano de control puede alcanzar una alta disponibilidad mediante la elección de líder o la replicación activo-pasivo sin que esa complejidad se propague al plano de datos.
Una NAP que combina el plano de control y el plano de datos, y en la que el Orquestador es también el motor de ejecución, no puede escalar ambas funciones por separado. Si aumentar la capacidad de ejecución exige aumentar también la capacidad del Orquestador, puede que las responsabilidades no estén bien separadas. Los entornos pequeños que no necesitan escalar son la excepción (una vez más).
Al separar los planos queda un problema que ninguna arquitectura elimina: los datos que leen ambos planos nunca están del todo actualizados.
Modelos de consistencia#
En un mundo ideal, queremos que todos nuestros datos (tanto los de intención como los observados) sean consistentes. Por ejemplo:
- En la Fuente de Verdad, que se describe en el Capítulo 5, cada lectura devuelve la última intención escrita.
- El estado observado de la red, que se describe en el Capítulo 7, refleja el estado real de la red.
En la práctica, no se cumple ninguna de las dos condiciones. Puede que los datos recién escritos aún no estén disponibles por el uso de cachés o de fuentes de datos distribuidas. Los datos observados de la red tampoco están nunca del todo sincronizados con la realidad, porque la recopilación, el procesamiento y la distribución introducen retrasos.
No son casos excepcionales. Son las condiciones normales de funcionamiento de cualquier sistema distribuido que gestione infraestructura física. Si el diseño de la NAP no las tiene en cuenta, se manifestarán como incidentes operativos.
Hay que tomar tres decisiones de forma explícita:
- Cuánto tiempo esperar. La ventana de conciliación: después de un despliegue, ¿cuánto tiempo espera la NAP antes de consultar el estado posterior al cambio? Un buen punto de partida es esperar entre dos y tres veces el intervalo de recopilación de telemetría. Si la NAP realiza un sondeo cada 30 segundos, espera al menos 90 segundos antes de dar por fallida la validación: es posible que el dispositivo aún esté convergiendo.
- Qué hacer mientras persista la discrepancia. Cuando la Fuente de Verdad y el estado observado discrepan durante ese intervalo, ignorar la discrepancia casi nunca es la respuesta adecuada. Así se descarta sin aviso información que puede ser importante para el diagnóstico. Conviene reintentar la operación cuando la discrepancia parece transitoria, por ejemplo, si hay un retraso en la recogida de datos. Si los estados difieren de verdad, la respuesta por defecto es avisar y esperar. La NAP avisa a la persona de guardia y le comunica el ID del dispositivo, el valor esperado según la Fuente de Verdad y el valor observado por la capa de Observabilidad. A continuación, pausa el flujo de trabajo afectado al final de la etapa en curso. La persona de guardia confirma que la discrepancia es aceptable y reanuda el flujo, o bien lo aborta e investiga. La NAP no toma esa decisión por su cuenta.
- Qué hacer cuando vence el plazo. Si la discrepancia persiste, se ha producido una desviación o hay un problema en la cadena de telemetría. Ambos casos requieren investigación y la NAP necesita intervención humana para distinguirlos.
Esas tres decisiones dan forma a la arquitectura. La siguiente sección las convierte en patrones que puedes aplicar a medida que crece la NAP.
Patrones de escalado#
A continuación se presentan cuatro patrones. Los dos primeros reparten el trabajo y los datos entre más recursos mediante el particionamiento entre procesos de trabajo (worker sharding) y el particionamiento de la capa de datos (data-layer sharding). El tercero mantiene coordinados los componentes cuando aumenta el volumen de trabajo mediante la coordinación basada en eventos y la mensajería que la sustenta. El último evita que la Fuente de Verdad, que todos los flujos de trabajo consultan en primer lugar, se convierta en el cuello de botella.
Cada uno de los tres primeros patrones añade un componente a la NAP de la Figura 12.2, y el diagrama se amplía con cada incorporación. La Figura 12.3 muestra el interior del Orquestador, incluida su cola de trabajo, y la red subyacente. Las Figuras 12.3 a 12.5 destacan lo que añade cada patrón.
La cola de trabajo hace que la NAP funcione de forma asíncrona internamente, con independencia de lo que vea quien envía la solicitud (el Capítulo 8 trata la ejecución síncrona y asíncrona desde la perspectiva de quien la solicita). La cola absorbe las ráfagas de solicitudes y su longitud es el primer indicador de presión antes de que disminuya la tasa de procesamiento. La NAP del relato inicial ya tenía esta cola. Lo que le faltaba era un tiempo de espera máximo para cada operación. Con ese límite, si un dispositivo nunca responde, el proceso de trabajo que lo atiende queda libre y los dispositivos que esperan detrás siguen avanzando.
La cola complica la depuración. Si un flujo de trabajo falla en el tercero de siete pasos, su estado queda repartido entre la cola, el proceso de trabajo que ejecutó los tres primeros pasos y la cola de mensajes no entregados que recibió el mensaje fallido. La traza distribuida, que se describe en la sección Trazas distribuidas entre flujos de trabajo, permite abordar ese diagnóstico.
Particionamiento entre procesos de trabajo#
El particionamiento entre procesos de trabajo reparte el inventario de dispositivos de modo que cada proceso se encarga de un subconjunto acotado. Es lo que permite multiplicar por 48 la tasa de procesamiento al utilizar 48 procesos de trabajo. También determina qué dispositivos se ven afectados a la vez cuando un proceso deja de funcionar. Importa más cómo delimites los subconjuntos que cuántos haya.
La estrategia más sencilla es la asignación aleatoria. Para cada tarea, los dispositivos se reparten al azar entre los procesos de trabajo disponibles. La asignación aleatoria distribuye la carga de manera uniforme, pero los efectos de un fallo no quedan localizados. Si un proceso de trabajo se cae, el fallo afecta a una muestra aleatoria de todo el parque de dispositivos. Así resulta difícil determinar si el fallo tiene una causa sistemática, por ejemplo, si los dispositivos afectados comparten sede, firmware o modelo de un mismo fabricante.
El particionamiento que preserva la localidad, o afinidad con el proceso de trabajo (worker affinity), asigna los dispositivos a los procesos según un atributo significativo, como la sede, la región, el fabricante o el dominio organizativo. El planificador lee ese atributo de la Fuente de Verdad al distribuir el trabajo. Es lo contrario de la antiafinidad que separa las réplicas de la NAP en el Capítulo 11, ya que aquí interesa mantener juntos los dispositivos relacionados. El proceso de trabajo encargado de la sede A atiende a todos los dispositivos de esa sede.
Si ese proceso se cae, todos los dispositivos afectados están en la sede A, que constituye un dominio de fallo con sentido operativo (véase la sección Compartimentos estancos y dominios de fallo). El impacto queda limitado a una unidad geográfica u organizativa y la relación entre el fallo y el conjunto afectado resulta evidente de inmediato. A veces la localidad ni siquiera es opcional. Si solo se puede acceder a una sede desde su propia red, hace falta un proceso de trabajo allí.
La Figura 12.3 muestra la NAP con los procesos de trabajo distribuidos en un grupo por sede, tanto para el Ejecutor como para el Recolector.
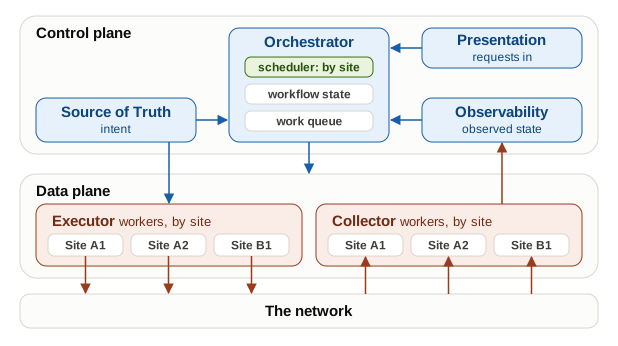
El coste de preservar la localidad al particionar es una distribución desigual de la carga. Una sede con 1200 dispositivos carga más a su proceso de trabajo que una con 80. El sistema de planificación debe tener en cuenta este desequilibrio, ya sea asignando varios procesos de trabajo a las sedes grandes o redistribuyendo la carga de forma dinámica a medida que crecen las sedes.
Recomiendo particionar por sede desde el principio para preservar la localidad, incluso a pequeña escala. El desequilibrio de carga es un problema de planificación con soluciones conocidas. En cambio, con la asignación aleatoria, establecer la correlación entre el fallo y los dispositivos afectados es un problema de investigación de incidentes que, una vez ocurrido el fallo, no tiene buena solución. Cuando falla un proceso de trabajo en un sistema que preserva la localidad, se ve enseguida qué tienen en común los dispositivos afectados: son todos los de la sede A.
Cuando falla un proceso de trabajo en un sistema de asignación aleatoria, los dispositivos afectados son una muestra aleatoria del parque sin valor diagnóstico. Esa diferencia importa sobre todo a las 02:00, cuando el equipo intenta determinar si el fallo obedece a un problema sistemático o es un incidente aislado. La asignación aleatoria favorece la uniformidad de la carga a costa de la claridad operativa. Es una mala elección para un sistema que gestiona infraestructura de red en producción.
Algunos flujos de trabajo abarcan varias sedes, como un cambio de política de enrutamiento que afecta a un router de peering de la sede A y a un reflector de rutas BGP de la sede B. Asigna esos flujos a un proceso de trabajo regional y limita su ámbito a los dispositivos que el flujo declare como destino. El particionamiento por sede cubre el caso habitual de una sola sede. El proceso de trabajo regional se ocupa de las excepciones que abarcan varias sedes y preserva la localidad para el resto.
Cuando el parque de dispositivos combina protocolos de gestión, con equipos que utilizan NETCONF o gRPC Network Management Interface (gNMI) y otros que solo permiten extraer datos de la salida de la interfaz de línea de comandos (CLI) a través de Secure Shell (SSH), añade el tipo de protocolo como atributo secundario de particionamiento junto a la sede. Un proceso de trabajo configurado para NETCONF falla de inmediato si intenta comunicarse con un dispositivo que solo admite CLI. Sin una etiqueta que indique el tipo de protocolo en el registro, ese fallo es indistinguible de un problema de conectividad.
El particionamiento entre procesos de trabajo reparte la ejecución. Los datos siguen en el mismo sitio. Si todos los procesos consultan la misma instancia de la Fuente de Verdad y esta se satura, añadir más procesos solo alarga la cola en la base de datos. De eso se ocupa el siguiente patrón.
Particionamiento de la capa de datos#
El particionamiento de la capa de datos divide la Fuente de Verdad por región o dominio, de modo que cada partición almacena los registros de un subconjunto acotado del inventario de dispositivos. Los procesos de trabajo asignados a una región consultan únicamente la partición de esa región, sin acudir a la global. La carga de las consultas se reparte entre las particiones.
Una restricción fundamental es que el particionamiento entre procesos de trabajo y el de la capa de datos estén alineados. Si el trabajo se reparte entre los procesos por sede y la Fuente de Verdad se divide por región, un proceso encargado de una sede de la región A debe consultar la partición de la región A. Así funciona. Si el reparto del trabajo y la división de los datos no están alineados, el proceso debe consultar varias particiones para reunir sus datos de entrada. Es probable que esa consulta a varias particiones sea más lenta que la consulta a una sola instancia que pretendía sustituir. Las dos estrategias de particionamiento deben diseñarse conjuntamente.
La solución es sencilla. Haz coincidir los límites de las particiones de la Fuente de Verdad con el atributo de localidad que ya utilizas para repartir el trabajo entre los procesos. Si el trabajo se reparte por región (todas las sedes de Norteamérica al grupo de procesos NA y todas las sedes de Europa al grupo EU), la Fuente de Verdad debe dividirse también por región. Cada partición tiene un límite geográfico u organizativo que se corresponde con un dominio de enrutamiento de la red física. Así, tanto el planificador como quien administra la base de datos pueden interpretar ese límite en los mismos términos. La Figura 12.4 incorpora esa correspondencia a la NAP.
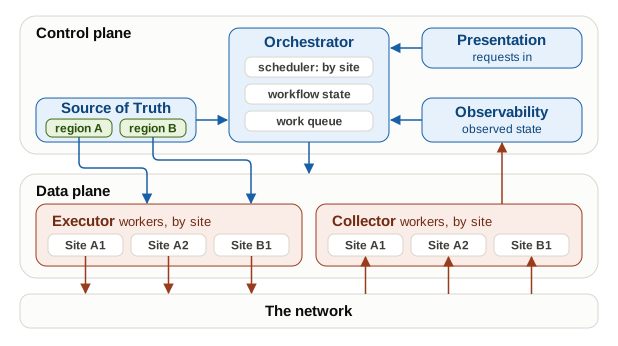
Define las particiones según un límite que tenga sentido para las operaciones de red, como una región o un gran centro de datos. Evita los límites elegidos por conveniencia de la base de datos, como el valor hash del nombre del dispositivo. Así, un fallo en una partición afecta a un conjunto de dispositivos identificable y coherente desde el punto de vista operativo.
El particionamiento no elimina el problema de las consultas a varias particiones. Algunos flujos de trabajo traspasan sus límites, como un cambio de política de enrutamiento que afecta a dispositivos de dos regiones o una consulta de auditoría global de la Fuente de Verdad. Estas consultas se ejecutan en una réplica de lectura global que reúne los datos de las distintas particiones. Se acepta así la mayor latencia de una consulta a varias particiones a cambio de la flexibilidad de una vista unificada. Sin embargo, la réplica global solo admite lecturas y puede llevar retraso. Los flujos de trabajo que necesitan un estado global con consistencia fuerte deben rediseñarse para ejecutarse en una única partición o aceptar la ventana de consistencia de la réplica.
El particionamiento reparte el trabajo y los datos entre más recursos. El siguiente límite es la coordinación. Un único Orquestador que se ocupa de toda la planificación también acaba saturándose.
Coordinación basada en eventos y mensajería#
El Capítulo 8 presentó la distinción entre la coordinación orquestada de los flujos de trabajo y la coordinación basada en eventos. A pequeña escala son preferibles los flujos de trabajo orquestados. Son deterministas, fáciles de depurar y su traza de ejecución ofrece un registro lineal de lo ocurrido y del momento en que ocurrió.
A gran escala, la capacidad de planificación del Orquestador determina el punto de saturación de los flujos de trabajo orquestados. Si el Orquestador puede planificar N instancias de flujo de trabajo por segundo y la tasa de llegada de solicitudes supera N, la cola crece sin límite. El Orquestador se convierte en el cuello de botella y, si falla, el fallo afecta a todos los flujos de trabajo en curso a la vez.
Las arquitecturas basadas en eventos distribuyen la coordinación. Cada paso del flujo de trabajo emite un evento al completarse y los pasos posteriores se activan al consumir esos eventos de una cola. La cola absorbe los picos de actividad. Si durante un tiempo se producen eventos a un ritmo superior al de consumo, la cola crece, pero el sistema sigue funcionando. Los procesos de trabajo escalan horizontalmente al añadir más consumidores a la cola. En un sistema basado íntegramente en eventos, la propia cola sustituye al Orquestador.
Depurar un sistema así tiene un coste. Cuando un flujo de trabajo basado en eventos falla a mitad de la ejecución, su estado queda repartido entre el registro de eventos, las posiciones de lectura de los consumidores y los datos de estado que haya guardado cada paso antes de fallar. Para reconstruir el fallo hay que correlacionar la información de esas ubicaciones. Por eso, en los sistemas basados en eventos a gran escala, el trazado distribuido es imprescindible como herramienta principal de depuración.
El criterio es el mismo que para la federación en Centralización frente a federación. Empieza con flujos orquestados y pasa a la coordinación basada en eventos solo cuando detectes una señal concreta de saturación. Dos señales justifican el cambio. La primera es que las mediciones bajo carga muestran que la planificación alcanza su límite y las tareas se acumulan en la cola más deprisa de lo que el Orquestador puede distribuirlas, incluso después de ajustar los procesos de trabajo. La segunda es que un patrón de fallos revela que la sobrecarga de coordinación del Orquestador amplifica los fallos en vez de contenerlos. En ausencia de esas señales, los flujos de trabajo orquestados son más fáciles de depurar y de entender, y es más fácil traspasar su gestión al personal de ingeniería que no participó en el desarrollo de la NAP.
Sin embargo, ambas opciones pueden combinarse. Puedes usar la coordinación basada en eventos para funciones como la activación de los flujos y mantener flujos de trabajo orquestados para las partes sujetas a restricciones más estrictas.
El mismo modelo de eventos se aplica a los datos. En lugar de consultar la Fuente de Verdad al inicio de cada ejecución para obtener una instantánea actualizada, los procesos de trabajo se suscriben a sus eventos de cambio, como se describe en la sección Consumo de datos del Capítulo 5. Mantienen una caché local que se actualiza de forma incremental. Un cambio en el registro de un dispositivo genera un evento en un bus de mensajes o a través de un webhook. Los procesos de trabajo a los que les afecta el cambio actualizan su caché. El coste de las consultas pasa de cargar todo el inventario cada vez que se inicia un flujo de trabajo a cargar una pequeña diferencia cada vez que se escribe en la Fuente de Verdad.
Esto añade una dependencia. La Fuente de Verdad debe publicar eventos de cambio fiables. Si falla el flujo de eventos, las cachés quedan desactualizadas sin dar aviso, así que mantén un ciclo de conciliación que vuelva a cargar periódicamente los datos desde la Fuente de Verdad. Solo algunas implementaciones permiten publicar esos eventos de serie.
Elijas el modelo de coordinación que elijas, los eventos, las tareas y las notificaciones se transmiten como mensajes y, cuando el volumen es elevado, entran en juego las propiedades de la propia capa de mensajería. Cada componente de la NAP se comunica con los demás mediante mensajes. El Orquestador asigna tareas a los procesos de trabajo, la Fuente de Verdad anuncia los cambios, los recolectores transmiten telemetría de forma continua a Observabilidad y la capa de Presentación envía notificaciones a quienes presentan las solicitudes.
A pequeña escala, todo esto se transmite mediante llamadas directas a la API. A gran escala, la mayor parte de ese tráfico pasa a un bus de mensajes, que a menudo es un servicio que ya gestiona la IDP. La Figura 12.5 completa el esquema. El bus ocupa el lugar de la cola de trabajo entre los planos y transporta todos esos flujos.
Las propiedades del bus pasan a ser propiedades de la NAP. Hay cinco que importan:
Semántica de entrega: la mayoría de los buses garantizan la entrega al menos una vez, por lo que un mensaje puede llegar dos veces. El procesamiento debe ser idempotente. Un duplicado produce el mismo resultado que una sola entrega. La sección Ingeniería de fiabilidad trata en detalle la Idempotencia. En la capa de mensajería, lo importante es que el bus no puede garantizar que el mensaje se entregue exactamente una vez, así que el consumidor debe garantizar que solo surta efecto una vez.
Orden de los mensajes: el bus ordena los mensajes dentro de cada partición, sin imponer un orden global. Particiona por dispositivo para que dos cambios en el mismo dispositivo lleguen en el orden en que se hicieron. El orden global no escala y una NAP rara vez lo necesita.
Durabilidad y reproducción: un bus que conserva los mensajes permite que un consumidor reanude la lectura donde la dejó tras un reinicio y que uno nuevo reconstruya su estado a partir del historial. Sin retención de mensajes, si un proceso de trabajo se cae, pierde el trabajo que aún no había confirmado.
Esquemas explícitos: los mensajes entre componentes deberían tener esquemas explícitos y versionados. Si un proceso de trabajo recibe un mensaje mal formado o inesperado, debería rechazarlo con un error que permita diagnosticar el problema, sin detenerse ni procesar el mensaje de forma incorrecta.
Mecanismos de contrapresión: cuando los consumidores no pueden seguir el ritmo de los productores, la cola crece. Si crece sin control, consume memoria y almacenamiento y acaba provocando que el sistema rechace mensajes nuevos. La contrapresión es el mecanismo que permite al consumidor indicar al productor que debe reducir el ritmo. La implementación concreta depende del sistema de mensajería, pero el diseño debe prever que el plano de datos pueda saturarse. Añadir más trabajo a un sistema saturado empeora la situación.
El Orquestador sigue decidiendo qué se ejecuta, pero ahora publica las tareas en el bus en vez de mantenerlas en su propia cola. La Fuente de Verdad publica eventos de cambio que mantienen al día las cachés de los procesos de trabajo, y los procesos de recolección publican telemetría que consume Observabilidad. Añadir procesos de trabajo sigue consistiendo en añadir consumidores, sin modificar el plano de control.
Está surgiendo un tercer modelo de coordinación, el de los flujos de trabajo con agentes, que se presenta en la sección Orquestación con agentes del Capítulo 8 y se integra en una capa de decisión en el Capítulo 18. Como su ruta de ejecución no es determinista, predecir la carga y la ejecución resulta más difícil que con la orquestación o la coordinación basada en eventos. Sin embargo, la capacidad del agente para adaptarse a los fallos observados puede reducir la necesidad de programar de antemano la lógica de reintentos y de interruptor de circuito. Aun así, cada cambio que propone un agente pasa por los mismos controles deterministas que cualquier otro cambio.
Un componente merece su propio conjunto de patrones porque todos los flujos de trabajo empiezan por consultarlo. Se trata de la Fuente de Verdad.
Recuperación de datos de la Fuente de Verdad a gran escala#
La recuperación de datos de la Fuente de Verdad suele pasar inadvertida como cuello de botella hasta que superas cierto umbral de escala. Entonces se convierte en una crisis porque todo empieza ahí.
Un flujo de trabajo que necesita procesar un subconjunto del inventario de dispositivos, por ejemplo, todos los conmutadores de campus de una sede concreta, suele empezar por solicitar ese subconjunto a la Fuente de Verdad. A pequeña escala, la consulta devuelve los resultados enseguida. Con decenas de miles de dispositivos, incluso una consulta con filtro a una Fuente de Verdad que almacene registros de dispositivos e interfaces, conexiones de cableado, asignaciones de direcciones Internet Protocol (IP) y asignaciones de servicios puede devolver millones de filas antes de aplicar el filtro. El tiempo de consulta crece con el volumen de datos de la Fuente de Verdad, no solo con el tamaño del conjunto de resultados.
Las medidas de diseño actúan en distintos puntos del ciclo de vida de la consulta:
Carga diferida: carga solo los datos de la Fuente de Verdad que necesite el flujo de trabajo para el lote actual. Un flujo de trabajo destinado a la sede A debería consultar solo los registros de esa sede, lo que resulta más eficiente que consultar el inventario global. Para ello, el flujo de trabajo debe conocer su ámbito antes de hacer la consulta, por lo que el sistema de planificación tiene que asignar un ámbito a cada flujo antes de que se ejecute.
Paginación: nunca cargues el conjunto completo de resultados de una consulta grande en una operación atómica. Si una consulta devuelve cincuenta mil registros de interfaces, debería entregarlos de forma progresiva en páginas de unos cientos de registros. Procesa cada página y libera la memoria antes de cargar la siguiente. A esta escala, las cargas atómicas pueden ejercer una presión sobre la memoria que afecte a todo el proceso de trabajo.
Réplicas de lectura: separa las rutas de lectura y escritura en la base de datos. Las lecturas masivas de los procesos de trabajo deberían dirigirse a réplicas de lectura con consistencia eventual respecto a la base de datos primaria. Así evitas que las operaciones de lectura masiva compitan con las escrituras de la Fuente de Verdad por los recursos de la base de datos y degraden la ruta de escritura que procesa los cambios entrantes.
Caché basada en TTL: los procesos de trabajo que procesan varios dispositivos en secuencia pueden almacenar en caché los resultados de sus consultas a la Fuente de Verdad con un TTL corto (el tiempo de caducidad de la caché, no el tiempo de vida de un paquete IP). El TTL es una decisión de diseño que fija hasta qué punto puede quedar desactualizada la instantánea de la Fuente de Verdad antes de que un flujo de trabajo deba consultarla de nuevo. Elegirlo exige sopesar la carga que las consultas imponen a la Fuente de Verdad y el grado de actualización de los datos con los que opera el proceso de trabajo.
Consumo basado en eventos: es el enfoque de mayor relevancia arquitectónica y se describe en la sección Coordinación y mensajería basadas en eventos. Los procesos de trabajo se suscriben a los eventos de cambio de la Fuente de Verdad en lugar de consultarla.
El almacén de datos de observabilidad presenta el mismo problema en la ruta de lectura. Una consulta de validación tras una oleada es lenta si examina la telemetría en bruto de alta resolución de 800 conmutadores. Consulta datos agregados de menor resolución cuando la decisión lo permita y conserva los datos en bruto de los dispositivos que estés investigando. La sección Persistencia del Capítulo 7 trata la reducción de la frecuencia de muestreo.
Estas cinco medidas se ocupan de la ruta de lectura. Las escrituras se topan con el mismo límite desde el otro lado, y ahí la solución son los puntos de acceso de la API para operaciones por lotes. El cálculo es contundente. Actualizar diez mil dispositivos de objeto en objeto supone diez mil solicitudes y diez mil viajes de ida y vuelta, lo que consume varios minutos de tiempo real antes de que ocurra nada más. Una sola llamada por lotes reduce todo eso a un único viaje de ida y vuelta y permite al servidor paralelizar el trabajo.
A cambio, renuncias a lo que hacía seguras las escrituras de objetos individuales. Para alcanzar su tasa de procesamiento, los puntos de acceso por lotes omiten las costosas comprobaciones entre objetos y notifican los errores por lote en lugar de hacerlo por objeto. Si se produce un fallo parcial, te toca averiguar cuáles de los diez mil registros quedaron sin guardar. Es la misma disyuntiva entre validación síncrona y diferida que plantea el Capítulo 4 en la capa de datos y que aquí se presenta como una decisión de diseño de la API. Usa operaciones por lotes para los cambios generados por máquinas cuyos datos ya se hayan validado en una etapa anterior. Mantén las escrituras de objetos individuales para todo lo que alguien haya introducido a mano.
Estos patrones se complementan y conviene adoptarlos en el orden que marcan sus requisitos de infraestructura. La carga diferida y la paginación solo requieren cambios en el código de los flujos de trabajo y deberían ser prácticas habituales desde que se empieza a construir la NAP. Las réplicas de lectura requieren un cambio en la configuración de la base de datos y son la medida que más reduce por sí sola la carga de consultas sobre la Fuente de Verdad. Implántalas en cuanto la latencia de las consultas se convierta en un cuello de botella medible.
El almacenamiento en caché con TTL exige además coordinar el flujo de trabajo con la capa de caché y resulta adecuado cuando las réplicas de lectura por sí solas ya no dan abasto con las peticiones simultáneas de los procesos de trabajo. Consumir los datos de la Fuente de Verdad a partir de eventos es la inversión de mayor calado arquitectónico y solo resulta adecuado cuando los demás patrones ya están implantados y se ha comprobado que la infraestructura de publicación de eventos de la Fuente de Verdad es fiable.
Todos estos patrones agilizan las lecturas. Ninguno indica al flujo de trabajo hasta qué punto están actualizados sus datos, y a menudo el flujo lo desconoce. El Capítulo 5 distingue entre consultar la Fuente de Verdad una sola vez, como referencia, y consultarla en cada paso, como dependencia activa. A gran escala, el primer enfoque presenta un modo de fallo que conviene señalar.
Cuando el Orquestador lee el inventario de dispositivos al iniciar el flujo de trabajo y después distribuye la ejecución entre 200 dispositivos, trabaja con una instantánea. Puede que se retire un dispositivo en plena ejecución o que se reasigne una dirección IP entre la toma de la instantánea y el paso de ejecución. La automatización actúa entonces sobre datos que eran correctos en el momento de la lectura y que ya son incorrectos cuando se utilizan. En los flujos de trabajo breves, esto suele ser aceptable. En una actualización de firmware que dura horas o en un aprovisionamiento que abarca toda una ventana de mantenimiento, el periodo durante el que los datos pueden quedar obsoletos es lo bastante largo como para tenerlo en cuenta.
Trata la disponibilidad de la Fuente de Verdad como una dependencia en lugar de darla por supuesta:
- Antes de distribuir la ejecución entre los dispositivos, comprueba que la lectura de la Fuente de Verdad se ha completado correctamente y ha devuelto un registro actualizado. Para ello, consulta las marcas de tiempo de la última sincronización o el punto de acceso de la propia Fuente de Verdad que informa de su estado.
- En los flujos de trabajo de larga duración, vuelve a consultar la Fuente de Verdad en cada etapa importante en vez de leerla una sola vez al principio.
- Si la Fuente de Verdad no está disponible, detén la ejecución de forma controlada con un mensaje de error claro. No continúes a partir de una instantánea en caché cuya antigüedad desconoces. Una ejecución que recurre en silencio a una intención obsoleta es peor que una que se detiene, porque no queda constancia de que se actuó según una intención que ya no estaba vigente.
Esto impone a su vez un requisito a la propia Fuente de Verdad. Si la Fuente de Verdad es la autoridad de escritura para toda la automatización y carece de una configuración de alta disponibilidad, constituye un punto único de fallo para toda la NAP. Las réplicas de lectura, los despliegues regionales y la elección entre una sola Fuente de Verdad o varias federadas son las cuestiones que plantea el apartado Centralización frente a federación, aplicadas a la capa de datos que consulta el resto de la NAP.
Los patrones de escalado hacen que la NAP sea más rápida, pero ¿cómo se comporta cuando algo falla?
Ingeniería de fiabilidad#
Un sistema distribuido es aquel en el que el fallo de un ordenador que ni siquiera sabías que existía puede dejar inutilizable tu propio ordenador.
Leslie Lamport
La ingeniería de fiabilidad es la disciplina que se ocupa de diseñar un sistema para que siga prestando servicio aunque fallen algunas de sus partes. Parte de que los componentes, las dependencias y las redes fallarán, determina de antemano cómo detectar y contener cada fallo y mide si el sistema sigue cumpliendo lo prometido. La ingeniería de fiabilidad de sitios (SRE) convirtió esta disciplina en una práctica habitual en los servicios de software. En este apartado la aplicamos a la NAP.
La ingeniería de fiabilidad abarca toda la NAP: cada componente y todos los límites entre componentes, además del límite con la red. La Tabla 12.1 enumera esos límites. En cada uno se producen fallos distintos y hace falta diseñar una defensa antes de que se produzcan. En una NAP, el ordenador que no sabías que existía suele ser la Fuente de Verdad, el almacén de secretos o un dispositivo que nunca responde.
| Límite | Fallo habitual | Defensa |
|---|---|---|
| Del solicitante a la Presentación | Una ráfaga de solicitudes | La cola absorbe la ráfaga y la contrapresión reduce el ritmo de admisión |
| Del Orquestador a los procesos de trabajo | Pérdida de un proceso de trabajo, mensaje duplicado | Tiempos de espera máximos, tareas idempotentes |
| De la NAP a la Fuente de Verdad | Una consulta lenta, una lectura de datos obsoletos | Tiempos de espera máximos, réplicas de lectura, comprobaciones de vigencia de los datos |
| De la NAP a la Observabilidad | Retraso en la telemetría | Una ventana de conciliación |
| De la NAP a los servicios de la IDP | No se puede acceder al registro o al almacén de secretos | Bloquear la operación en caso de fallo, como se describe en el Capítulo 11 |
| Del proceso de trabajo a la red | Un bloqueo, un límite de frecuencia o la caída de un demonio de gestión o de la API de un controlador | Tiempos de espera máximos, un interruptor de circuito (Circuit Breaker), límites por destino |
Los apartados siguientes presentan las defensas por orden. La idempotencia permite repetir una operación con seguridad. Los mamparos, que deben su nombre a los compartimentos estancos de un barco, confinan el fallo a una parte de la NAP. Los tiempos de espera máximos, los interruptores de circuito y la contrapresión evitan que una dependencia lenta bloquee todo lo demás. Los dos últimos apartados tratan los fallos que se encadenan a través de varios límites y la caída completa de la NAP.
Idempotencia#
La idempotencia es la propiedad por la que aplicar una operación varias veces produce el mismo resultado que aplicarla una sola vez. En el software suele considerarse una característica práctica que permite reintentar las operaciones con seguridad. En la automatización de redes es un requisito para garantizar que el resultado sea correcto.
El Capítulo 6 trata la idempotencia en el dispositivo: cómo gestionan los módulos de Ansible, las operaciones NETCONF y las API declarativas el caso en que el cambio «ya se ha aplicado». Este apartado la trata en toda la NAP, donde cualquier mensaje o envío de configuración puede repetirse: un bus que entrega una tarea dos veces, un proceso de trabajo que se reinicia en plena ejecución o un envío cuya confirmación nunca llega.
Veamos el último caso. Un proceso de trabajo envía la configuración de la VLAN 412 a un conmutador del edificio B y la sesión de gestión se interrumpe antes de que el conmutador confirme la operación. El proceso de trabajo no puede saber si la VLAN 412 ya existe. Lo seguro es reintentar la operación. Si el envío es idempotente, al reintentarlo se comprueba que la VLAN 412 ya existe y el adaptador interpreta la respuesta «vlan-exists» como un éxito, tal como se describe en el Capítulo 10. Si el envío consiste en una secuencia de comandos CLI sin más, al reintentarlo puede ejecutarse dos veces la mitad de la secuencia o producirse un error que el flujo de trabajo interprete como un fallo real, lo que llevaría a revertir un cambio correcto.
Para añadir idempotencia a posteriori a un flujo de trabajo, hay que revisar cada operación que realiza y cada interacción con los dispositivos. Adaptarlo después tiene un coste elevado. Diseñarlo desde el principio para que sea idempotente cuesta menos. Representa los cambios mediante declaraciones de estado deseado (en lugar de secuencias imperativas) e incluye la comprobación del estado deseado en cada operación. Después, confirma cómo se comporta cada dispositivo para cada tipo de operación cuando el cambio ya se ha aplicado.
La idempotencia permite repetir una operación con seguridad. Limitar hasta dónde se propagan los efectos de una operación incorrecta es el cometido de la siguiente defensa.
Mamparos y dominios de fallo#
En un barco, los mamparos dividen el casco en compartimentos, de modo que una vía de agua solo inunda uno de ellos. El patrón Mamparo (Bulkhead), como lo denomina Michael Nygard en Release It!, aplica la misma idea al software: divide los recursos en particiones para que un fallo en una de ellas no pueda agotar los recursos de las demás. Los proveedores de servicios en la nube llaman a este mismo diseño arquitectura basada en celdas.
En la NAP, las particiones siguen los dominios de fallo, es decir, los límites dentro de los cuales queda contenido un fallo. Una jerarquía de tres niveles cubre la mayoría de las redes:
- Nivel de dispositivo: un solo dispositivo. Un fallo en este nivel afecta únicamente a ese dispositivo. Es la unidad más pequeña y todo diseño de fiabilidad debe funcionar correctamente a este nivel.
- Nivel de sede: todos los dispositivos de una sede geográfica o lógica. Un fallo en este nivel afecta a un grupo que se gestiona como una unidad. La sede suele ser la unidad natural que define el alcance del impacto de los cambios de red: un error de configuración de una VLAN en un campus afecta a ese campus.
- Nivel de región: todos los dispositivos de una región geográfica u organizativa. Un fallo en este nivel es un incidente grave se mire como se mire. El diseño de la NAP debe reducir al mínimo las circunstancias en las que un solo cambio puede afectar a toda una región.
La Figura 12.6 aplica esta jerarquía a los recursos de la propia NAP.
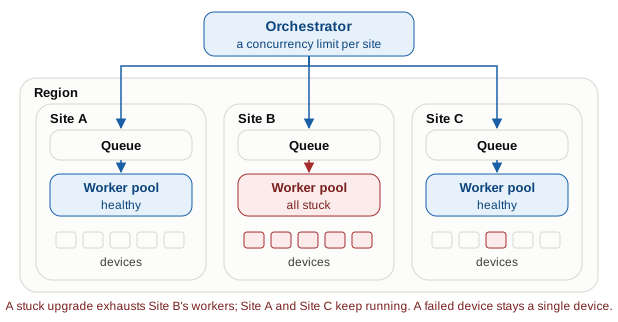
Asigna a cada sede su propio grupo de procesos de trabajo y su propia cola. Así llevas un paso más allá la afinidad de los procesos de trabajo descrita en el apartado Particionamiento de los procesos de trabajo. De este modo, si una actualización de firmware se bloquea en una sede, solo agota los procesos de trabajo de esa sede y el resto del parque de dispositivos conserva los suyos.
Aplica el mismo criterio a los componentes compartidos: un único Orquestador con un límite de concurrencia por sede evita que una sede con 1200 dispositivos acapare todos los puestos de ejecución que puede asignar el planificador. Aplica el patrón en cuanto una sola sede, un solo inquilino o un solo flujo de trabajo pueda saturar un recurso compartido. En la NAP del campus, ese momento llega con la primera operación masiva que abarca más de un edificio.
Los dominios de fallo también acotan los cambios de red. Si un error de software hace que se calcule mal la lista de destinos, es el límite que impone la NAP lo que impide que el cambio llegue a todo el parque de dispositivos. El Capítulo 11 trata este aspecto: su política de despliegue en el parque de dispositivos limita cada oleada a un dominio de fallo, y las oleadas y las aprobaciones determinan cuándo pasa un cambio al dominio siguiente.
Ambos tipos de límite resultan especialmente valiosos en los cambios masivos, como la actualización de firmware del relato inicial. En aquel caso, el equipo actualizó los 800 conmutadores en un solo lote, sin oleadas, y eso contribuyó al fallo: no había ninguna barrera entre el primer conmutador y el último. El Capítulo 13 explica cómo ese mismo límite acota el alcance de un flujo de trabajo comprometido.
Los mamparos contienen los fallos. Los tiempos de espera máximos, los interruptores de circuito y la contrapresión impiden que la lentitud de una dependencia acabe provocando uno.
Tiempos de espera máximos, reintentos, interruptores de circuito y contrapresión#
La red es fiable.
L. Peter Deutsch
Deutsch situó esa frase en primer lugar entre las falacias de la computación distribuida: supuestos que todo sistema distribuido da por ciertos y en los que todos se equivocan. La NAP da por cierto ese supuesto en cada uno de los límites de la Tabla 12.1.
El Capítulo 8 define estos patrones para el Orquestador en los apartados sobre reintentos y resiliencia en las interacciones entre bloques. Este apartado los aplica a gran escala en cada uno de los límites de la Tabla 12.1. Bastan cuatro reglas, cada una para un caso más grave que el anterior.
Toda llamada tiene un tiempo de espera máximo. Toda llamada que cruza un límite tiene un tiempo de espera máximo: tanto si un proceso de trabajo espera a un dispositivo como si el Orquestador espera a un proceso de trabajo o cualquier componente espera a la Fuente de Verdad. En el caso inicial, la espera entre el proceso de trabajo y la red no tenía límite, por lo que un solo conmutador que no respondía mantuvo ocupado un proceso durante más de dos horas y media. Un tiempo de espera máximo convierte una espera de duración desconocida en un fallo identificable ante el que la NAP puede actuar. Fíjalo según la clase de dispositivo y la operación: es normal que copiar una imagen de firmware lleve minutos, pero no que los lleve leer una tabla de VLAN.
Los reintentos tienen un límite y se espacian cada vez más. Un dispositivo que no responde puede estar sobrecargado, en pleno reinicio o averiado, y la NAP no puede distinguir la causa. Un reintento inmediato añade carga a un dispositivo que ya tiene dificultades. Aplica una espera exponencial entre intentos: espera 1 segundo para el primer reintento, 2 para el segundo, 4 para el tercero y así sucesivamente hasta un máximo. Tras un número predefinido de intentos, marca la operación como fallida y escala la incidencia.
Si una dependencia falla repetidamente, se interrumpen las llamadas a ella. Un interruptor de circuito cuenta los fallos consecutivos de las llamadas a una misma dependencia. Cuando se supera un umbral, el circuito se abre: las llamadas posteriores fallan de inmediato sin esperar a que venza el tiempo de espera. Si se aplica por dispositivo, evita que un conmutador que funciona mal consuma capacidad de los procesos de trabajo con intentos de conexión repetidos. Si se aplica por componente, una caída de la Fuente de Verdad genera de inmediato el error «Fuente de Verdad no disponible» y evita que se acumulen flujos de trabajo bloqueados. La Figura 12.7 muestra sus tres estados.
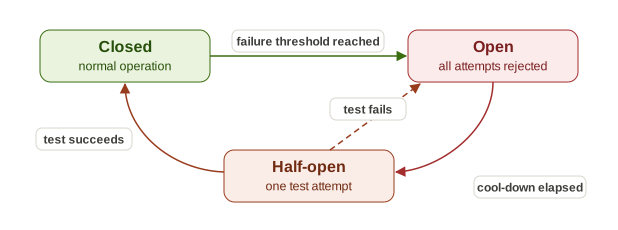
Tras un periodo de espera, el interruptor deja pasar una llamada de prueba. Si tiene éxito, el circuito se cierra. Si falla, el interruptor vuelve a abrirse durante otro periodo de espera.
Si una dependencia sigue activa pero responde con lentitud, se aplica contrapresión. La contrapresión reduce el ritmo del productor cuando el consumidor no puede seguirlo. Entre los componentes de la NAP, la proporciona el bus de mensajes, como explica el apartado Coordinación y mensajería basadas en eventos. En el límite con el dispositivo, el consumidor es su plano de gestión, y sus límites dependen del fabricante, del modelo y del firmware: hay topes documentados para las transacciones y sesiones, procesos de gestión que se reinician bajo carga y errores que afectan a operaciones concretas en determinadas versiones. En los parques de dispositivos brownfield, es frecuente que convivan cinco o más generaciones de firmware para un mismo modelo, por lo que los límites deben modelarse por versión de firmware, no por modelo.
Cómo se manifiesta el límite. Cada noche, una tarea de comprobación de cumplimiento recorre las tablas de los conmutadores mediante Simple Network Management Protocol (SNMP). Una noche, durante el recorrido, se inicia una carga masiva de configuración en el mismo chasis. El demonio de gestión se reinicia a mitad de la carga. El proceso de trabajo detecta que se ha cortado la sesión y no puede determinar si la configuración llegó a aplicarse antes del fallo. Es la incertidumbre más difícil de resolver de este capítulo. Tanto la carga como el recorrido eran correctos. Al coincidir, superaron un límite que nadie había documentado.
Modela estos límites como datos en lugar de codificarlos: guárdalos como atributos del tipo de dispositivo y del firmware en la Fuente de Verdad y léelos al programar las tareas para fijar la concurrencia y la política de reintentos de cada dispositivo. Busca los valores primero en la documentación del fabricante, después consúltalos con su equipo de soporte técnico y solo en último término recurre a una prueba de carga controlada con un dispositivo de laboratorio. Descubrir el límite de un dispositivo en producción es precisamente el fallo que este diseño pretende evitar.
Cada una de estas defensas protege un límite. Los fallos peligrosos son los que atraviesan varios.
Fallos en cascada#
El escenario inicial no consistió en un fallo aislado. Fue una cascada y la Figura 12.8 muestra su estructura.
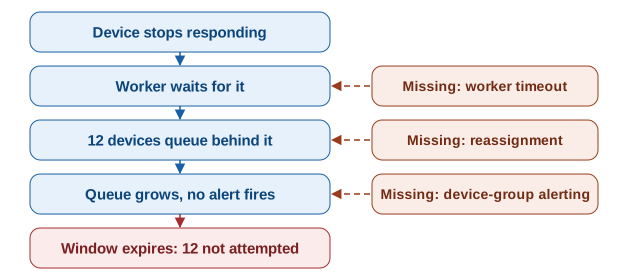
Cada mecanismo que faltaba se ha descrito antes en este apartado o en el apartado Diseño mínimo viable de fiabilidad: un tiempo de espera máximo para el proceso de trabajo, la reasignación de su plaza cuando vence ese plazo y las alertas de cola por grupo de dispositivos. Juntos, interrumpen la cascada en tres puntos: antes de que el proceso de trabajo quede ocupado indefinidamente, antes de que se bloqueen los dispositivos que vienen detrás y antes de que el atasco pase inadvertido.
Con esos tres mecanismos, el escenario se resuelve de otra manera. A las 03:23, tres minutos después de que se detenga el proceso, vence el plazo durante el que el proceso de trabajo número 48 espera una respuesta del plano de gestión. El vencimiento queda registrado en la cola de mensajes no entregados junto con el identificador del dispositivo, el último estado conocido del plano de gestión y la marca de tiempo exacta. Los 12 dispositivos en cola pasan a los siguientes procesos de trabajo disponibles y sus actualizaciones terminan a más tardar a las 03:45.
A las 03:46, la persona de guardia recibe un aviso: dispositivo sw-b-acc-17, tiempo de espera del plano de gestión agotado tras 3 minutos, emplazamiento Edificio B, 0 dispositivos más en la cola. La ventana de mantenimiento se cierra con 799 actualizaciones completadas con éxito, 1 dispositivo en la cola de mensajes no entregados con un registro completo del fallo para investigarlo por la mañana y ninguna laguna sin explicar en el registro de auditoría.
Una cascada así no es excepcional. En los sistemas distribuidos sometidos a presión, los fallos tienden a propagarse en cascada porque los componentes diseñados para detectarla e interrumpirla son los mismos que sufren esa presión. La ingeniería de fiabilidad consiste en diseñar esos mecanismos de detección e interrupción antes de que llegue la presión.
Las cascadas también son más frecuentes de lo que parecen, porque los fallos que las desencadenan son los que nadie previó. Nadie había incluido «un conmutador que ni responde ni rechaza la conexión» en la lista de riesgos. No puedes enumerar todo lo que desconoces, así que no diseñes defensas solo para las causas que puedas nombrar. Establece protecciones basadas en los síntomas: un tiempo de espera máximo en cada llamada, un porcentaje de fallos a partir del cual se interrumpe cada despliegue y una alerta sobre el avance de cada grupo de dispositivos. Así se contiene el fallo que no habías imaginado cuando su alcance aún es reducido.
En esa segunda versión del caso hay otro supuesto implícito: que una actualización fallida se puede revertir dentro de la misma ventana. En el caso del firmware, la reversión exige un segundo reinicio planificado para cargar la imagen anterior, ya sea desde la partición de arranque alternativa o mediante una variable de arranque fijada antes de la actualización. La reversión lleva tanto tiempo como la actualización, a veces más, y puede fallar de las mismas maneras. Reserva ese tiempo antes de que se abra la ventana. El tiempo asignado a cada tanda incluye su propia reversión. Si no da tiempo a actualizar y revertir una tanda antes de que se cierre la ventana, esa tanda no se inicia.
Todas estas defensas presuponen que parte de la NAP sigue en funcionamiento. A veces no queda ningún componente operativo.
Indisponibilidad de la NAP y continuidad de las operaciones manuales#
Todos los modos de fallo analizados en este capítulo presuponen que al menos una parte de la NAP funciona: algunos procesos de trabajo terminan sus tareas, el Orquestador puede programarlas y la cola se va vaciando. La ingeniería de fiabilidad aborda los fallos parciales y el funcionamiento en condiciones degradadas. Pero un incidente de red puede provocar otra clase de fallo: la indisponibilidad total de la NAP. No se puede acceder al Orquestador, el almacén de artefactos está caído y no se puede ejecutar ningún flujo de trabajo de cambio. Esto ocurre. Una NAP que es en sí misma un sistema distribuido llegará a quedar completamente fuera de servicio, aunque sea por poco tiempo, como consecuencia de las mismas condiciones de fallo que está diseñada para gestionar.
Antes de confiar el proceso de cambio a la NAP, quien trabaja en ingeniería de redes necesita una respuesta a esta pregunta: ¿cómo se opera cuando la NAP no está disponible y aun así hay que hacer cambios en la red?
La solución es preparar de antemano un modelo operativo. La Figura 12.9 lo muestra desde el momento en que cae la NAP hasta que vuelve a funcionar. El modelo se describe en este apartado, al que remiten el Capítulo 11 y el Capítulo 13 para consultar el procedimiento operativo en caso de caída.
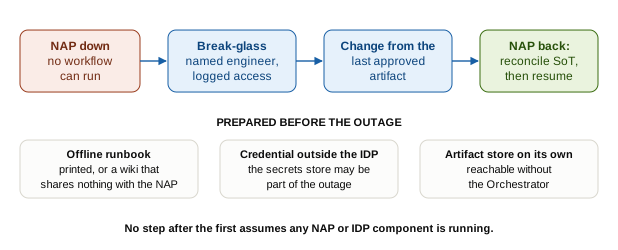
Dos elementos permiten seguir operando la red durante la caída. El primero es la vía de acceso de emergencia del apartado Cuando la vía está bloqueada del Capítulo 11: permite al personal de ingeniería designado acceder a los dispositivos sin la NAP y cuenta con su propio registro de auditoría. El segundo es el almacén de artefactos. Los artefactos más recientes aprobados para producción recogen la última intención conocida de la NAP. Por tanto, si la NAP se detiene en plena operación, el último artefacto desplegado en cada dispositivo es la referencia para cualquier cambio manual: quien realiza el cambio sabe qué pretendía desplegar la NAP porque el artefacto existe y se validó antes del fallo. Antes de cualquier ventana de mantenimiento u operación masiva, confirma que puedes acceder al almacén y recuperar los artefactos vigentes.
Ambos elementos dependen de tres preparativos previos a la caída:
- El almacén de artefactos debe ser accesible sin el Orquestador. Si solo se puede acceder al almacén a través de la API del Orquestador, cuando este cae, el almacén también queda inaccesible.
- La credencial de acceso de emergencia debe guardarse fuera del almacén de secretos de la NAP. Ese almacén pertenece a la IDP, y una caída de la IDP es una de las causas por las que la NAP puede quedar fuera de servicio.
- El procedimiento operativo de guardia debe poder seguirse aunque nada esté en funcionamiento. Documenta el procedimiento de acceso de emergencia y la consulta de artefactos sin presuponer que haya algún componente de la NAP o de la IDP operativo. Si el procedimiento está en una wiki alojada en la misma IDP, deja de estar disponible cuando esta cae. Hay dos soluciones que funcionan: una copia impresa en un lugar con protección física, como un armario de bastidores o una caja fuerte del centro de operaciones de red, o una wiki independiente, accesible fuera de banda y sin componentes ni credenciales en común con la NAP ni con la IDP. Ensaya el procedimiento y actualízalo después de cada uso.
Cuando la NAP se recupera, el primer paso antes de reanudar los despliegues automatizados es la conciliación con la Fuente de Verdad que prescribe la sección Cuando el camino está bloqueado del capítulo 11. Antes de que la NAP aplique nuevos cambios automatizados, hay que conciliar con la Fuente de Verdad el estado de todos los dispositivos que se hayan modificado manualmente durante la interrupción. Si la NAP reanuda los despliegues en un dispositivo cuyo estado desconoce tras una intervención manual, los resultados diferirán de los que cabría esperar según el estado deseado que recoge la Fuente de Verdad.
Las réplicas no son copias de seguridad. Una réplica de lectura protege a la Fuente de Verdad frente a la pérdida de un servidor, pero una escritura masiva errónea se propaga a todas las réplicas en cuestión de segundos. Haz copias de seguridad de la base de datos de la Fuente de Verdad, del almacén de artefactos y del estado de los flujos de trabajo del Orquestador, y decide cuántos datos recientes puedes permitirte perder en cada restauración. En el caso de la intención, perder una hora de propuestas es un contratiempo. Perder un día puede obligarte a reconstruir cambios que ya están en la red. Después, restaura esas copias periódicamente en un entorno de pruebas. Si nadie ha restaurado una copia de seguridad, confiar en ella es una esperanza, no un plan.
Cada medida de protección de esta sección necesita pruebas de que funciona: datos de producción y ensayos que te permitan conocer sus límites antes de descubrirlos en producción.
Observación y pruebas de la NAP a gran escala#
A gran escala, hay que observar la NAP como cualquier otro servicio y someterla a pruebas antes de descubrir sus límites en producción. Esta sección aborda ambas tareas por orden: primero los niveles de servicio de la NAP, después el trazado entre sus componentes y, por último, las pruebas de carga y de caos. El objeto de esta sección es la propia NAP y aquí se definen sus métricas. El capítulo 7 enumera las señales que hay que recoger, y el capítulo 11 sitúa en la IDP la pila que las almacena. El capítulo 15 aplica las mismas herramientas de nivel de servicio a los servicios de red que presta la NAP.
Aumentar la escala también aumenta el coste, y al observar la plataforma puedes ver de dónde viene. Cada proceso de trabajo añade consumo de cómputo, la cantidad de datos que retiene el bus de mensajes crece con el volumen de mensajes y cada solicitud genera más datos de traza: conserva las trazas de todas las solicitudes fallidas o lentas y toma una muestra de las que se procesan con normalidad. La telemetría de red suele ser la partida de mayor coste, y la sección Persistencia del capítulo 7 trata su muestreo y retención. El escalado automático de la IDP (capítulo 11) te ahorra el trabajo de añadir procesos de trabajo, pero aún tienes que decidir cuándo añadirlos: fija un mínimo y un máximo, y ajústalo para que responda al crecimiento sostenido de la cola en vez de a un pico que desaparece en unos minutos.
Niveles de servicio de la NAP#
Los niveles de servicio convierten las métricas de salud de la NAP en un compromiso: qué pueden esperar de ella quienes la operan y los flujos de trabajo que dependen de ella. El compromiso importa más allá del equipo de red, porque otros equipos lo toman como base para asumir sus propios compromisos. Un equipo de aplicaciones que necesita una VLAN para publicar una versión solo puede comprometerse con una hora de publicación si sabe cuánto se tarda en aprovisionar la VLAN.
Los servicios de red del capítulo 15 se construyen a partir de los objetivos de la NAP. Una NAP sin un nivel de servicio explícito obliga a cada equipo que depende de ella a hacer conjeturas, y cada conjetura oculta un riesgo en el compromiso que asume otra persona. La jerarquía de tres niveles de SRE aporta el vocabulario:
Un indicador de nivel de servicio (SLI) es una medida cuantitativa de un aspecto concreto del comportamiento del servicio. La NAP tiene cuatro:
- Tiempo de finalización de una solicitud: desde que se presenta la solicitud hasta que se verifica el resultado.
- Tasa de éxito de los cambios: la fracción de solicitudes que se completan. Desglosa los resultados por punto de control para encontrar la causa de los fallos: una tasa de fallos elevada en el control de integridad de la SoT apunta a un problema de calidad de los datos, y una tasa elevada en la simulación indica que la cobertura del laboratorio se está quedando atrás respecto a la red.
- Tiempo hasta la primera respuesta útil: el tiempo que transcurre hasta que quien presenta la solicitud recibe un primer resultado que le permite actuar. Es la métrica que perciben quienes usan la plataforma, y el capítulo 11 explica por qué determina si el equipo de ingeniería sigue el Camino recomendado (Golden Path).
- Tiempo de vaciado de la cola: cuánto tarda en vaciarse la cola al ritmo actual de llegada de solicitudes.
Algunos de estos indicadores dependen de la IDP: la capacidad del entorno de ejecución determina el tiempo de vaciado de la cola, y la latencia del registro se suma al tiempo de finalización. Haz un seguimiento de los niveles de servicio de la propia IDP como datos de entrada para que, si el servicio se degrada, las métricas apunten a la capa correcta.
En los parques de dispositivos brownfield donde los equipos heredados solo admiten sondeo mediante SNMP o syslog, la validación posterior a cada tanda debe esperar entre dos y tres intervalos de sondeo antes de dar un resultado. Refleja ese plazo más largo en los objetivos de cada tipo de dispositivo en lugar de fijar un único umbral global.
Un objetivo de nivel de servicio (SLO) es el valor objetivo de un SLI: «el percentil 95 del tiempo de finalización de los flujos de trabajo debe ser inferior a 15 minutos». Los SLO son objetivos internos. Definen qué significa que la NAP esté «en buen estado». Incumplir un SLO es una señal operativa, no un incumplimiento contractual. Significa que la fiabilidad de la NAP se está deteriorando y que hay que investigar la causa.
Para la NAP del campus, estos son unos objetivos iniciales concretos, ajustados al alcance real de cada flujo de trabajo. Para añadir una VLAN en los 24 conmutadores del edificio B, el p95 del tiempo de finalización del flujo de trabajo se mantiene por debajo de 8 minutos. La actualización del firmware de los 800 dispositivos del parque se completa dentro de su ventana de mantenimiento, con un p95 del tiempo de actualización por dispositivo inferior a 20 minutos, desde la preparación de la imagen hasta la verificación, pasando por el reinicio.
El SLO de la tasa de éxito de los cambios es del 99,5 % en cualquier ventana móvil de 30 días. Estas cifras son alcanzables en una NAP bien instrumentada y dan al equipo una referencia antes de que el primer incidente revele qué significa en la práctica «degradado».
Un acuerdo de nivel de servicio (SLA) es un compromiso con quienes operan la NAP y con los equipos que dependen de ella. La sección Niveles de servicio de los servicios de red del capítulo 15 aplica el mismo modelo, desde la base, a los servicios de red que presta la NAP. El SLA se deriva del SLO dejando un margen. Si el SLO interno de la NAP fija un percentil 95 inferior a 15 minutos, el SLA acordado con quienes consumen el servicio debe fijar un valor que la NAP pueda cumplir incluso bajo presión.
La Figura 12.10 muestra cómo se relacionan los tres.
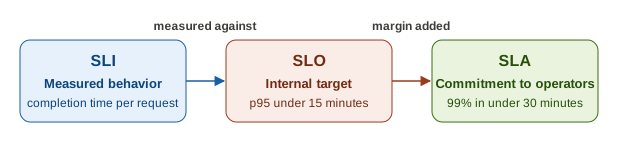
El Presupuesto de errores es el margen de fallo que permite el SLO. Con un SLO del 99,5 % para la tasa de éxito de los cambios en 30 días, el presupuesto es del 0,5 %: unos cinco cambios fallidos por cada mil. El SLA es menos exigente que el SLO, de modo que gastar el presupuesto nunca supone incumplir el compromiso con quienes operan la NAP. Los equipos que gestionan la NAP como un producto utilizan el presupuesto de errores para tomar decisiones explícitas. Cuando queda suficiente presupuesto, el equipo tiene margen para acometer cambios de mayor riesgo. Cuando se agota, el trabajo de fiabilidad tiene prioridad sobre cualquier riesgo nuevo. Los incidentes de fiabilidad consumen presupuesto de forma involuntaria. Al acometer cambios arriesgados, el equipo lo gasta de forma deliberada.
Empieza por la tasa de éxito de los cambios. Es la única métrica que responde directamente a la pregunta de si la NAP cumple su función. Una NAP con una tasa de éxito de los cambios del 95 % tiene un problema, por muy rápida que sea. El tiempo de finalización solo importa una vez que la NAP completa los cambios con éxito: de poco sirve fallar deprisa. El tiempo de vaciado de la cola es un indicador temprano de saturación que solo cobra sentido cuando tienes una referencia del funcionamiento normal con la que compararlo. Por tanto, instrumenta primero la tasa de éxito de los cambios (¿funciona?), después el p95 del tiempo de finalización (¿funciona lo bastante rápido?) y, por último, el tiempo de vaciado de la cola (¿sigue el ritmo de la demanda?).
Los niveles de servicio indican si la NAP cumple su compromiso. Cuando lo incumple, el trazado indica dónde.
Trazado distribuido de los flujos de trabajo#
En un solo cambio de red intervienen varios bloques arquitectónicos: la Fuente de Verdad proporciona la intención, el Orquestador programa el flujo de trabajo, el Ejecutor aplica la configuración y la pila de Observabilidad registra el resultado. Cada uno de estos puntos de interacción corresponde a un sistema distinto. Cuando se produce un fallo entre dos de ellos, por ejemplo, al pasar una tarea del Orquestador al Ejecutor o al consultar la Fuente de Verdad desde un proceso de trabajo, el síntoma se manifiesta en un extremo y la causa está en el otro. El flujo de trabajo no se completó. La consulta a la Fuente de Verdad agotó el tiempo de espera porque una réplica de lectura iba con retraso.
El trazado distribuido conecta estos puntos de interacción en una sola traza que abarca toda la ejecución del flujo de trabajo. Cada componente propaga un identificador de traza a través de sus operaciones. Tanto si el flujo de trabajo se completa como si falla, se puede consultar la traza completa: muestra la secuencia de operaciones, los tiempos de cada una y el punto en el que se produjo cualquier fallo.
El fallo al pasar la tarea del Orquestador al Ejecutor puede correlacionarse con la consulta a la Fuente de Verdad inmediatamente anterior. El pico de latencia de esa consulta puede correlacionarse con la exportación programada que se ejecutaba al mismo tiempo. OpenTelemetry es el estándar abierto de uso común para el trazado distribuido: sus bibliotecas propagan el contexto de la traza entre componentes, y sistemas como Jaeger o Grafana Tempo almacenan y muestran el resultado. La Figura 12.11 muestra el aspecto de la traza de una solicitud de cortafuegos.
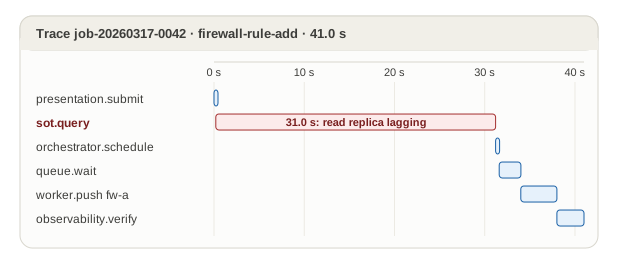
Para quien presentó la solicitud, esta simplemente tardó en completarse. La traza muestra que, de los 41 segundos que tardó, 31 correspondieron a una sola consulta a la Fuente de Verdad sobre una réplica de lectura que iba con retraso. El registro de un componente aislado no habría revelado esa causa.
Una traza generada de este modo también sirve como evidencia de auditoría. La sección Evidencias: cómo demostrarlo del capítulo 13 explica cómo conseguir que ese registro de auditoría esté completo, pueda consultarse y permita detectar cualquier manipulación, de modo que la traza distribuida sirva como evidencia de gobernanza además de como herramienta de depuración.
La sección Resiliencia en los límites entre bloques del capítulo 8 define cómo se diseñan esos límites. El trazado distribuido los hace visibles: es el mecanismo que permite al equipo de automatización de redes determinar si un fallo en el límite entre dos bloques sigue un patrón recurrente o es un hecho aislado.
La observación muestra cómo se comporta la NAP con la carga actual. Las pruebas muestran cómo se comportará con la carga que tendrá.
Pruebas de carga#
Las pruebas de carga determinan la máxima tasa de procesamiento que puede mantener la NAP: ¿cuántas ejecuciones simultáneas de flujos de trabajo puede gestionar antes de que aumente la latencia, suba la tasa de fallos o la cola crezca sin límite? La prueba envía flujos de trabajo a un ritmo cada vez mayor y mide cómo se comporta la NAP en cada escalón de carga. Fíjate en el ritmo al que empieza a degradarse el rendimiento de la NAP. Ese punto es más útil que el de colapso porque permite al equipo de automatización de redes saber qué margen queda desde la carga actual, medida con los mecanismos de observabilidad de la propia NAP. La Figura 12.12 muestra la forma de una curva de carga típica.
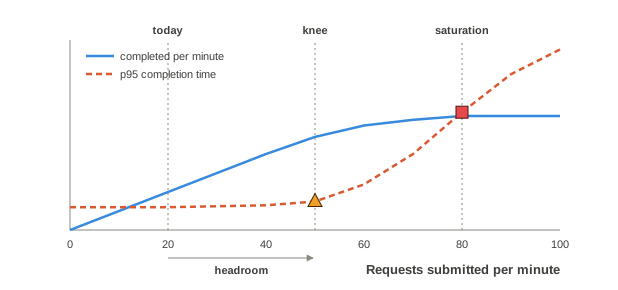
Para planificar la capacidad, toma como referencia el codo de la curva, donde empieza a subir el percentil 95 del tiempo de finalización. El punto de saturación llega después. La distancia entre la carga actual y el codo es tu margen de capacidad. Cuando el crecimiento consuma la mitad de ese margen, añade capacidad o empieza a aplicar el siguiente patrón de escalado.
Para estas pruebas sirven las herramientas habituales de pruebas de carga: Locust (basada en Python, programable mediante scripts y adecuada para servicios que hacen un uso intensivo de las API), k6 (JavaScript, con soporte nativo para Hypertext Transfer Protocol (HTTP) y WebSocket) y Gatling (basada en la JVM, con informes detallados). Todas permiten reproducir los patrones de envío de flujos de trabajo que admite la NAP. La adaptación principal consiste en parametrizar la prueba con cargas útiles realistas para los flujos de trabajo en lugar de usar peticiones HTTP genéricas.
Las pruebas de carga sostenida son distintas de las pruebas de picos de carga. Una NAP que gestiona 200 flujos de trabajo simultáneos durante 10 minutos quizá no pueda gestionarlos durante 8 horas: las fugas de memoria, el crecimiento de los archivos de registro, el agotamiento del conjunto de conexiones a la base de datos y otras limitaciones de recursos que se agravan poco a poco solo se manifiestan bajo carga sostenida. La prueba debe durar lo suficiente para que estos efectos salgan a la luz.
Prueba un componente cada vez. Para obtener resultados significativos, no necesitas hacer las pruebas con dispositivos en servicio ni con sistemas externos reales. Simular las integraciones permite aislar el componente que pruebas: si solo quieres medir la tasa de procesamiento de los procesos de trabajo, una Fuente de Verdad simulada que devuelve datos predecibles elimina la Fuente de Verdad como variable. Una API de dispositivo simulada que introduce una latencia configurable te permite probar cómo se comportan los procesos de trabajo cuando los dispositivos responden despacio, sin necesidad de disponer de un dispositivo real que sea lento. Una vez que tengas mediciones de referencia para cada componente, prueba la NAP en su conjunto. Si la prueba conjunta falla y careces de esas referencias, sabrás que algo se ha saturado, pero no qué componente.
Esto va más allá de las pruebas de carga: simular a propósito una degradación del rendimiento revela carencias de fiabilidad. Configura una Fuente de Verdad simulada para que tarde 5 segundos en responder y verás si los procesos de trabajo agotan su tiempo de espera, si se abre el interruptor de circuito y si la alerta de la cola se activa en el umbral adecuado. Todo ello sin tocar producción.
Las pruebas de carga permiten conocer los límites de una NAP que funciona correctamente. Las pruebas de caos permiten averiguar qué ocurre cuando una parte de ella falla.
Pruebas de caos#
Las pruebas de caos introducen fallos deliberadamente en la NAP para descubrir cómo se comporta en condiciones que las pruebas normales no reproducen. El problema de la actualización de firmware descrito al principio del capítulo podría haberse descubierto antes de la ejecución nocturna. Una prueba de caos que introdujera un dispositivo que nunca responde habría mostrado si la NAP imponía un tiempo máximo de espera a los procesos de trabajo. También habría mostrado si la cola reasignaba el dispositivo bloqueado y si el sistema de alertas detectaba el problema.
Empieza con un alcance limitado y en una fase avanzada. Los cuatro modos de fallo que se enumeran a continuación forman parte del diseño mínimo que se presenta al final del capítulo: se inyectan en un laboratorio para poner a prueba defensas que ya has implementado. Las pruebas de mayor alcance, como los experimentos en producción, corresponden a una NAP madura que ya cuenta con defensas básicas y ha medido su eficacia. Antes de llegar a ese punto, las pruebas de caos solo vuelven a sacar a la luz carencias que ya conoces.
Chaos Monkey, la herramienta de Netflix que popularizó la inyección deliberada de fallos en sistemas de producción, detiene instancias al azar en un servicio en ejecución para demostrar que el sistema tolera la pérdida de instancias. Aquí se aplica el mismo principio: detener al azar un proceso de trabajo, provocar una partición de red o bloquear el puerto de gestión de un dispositivo en un entorno de preproducción debería dar lugar a un comportamiento observable de la NAP y permitir que esta se recupere. Si no es así, la carencia debe incorporarse a la lista de trabajo pendiente sin esperar a la retrospectiva de un incidente.
Todas las pruebas de caos siguen el mismo ciclo, que se muestra en la Figura 12.13.
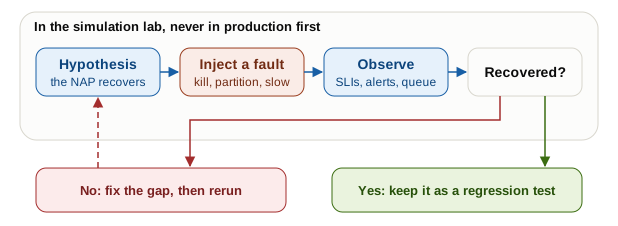
Empieza con una hipótesis que puedas comprobar mediante mediciones: «Si un proceso de trabajo se detiene en plena ejecución, la cola reasigna sus dispositivos en un máximo de 2 minutos y ningún dispositivo se configura dos veces». Inyecta el fallo y observa los SLI, las alertas y la longitud de la cola de la propia NAP. Si la NAP se recupera tal como preveía la hipótesis, conserva la prueba e incorpórala al conjunto de pruebas que se ejecuta antes de cada versión principal de la NAP. Si no se recupera como esperabas, añade la carencia a la lista de trabajo pendiente y repite la prueba una vez corregida.
Conviene empezar por inyectar estos cuatro modos de fallo:
- Un proceso de trabajo que termina de forma inesperada en pleno despliegue, con operaciones en curso que pueden haberse completado o no antes del fallo.
- Una partición de red entre el Orquestador y los procesos de trabajo que impide al Orquestador conocer el estado de esos procesos mientras siguen intentando ejecutar operaciones.
- Una Fuente de Verdad que responde despacio o devuelve errores, para comprobar si los procesos de trabajo gestionan de forma controlada los fallos de esa dependencia o se bloquean indefinidamente.
- Un dispositivo que acepta conexiones pero nunca envía una respuesta, para comprobar cómo se comporta el proceso de trabajo cuando se agota el tiempo de espera.
Puedes simular todas estas integraciones y ajustar su comportamiento en lugar de usar sistemas de producción reales (quizá aún no estés en condiciones de hacer pruebas en producción). Por ejemplo, el entorno de simulación del Capítulo 10 es un entorno adecuado para las pruebas de caos: ofrece un parque de dispositivos realista sin las consecuencias de los fallos en producción. Una prueba de caos que provoca la caída de procesos de trabajo mientras operan sobre una topología de campus simulada produce en la NAP los mismos modos de fallo que un incidente en producción sin afectar a los usuarios reales.
Una vez descritas las defensas, las evidencias y las pruebas, queda por decidir por dónde empezar.
El diseño mínimo viable de fiabilidad#
Ya conoces el modelo completo de fiabilidad. ¿Por dónde empiezas si tu NAP ya ejecuta cambios masivos? Por las cinco etapas de la Figura 12.14. Cuatro se implementan en la NAP y la IDP proporciona la otra, el plano de control de alta disponibilidad. Cada etapa resuelve una carencia que el incidente inicial puso de manifiesto o habría puesto de manifiesto a continuación, y cada una es útil por sí sola.
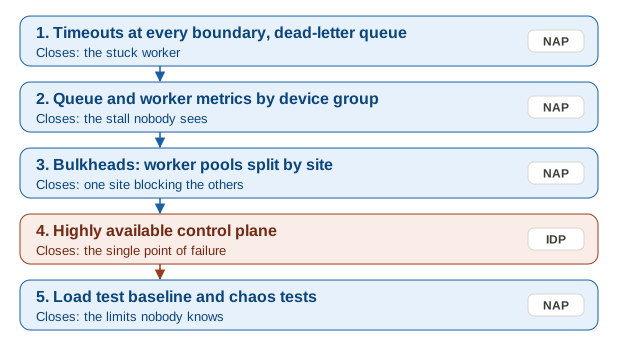
Tiempos máximos de espera en cada límite, con una cola de mensajes no entregados (NAP). Toda llamada que atraviesa uno de los límites de la Tabla 12.1 tiene un tiempo máximo de espera. Cada operación que un proceso de trabajo ejecuta en un dispositivo también tiene el suyo, configurado por clase de dispositivo y tipo de operación. Cuando se agota el tiempo de espera, la operación se marca como fallida y se traslada a una cola de mensajes no entregados, donde queda un registro persistente con el identificador del dispositivo, el motivo del fallo, el último estado observado y la marca de tiempo exacta. Ningún proceso de trabajo puede quedar bloqueado indefinidamente por un dispositivo que no responde. La plaza que ocupaba se libera y se reasigna. Esta etapa se completa cuando ningún proceso de trabajo puede esperar indefinidamente la respuesta de un dispositivo y, cada vez que se agota el tiempo de espera, se genera un registro que se puede recuperar y que contiene el identificador del dispositivo, la marca de tiempo del fallo y el último estado conocido del dispositivo.
Métricas de las colas y de los procesos de trabajo por grupo de dispositivos (NAP). La longitud global de la cola no es el indicador adecuado para detectar la segunda carencia del caso inicial. Que haya doce dispositivos en espera en un sistema con 48 procesos de trabajo no es inusual. Que los doce estén en la misma sede mientras en todas las demás finalizan las operaciones sí indica un problema de fiabilidad. La alerta se activa por grupo de dispositivos: si los dispositivos con el mismo atributo de sede no avanzan mientras los de otras sedes completan sus operaciones, la persona de guardia recibe un aviso que indica la sede concreta y el número de dispositivos. Estas métricas son también los primeros SLI de la sección Niveles de servicio de la NAP. Esta etapa se completa cuando un grupo de dispositivos bloqueado genera una alerta dentro de un plazo definido, aunque la tasa global de éxito parezca normal.
Compartimentos estancos: grupos de procesos de trabajo separados por sede (NAP). Cada sede dispone de su propio grupo de procesos de trabajo y de su propia cola, y el Orquestador limita el número de plazas de ejecución que puede asignar a una misma sede. Así, una sede bloqueada solo puede agotar sus propios procesos de trabajo. Esta etapa se completa cuando una prueba de caos bloquea los dispositivos de una sede y la tasa de procesamiento de todas las demás se mantiene sin cambios.
Un plano de control de alta disponibilidad (IDP). El Orquestador se ejecuta mediante réplicas en distintos hosts y almacena de forma persistente el estado de los flujos de trabajo. Sigue siendo un único Orquestador lógico, sin formar una federación. La Fuente de Verdad dispone de réplicas de lectura y la cola de trabajo conserva los mensajes, al igual que el bus de mensajes cuando dispongas de él. La IDP proporciona las réplicas, la antiafinidad descrita en el Capítulo 11 y las bases de datos gestionadas. A la NAP le corresponde ejecutarse sobre esa infraestructura. Esta etapa se completa cuando se puede detener cualquier instancia individual del plano de control en plena ejecución sin que se pierda ningún flujo de trabajo en curso.
Mediciones de referencia de carga y pruebas de caos (NAP). Mide el codo de la curva de carga de la NAP y escribe una prueba de caos para cada modo de fallo de la Tabla 12.1. Esta etapa se completa cuando se conoce la carga correspondiente al codo de la curva y todas las pruebas de caos se superan antes de cada versión principal de la NAP.
Las etapas 1 y 2 habrían bastado para resolver el incidente inicial. La actualización que terminó a las 06:00 con doce conmutadores sin parchear habría concluido a más tardar a las 03:45, con un solo dispositivo en la cola de mensajes no entregados y un registro completo. Las etapas 3 a 5 permiten contener el siguiente incidente en una sola sede, mantener el servicio si se pierde un host del plano de control y sustituir las conjeturas sobre la capacidad por mediciones. El modelo completo llega más lejos e incluye la federación, la coordinación basada en eventos y los presupuestos de errores.
Resumen#
Espera lo mejor y prepárate para lo peor. En el Capítulo 11 construimos la NAP. En este capítulo conseguimos que resista incluso en las peores circunstancias: una herramienta interna sobrecargada, una interrupción de la red, etc.
Este capítulo reúne lecciones y pautas extraídas de las prácticas de SRE. Define cómo se separan los planos de control y de datos de la NAP y cómo interactúan. Describe distintos patrones de particionamiento para repartir la ejecución y los datos, así como medidas de protección como los tiempos de espera máximos, los reintentos, los interruptores de circuito y la contrapresión. También explica cómo limitar el alcance del impacto de los cambios para que el resultado, es decir, el estado de la red, sea lo más fiable posible.
Además del rendimiento, también importa medir el nivel de servicio para dar sustento a la Escalera de Confianza (Confidence Ladder) que presenta el Capítulo 14 para fomentar la adopción de la automatización en la organización.
Y recuerda contar con que la NAP entera dejará de estar disponible en algún momento. Prepárate para tener un procedimiento claro que seguir cuando ocurra.
El Capítulo 13 aborda una cuestión aún pendiente: cómo garantizar que la NAP funcione conforme a una política de gobernanza.
Referencias#
- Designing Data-Intensive Applications, Martin Kleppmann (O’Reilly, 2017). La obra de referencia sobre el retardo de replicación, las estrategias de particionamiento, los modelos de consistencia y los compromisos que exige el procesamiento de flujos de datos.
- Site Reliability Engineering, Betsy Beyer, Chris Jones, Jennifer Petoff y Niall Richard Murphy (O’Reilly, 2016). Obra fundamental sobre el diseño de SLI, SLO y SLA y sobre los presupuestos de errores. El modelo de nivel de servicio de la sección Observación y pruebas de la NAP a escala se basa directamente en esta obra. (Texto completo disponible gratis en línea.)
- Release It!, 2nd Edition, Michael T. Nygard (Pragmatic Bookshelf, 2018). Obra que describió por primera vez los interruptores de circuito, los compartimentos estancos y los patrones de estabilidad. De ella proceden los patrones de compartimentos estancos, tiempo de espera máximo e interruptor de circuito de la sección Ingeniería de fiabilidad.
- Designing Distributed Systems, Brendan Burns (O’Reilly, 2018). Presenta patrones prácticos como el particionamiento, la coordinación basada en eventos y la contrapresión. Son directamente aplicables a los patrones de escalado de la sección Patrones de escalado.
- Chaos Engineering, Casey Rosenthal y Nora Jones (O’Reilly, 2020). Expone los principios que guían la inyección de fallos en sistemas en producción para detectar deficiencias de fiabilidad. Las pruebas de caos de la sección Observación y pruebas de la NAP a escala se basan en este marco.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo