Ingeniería de plataformas: cómo construir la plataforma de automatización de redes#
Una ingeniera de redes acaba de recibir una solicitud para crear una regla de cortafuegos. Un servicio nuevo necesitaba acceder al punto de conexión interno de autenticación por el puerto TCP 636. Diseñar la regla le llevó diez minutos. Conseguir que se desplegara, nueve días.
Ya había automatización: una Fuente de Verdad definía la política del cortafuegos, un Orquestador tenía listo un flujo de trabajo de despliegue y la pila de Observabilidad verificaba el resultado de la operación. Sin embargo, el equipo de redes no tenía una vía de acceso clara.
La ingeniera abrió un ticket en la herramienta de gestión de servicios de TI (ITSM) y después registró en otro sistema una solicitud aparte para que se aprobara el cambio. A continuación, ejecutó el script de comprobaciones previas en su portátil y actualizó el ticket con los resultados. Por último, la persona encargada de revisar el cambio, que estaba en otra zona horaria, se dio cuenta de que los resultados eran incorrectos porque se había actualizado el script. La ingeniera tuvo que volver a ejecutarlo. Como ves, solo la aprobación del cambio llevó seis días. Después hubo que esperar otros tres hasta la siguiente ventana de mantenimiento, el sábado a las 02:00.
El sábado, durante la ventana de mantenimiento, falló la sincronización de la configuración entre los dos cortafuegos del par de alta disponibilidad (HA), así que el flujo de trabajo de despliegue tuvo que aplicar el cambio a un dispositivo cada vez. Primero actualizó la unidad principal. Cuando todo estaba listo para iniciar la tarea en la segunda unidad, el Orquestador se detuvo porque la máquina virtual en la que se ejecutaba se había quedado sin espacio en disco (el recolector que se ejecutaba en esa misma máquina llevaba una semana recopilando todos los registros de depuración). El cortafuegos secundario se quedó sin la regla, pero nadie recibió un aviso porque el sistema de alertas se ejecutaba en la misma máquina virtual que había dado problemas.
Por último, el martes siguiente al cambio, falló una actualización del firmware del cortafuegos que no guardaba relación con el cambio, el tráfico pasó a la unidad secundaria y el nuevo servicio perdió el acceso al punto de conexión de autenticación. Pasó casi una hora hasta que alguien comparó las dos configuraciones y descubrió que faltaba la regla. También se dio cuenta de que el Orquestador estaba fuera de servicio. Para empeorar las cosas, al intentar recuperarlo, el equipo descubrió que el único ingeniero que sabía crear y operar la máquina virtual ya no trabajaba en la empresa y no había dejado en ningún repositorio documentación ni código que indicara cómo hacerlo. Recuperar la máquina virtual llevó cuatro días y, durante ese tiempo, el equipo aplicó todos los cambios a mano.
Puede que esta situación te resulte familiar. He visto muchos casos parecidos. Todo tenía su razón de ser: el ticket, la revisión y la ventana de mantenimiento. En esta historia hubo dos fallos básicos: faltaba una plataforma de automatización de redes cohesionada (existían los bloques arquitectónicos, pero no estaban conectados entre sí) y el entorno de ejecución era poco fiable y carecía del respaldo de una plataforma interna para desarrolladores. Cada problema requiere un enfoque distinto, pero hay que abordar ambos a la vez para construir una solución de automatización de redes que esté a la altura.
Este capítulo trata de ambas plataformas, del contrato entre ellas y de sus diferencias. Necesitas las dos para construir tu estrategia de automatización de redes. Cada una resuelve problemas distintos y de cada una se esperan cosas distintas.
Dos plataformas, una pila#
La palabra «plataforma» tiene demasiados significados en la automatización de redes. Para poder avanzar en este capítulo, primero tenemos que distinguirlos. En esta sección damos nombre a las dos plataformas, definimos cada una y explicamos qué promete a la capa superior.
Lee cualquier documento de diseño de automatización y encontrarás la palabra «plataforma» en tres sentidos. «El equipo de plataforma ha actualizado los agentes de ejecución» se refiere a la infraestructura de software compartida. «La plataforma ha rechazado mi cambio» se refiere al sistema de automatización de redes. «En el campo de plataforma figura EOS» se refiere al sistema operativo de un dispositivo. Los tres usos son correctos en su contexto. Confundirlos lleva a errores concretos: un equipo de redes pide «una plataforma» al equipo de infraestructura y recibe agentes de ejecución de CI sin tener ni idea de cómo utilizarlos para desplegar un cambio de red.
A partir de aquí, el libro distingue tres términos:
- Plataforma interna para desarrolladores (IDP): la base compartida que permite compilar, desplegar y ejecutar cualquier software.
- Plataforma de automatización de redes (NAP): los bloques arquitectónicos de la parte 2, desplegados y conectados entre sí para formar un único producto que opera la red.
- Sistema operativo del dispositivo o servicio en la nube: el sistema operativo de red que ejecuta un dispositivo o el servicio de red en la nube que configura la NAP. En la parte 2 a veces se usaba «plataforma» para referirse a cualquiera de los dos.
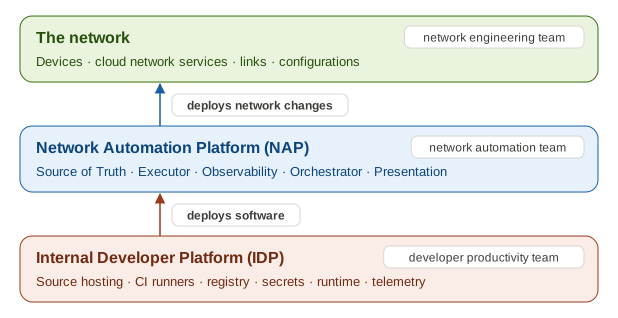
La palabra «plataforma» por sí sola solo se conserva en denominaciones establecidas, como ingeniería de plataformas o el patrón Contrato de plataforma (Platform Contract). La Figura 11.1 muestra cómo se superponen las tres capas.
La plataforma interna para desarrolladores
Una IDP es la base compartida que construye un equipo para que otros puedan entregar y ejecutar software sin tener que montar por su cuenta la infraestructura subyacente. Reúne alojamiento de código fuente, agentes de ejecución de CI, un registro de artefactos, un almacén de secretos, un entorno de ejecución, telemetría del software en ejecución e inicio de sesión único. Muchas IDP añaden un portal de autoservicio sobre esa base. En una empresa que desarrolla software, como ocurre en la mayoría, un equipo de producto no monta su propio sistema de CI ni su propio clúster de contenedores. Despliega su servicio en la IDP y el equipo responsable de esta mantiene la base en funcionamiento mientras crecen las decenas de equipos que la utilizan.
En el sector, a veces se usa «IDP» para referirse solo al portal. En este libro usamos el sentido más amplio: todo lo que un equipo necesita para compilar, desplegar y ejecutar software sin tener que ocuparse de su alojamiento.
Supón que otro equipo es responsable de la IDP. En este libro lo llamamos equipo de productividad de los desarrolladores, como en el capítulo 3. Puede que en tu organización se llame equipo de ingeniería de plataformas, de ingeniería de la nube o de experiencia de desarrollo. La mayoría de las organizaciones del tamaño al que se dirige este libro ya cuentan con un equipo así, que opera la IDP para quienes desarrollan aplicaciones. El equipo de automatización de redes es un usuario más de esa infraestructura compartida. Ese es el punto de vista de este capítulo: utilizas la IDP, negocias con sus responsables y no vuelves a construirla.
La plataforma de automatización de redes
La NAP es el diseño de la parte 2 puesto en servicio. La Fuente de Verdad, el Ejecutor, el Recolector, la Observabilidad, el Orquestador y la capa de Presentación se apoyan en el bloque de Red y están desplegados y conectados entre sí. Quien trabaja en ingeniería de redes puede presentar un cambio y seguirlo hasta que llega a producción sin tener que conocer el funcionamiento de cada bloque. El equipo de automatización de redes es responsable de la NAP.
La NAP es software, por lo que se ejecuta en la IDP. Pero no es una aplicación más. Accede a la red de gestión, guarda credenciales de acceso a todos los dispositivos, ejecuta despliegues que duran horas y necesita un laboratorio de dispositivos emulados donde hacer pruebas. Esas necesidades determinan qué le pides a la IDP, como muestra la sección Qué esperar de la IDP.
Los contratos entre capas#
Cada capa existe para ofrecer una garantía a la capa superior, y las dos garantías comparten un verbo. La IDP despliega software. La NAP despliega cambios de red.
La IDP garantiza al equipo de automatización de redes que su código se compila siempre de la misma manera, que sus componentes se ejecutan en un entorno reproducible, que sus artefactos se versionan y se pueden recuperar y que sus tareas reciben credenciales de corta duración. La NAP garantiza al personal de ingeniería de redes que sus cambios se validan, se despliegan de forma segura, se supervisan y quedan registrados, todo ello por una vía que pueden utilizar por su cuenta.
De ahí se derivan dos consecuencias de las que depende el resto del capítulo.
- «Despliegue» tiene dos significados. Desplegar una nueva versión del Orquestador es un despliegue de software en la IDP. Desplegar una regla de cortafuegos es un cambio de red que se realiza a través de la NAP. El procedimiento y el alcance del impacto son distintos en cada caso. La sección Despliegue de la NAP en la IDP trata el primer caso y Un cambio de red de principio a fin, el segundo.
- Un fallo en una capa inferior se manifiesta en todas las capas superiores. La caída del orquestador en el ejemplo inicial fue un fallo propio de la IDP: faltaba un entorno de ejecución reproducible. El fallo se manifestó en la red, con el cambio aplicado solo a uno de los dos cortafuegos. Cada capa es responsabilidad de un equipo distinto, pero un fallo en una de ellas repercute en las demás.
Así funcionan las dos capas cuando existen ambas. Pocos equipos cuentan con las dos desde el principio, y la capa que les falta determina qué deben construir a continuación. Ahora te muestro las cuatro combinaciones.
Cuatro formas de ejecutar la automatización de redes#
El capítulo 1 situaba a los equipos en una escala de madurez según el alcance de su automatización, desde las tareas automatizadas con scripts hasta las redes autónomas. Esta sección añade un segundo eje: la infraestructura sobre la que se ejecuta esa automatización. Ambos ejes evolucionan a la par. Las tareas automatizadas con scripts suelen ocupar la primera celda de la matriz que se muestra a continuación, la automatización de flujos de trabajo tiende a estancarse en una de las dos etapas intermedias y los sistemas basados en la intención necesitan la infraestructura de la celda objetivo.
Los equipos llegan al objetivo, una IDP sobre la que se ejecuta una NAP, siguiendo una trayectoria reconocible. El punto en el que se encuentran determina qué construyen a continuación. La Figura 11.2 sitúa las cuatro combinaciones en una matriz: con o sin IDP en la capa inferior y con o sin NAP en la superior.
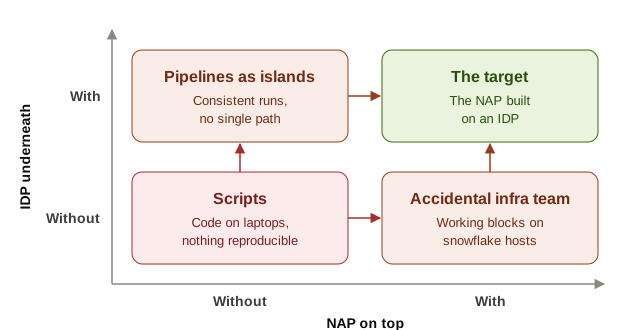
Veremos las cuatro celdas en el orden en que los equipos suelen recorrerlas.
Sin IDP ni NAP: scripts Alguien del equipo de ingeniería de redes escribe un script para aprovisionar VLAN. Funciona. Otra persona escribe uno para las reglas de cortafuegos y una tercera, para los vecinos Border Gateway Protocol (BGP). Los scripts se acumulan y empiezan a contradecirse porque cada uno parte de supuestos distintos sobre el estado de la red. Uno se escribió para Python 3.8 y falla sin avisar en la versión 3.11. Otro lleva incorporada una credencial que caducó la primavera pasada. Quien acaba de incorporarse al equipo de ingeniería de redes no tiene forma de saber cuál es el script de referencia ni si se ha probado alguno este año.
Aquí no se comparte nada, así que nada es reproducible. El código se guarda en portátiles y se ejecuta allí donde a alguien se le ocurre lanzarlo.
Una IDP sin NAP: cadenas de ejecución aisladas El siguiente paso suele ser trasladar los scripts al sistema de CI/CD de la empresa, que la IDP ya proporciona. Los cambios pasan por una cadena de ejecución. Las pruebas se ejecutan automáticamente. Los scripts ganan en fiabilidad porque se ejecutan siempre de la misma forma, en un runner en lugar de un portátil.
Pero la cadena se limita a ejecutar los scripts, sin organizarlos. Cada flujo de trabajo funciona como una isla, con su propia forma de recibir solicitudes, su propia validación y su propia visión de la red. Nada conecta la cadena de VLAN con la Fuente de Verdad que consulta la cadena de cortafuegos, y cada cadena repite las mismas comprobaciones de una forma ligeramente distinta. Por mi experiencia, esta es la situación actual de la mayoría de los equipos que dicen haber automatizado sus operaciones. En esta casilla se explican los nueve días del relato inicial: había herramientas de sobra, pero faltaba una vía común.
Una NAP sin IDP: un equipo de infraestructura por accidente El otro paso a medias es menos frecuente y más peligroso. Un equipo de automatización competente construye bien los bloques de la parte 2: una Fuente de Verdad con su modelo de datos, un orquestador con flujos de trabajo duraderos y una pila de recolección de datos. Como carece de una IDP donde ejecutarlos, el propio equipo los aloja en máquinas virtuales que crea a mano y configura de forma interactiva, y de las que hace copias de seguridad cuando alguien se acuerda.
La NAP funciona hasta que falla la infraestructura que la sustenta. Cada máquina virtual es única: las actualizaciones se posponen porque nadie sabe qué más se ejecuta en el host. Las credenciales se guardan en archivos de entorno porque no hay un almacén de secretos. En menos de dos años, el equipo dedica más tiempo a aplicar parches a los hosts que a mejorar los flujos de trabajo. Se ha convertido por accidente en un equipo de infraestructura, sin las competencias, el turno de guardias ni el mandato que ello requiere. Los cuatro días de reconstrucción del relato inicial muestran esta casilla en su peor momento: para restaurar el orquestador hubo que investigar a mano en vez de recurrir a la automatización.
Ambas plataformas: el objetivo y la retirada de lo anterior En la cuarta casilla, el equipo de automatización de redes construye y opera la NAP, y esta se ejecuta sobre una IDP cuyo buen funcionamiento corre a cargo de otro equipo. El equipo de automatización dedica su tiempo a los problemas de red. El equipo de productividad de los desarrolladores dedica el suyo a resolver los problemas del entorno de ejecución, del registro y de los runners para todos los equipos usuarios a la vez.
Pasar de una casilla a otra añade capas y conserva el trabajo anterior. Un equipo que está en la casilla objetivo sigue teniendo scripts, ahora como artefactos versionados y probados dentro de la NAP. Un equipo que llega al sistema con gobernanza del capítulo 13 sigue teniendo su NAP. La gobernanza añade capas de control por encima.
Recuerda que alcanzar el objetivo exige un plan explícito para retirar lo anterior. Si los scripts y las cadenas aisladas siguen funcionando junto a la NAP, surgen dudas sobre cuál es la vía oficial y el equipo tiene que repartir su atención. La transición se completa cuando se desactivan las vías antiguas (no cuando se construye la NAP). La sección Estrategias de migración explica cómo llegar a ese punto sin hacer el cambio de una sola vez.
El resto de este capítulo da por supuesto que estás en la casilla objetivo. El capítulo 12 examina qué ocurre cuando la NAP funciona a gran escala, y el capítulo 13, cómo demuestra la NAP que es digna de confianza.
El equipo del relato inicial sufría a la vez los problemas de ambos pasos a medias: sus bloques nunca llegaron a formar una vía común y se ejecutaban en hosts que nadie sabía reconstruir. En la casilla objetivo hay dos capas, cada una a cargo de un equipo. Las dos secciones siguientes las recorren de abajo arriba: primero, qué debe esperar el equipo de automatización de redes de una IDP que gestiona otro equipo y, después, qué debe incorporar a la NAP.
Qué esperar de la IDP#
Como profesional de la ingeniería de automatización de redes, utilizas la IDP y es otro equipo quien la construye. Tu trabajo consiste en saber qué puedes esperar de ella, detectar las carencias que pone de manifiesto la automatización de redes y pedir con antelación lo que falta. La Tabla 11.1 resume el contrato.
| Capacidad | Qué deberías recibir | Qué necesita además la NAP |
|---|---|---|
| Alojamiento del código fuente | Repositorios, revisiones, protección de ramas y webhooks | Posibilidad de invocar al Orquestador al fusionar cambios en un repositorio de intención |
| Runners de CI | Trabajos que se inician mediante commits, llamadas a la API o temporizadores | Runners con acceso al laboratorio para probar plantillas y definiciones de flujos de trabajo |
| Registro de artefactos | Imágenes y paquetes versionados con mecanismos de promoción | Configuraciones generadas a partir de plantillas e instantáneas de dispositivos, con información de procedencia y reglas de conservación |
| Secretos e identidad | Credenciales de corta duración para cada trabajo e inicio de sesión único | Credenciales de dispositivos con un ámbito limitado a cada ejecución y a cada sede |
| Entorno de ejecución | Alojamiento reproducible para los servicios | Servicios con estado, flujos de trabajo que esperan durante horas y procesos de trabajo con acceso a la red de gestión |
| Observabilidad | Registros, métricas y trazas del software en ejecución | Alertas que te siguen llegando cuando fallan los recolectores de la propia NAP |
| Capacidad de laboratorio | Entornos ajenos a producción | Recursos de cómputo para poner en marcha bajo demanda topologías de dispositivos emulados |
Los apartados siguientes recorren las filas en orden. Cada uno termina con la pregunta que debes plantear al equipo de productividad de los desarrolladores.
Alojamiento del código fuente y control de versiones#
Deberías disponer de repositorios con revisión de cambios, protección de ramas y un registro de quién fusionó qué cambios. Allí se guarda todo lo que rige el funcionamiento de la NAP: las definiciones de los flujos de trabajo, las plantillas, las definiciones de los controles de paso y el código de infraestructura que despliega los componentes de la NAP. El estado registrado en el Sistema de control de versiones (VCS) indica qué debe hacer la NAP. Cualquier divergencia es un error.
Conviven dos tipos de repositorios, cada uno con su propia gobernanza. Uno contiene la intención de red: los archivos de datos y los esquemas que utiliza la Fuente de Verdad, sujetos a las prácticas de gestión de datos del capítulo 4. El otro contiene el código de la propia NAP: las definiciones de los flujos de trabajo, los adaptadores del Ejecutor con sus plantillas, las definiciones de las cadenas de ejecución y los manifiestos de despliegue. Mantén sus estructuras separadas. En cierto sentido, el contenido de ambos es software: un cambio en una plantilla o en la definición de un flujo de trabajo activa una cadena de la IDP que lo pone a prueba, y ningún paso de esa cadena actúa sobre la red de producción.
Con los cambios de red ocurre algo distinto: se ejecutan como flujos de trabajo de cambio en el Orquestador de la NAP, no en las cadenas de la IDP. Esto se cumple tanto si la intención se guarda en una Fuente de Verdad relacional como si se guarda en un repositorio de intención, la variante GitOps. La sección Reduce la fricción con un Camino recomendado (Golden Path) compara las dos opciones. En ambos casos, el cambio pasa por los mismos controles. De lo contrario, el punto de entrada se convierte en una puerta lateral que permite eludirlos todos.
Pregunta: ¿puede una fusión de cambios en nuestro repositorio de intención invocar la interfaz de programación de aplicaciones (API) del Orquestador?
Runners de CI#
Un runner de una cadena de ejecución es un planificador que ejecuta etapas de la cadena bajo demanda cuando lo activa un commit, una llamada a la API o un temporizador. Deberías disponer de grupos de runners cuyo dimensionamiento y mantenimiento con parches corran a cargo de otro equipo. La NAP utiliza los runners para su propio software: compila y prueba sus componentes y prueba las plantillas y las definiciones de los flujos de trabajo antes de publicarlas. En la variante GitOps, los runners también pueden ejecutar las comprobaciones de datos que activa un commit en el repositorio de intención.
Los cambios de red no se ejecutan aquí. Los ejecutan los procesos de trabajo del Orquestador en el entorno de ejecución, y son esos procesos los que necesitan acceso a la red de gestión de dispositivos. En los runners la carencia es más concreta: los runners compartidos suelen estar en una red de aplicaciones sin acceso a tu laboratorio, y para probar una plantilla con dispositivos emulados hace falta ese acceso.
Algunos equipos prescinden de esa separación y ejecutan sus flujos de trabajo de cambio en runners de CI, con el sistema de CI como Orquestador. Es una implementación válida: una herramienta aloja el bloque del Orquestador. En ese caso, los runners necesitan el acceso a la red de gestión que esta sección reserva para los procesos de trabajo, y el sistema de CI debe proporcionar lo que el capítulo 8 exige a un Orquestador: estado persistente para ejecuciones que duran horas, controles de aprobación y resultados por dispositivo. Comprueba primero el límite de duración de los trabajos. La sección Recepción de solicitudes muestra en qué punto ese límite supone un problema.
Pregunta: ¿podemos disponer de un grupo de runners con acceso a nuestro laboratorio que utilice las mismas imágenes y reciba los parches con el mismo calendario que los grupos compartidos?
Registro de artefactos y contenedores#
Un almacén de artefactos es un repositorio versionado para los resultados que las etapas de una cadena de ejecución producen y promueven de un estado a otro. Deberías disponer de uno para las imágenes de contenedores y los paquetes de software, con versiones inmutables y un estado de promoción para cada versión (compilada, probada, publicada). Permite responder a la pregunta que surge en cada incidente: ¿qué se está ejecutando en producción y cuándo se validó?
La NAP guarda allí otros dos tipos de artefactos: las configuraciones de los dispositivos generadas a partir de plantillas y las instantáneas de los dispositivos tomadas antes del cambio. Ambos necesitan información de procedencia (qué ejecución los produjo y con qué datos de entrada) y un plazo de conservación suficiente para la reversión y la auditoría. Muchos registros gestionan bien las imágenes, pero tienen dificultades con archivos de otros tipos, así que compruébalo antes de basar tu solución en uno. La sección La promoción y la ventana de mantenimiento explica por qué el almacén de artefactos tiene tanto peso en un cambio de red.
Aplica el versionado semántico a todo lo que publiques: incrementa la versión de parche para una corrección retrocompatible, la versión menor para un comportamiento nuevo retrocompatible y la versión mayor para cualquier cambio al que deban adaptarse quienes consumen el software.
Pregunta: ¿podemos almacenar artefactos que no sean imágenes con nuestros propios metadatos y con una política de conservación que controlemos?
Secretos e identidad#
Un sistema de gestión de secretos almacena credenciales y emite credenciales de corta duración bajo demanda. Deberías disponer de uno y contar con identidad de carga de trabajo: al iniciarse, cada trabajo acredita su identidad y recibe credenciales con un ámbito limitado a esa ejecución. También deberías disponer de inicio de sesión único para que el personal de ingeniería acceda a la NAP con la misma identidad que utiliza en los demás sistemas.
La NAP restringe aún más el alcance de las credenciales. Una credencial para desplegar una VLAN en el edificio B no debería funcionar en ninguna otra sede y debería caducar al finalizar la ejecución. Guardar credenciales estáticas en los archivos de las cadenas de despliegue es el fallo de seguridad más común en la automatización de redes, porque basta con que se filtre una clave para que todo el parque de dispositivos quede expuesto. Busca esas credenciales durante la integración continua: tanto gitleaks como TruffleHog examinan todo el historial de commits. El capítulo 13 define el modelo en los apartados Identidad de las cargas de trabajo y Gestión y ciclo de vida de los secretos.
Si todavía no dispones de credenciales específicas para cada ejecución, lo mínimo es trasladar todas las credenciales de larga duración de los archivos de las cadenas de despliegue al almacén de secretos. Desde allí puedes controlarlas, auditar los accesos y rotarlas de forma centralizada.
Pregunta: ¿pueden nuestros trabajos recibir credenciales de acceso a dispositivos que solo sean válidas en una sede y durante la ejecución?
Entorno de ejecución#
Deberías disponer de un entorno reproducible para ejecutar servicios: una plataforma de contenedores o máquinas virtuales gestionadas. El despliegue debe hacerse a partir de código, con reinicio en caso de fallo y reconstrucción desde cero cuando haga falta. Esta es la fila que faltaba en la historia inicial.
Un orquestador de contenedores (por ejemplo, Kubernetes o un equivalente gestionado) te ofrece algo más que un entorno de ejecución. Tres de sus funciones responden directamente a necesidades de la NAP:
- El escalado automático añade procesos de trabajo cuando crece la cola de trabajos, por ejemplo, cuando al abrirse una ventana de mantenimiento se da paso a 200 cambios a la vez, y los retira después.
- Las estrategias de despliegue sustituyen las copias (réplicas) de un componente por grupos pequeños y detienen el despliegue si fallan las comprobaciones de estado. El apartado Despliegue de la NAP en la IDP se basa en estas estrategias.
- La antiafinidad sitúa las réplicas de un mismo componente en hosts o zonas diferentes, de modo que un solo fallo de hardware no pueda dejar fuera de servicio al Orquestador y a su instancia de reserva a la vez.
Para usar estas funciones basta con declararlas en un manifiesto, el archivo de configuración que describe cómo se ejecuta un componente. No tienes que implementarlas. Ese es el argumento de más peso para ejecutar la NAP en el entorno de ejecución de la IDP.
La NAP pone a prueba el entorno de ejecución de dos maneras. Algunos componentes conservan estado, como ocurre con la base de datos de la Fuente de Verdad y con el estado de los flujos de trabajo del Orquestador, y deben sobrevivir al fallo de un nodo sin perder ninguna ejecución en curso. Algunos trabajos son largos: un despliegue que ocupa toda una ventana o que se reparte en diez oleadas a lo largo de varias noches dura horas o días. Un entorno de ejecución ajustado para servicios web sin estado y con un tiempo límite de cinco minutos por trabajo, interrumpirá ambos tipos de despliegue.
Los procesos de trabajo del Orquestador añaden otro requisito. Son la parte de la NAP que inicia sesión en los dispositivos, así que deben ejecutarse en un grupo aislado con acceso a la red de gestión de los dispositivos y que no se comparta con ningún otro inquilino.
Pregunta: ¿qué ofrecéis para los servicios con estado, cuánto tiempo como máximo permitís que se ejecute un trabajo y podemos disponer de un grupo aislado de procesos de trabajo en nuestro segmento de la red de gestión?
Observabilidad del software en ejecución#
Deberías disponer de registros, métricas y trazas del software que ejecutas, con recogida y almacenamiento sin que tengas que operar la pila de observabilidad. Los componentes de la NAP la usan como cualquier otro inquilino para observar la longitud de la cola del Orquestador, la duración de los trabajos en los runners o las tasas de error de la API.
Mantén esta observabilidad separada de la telemetría de red. El bloque de Observabilidad del capítulo 7 supervisa la red. La pila de observabilidad de la IDP supervisa la NAP. El apartado Observabilidad del sistema de automatización del capítulo 7 ya enumera qué supervisar, incluidos los trabajos que terminan correctamente sin cambiar nada. También recomienda una pila mínima e independiente para esas señales. Su lugar natural es la pila de observabilidad de la IDP, porque se ejecuta fuera de la NAP. Si las alertas de la NAP dependen de sus propios recolectores, una caída te impide detectar la propia caída, como mostró el fallo silencioso de la historia inicial. El capítulo 12 define qué métricas enviar allí.
Pregunta: ¿seguiremos recibiendo las alertas de la NAP si su propia pila de observabilidad queda fuera de servicio?
Capacidad para laboratorios y emulación#
Ninguna IDP incluye de serie un laboratorio de red. Aun así, puede alojarlo. El punto de control de simulación del capítulo 10 necesita topologías emuladas bajo demanda: decenas de contenedores o máquinas virtuales con sistemas operativos de red, interconectados para reproducir una parte de la red de producción. Un flujo de trabajo de cambio o una cadena que prueba una plantilla los pone en marcha y los elimina al terminar. Una herramienta de emulación como containerlab ejecuta esos nodos como cargas de trabajo normales en el entorno de ejecución o en un runner. Así que lo que pides es capacidad de cómputo, no un producto de laboratorio.
Dos detalles determinan si los recursos de cómputo de la IDP se ajustan a tus necesidades. Las imágenes de los sistemas operativos de red están sujetas a licencias de los fabricantes que el equipo de productividad de los desarrolladores no gestionará por ti. Y algunas imágenes necesitan virtualización anidada o más memoria por nodo de la que ofrece un nodo de trabajo estándar.
Pregunta: ¿podemos programar la ejecución de topologías de laboratorio en vuestro entorno o necesitamos hosts dedicados?
Cuando no hay una IDP
A veces no hay otro equipo que opere una IDP. El contrato de la Tabla 11.1 sigue vigente, tú asumes la responsabilidad y te encuentras en la tercera casilla de la Figura 11.2. Limita en lo posible el alcance de esa casilla. Implementa lo que indica cada fila en el orden en que lo necesite la NAP: primero el repositorio y los runners, después el registro y los secretos y, por último, el entorno de ejecución. Define cada host en código desde el primer día y trata esta solución como algo temporal mientras justificas la necesidad de una IDP. El objetivo es más limitado que asumir el papel del equipo de productividad de los desarrolladores: asegúrate de que un disco lleno no vuelva a costarte cuatro días.
En resumen, apóyate en otro equipo siempre que puedas y, si no es posible, construye algo pequeño. El siguiente apartado sube una capa y examina qué construye el equipo de automatización de redes sobre esa base y qué debe ofrecer a sus propios usuarios.
Qué ofrece la NAP#
La NAP convierte los bloques de la parte 2 en algo que un equipo puede utilizar. Este apartado examina la NAP desde el punto de vista de quien la usa. Empieza por el criterio que guía todas las decisiones de diseño: tratar la NAP como un producto. Después aborda las vías de acceso que utiliza el personal de ingeniería para llegar a la NAP, el camino recomendado (Golden Path) que hay tras ellas, cómo medir si ese camino funciona y el contrato que permite que la NAP cambie sin que deje de funcionar lo que usan sus usuarios. Los dos apartados siguientes explican los detalles de funcionamiento.
El patrón Plataforma como producto para el personal de ingeniería (Platform as Product for Engineers) aplica a la NAP el enfoque de producto que el capítulo 15 aplica a cada servicio de red. El equipo responsable de una plataforma la trata como un producto, considera clientes a quienes la utilizan y toma la carga cognitiva, el autoservicio y la rapidez de respuesta como sus niveles de servicio. En el caso de la NAP, los clientes son el personal de ingeniería de redes, de operaciones y de ingeniería de fiabilidad de sitios (SRE), así como quienes desarrollan la automatización. El producto es el camino que lleva de una solicitud de cambio a un cambio verificado en la red.
El patrón transforma la pregunta «¿Está en funcionamiento la NAP?» en una serie de preguntas sobre el producto: ¿la está adoptando el personal de ingeniería? ¿Facilita el trabajo o añade dificultades? Cuando falla un cambio, ¿puede quien lo ha realizado actuar a partir del error sin tener que consultarnos? ¿Cuánto tarda alguien que acaba de incorporarse al equipo de ingeniería en desplegar su primer cambio? Si alguien desiste y vuelve a un proceso manual, el fallo es del producto, no de quien lo usa.
Aplica el patrón en cuanto alguien ajeno al equipo que desarrolla la NAP dependa de ella. También se aplica una capa más abajo: el equipo de productividad de los desarrolladores lo aplica contigo, y las preguntas de Qué esperar de la IDP te permiten exigirle que lo cumpla. El capítulo 15 añade lo que rodea al producto: contratos de servicio, acuerdos de nivel de servicio (SLA) internos y una hoja de ruta.
Un producto empieza en el punto de contacto con quienes lo usan, así que la primera pregunta es cómo accede el personal de ingeniería a la NAP.
Múltiples puntos de entrada#
El personal de ingeniería accede a la NAP por distintas vías. Quien desarrolla un flujo de trabajo quiere una interfaz de línea de comandos (CLI) que responda al instante. Quien supervisa un despliegue largo quiere un panel de control. Un sistema de gestión de tickets necesita una API que le permita enviar cambios y recibir información sobre su estado sin intervención humana. Un agente de inteligencia artificial (IA) necesita acceder a las mismas operaciones a través del Model Context Protocol (MCP).
El capítulo 9 diseñó estas interfaces como parte de la capa de Presentación. Este capítulo añade una regla: todas las interfaces llaman a la misma API. Las demás funciones (validación, artefactos y lógica de despliegue) quedan detrás de ella. Una CLI que realiza sus propias comprobaciones deja de coincidir con el formulario web en cuanto cambia uno de los dos.
Detrás de esa API externa hay una segunda API, de uso interno, que define cómo asigna el Orquestador las tareas a los procesos de trabajo, cómo comunican estos los resultados y cómo anuncia el almacén de artefactos la disponibilidad de un nuevo artefacto. Puede cambiar más deprisa que la API externa, pero también necesita esquemas y versiones explícitos, porque los componentes de la NAP se despliegan de forma independiente.
Sea cual sea la vía de entrada, la solicitud recorre después el mismo camino detrás de la API, y la NAP debería facilitarle el recorrido. Lo que importa es cuántos pasos requiere y por cuántas manos pasa.
Reduce la fricción con un camino recomendado#
Lo fácil debería ser fácil y lo difícil debería ser posible.
Larry Wall
Los nueve días de la historia inicial no fueron nueve días de trabajo. En total, cinco personas dedicaron unas pocas horas de trabajo entre todas. El tiempo transcurrido se debió a los traspasos: en cada uno había que esperar a que la siguiente persona se fijara en la cola, reuniera el contexto y actuara.
Reducir ese tiempo es más una cuestión de diseño del flujo de trabajo que de herramientas. Cada traspaso entre personas alarga el plazo y hace que se pierda contexto. La propia NAP debería encargarse de pasar de una etapa a la siguiente: recepción, validación, punto de control, notificación y despliegue. La interfaz del personal de ingeniería debería ser lo bastante sencilla como para usarla correctamente al primer intento. La Figura 11.3 compara el camino que debería ofrecer la NAP con la vía que permite eludirlo.
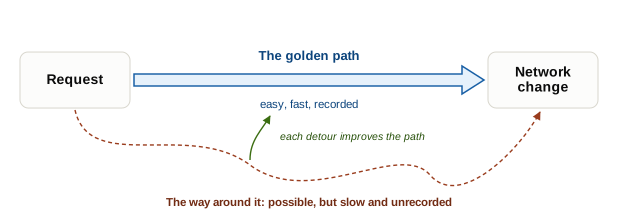
La solución es un camino recomendado: una ruta bien señalizada, probada y documentada para los flujos de trabajo más habituales. Quien solicita una regla de cortafuegos estándar sigue ese camino sin necesitar ayuda en ningún momento. Quien tiene un motivo legítimo para apartarse de él, como una dependencia poco habitual o un paso de validación personalizado, puede hacerlo sin desmontar la NAP. El equipo registra cada desviación y la utiliza como información de retorno. Así se aplica la regla de Larry Wall: la solicitud estándar es fácil de tramitar y la excepcional sigue siendo posible.
En mi experiencia, un camino recomendado que cubre menos del 80 % de las solicitudes de cambio reales del equipo aún no merece ese nombre. Por debajo de ese umbral, quedan más cambios fuera del camino que dentro, y el coste de mantenerlo supera el valor de la coherencia que aporta. Mide la cobertura. Si es baja, la diferencia te indica qué le falta al camino. No demuestra que el personal de ingeniería incumpla las normas.
El camino recomendado es una recomendación. La aplicación obligatoria de reglas es otra herramienta y se trata en el capítulo 13. Aquí el objetivo es que el camino resulte lo bastante atractivo como para que el personal de ingeniería lo elija.
El camino recomendado incorpora lo que ha aprendido el equipo: las lecciones de los despliegues fallidos y las convenciones que permiten entender un flujo de trabajo escrito por otra persona. ¿Cuáles de esas convenciones merece la pena hacer obligatorias? Dedica el esfuerzo de hacer cumplir las reglas a lo que aporta seguridad, no a lo que solo aporta uniformidad. Una convención para nombrar las etapas de los flujos de trabajo ayuda a mantener la NAP ordenada, pero no evita nada. Una regla que exige que todo cambio en producción supere sus controles evita toda una clase de incidentes.
El camino recomendado también cambia lo que requiere aprobación. El capítulo 15 presenta el patrón de automatización preaprobada (Pre-Approved Automation Pattern) en el apartado Niveles de servicio para los servicios de red: se aprueba una sola vez el diseño del flujo de trabajo, sin tener que aprobar cada ejecución. Un flujo de trabajo que sigue el camino recomendado responde a ese diseño. Sus controles se revisaron durante la incorporación, de modo que una solicitud que se mantiene dentro de los límites que fijan constituye una llamada al servicio. El comité de revisión no la considera un cambio nuevo.
Pero un camino solo sirve si el personal de ingeniería puede acceder a él. En él confluyen dos roles del modelo de acceso del capítulo 9: el de ingeniería, que consiste en escribir y gestionar flujos de trabajo, y el de operación, que consiste en solicitar su ejecución. Son roles, no puestos de trabajo: a menudo una misma persona desempeña ambos y cada organización traza la división entre ellos de forma distinta.
Para quien se incorpora al equipo de ingeniería, el momento más difícil es crear el primer flujo de trabajo. Sin ayuda, aprende por ensayo y error convenciones que nadie ha documentado o escribe código que falla en la integración continua. ¿Cómo puedes facilitar esa incorporación? Con una estructura base: un esqueleto de referencia que incorpora las convenciones del equipo y permite partir de algo que ya funciona. Quien copia la estructura base sigue por defecto el camino recomendado.
El Listado 11.1 muestra la estructura base de un flujo de trabajo de VLAN para el ejemplo del campus.
workflow-vlan-add/
├── workflow.yaml            # declares the adapter versions it needs
├── inputs/
│   └── change.yaml          # sample request, used by tests
└── tests/
└── test_vlan_render.py # renders the sample through each adapter, in CILa estructura base no incluye plantillas. Las plantillas que traducen una VLAN a la sintaxis de cada plataforma residen en los adaptadores del Ejecutor (capítulo 6). Todos los flujos de trabajo que operan sobre VLAN comparten esas plantillas, que se publican junto con el adaptador. Cuando el equipo de automatización de redes corrige una plantilla, todos los flujos de trabajo reciben la corrección con la siguiente versión del adaptador. Si cada flujo tuviera su propia copia de la plantilla, en cuestión de meses esas copias empezarían a divergir del original. Si un flujo de trabajo necesita una sintaxis que aún no genera ningún adaptador, se solicita una nueva versión del adaptador en vez de incluir una plantilla propia en el flujo.
El archivo workflow.yaml declara en qué consiste el flujo de trabajo y cómo debe tratarlo la NAP. El apartado Antes de la solicitud muestra un archivo completo. Para solicitar una ejecución no hace falta nada de esto. Quien la solicita rellena un breve archivo de entrada, o los mismos campos en un formulario, y lo envía:
$ nap submit --workflow vlan-add --input change.yaml
job-20260315-0042
  sot_integrity_check   passed   1.2s
  schema_validation     passed   0.4s
  render_tests          passed   2.3s
  simulation            skipped  no template change
Track: https://nap.example.net/changes/job-20260315-0042En menos de 5 segundos, antes de pasar a otra tarea, quien ha solicitado la ejecución ya dispone de un identificador de trabajo, tres resultados y un enlace para seguir el despliegue. Si hubiera fallado la comprobación de integridad de la Fuente de Verdad (SoT), el mensaje indicaría qué registro falta: en lugar de «error de validación», diría «dispositivo sw-b-acc-01: no se encuentra en la SoT, regístralo antes de volver a enviar la solicitud». Quien hizo la solicitud puede resolverlo sin ayuda.
¿Dónde se guarda el cambio una vez enviado? Distingue entre el flujo de trabajo y la solicitud. El flujo de trabajo (el archivo workflow.yaml de la estructura base y las pruebas) es código: se guarda en un repositorio Git y llega a la NAP como una versión publicada. La solicitud (change.yaml) corresponde a una ejecución de ese flujo de trabajo, y su destino depende de si modifica la intención de red:
- Intención almacenada en archivos.
nap submitabre una solicitud de incorporación de cambios en un repositorio de intención y Git conserva el historial y la revisión. Esto funciona mientras el modelo de datos sea lo bastante pequeño como para guardarlo en archivos. - Intención almacenada en una Fuente de Verdad relacional. La NAP registra la intención como una propuesta de cambio y la Fuente de Verdad conserva el historial. Es la opción predeterminada para un modelo relacional y la que se sigue en el apartado Recepción.
- Sin cambios en la intención. Una solicitud que se limita a ejecutar una operación, como desactivar y volver a activar un puerto o recopilar datos de diagnóstico, no debe modificar la Fuente de Verdad. La capa de Presentación registra la solicitud para poder seguirla y el Orquestador guarda los datos de entrada junto con la ejecución en su propia base de datos.
Nunca sigas la tercera vía para un cambio de configuración. Un cambio registrado solo en el Orquestador deja la red en un estado distinto del que define su intención, sin que quede constancia del motivo.
Sea cual sea la vía que siga una solicitud, el Orquestador conserva el registro de la ejecución (el identificador de trabajo y el resultado de cada control) y lo vincula a la intención. El almacén de artefactos conserva la salida generada a partir de las plantillas. En el ejemplo del campus, nap submit registra la VLAN en la Fuente de Verdad como una propuesta de cambio, y job-20260315-0042 es el registro de esa ejecución en el Orquestador.
Una estructura base y una primera respuesta rápida facilitan los primeros pasos por el camino recomendado. Hay que medir si el personal de ingeniería sigue utilizándolo.
Cómo medir la adopción y la carga cognitiva#
Un camino recomendado que el personal de ingeniería no utiliza no sirve de nada, y el equipo necesita cifras para saber si la gente lo adopta. La adopción es el indicador retardado: la proporción de cambios que pasan por la NAP, que ya se mide con el umbral de cobertura del 80 % mencionado antes. La carga cognitiva es el indicador adelantado: aumenta antes de que disminuya la adopción. La Figura 11.4 ilustra el límite que permiten medir esas cifras: quien desempeña el rol de ingeniería ve tres pasos y la NAP oculta el resto.
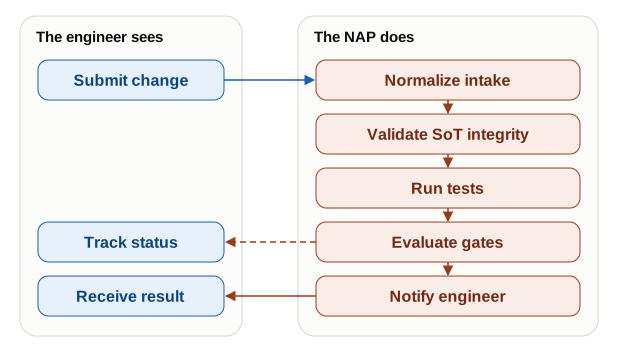
Cuatro preguntas convierten ese límite en métricas:
- ¿Cuántos pasos necesita quien se incorpora al equipo de operación para enviar su primera solicitud?
- ¿En cuántos sistemas tiene que iniciar sesión?
- Una vez enviada la solicitud, ¿cuánto tarda en saber si ha superado los controles? Es la métrica de tiempo hasta el primer resultado útil del apartado Métricas de estado de la NAP.
- Cuando falla una comprobación, ¿puede actuar a partir del mensaje sin tener que consultar al equipo de automatización de redes?
Conviene tener un punto de referencia. Si alguien que se incorpora al equipo de ingeniería sigue necesitando ayuda después de una jornada completa, la dificultad es estructural y no se debe a la curva de aprendizaje. Compara las mediciones con tus propios valores de referencia anteriores a la NAP.
Las métricas muestran si la NAP funciona hoy para quienes la utilizan, pero no cómo conseguir que siga funcionando mientras la propia NAP cambia.
El patrón de contrato de plataforma (Platform Contract)#
A medida que más equipos dependen de la NAP, sus responsables se enfrentan a un nuevo problema: cómo modificarla sin perjudicar a quienes dependen de ella. Si alguien crea una integración con la API de envío de solicitudes y seis meses después descubre que ha dejado de funcionar sin previo aviso, ha sufrido un fallo del servicio, sean cuales sean los motivos del cambio.
En el patrón de contrato de plataforma, quien se responsabiliza de una plataforma asume un compromiso explícito y versionado sobre qué ofrece la plataforma, cómo se comporta y cómo cambia. El contrato tiene tres partes: una API versionada con una semántica documentada, una política de obsolescencia que anuncia los cambios incompatibles e indica cómo migrar, y una fecha a partir de la cual una versión declarada obsoleta deja de funcionar. Se redacta como una entrada de un registro de cambios:
A partir del 1 de marzo,
POST /v1/changesse declara obsoleto en favor de/v2/changes, que añade el campo obligatoriosite. La versión v1 seguirá funcionando hasta el 1 de septiembre. Los flujos de trabajo que usan la estructura base 1.x seguirán generando su salida a partir de plantillas. Ejecutanap scaffold upgradepara pasar a la versión 2.0.
El contrato reside en la API común a la que llaman todos los puntos de entrada descritos en el apartado Múltiples puntos de entrada. El capítulo 9 explica los detalles de funcionamiento en el apartado Versionado y estabilidad. Las definiciones de los flujos de trabajo y las estructuras base también forman parte del contrato y se versionan en sus propios repositorios, pero quienes las utilizan acceden a ellas a través de esa API.
Aplica el contrato desde que haya alguien ajeno al equipo que use la plataforma. En este capítulo, el patrón se aplica en ambos sentidos: la NAP debe ofrecer ese contrato al personal de ingeniería de redes y la IDP debe ofrecérselo a la NAP para las imágenes de los agentes de ejecución, las API de los registros y las versiones de los entornos de ejecución. El capítulo 15 lo sitúa dentro del ciclo de vida completo del producto.
Antes del primer cambio de versión de una definición de flujo de trabajo, hay que responder a dos preguntas. La primera es qué se considera un cambio incompatible. Añadir un campo obligatorio rompe la compatibilidad, al igual que eliminar cualquier campo o cambiar el significado de uno existente, incluso si el propio esquema sigue igual. Añadir un campo opcional con un valor predeterminado mantiene la compatibilidad.
La segunda es qué ocurre con una ejecución iniciada en la versión 1.2 cuando se publica la 1.3. Deja que termine con la versión con la que empezó y retira la 1.2 solo cuando ya no la utilice ninguna ejecución. Si una ejecución no puede terminar con su versión, la NAP debe ofrecerle una vía de migración. La opción más sencilla es programar la transición para un momento en el que no haya ninguna ejecución activa.
El contrato recoge lo que la NAP promete sobre los cambios. Cumplirlo depende de cómo publique esos cambios el equipo de automatización de redes, que es el tema del siguiente apartado.
Despliegue de la NAP en la IDP#
La NAP es software y la IDP despliega software. Esta sección trata ese primer tipo de despliegue: cómo llegan a producción los componentes de la propia NAP. Empezaremos por los cimientos, el código y GitOps, y seguiremos con las pruebas. Después veremos tres técnicas para publicar versiones de componentes que no se pueden reiniciar sin más. Terminaremos viendo qué ocurre cuando falla la propia IDP.
Describe cada componente de la NAP mediante infraestructura como código (IaC): la aplicación de la Fuente de Verdad y su base de datos, el Orquestador, los trabajadores, los recolectores y la configuración de los runners. Si alguien monta un orquestador a mano y lo configura de forma interactiva, solo esa persona sabrá restaurarlo. La historia inicial muestra el coste: cuatro días.
Trata igual las definiciones de las cadenas de despliegue. Las etapas, los controles y la lógica de aprobación son código. Pasan por revisión y cada cambio es visible, reversible y se somete a pruebas. Los equipos de automatización suelen automatizarlo todo salvo su propia infraestructura.
Fija las versiones de las dependencias externas: colecciones de Ansible, paquetes de Python, imágenes base de contenedores y definiciones de esquemas. Si dejas una versión sin fijar, la NAP puede comportarse de forma distinta según el día en que se ejecute. Revisa las actualizaciones de dependencias como cualquier otro cambio. El capítulo 13 trata la cadena de suministro.
Con GitOps, el repositorio es la referencia de lo que debe estar desplegado y cualquier desviación se corrige automáticamente. Herramientas como Argo CD y Flux concilian continuamente el estado del entorno de contenedores con el repositorio. Los runners que utilizan Git se aproximan a ese modelo: cada commit que cumple los criterios desencadena la ejecución a partir de código versionado. GitOps es un buen punto de partida para todos los componentes de la NAP desde el primer día. La configuración de cada runner remite a un commit. Cada actualización de políticas deja constancia de su revisión. Para revertir una versión defectuosa de la NAP basta con revertir un commit, sin reconstruir un servidor. Para esta clase de artefactos, GitOps ofrece garantías sólidas a bajo coste.
Los dispositivos de red son otro caso. La NAP solo los modifica mediante solicitudes revisadas. Cuando un dispositivo se aparta de la intención, genera una alerta en vez de corregirlo. Corregir la red automáticamente es una decisión aparte que abordaremos en el bucle cerrado del capítulo 16.
Pruebas del software de la NAP#
Los componentes de la NAP son software y se prueban como tal. Estas pruebas se ejecutan en los runners de CI de la IDP y no necesitan dispositivos de red:
- Las pruebas unitarias cubren las piezas más pequeñas: una función de una biblioteca compartida o una regla de validación que debe detectar el caso inválido y aceptar el válido. Son rápidas y no tienen dependencias. Si una prueba tarda diez segundos y necesita una base de datos, es una prueba de integración lenta.
- Las pruebas de integración comprueban que los componentes funcionen juntos: el Orquestador encola una tarea que los trabajadores aceptan, o el adaptador lee lo que devuelve la Fuente de Verdad. Utilizan instancias de prueba de cada bloque, nunca las de producción.
- Las pruebas de compatibilidad ejecutan las definiciones de los flujos de trabajo existentes con la nueva versión del componente. Detectan esa versión que supera sus propias pruebas pero rompe todos los flujos escritos para la anterior.
Probar la propia red exige dispositivos, así que corresponde al recorrido del cambio, en la sección Controles de validación.
Las pruebas te dicen si una versión nueva es correcta. No te dicen cómo ponerla en producción mientras el componente ejecuta cambios de red. Ese es el siguiente problema.
Despliegue de nuevas versiones de la NAP#
Si duele, hazlo más a menudo.
Martin Fowler
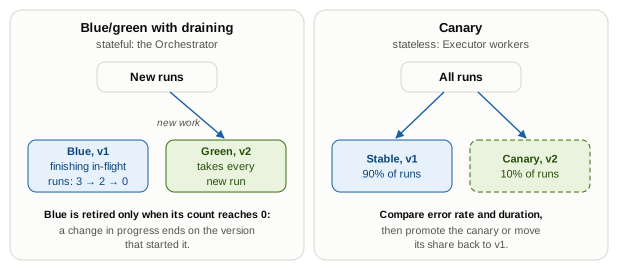
Reiniciar un componente de la NAP no es como reiniciar un servidor web. Algunos componentes gestionan cambios de red en curso, otros guardan el esquema que leen todos los flujos y otros se ejecutan en 40 sedes. Cada caso tiene su técnica: despliegue azul/verde con vaciado para componentes con estado, despliegues canarios para los trabajadores y ampliación, migración y retirada para los esquemas, y oleadas para los componentes distribuidos por todo el parque. Publicar versiones de la NAP cuesta, y por eso conviene hacerlo a menudo, en pasos pequeños. La Figura 11.5 compara las dos primeras técnicas de despliegue.
Despliegue azul/verde y vaciado de componentes con estado
Algunos componentes de la NAP no se pueden reiniciar en cualquier momento. Imagina al Orquestador en mitad de un flujo de varias oleadas: ya ha aplicado la primera y espera la validación antes de la segunda. Si lo interrumpes, los dispositivos se quedan a medio cambiar y nadie sigue su estado. Un despliegue azul/verde lo evita. Las versiones antigua (azul) y nueva (verde) se ejecutan a la vez. La verde recibe el trabajo nuevo y la azul termina el que tiene en curso.
Invierte en esta técnica antes de que el primer flujo de varias oleadas llegue a producción. Hasta entonces basta con una pausa programada: los flujos cortos de un solo paso se pueden interrumpir y reiniciar. A partir de ahí, una actualización de la NAP que interrumpe el trabajo en curso constituye una incidencia de producción.
Para saber si ha terminado el vaciado necesitas un número. El Orquestador debe exponer en tiempo real cuántos flujos siguen activos en cada instancia, y el panel debe mostrar cómo la cifra de la instancia azul baja hasta cero. Ni un temporizador ni una suposición te dicen si se ha vaciado. En los flujos de red la regla es estricta: un cambio en curso termina en la versión que lo inició. Programa la transición cuando no haya flujos de varias oleadas en curso o espera a que lleguen a un punto de control.
Actualizaciones canarias y migración de esquemas
Para los componentes sin estado, como una nueva imagen de los trabajadores del Ejecutor, un despliegue canario dirige primero una pequeña parte de las ejecuciones a la versión nueva. Si, tras suficientes ejecuciones, su tasa de errores y su duración coinciden con las de la versión estable, la nueva la sustituye. En caso contrario, el tráfico vuelve a la anterior y se detiene la publicación.
Actualizar componentes con estado es más difícil. El caso más delicado es cambiar el esquema de la Fuente de Verdad. Un cambio incompatible afecta a todos los flujos que leen o escriben los campos afectados. La secuencia segura es ampliar, migrar y retirar: añade los nuevos campos junto a los antiguos, migra los flujos uno a uno y retira los campos antiguos cuando ya nadie los lea. El error que veo más a menudo es cambiar el esquema y los flujos en la misma versión. Si algo falla, hay dos causas posibles y ninguna forma sencilla de volver atrás.
Cambios de versión y cambios de configuración
No todas las publicaciones de la NAP sustituyen código. Un cambio de versión sustituye un componente o modifica la arquitectura: una versión nueva del Orquestador, una migración de esquema o un bus de mensajes nuevo. Un cambio de configuración mantiene el código y modifica su comportamiento: la lista de destinos de un recolector, el tamaño de un grupo de trabajadores o la tolerancia de un control. Dales recorridos de publicación distintos. Los cambios de configuración son menores y más fáciles de revertir. Puedes publicarlos con más frecuencia y con menos pasos: se revisan y versionan como todo lo demás, porque GitOps cubre ambos casos, pero no necesitan vaciado ni despliegue canario.
Ese recorrido más corto tiene dos excepciones. Un cambio de configuración del que dependan todos los flujos, como una política de despliegue o la definición de un control, se revisa como código porque se comporta como tal. Y un cambio de configuración que exige reiniciar el componente para surtir efecto es, en la práctica, un cambio de versión.
Actualización de una NAP distribuida
Algunos componentes de la NAP se ejecutan en todo el parque: un recolector por sede, un grupo de trabajadores por centro regional o un servicio de aprovisionamiento en el extremo de la red. Si actualizas el recolector de las 40 sedes a la vez, un fallo de análisis de datos en la nueva versión te deja sin visibilidad en todas durante la misma ventana.
Actualízalos por oleadas, con la misma lógica que un cambio de red: primero las sedes piloto, después un subconjunto regional y por último el resto. Cada oleada exige que los nuevos recolectores indiquen que funcionan correctamente. Hay más en juego de lo que parece. Un cambio de red fallido afecta a un subconjunto de dispositivos. Una actualización fallida de la NAP puede dejarla sin capacidad para validar y recuperar todos los cambios posteriores.
Todas estas técnicas dan por hecho que la IDP funciona. A veces falla.
Cuando falla un servicio de la IDP#
La NAP depende de servicios de la IDP que no controla. El registro puede quedar inaccesible en mitad de una promoción. Entre dos controles, el entorno de ejecución puede perder el nodo que aloja a un trabajador. El almacén de secretos puede denegar una credencial. El origen de estos fallos está por debajo de la NAP, fuera del flujo de trabajo.
Diseña cada etapa para que se detenga ante un fallo. Si un servicio necesario no está disponible, la etapa falla y la ejecución se detiene. Un despliegue no continúa si no puede confirmar que su artefacto está almacenado. Identifica cada dependencia en la gestión de errores del flujo para que el mensaje diga «registro inaccesible» en vez de «error de despliegue».
Documenta la respuesta antes de necesitarla. Escribe una entrada breve por servicio de la IDP: qué hace la NAP si falta, a quién se avisa y cómo se reanuda una ejecución detenida. Después ponla a prueba. Desconecta el registro en preproducción y comprueba que la ejecución se detiene con el mensaje correcto. Actualiza la entrada después de cada fallo real. El capítulo 12 trata los reintentos y los interruptores de circuito. Su sección Indisponibilidad de la NAP y continuidad manual incluye el procedimiento para cuando caiga la NAP.
Con esto termina el primer sentido de despliegue: instalar software en la IDP. Pasemos al segundo.
Un cambio de red de principio a fin#
La NAP ya está desplegada. Ahora hace su verdadero trabajo: desplegar un cambio de red. Seguiremos el cambio de cortafuegos de la historia inicial por una NAP que funciona, con la misma regla, el mismo par de alta disponibilidad y la misma ventana de mantenimiento. La parte 2 explica la mayoría de los mecanismos. Por eso, cada paso remite al capítulo correspondiente y añade solo lo que aporta la NAP cuando los bloques trabajan juntos.
La Figura 11.6 muestra el recorrido completo en tres partes.
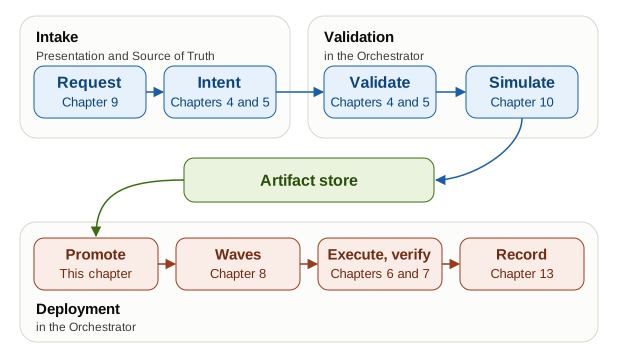
Durante la recepción, la capa de Presentación y la Fuente de Verdad convierten la solicitud en intención. Desde ahí el Orquestador ejecuta un único flujo de trabajo de cambio hasta el final. Las etapas de validación son cortas y sin estado. Responden a la pregunta «¿es correcto este cambio?». Las etapas de despliegue son largas y mantienen estado. Responden a «¿conviene aplicarlo ahora y cómo?». Entre ambas está el almacén de artefactos.
El punto en que termina la recepción depende de dónde se guarde la intención, como explica la sección Recepción de solicitudes. Lo importante es que todas las vías de entrada pasen por los mismos controles.
Cada paso tiene un responsable:
- Solicitud. El personal de ingeniería presenta la solicitud por cualquiera de los puntos de entrada (capítulo 9).
- Intención. La solicitud se convierte en una propuesta de cambio donde reside la intención: crear una rama, proponer, comprobar, aprobar y fusionar en la Fuente de Verdad (capítulo 5), o abrir una solicitud de incorporación de cambios en un repositorio de intención.
- Validación y generación. Los controles comprueban los datos y el Ejecutor genera las configuraciones a partir de plantillas mediante su llamada de solo generación (capítulo 6).
- Simulación. Si el flujo lo exige, el cambio generado se ejecuta sobre una topología emulada (capítulo 10).
- Promoción. El artefacto se etiqueta y, si su nivel de riesgo lo exige, queda a la espera de que se apruebe su despliegue (este capítulo).
- Oleadas. El Orquestador establece la secuencia del despliegue y evalúa el control de estado de cada oleada (capítulo 8).
- Ejecución y verificación. El Ejecutor aplica el cambio de forma idempotente y lo verifica con los datos de Observabilidad (capítulo 6 y capítulo 7). Reintentar un paso no debe aplicar dos veces el cambio. El capítulo 12 trata la idempotencia en los reintentos.
- Registro. Las evidencias de la ejecución se incorporan al registro del cambio (capítulo 13).
La validación y el despliegue fallan por motivos distintos y por eso se separan. Un fallo de validación indica que el cambio es incorrecto: corrígelo y vuelve a enviarlo. Un fallo de despliegue puede producirse con un cambio perfectamente válido: todavía no se ha abierto la ventana, un dispositivo está inaccesible o el control de una oleada detectó que algo más había cambiado. Si mezclas ambos casos, el fallo es ambiguo y el equipo de automatización debe diagnosticarlo.
Recorramos estos pasos en orden, empezando antes de que alguien del equipo de redes presente la solicitud.
Antes de la solicitud: incorporación del flujo de trabajo#
La regla de cortafuegos puede seguir el camino recomendado porque alguien incorporó antes el flujo correspondiente. En este capítulo, un flujo de trabajo es una clase de operación de red que la NAP sabe ejecutar: «añadir una regla de cortafuegos», «añadir una VLAN a una sede» o «desactivar y reactivar un puerto». Algunas modifican la intención y otras no. Incorporar un flujo consiste en escribir su definición y sus controles, enseñar a los adaptadores a generar la sintaxis que aún no admiten y probarlo todo una vez. A partir de ahí, cada solicitud es una ejecución del mismo flujo.
La definición constituye el contrato entre el flujo y la NAP. Declara qué es específico de ese flujo para que nadie tenga que decidir a las 02:00 qué controles aplicar ni qué riesgo asumir. El Listado 11.3 muestra la definición para la regla de cortafuegos.
Los Listados 11.3 y 11.4 son ejemplos ilustrativos. No utilizan la sintaxis de ningún producto. Muestran qué decisiones deben recoger la definición de un flujo y una política de despliegue. Tu Orquestador expresará las mismas decisiones en su propio formato.
name: firewall-rule-add
version: "2.1"
risk_tier: standard
risk_evaluation: security_policy
adapters: { vendor-fw: ">=3.4" }
scope:
  unit: site
  attribute: site_code
validation:
  before_deploy:
    - sot_integrity_check
    - schema_validation
    - render_tests
    - simulation:
        when: high_risk
  per_wave:
    before:
      - drift_check:
          attributes: [security_policy]
    after:
      - health_gate:
          checks: [requested_flow_reachable, other_rule_hits_stable]
convergence_seconds: 60La definición distingue dos grupos de controles. Los controles before_deploy evalúan el cambio antes de que llegue al almacén de artefactos. Los veremos en la sección Controles de validación. Los controles per_wave se ejecutan durante el despliegue, antes y después de cada oleada, como explica la sección Promoción y ventana de mantenimiento.
Conviene detenerse en cuatro campos:
risk_tierfija el nivel inicial de todas las solicitudes yrisk_evaluationidentifica la política con la que la NAP contrasta cada una. Si la regla se ajusta a la política de seguridad, conserva el nivelstandard. Si se sale de ella, pasa ahigh. El nivel determina cómo se despliega el cambio y qué aprobaciones necesita, como muestra el Listado 11.4.adaptersindica con qué versiones del adaptador del Ejecutor se ha probado el flujo. La NAP rechaza su ejecución con adaptadores anteriores. Si una nueva versión del adaptador deja de admitir una versión que el flujo necesita, no supera las pruebas del flujo previas a la publicación.simulation.whendetermina qué solicitudes necesitan pasar por el laboratorio. Este flujo simula las de alto riesgo: una regla que queda fuera de la política de seguridad puede interactuar con las reglas del par de cortafuegos de formas que ninguna prueba de generación detecta. Para un flujo de VLAN, el valor seríatemplate_changed: un nuevo identificador de VLAN procesado con una plantilla probada necesita pruebas de generación, pero no laboratorio.convergence_secondsforma parte de la especificación del control. Una red necesita tiempo para estabilizarse. Una política de BGP tarda entre segundos y minutos en llegar a los pares. Si el control se ejecuta antes de la convergencia, certifica una oleada que aún no se ha estabilizado. Fija el intervalo para cada flujo y no lo acortes porque el flujo te parezca lento.
El campo
risk_tierfija un mínimo al incorporar el flujo. El personal de operaciones nunca lo elige. Algunas solicitudes entrañan más riesgo que el habitual en su flujo: una regla que abre el acceso a toda una subred o una VLAN añadida a un enlace troncal del núcleo en vez de a un puerto de acceso. La NAP evalúa el alcance y el contenido de cada solicitud y solo puede elevar su nivel. El capítulo 13 lo explica en la sección Clasificación por niveles de riesgo.
El flujo no especifica cómo distribuir el despliegue. El tamaño de las oleadas y los umbrales de cancelación se deciden para todo el parque. Dependen del diseño de la red, no de lo que haga el cambio. Cien flujos que los eligieran por separado producirían cien comportamientos distintos. El equipo de automatización los define una sola vez en una política de despliegue que el Orquestador aplica a cada ejecución según su nivel de riesgo.
rollout_policy:
  wave_selection: site
  vendor_stratified: true
  redundant_pairs:
    default: standby_first
    removes_access: active_first
    on_failure: unwind_all
  tiers:
    standard:
      intent_review: none
      deploy_approval: none
      abort_ratio: 0.05
      on_failure: halt
    high:
      intent_review: peer
      deploy_approval: manual
      abort_ratio: 0.0
on_failure: unwind_allResuelve las cuestiones que el capítulo 8 dejó para este capítulo:
- La selección de las oleadas fija el tamaño y el alcance del despliegue. Agrupar por sede limita geográficamente el impacto. Estratificar por fabricante incluye a todos los fabricantes en una oleada temprana para detectar comportamientos específicos antes de que lleguen a todo el parque. Dimensiona la primera oleada por cobertura: tres switches de fabricantes distintos detectan más que cuarenta de uno solo. Los miembros de un par redundante nunca comparten oleada. Empieza por el de reserva, salvo que el cambio retire acceso. Así, las dos oleadas del par de cortafuegos corresponden a sus dos unidades. Si el par sincroniza la configuración, trátalo como una unidad: aplica el cambio al miembro activo y verifica en el control que el de reserva lo ha recibido.
abort_ratioindica cuándo detener el despliegue. Un dispositivo que falla en una oleada de 5 es una señal distinta de uno que falla en una de 400. Expresa el umbral como una proporción y déjalo por escrito antes de empezar. Para los cambios de alto riesgo es cero: cualquier fallo detiene el cambio.on_failuredefine la política de reversión de oleadas: qué ocurre con las oleadas que ya superaron su control si falla una posterior. Conhaltse conservan porque pasaron el control. Conunwind_allse compensan todas las oleadas terminadas, para cambios en los que un resultado parcial es peor que ninguno. Es el caso del par de cortafuegos, como mostró la conmutación de la historia inicial. En un par redundante, esta regla prevalece sobre el nivel de riesgo: nunca se deja el cambio aplicado a una sola unidad, por lo que siempre se revierte.
Si un flujo necesita un despliegue distinto, se crea un nivel nuevo y se revisa como cualquier cambio de política. Nunca se añade una excepción privada a la definición del flujo.
Como el flujo es código, se prueba como tal antes de que lo use ninguna solicitud. El capítulo 4 dejó para este capítulo la estrategia de pruebas de los patrones de diseño. Consta de tres pasos, del más barato al más costoso:
- Las pruebas de generación pasan datos de prueba por los adaptadores del flujo y comparan la salida con las configuraciones esperadas. Utilizan un conjunto de datos por sistema operativo de dispositivo. Tardan segundos y detectan la mayoría de los errores de lógica de las plantillas.
- Las pruebas de integración generan configuraciones a partir de una instancia de prueba de la Fuente de Verdad. Así detectan supuestos sobre el modelo de datos que los datos de prueba ocultan.
- Una ejecución en laboratorio prueba el flujo entero, controles incluidos, en la topología emulada que describe la sección Controles de validación. Cuando la fusión solo cambia la lógica del flujo, como la secuencia, los controles o la compensación, bastan dobles de prueba que respondan como los dispositivos reales. Su coste es una fracción del de la topología emulada. Las plantillas y todo lo que dependa de la respuesta real del dispositivo siguen necesitando las imágenes emuladas.
Un cambio en un diseño afecta a todas las sedes que lo utilizan. Por eso cada fusión de cambios en el flujo ejecuta las tres pruebas. Las dos primeras son pruebas de software y se ejecutan en una cadena de la IDP. Solo la tercera necesita el Orquestador y el laboratorio. Cuando supera las tres, se publica el flujo para que acepte solicitudes.
Una vez publicado el flujo, el personal de ingeniería puede presentar la solicitud.
Recepción de solicitudes#
La solicitud para el cortafuegos llega por la capa de Presentación. En este caso, un formulario de ITSM llama a la API de la NAP. La intención puede guardarse en cualquiera de los dos sitios descritos en Reduce la fricción con un camino recomendado. Este equipo la guarda en una Fuente de Verdad relacional. La solicitud se convierte allí en una propuesta de cambio: una entrada nueva en la política que hace referencia a la subred del servicio nuevo y al punto de acceso de autenticación.
La NAP contrasta la propuesta con la política de seguridad. Dar acceso a la capa de autenticación desde una subred de origen nueva queda fuera de la política, de modo que la solicitud pasa a ser de alto riesgo y requiere dos aprobaciones. La primera es una revisión de la intención al presentar la propuesta. Otra persona del equipo de ingeniería, nunca quien la solicitó, comprueba que el cambio sea el adecuado. Es la separación de funciones que exige el capítulo 13. La segunda es una aprobación del despliegue tras la simulación, descrita en Promoción y ventana de mantenimiento. La fusión de la propuesta inicia el flujo de cambio: la Fuente de Verdad emite un evento y el Orquestador lo acepta en el control de recepción.
¿Por qué no guardar la intención en archivos de Git? Con un modelo pequeño funciona. Pero los datos de red son relacionales. La sección Persistencia de datos del capítulo 5 explica cuándo dejan de bastar los archivos.
¿Dónde se ejecuta el flujo de cambio? En el Orquestador, desde el primer control hasta la última oleada, como muestra la Figura 11.6. Sus dos mitades tienen necesidades distintas:
- La validación (generación de configuraciones, pruebas, controles y simulación) es breve y no mantiene estado.
- El despliegue (oleadas durante la ventana, controles de estado y compensación) es largo y mantiene estado. Para eso sirve el estado persistente del flujo que vimos en el capítulo 8.
Al reunir ambas partes en un solo flujo hay una ejecución, un registro y una identidad desde la recepción hasta la verificación. El artefacto promovido sirve de enlace entre ambas. En la variante GitOps, la validación puede ejecutarse en una cadena de la IDP y entregar el artefacto al Orquestador. Funciona siempre que los controles sean los mismos. Lo que falla es ejecutar todo el recorrido como una sola tarea de CI. Los equipos que lo intentan lo descubren en su primer despliegue de varias horas, cuando la tarea agota su tiempo de espera a mitad de una oleada.
Una vez que la fusión inicia el flujo, la parte de validación comprueba que el cambio sea correcto.
Controles de validación#
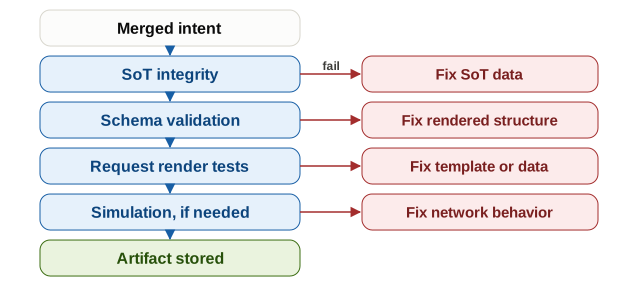
El flujo somete el cambio a los controles before_deploy de su definición, empezando por el más barato. Evalúan el cambio antes de que exista fuera del almacén de artefactos. Los controles per_wave llegan después, durante el despliegue. La Figura 11.7 ordena los controles de validación por coste y muestra qué debe corregir el personal de ingeniería ante cada fallo.
Cada control detecta una clase de problema que escapa a los anteriores:
- Integridad de la SoT. Cada objeto al que hace referencia el cambio existe y está completo. Para la regla de cortafuegos, ambas unidades están registradas con sus direcciones de gestión, la subred de origen existe como objeto de servicio y el punto de acceso de autenticación es un destino conocido. Una regla que hace referencia a un objeto renombrado hace tres semanas falla aquí. El mensaje indica el nombre obsoleto días antes de que el despliegue hubiera revelado el fallo.
- Validación del esquema. El artefacto generado tiene la estructura esperada. Un artefacto mal formado nunca entra en el almacén.
- Pruebas de generación con la solicitud. Al incorporar el flujo, las pruebas emplearon datos preparados. Este control las repite con los valores de la propia solicitud. Así detecta un valor que aquellos datos no contemplaban, como una descripción de regla con un carácter que la plantilla no escapa.
- Simulación, si hace falta. El cambio pasa por el laboratorio cuando lo indica su definición, como veremos a continuación.
El orden responde al coste. Las comprobaciones que no dependen unas de otras se ejecutan en paralelo: se pueden ejecutar a la vez el control de integridad y los controles de esquema de tres tipos de configuración. El flujo es un DAG, es decir, un grafo acíclico dirigido en el que cada etapa depende únicamente de etapas anteriores. Los patrones de DAG del capítulo 8 se aplican directamente.
La desviación no es un control de validación. Saber si un dispositivo sigue ajustándose a la intención es una pregunta sobre la red, no sobre el cambio. La Fuente de Verdad conoce la intención, pero desconoce el estado real. Observabilidad responde en dos momentos. Compara continuamente el estado observado con la intención y genera una alerta específica si detecta desviaciones (capítulo 7). Además, justo antes de modificar los dispositivos de cada oleada, el despliegue ejecuta el control de desviación
per_wave. En un dispositivo pendiente de cambio, cierta diferencia es normal: los datos que modifica el cambio difieren del dispositivo hasta que se aplica la oleada. El control descarta esa diferencia. Lo que queda corresponde a otra parte de la intención y constituye la desviación peligrosa.
El último control, la simulación, es el más costoso. Solo se ejecuta cuando lo exige la definición: para las solicitudes de alto riesgo, las que cambian una plantilla o las que introducen una función que el laboratorio aún no ha probado, como un protocolo nuevo. La regla de la historia inicial es de alto riesgo y pasa por este control. El flujo despliega la regla generada en una copia emulada de la sede. Utiliza el mismo flujo, el mismo Ejecutor y la misma verificación, pero apunta al laboratorio. El capítulo 10 describe el diseño del control. A la NAP le toca ejecutarlo sin intervención humana siempre que haga falta. Para eso necesita tres cosas:
- Topologías bajo control de versiones. Cada topología de laboratorio se guarda en un archivo del repositorio de la NAP y se revisa como código.
- Topologías sincronizadas desde la Fuente de Verdad. Una tarea programada exporta los dispositivos, enlaces y versiones de los sistemas operativos pertinentes y regenera los archivos de topología. Así, el laboratorio va como máximo un día por detrás de producción. Para las reglas de cortafuegos no basta con la topología: que otra regla oculte la nueva, o que esta oculte otra, depende de las reglas que ya tenga el par. El laboratorio necesita una instantánea del conjunto de reglas de producción. Otra posibilidad es que el control analice esa instantánea mediante un modelo en lugar de emular los dispositivos.
- Laboratorios iniciados por el flujo. La etapa de simulación solicita capacidad a la IDP, arranca la topología, ejecuta el flujo, recoge el resultado y desmantela el laboratorio. Si alguien tiene que iniciar el laboratorio a mano, bajo presión se saltará el control.
El laboratorio necesita la diversidad de producción, sin tener que reproducir su escala. Incluye cada fabricante y cada función de dispositivo del parque. En un parque brownfield incluye también cada generación de firmware con diferencias conocidas en el plano de gestión, como explica la sección Tiempos de espera, reintentos, interruptores de circuito y contrapresión del capítulo 12. Cinco switches de tres fabricantes detectan más problemas que cincuenta idénticos.
Un cambio que supera sus controles de validación es correcto. Determinar si ha llegado el momento de aplicarlo es otra cuestión.
Promoción y ventana de mantenimiento#
El martes por la tarde la regla de cortafuegos superó la revisión de intención y la simulación: de la solicitud al cambio validado pasó un día en vez de seis. La ventana de la sede se abre el sábado a las 02:00. La NAP distingue dos preguntas que el equipo de la historia inicial mezclaba: «¿es correcto el cambio y está aprobado?» y «¿es ahora el momento de aplicarlo?». El almacén de artefactos queda entre ambas, como muestra la Figura 11.8.
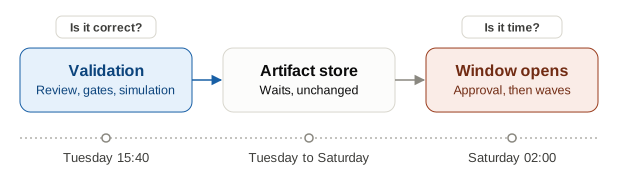
El flujo etiqueta el artefacto como aprobado para producción: ha superado todos los controles y puede pasar a producción cuando lo permita su nivel de riesgo. El artefacto espera tal como se validó. La aprobación del despliegue consiste en entregarlo al Orquestador: al abrirse la ventana de la sede, una persona del equipo de ingeniería lo promueve con los resultados de los controles y de la simulación a la vista.
Fíjate en la expresión «la ventana de la sede». La ventana es un atributo de la sede en la Fuente de Verdad. No se configura en el Orquestador. Una NAP que abarca varias regiones gestiona decenas de ventanas: las 02:00 del sábado en Fráncfort corresponden al viernes por la tarde en Nueva York. Guarda cada ventana en la hora local de la sede con su zona horaria. Deja que el Orquestador evalúe todas en UTC, la referencia que el capítulo 7 pide para las marcas de tiempo. Así, un despliegue entre regiones inicia cada oleada cuando se abren las ventanas de sus sedes. El cambio de horario se resuelve con los datos, sin introducir un error de programación.
La espera depende del nivel de riesgo. Para una solicitud estándar, como añadir una VLAN a un puerto de acceso o una regla que cumple la política de seguridad, una aprobación de despliegue y una ventana añaden demora sin aportar seguridad. Los controles ya hicieron las comprobaciones. Promueve esos cambios automáticamente en cuanto las superen. Ese es el despliegue continuo aplicado a la red, el resultado al que conducen el patrón de automatización preaprobada y la visión de producto del capítulo 15.
Quienes gestionan cambios conocen este modelo como cambio estándar de ITIL: una clase de cambio de bajo riesgo que el comité aprueba una sola vez para todas las solicitudes futuras. La aprobación sigue dejando el registro exigido por la normativa. La NAP lo genera a partir de la política que clasificó la solicitud y de los controles superados. El capítulo 13 trata las evidencias que pide auditoría. Reserva las dos aprobaciones y la ventana para solicitudes de alto riesgo, como esta regla en un par de cortafuegos, donde un fallo interrumpe un servicio y conviene que alguien esté pendiente durante la ejecución. Los niveles del Listado 11.4 recogen esa decisión una sola vez para todos los flujos.
La confianza permite que las solicitudes pasen de un modo al otro. Cada decisión acertada de un control aporta evidencia. Con el tiempo se amplía la política de preaprobación, más tipos de solicitud se clasifican como estándar y los demás pasan de ventanas mensuales a semanales y después a nocturnas.
Dos reglas protegen el cambio mientras espera. Primero, la promoción tiene un control: nadie puede promover un artefacto que haya fallado una validación y la NAP registra quién promovió qué. Segundo, pasa el tiempo y cambian tanto la intención como la red. Justo antes de cada oleada, la NAP repite el control de integridad de la SoT y ejecuta el control de desviación de esa oleada. Si la Fuente de Verdad ha cambiado (por ejemplo, se ha eliminado un dispositivo o renombrado un atributo) o un dispositivo se ha desviado, el cambio se detiene. Sin esa comprobación aparece el fallo de instantánea obsoleta: se despliega con éxito un artefacto incorrecto porque se generó con datos que ya no son ciertos.
En las redes brownfield, limita el control de desviación a los atributos afectados por el cambio. Un flujo de VLAN comprueba la tabla de VLAN, no el árbol de expansión ni Network Time Protocol (NTP). De lo contrario lo bloquearía todo desde el primer día, porque casi todos los dispositivos presentan alguna desviación.
Si un dispositivo falla el control previo de desviación, nadie lo modifica y cuenta como fallo para el umbral de cancelación de la oleada. El par de cortafuegos se detiene, ya que sus oleadas tienen una sola unidad. Una oleada de VLAN del campus omite ese switch y deja constancia de la diferencia en el registro del cambio. La alternativa es un despliegue forzado: descartar los valores que tiene el dispositivo en esos atributos y aplicar los de la Fuente de Verdad. Así también sobrescribes la causa de la desviación, incluida cualquier corrección de emergencia aún sin registrar. Trátalo como una solicitud de alto riesgo que debe aprobar alguien de ingeniería, nunca el personal de operaciones.
A las 02:00, el Orquestador inicia el despliegue del artefacto. El capítulo 8 explica el despliegue: el Patrón Saga compensa una oleada fallida y, tras la ventana de convergencia, el control de estado comprueba la configuración, el estado operativo, el estado del servicio y que nada más haya cambiado. Su Figura 8.4 ilustra el proceso. A la NAP le corresponde hacer cumplir la definición del flujo y la política de despliegue:
- Una instantánea por oleada. El Ejecutor captura la configuración de cada dispositivo justo antes de su oleada. Cuando empieza la tercera, los dispositivos de la primera pueden haber recibido otros cambios. Una instantánea tomada al principio de toda la ejecución también revertiría esos cambios.
- Avance solo tras superar el control. La oleada siguiente solo empieza si la anterior supera el control. Nadie puede saltárselo desde la CLI por falta de tiempo. Si alguien puede ignorar el límite entre oleadas, este deja de proteger la red.
- Umbral de cancelación y política de reversión de oleadas. Cuando la proporción de fallos supera el umbral del nivel de riesgo, el Orquestador compensa la oleada fallida. Después aplica la política de reversión de ese nivel a las oleadas anteriores.
El cambio de cortafuegos afecta a un solo par de alta disponibilidad. La primera oleada aplica la regla a la unidad de reserva y la verifica. La segunda la aplica a la unidad activa. Imagina que la unidad activa rechaza el commit. El Ejecutor restaura esa unidad a partir de su instantánea. Como el destino es un par redundante, su política es unwind_all. La Saga compensa entonces la primera oleada y retira la regla de la unidad de reserva. El par termina la noche en su estado original y coherente, con un fallo identificado para el turno de mañana. Nadie tiene que descubrir en la siguiente conmutación que el cambio quedó a medias.
¿Y si el Orquestador cae en mitad de la ejecución, como en la historia inicial? Aquí confluyen tres piezas que ya hemos visto. La antiafinidad ha mantenido una réplica en otro servidor, así que el Orquestador sobrevive a la pérdida de una máquina. El estado persistente indica que la primera oleada terminó y la segunda no ha empezado. La réplica retoma el flujo donde se detuvo: pasa a la segunda oleada o compensa la primera si se ha cerrado la ventana. Además, el sistema de observabilidad de la IDP, que se ejecuta fuera de la NAP, avisa a la persona de guardia en cuestión de minutos. En el peor caso sabemos que el par quedó a medio cambiar, hay una alerta abierta y alguien se encarga. Nunca se descubre por sorpresa en la próxima conmutación.
El orden de las oleadas importa en ese peor caso. Si empieza la unidad de reserva y el flujo se detiene entre oleadas, la regla queda únicamente en la unidad que no cursa tráfico. Para una regla que permite acceso, ese es el lado seguro: si el par conmuta antes de que alguien lo corrija, el servicio gana acceso en vez de perderlo. Para una regla de denegación ocurre lo contrario: la conmutación adelantaría el bloqueo. Por eso la política del Listado 11.4 ordena el par según el efecto del cambio: por defecto empieza la unidad de reserva, pero si se retira acceso empieza la activa.
La VLAN del campus de 800 switches es un cambio de nivel estándar y su política es halt. Si falla la tercera oleada, los edificios de las dos primeras conservan la VLAN que ya validaron y ninguno queda peor que antes.
Decidan lo que decidan las oleadas, la ejecución termina de una de dos formas: un cambio verificado o una reversión verificada.
Verificar, registrar o revertir#
La Reversión en una red es distinta de la reversión de software. Para revertir un contenedor basta con arrancar la imagen anterior. Revertir un artefacto en el almacén no cambia nada en los dispositivos. Hay que diseñar la reversión de red antes de iniciar el cambio. De las cuatro reversiones de la parte 2 (Figura 8.7 del capítulo 8), dos modifican dispositivos. La reversión de la ejecución restaura desde su instantánea los dispositivos en los que falló la tarea del propio Ejecutor (capítulo 6). La compensación de la Saga deshace pasos completos que ya habían terminado (capítulo 8). La NAP añade cuatro reglas:
- Una reversión se verifica como un cambio. Después de revertir se ejecuta el mismo control. Hasta que no se verifica, la reversión es solo una afirmación.
- Una reversión fallida detiene el flujo. Si un dispositivo queda inaccesible durante la reversión, la ejecución se detiene y avisa a la persona de guardia, tal como declara el ajuste
on_failure: halt_and_pagedel Listado 8.2 del capítulo 8. Un parque dividido entre dos estados sin constancia del estado de cada dispositivo es peor que un problema conocido. - Las instantáneas se guardan en el almacén de artefactos. Cada una conserva la misma información de procedencia que el artefacto usado para aplicar el cambio. Así, la referencia para la reversión es el estado que encontró la oleada. Nunca se vuelve a generar a partir de una Fuente de Verdad que puede haber cambiado desde entonces.
- La Fuente de Verdad conserva la intención. La reversión restaura la red. Cuando se revierte el cambio de cortafuegos, la Fuente de Verdad sigue guardando la regla nueva. Es lo que se pidió y sigue siendo la referencia, incluso si resulta ser incorrecta. La NAP registra que el cambio falló y se revirtió, de modo que la diferencia entre intención y red tiene una causa conocida. El personal de ingeniería la resuelve por la vía habitual: propone una regla corregida o un cambio que revierta la propuesta original. Hasta entonces, la siguiente solicitud para esos dispositivos se detiene en el control de desviación. Es deliberado: nadie añade un cambio encima de otro aún sin resolver.
La confirmación de cambios con plazo de espera (confirmed commit) me ha resultado especialmente útil: el dispositivo revierte el cambio por sí solo si nadie lo confirma a tiempo. El control cuenta con un paso de confirmación explícito y tú conservas una protección si el propio cambio corta la vía de gestión.
Sea cual sea el resultado, la NAP cierra la ejecución adjuntando al registro del cambio las evidencias: quién lo solicitó, qué controles superó, los artefactos y las instantáneas y el resultado por dispositivo. El capítulo 13 convierte ese registro en la Cadena de procedencia (Provenance Chain) que puede consultar auditoría.
Hasta aquí hemos supuesto que el camino está abierto. El último paso explica qué hace el equipo cuando está bloqueado.
Cuando el camino está bloqueado#
A veces el camino recomendado está cerrado: la NAP está caída, el flujo de cambio no funciona o el cambio no puede esperar a la ventana. Sin una alternativa legítima, el personal de ingeniería acaba encontrando otra por su cuenta, y el cambio queda sin registrar. Proteger la rama principal evita que alguien se salte los controles por comodidad, pero no resuelve una emergencia a las 03:00.
La mayoría de los cambios urgentes pueden seguir el camino habitual. Una vía de emergencia conserva los controles automáticos y acorta los tiempos de intervención humana. La persona de guardia da las dos aprobaciones en el momento y otra persona de ingeniería repite la revisión de intención el siguiente día laborable. Solo se simula si la urgencia lo permite. Así se puede bloquear en minutos un prefijo desde el que se está atacando la red. Queda el mismo registro que para cualquier cambio y la revisión posterior confirma la regla o abre una solicitud para retirarla. El acceso de emergencia directo se reserva para cuando la propia NAP no puede funcionar.
Si la NAP está caída, la alternativa prevista es un procedimiento de acceso de emergencia: acceso directo a los dispositivos, restringido a personas identificadas, con autorización explícita y un registro independiente que permite detectar manipulaciones. Su uso genera una alerta y activa una revisión. Antes de que la NAP vuelva a modificar esos dispositivos, se concilia la Fuente de Verdad con el cambio manual. Lo garantiza el control previo a la oleada: mientras la Fuente de Verdad no refleje el cambio manual, toda solicitud para esos dispositivos se detiene en ese punto. Ambas vías deben figurar en el manual de guardia y ensayarse antes de la noche en que hagan falta. El capítulo 12 trata el procedimiento ante una caída total. El capítulo 13 explica la gobernanza y el procedimiento cuando la seguridad de la NAP se ha visto comprometida.
Aquí termina el recorrido. Si lo miras en conjunto, reconocerás buena parte de lo que ocurre en la capa inferior.
Patrones comunes a ambas plataformas#
La IDP y la NAP sirven a usuarios distintos y las construyen equipos distintos. Sin embargo, resuelven el mismo problema en capas diferentes: aplicar un cambio de forma segura por un camino que otras personas puedan utilizar. Por eso la mayoría de los patrones del capítulo aparecen dos veces. La Figura 11.9 muestra el caso más claro: ambas plataformas hacen pasar sus artefactos por el mismo ciclo de vida, con controles distintos.
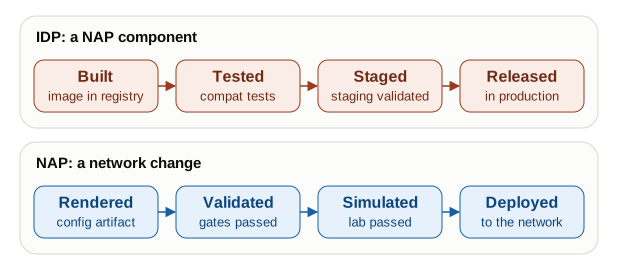
La Tabla 11.2 recoge los demás patrones. Si conoces uno en una de las plataformas, puedes reconocer cómo se aplica en la otra.
| Patrón | En la IDP | En la NAP |
|---|---|---|
| La plataforma como producto para ingeniería | Sus clientes son los equipos de aplicaciones y el equipo de automatización de redes | Sus clientes son el personal de ingeniería y el de operaciones de red |
| Camino recomendado | Una plantilla de servicio que permite desplegar el primer día | Una estructura base de flujo que permite desplegar un primer cambio |
| Contrato de plataforma | Imágenes de runner y API del registro y del entorno de ejecución con versiones | API de envío, definiciones de flujos y estructuras base con versiones |
| GitOps | Conciliación de los componentes de la NAP a partir de un repositorio | La intención solo cambia mediante solicitudes revisadas. Las desviaciones generan una alerta sin activar una corrección automática |
| Promoción de artefactos | La imagen se construye, se prueba, pasa a preproducción y se publica | La configuración se genera, se valida, se simula y se despliega |
| Despliegue progresivo | Despliegue canario: una parte de las ejecuciones pasa a la versión nueva | Oleadas: una parte de los dispositivos en cada oleada, con controles de estado de la red |
| Observación del recorrido | Duración de las tareas de la cadena, tasa de fallos, longitud de la cola | Tiempo hasta el primer resultado útil por cambio y tasa de fallos por control |
| Credenciales de corta duración | Un token por tarea | Una credencial de dispositivo por ejecución y por sede |
Cuando los patrones difieren, la razón está en la red. Revertir software restaura una versión anterior. La reversión en la red debe diseñarse antes del cambio y puede fallar si un dispositivo está inaccesible. En software, el impacto alcanza a una proporción de las solicitudes. En la red tiene límites físicos: un edificio o un par de cortafuegos. Además, el software está listo en cuanto arranca el proceso, mientras que la red necesita una ventana de convergencia antes de que un control pueda evaluarla. Reutiliza el patrón, pero comprueba cómo cambia su funcionamiento.
Saber qué patrones puedes reutilizar ayuda en la última parte del trabajo: mantener la NAP en funcionamiento durante años.
Operación y evolución de la NAP#
Una vez que la NAP ejecuta cambios, el equipo la opera como servicio y sigue desarrollándola. Veremos, por orden, cómo observarla, cómo obtener resultados con rapidez, cómo trabajar con los equipos que la rodean y cómo migrar la automatización existente.
La observación va primero, porque todas las demás decisiones de esta sección dependen de sus datos.
Métricas de estado de la NAP#
Un equipo que no puede observar su propia NAP está en la misma situación que un equipo de redes que no puede observar su red. La sección Observabilidad del sistema de automatización del capítulo 7 enumera las señales. La sección Observabilidad del software en ejecución de este capítulo sitúa en la IDP el conjunto de herramientas que las recoge. El capítulo 12 define las métricas de estado de la NAP y las convierte en niveles de servicio: tiempo hasta la finalización, tasa de éxito de los cambios, tiempo hasta el primer resultado útil y tiempo de vaciado de la cola.
Una de ellas corresponde a este capítulo porque es una métrica de producto antes que de operaciones. El tiempo hasta el primer resultado útil va desde el envío de la solicitud hasta el primer resultado que permite actuar. Suele llegar mucho antes que el resultado final. En el campus del ejemplo, una solicitud de VLAN para los 24 switches del edificio B debería devolver el resultado de integridad de la SoT en 60 segundos y, si han cambiado las plantillas, el de la simulación en 8 minutos. Si ese resultado empieza a tardar 20 minutos, algún paso se ha ralentizado. Localízalo antes de llegar a los 40 minutos, cuando el personal de ingeniería deja de esperar.
El tiempo de respuesta influye en la conducta más que cualquier otra métrica. Si un flujo de cambio responde en tres minutos, puedes echar un vistazo a otra cosa y volver para ver un resultado claro. Cuarenta minutos superan el tiempo que la mayoría puede mantener el problema en la cabeza. La gente pasa a otra tarea y tiene que reconstruir el contexto antes incluso de interpretar un fallo.
El personal de ingeniería reacciona de dos maneras, ambas perjudiciales. Algunas personas agrupan cambios para evitar esperas sucesivas. Eso concentra el riesgo y dificulta aislar los fallos. Otras se saltan la NAP para los cambios de los que se sienten seguras. Así se interrumpe el registro de auditoría y desaparecen los controles. La rapidez con que llega el resultado va más allá de un ajuste de rendimiento. Determina si el equipo confía en la NAP o busca cómo evitarla.
Colaboración con otros equipos#
El equipo de automatización de redes trabaja con tres tipos de equipo, como muestra la Figura 11.10.
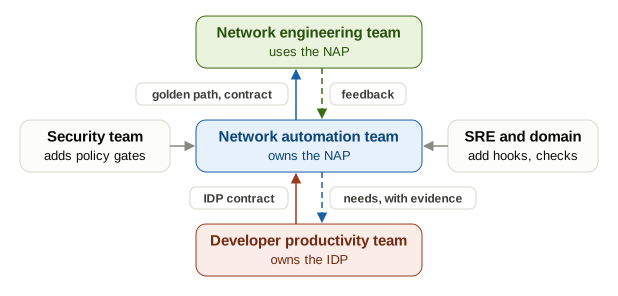
Por encima está el personal de ingeniería de redes, su clientela, a la que atiende mediante el camino recomendado y el contrato de plataforma. Por debajo está el equipo de productividad de los desarrolladores. Tu equipo depende de sus planes de trabajo, aunque las prioridades las fija ese equipo. Actúa como cliente: plantea pronto las preguntas de Qué esperar de la IDP, comparte tus métricas y pide el contrato por escrito. Pocos usuarios de la IDP necesitan acceso a la red de gestión, tareas largas o capacidad de laboratorio. Es más fácil que se prioricen esas necesidades de red si aportas datos.
Alrededor de la NAP hay equipos que quieren ampliarla: seguridad quiere incorporar controles de políticas, los SRE quieren integrar alertas y los equipos de cada dominio quieren añadir comprobaciones a sus flujos. Si todo pasa por el equipo de automatización, la espera crece con la adopción. El reparto sostenible es que ese equipo se encargue de los flujos de cambio principales y del camino recomendado, y que los demás contribuyan mediante el mismo proceso de revisión que cualquier otro cambio. Decide quién puede fusionar cambios en las definiciones de flujos y aplica esa decisión mediante el control de acceso. Si cualquiera puede modificar un flujo sin revisión, alguien lo hará cuando tenga prisa.
No todas las organizaciones empiezan con un equipo dedicado a la automatización de redes. Muchas empiezan con una o dos personas que se ocupan de la NAP además de su trabajo de redes. El modelo describe un objetivo. Para empezar, una sola persona puede mantener un camino recomendado mínimo, un flujo de cambio y un almacén de artefactos. El capítulo 14 explica cómo crece el equipo.
Estrategias de migración#
En Cuatro formas de ejecutar la automatización de redes vimos que la transición a la casilla objetivo solo termina cuando se cierran los caminos antiguos. ¿Cómo llegar hasta allí? La mayoría de los equipos que adoptan una NAP ya tienen automatización construida sin ella. Resulta tentador reescribirlo todo y fijar una fecha de transición. Fracasa por el mismo motivo que «el trimestre que viene lo refactorizamos todo»: el alcance es mayor de lo previsto, la fecha se aplaza y el equipo mantiene indefinidamente el sistema antiguo y una migración a medio hacer.
Incorpora los flujos uno a uno. Empieza por el que cambie más a menudo y cuyo fallo resulte más costoso. Si cambia con frecuencia, en unas semanas tendrás resultados y conocerás los casos límite que la estructura base del flujo no contemplaba. Si el riesgo es alto, los controles ya aportan valor. Ejecuta ese flujo de principio a fin en el laboratorio antes de utilizarlo en producción. Después pasa al siguiente. Cada flujo resulta más fácil que el anterior porque los patrones están documentados y el camino recomendado se ha adaptado a casos reales. Cierra cada vía antigua cuando entre en servicio su sustituta.
La migración lleva a la NAP la automatización que ya tienes. La última pregunta es por dónde empezar si hay poco que migrar o si todavía no existe la propia NAP.
La NAP mínima viable#
Cuando un sistema complejo funciona, invariablemente se descubre que evolucionó a partir de un sistema sencillo que ya funcionaba.
John Gall
Ya conoces el conjunto. ¿Por dónde empezar si tienes una red real que mantener y no quieres construir una NAP que solo sirva para algo cuando estén todas las piezas? Por las cinco etapas de la Figura 11.11. Tres aprovechan capacidades de la IDP y dos construyen lo que solo puede proporcionar la NAP. Cada etapa resuelve una carencia de la automatización mediante scripts, resulta útil por sí sola y hace posible la siguiente. Es la ley de Gall aplicada: cada etapa es una NAP sencilla que funciona.
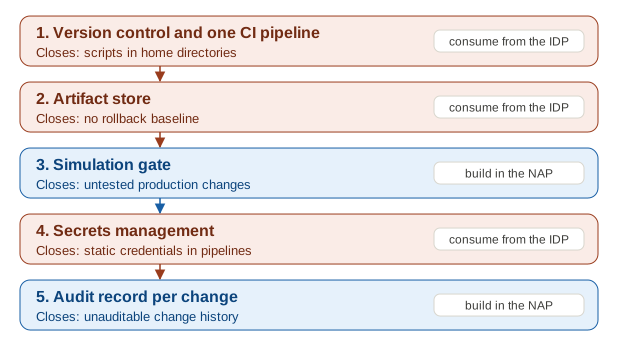
Control de versiones y una cadena de CI (utilizar la IDP). Guarda todos los flujos de automatización en un repositorio de la IDP. Con cada commit, ejecuta una cadena que valide la sintaxis y realice pruebas unitarias. Así se resuelve el problema de los scripts guardados en directorios personales: cada cambio tiene un historial y todas las ejecuciones utilizan un entorno coherente, en vez del portátil que esté disponible. Has completado esta etapa cuando todos los flujos de automatización se prueban en CI y todo el código de automatización está en el repositorio.
Un almacén de artefactos para las configuraciones generadas (utilizar la IDP). Cada cambio conserva ahora la configuración que genera. Así se resuelve el problema de la reversión: el artefacto anterior existe y se puede restaurar sin volver a generarlo desde una Fuente de Verdad que puede haber cambiado. Es también el primer elemento del registro de auditoría. Has completado esta etapa cuando cada despliegue produce un artefacto con un identificador de versión y puedes localizar cualquier despliegue anterior por ese identificador.
Un control de simulación en un laboratorio mínimo (construir en la NAP). Unos pocos dispositivos emulados, de los mismos fabricantes y con las mismas versiones de sistema operativo que el parque, detectan lo que escapa a las comprobaciones de sintaxis: errores de lógica en las plantillas, referencias ausentes en la Fuente de Verdad y fallos de idempotencia que solo aparecen ante un plano de gestión real. A partir de aquí, la NAP ya supera a los scripts tanto en seguridad operativa como en organización. Pide a la IDP la capacidad de laboratorio y construye tú el control. Has completado esta etapa cuando todos los cambios que requieren simulación según su flujo llegan a producción con el resultado de la simulación registrado.
Gestión de secretos en sustitución de las credenciales estáticas (utilizar la IDP). Cada ejecución recibe una credencial propia y de corta duración. Se emite al comienzo y caduca al final. Las etapas 1 a 3 organizan el trabajo y reducen el riesgo operativo, pero sin esta etapa siguen sin ofrecer seguridad de acceso. La clave estática que dejes en el archivo de una cadena o de un flujo es la que acabará encontrando una auditoría. Has completado esta etapa cuando ya no quedan credenciales estáticas en la configuración de cadenas o flujos, en variables de entorno ni en archivos que lea un runner o un trabajador.
Un registro de auditoría vinculado a cada cambio (construir en la NAP). Cada registro recoge la procedencia del cambio: quién lo autorizó, qué controles superó y el estado de la red antes y después. Ahora puedes responder a las preguntas de cumplimiento con los registros de la NAP y ahorrarte semanas de reconstrucción manual. El patrón Cadena de procedencia del capítulo 13 especifica la estructura completa. Has completado esta etapa cuando puedes consultar cualquier cambio de los últimos 90 días por dispositivo, solicitante y resultado sin tener que cruzar sistemas a mano.
¿Dónde quedan la Fuente de Verdad y el Orquestador? Las cinco etapas aportan la infraestructura que rodea a los bloques de la parte 2. Cada bloque tiene su propio punto de partida: la sección Primeros pasos del capítulo 5 para la Fuente de Verdad y el Ejemplo de implementación del capítulo 8 para el Orquestador. El estado persistente del Orquestador y las oleadas se vuelven imprescindibles con el primer flujo que se despliega en varias oleadas, al mismo tiempo que los despliegues azul/verde. Si careces de IDP, debes construir las etapas 1, 2 y 4 en el orden que indica el final de Qué esperar de la IDP.
Si la IDP ya ofrece las capacidades necesarias, las etapas 1 a 4 requieren semanas, no meses. Un equipo que ha llegado a la etapa 2 ya está en una situación considerablemente mejor que otro que utiliza scripts, aunque le falte un año para la etapa 5. La NAP completa de los capítulos 11 a 13 va mucho más allá: controles de políticas como código, clasificación por niveles de riesgo y federación entre regiones.
Resumen#
Solemos abusar de la palabra «plataforma». Al construir una solución de automatización de redes hay dos: la plataforma de automatización de redes (NAP), que atiende los casos de uso de red, y la plataforma interna para desarrolladores (IDP), que permite desplegar la propia NAP. Trabajan juntas, pero tienen responsables y capacidades muy diferentes. Entenderlo te facilita el trabajo: la IDP despliega software y la NAP despliega cambios de red.
Ese reparto afecta a todo lo demás. Al construir la NAP te apoyas en la IDP mediante un contrato. La propia NAP se convierte en un producto que ofrece un camino recomendado al personal de ingeniería que la utiliza para operar la red. Cada ámbito tiene responsabilidades propias.
En definitiva, la NAP se despliega en la IDP como cualquier otro software: con las mismas buenas prácticas y planes explícitos para reducir riesgos y ganar velocidad. A su vez, la NAP se encarga de aplicar cambios de red de principio a fin, desde la recepción hasta el despliegue. Hace cumplir los controles y proporciona información útil durante el proceso, por ejemplo mediante una simulación.
En el capítulo 12 partiremos de esta base para examinar también qué puede salir mal. Cuando el entorno se degrada, la NAP debería seguir funcionando.
Referencias#
- Team Topologies, Matthew Skelton y Manuel Pais (IT Revolution, 2019). Obra de referencia sobre la organización de equipos en torno a sistemas de software. Sus modelos de equipos de plataforma y de equipos alineados con un flujo de valor describen la relación del equipo de productividad de los desarrolladores con el de automatización de redes, y la de este último con el personal de ingeniería de redes.
- Accelerate: The Science of Lean Software and DevOps, Nicole Forsgren, Jez Humble y Gene Kim (IT Revolution, 2018). Investigación empírica que identifica la frecuencia de despliegue, el tiempo de entrega y la rapidez de respuesta como indicadores adelantados del rendimiento. Las métricas de carga cognitiva y de tiempo de respuesta de la NAP se apoyan en este trabajo.
- Continuous Delivery, Jez Humble y David Farley (Addison-Wesley, 2010). Primer estudio sistemático de la arquitectura de cadenas de CI/CD. La distinción entre integración continua y entrega continua, y el modelo de promoción de artefactos de Un cambio de red de principio a fin, proceden directamente de este libro.
- Platform Engineering on Kubernetes, Mauricio Salatino (Manning, 2023). Guía práctica sobre las plataformas internas para desarrolladores en infraestructura nativa de la nube.
- Site Reliability Engineering, Betsy Beyer, Chris Jones, Jennifer Petoff y Niall Richard Murphy (O’Reilly, 2016). Obra de referencia sobre la operación de infraestructura compartida como servicio fiable. Su modelo de presupuesto de errores, su método para eliminar el trabajo manual repetitivo y su disciplina de SLO se corresponden con las métricas de estado y los niveles de servicio de la NAP que define el capítulo 12. (Texto completo disponible gratuitamente en línea.)
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo