La Red#
La automatización de VLAN llevaba tres semanas funcionando en el laboratorio. Había tres switches, uno por fabricante, y todos los flujos de trabajo se completaban correctamente, así que el equipo se sintió seguro e intentó ponerla en producción.
La primera ejecución en producción se detuvo a medio camino al cerrarse la ventana de mantenimiento y el equipo, tal como estaba previsto, volvió a ejecutarla la noche siguiente. En la segunda ejecución fallaron 23 de los 800 switches del campus. Todos pertenecían a la misma plataforma del fabricante C y utilizaban una versión anterior del firmware que no estaba disponible en el laboratorio.
Tras enviar la configuración de VLAN, el playbook comprobaba la respuesta de error de cada dispositivo. Con el firmware actual del fabricante C, si la VLAN ya existe, el dispositivo devuelve el código de error duplicate-vlan. Con la versión anterior del firmware, en esa misma situación devolvía vlan-exists. El playbook estaba programado para interpretar duplicate-vlan como una señal de idempotencia que significaba «esto ya existe». Como no contemplaba vlan-exists, interpretó esa respuesta como un fallo. Los 23 switches indicaron que había fallado un cambio que ya habían aplicado la noche anterior, por lo que el equipo tuvo que dedicar tiempo a validar algo que ya era correcto.
La automatización era correcta. La red tenía un criterio propio que nadie del equipo conocía.
Este capítulo aborda el bloque que estaba implícito en toda la parte 2: la propia red. El equipo de automatización diseñó todos los bloques arquitectónicos construidos hasta ahora y cada uno se comporta según lo que especifican sus interfaces documentadas. La red, en cambio, la heredó. Tiene peculiaridades, interfaces diversas, diferencias de comportamiento entre versiones de firmware y capacidades que varían según el fabricante, la plataforma y la generación de software. Este capítulo responde a tres preguntas: ¿qué necesitamos de la red para que la automatización sea fiable?, ¿cómo validamos de forma segura la lógica de automatización antes de que actúe en producción? y ¿cómo se mantiene estable la automatización mientras la red sigue cambiando?
Fundamentos#
El capítulo 3 presentó la Red como uno de los siete bloques del marco NAF. Es el único bloque que no «pertenece» al equipo de automatización (es competencia de ingeniería de redes). El equipo configura la red, la observa y modela su intención, pero no creó el sistema operativo, el modelo de datos ni la interfaz de programación de aplicaciones (API). Esa dependencia condiciona todas las decisiones de diseño de la plataforma de automatización de redes (NAP) que se apoya en ella.
El capítulo 6 describió la vía de escritura del Ejecutor y el capítulo 7, la vía de lectura del Recolector. Ambos dan por supuesto que el dispositivo del otro extremo ofrece una interfaz fiable y coherente. Este capítulo examina si se cumple ese supuesto y qué hacer cuando no se cumple. Las dos vías suelen confluir en el mismo dispositivo y a menudo utilizan el mismo protocolo.
Este capítulo cierra la parte 2. En los seis capítulos anteriores construimos la NAP: un lugar donde almacenar la intención, un mecanismo para ejecutarla, otro para observar los resultados, un motor para coordinarlo todo e interfaces que dan acceso a la plataforma a quienes la utilizan. Este capítulo aborda aquello a lo que la NAP se ha dirigido desde el principio.
Tres objetivos definen la contribución del bloque de Red a la NAP:
Abarcar toda la gama de infraestructuras de red. Una NAP de gran tamaño puede comunicarse simultáneamente con switches de campus, fabrics de centros de datos, VPC en la nube, redes superpuestas de Kubernetes, controladores de redes superpuestas y equipos heredados. Cada tipo ofrece interfaces programables diferentes. La NAP debe admitirlos todos sin reducirlos a una única abstracción limitada al mínimo común denominador.
Validar la automatización y los nuevos diseños antes de que lleguen a producción. En un laboratorio, detectar errores de lógica, incumplimientos de los contratos de interfaz y peculiaridades de los dispositivos cuesta minutos, frente a las horas que cuesta hacerlo durante un incidente en producción. También es donde se prueban los nuevos diseños de red antes de pedir el hardware.
Mantener estable la NAP a medida que evoluciona la red. Se incorporan nuevos fabricantes. Cambian las versiones de firmware. Aparecen nuevos tipos de infraestructura. El diseño de la NAP debe permitirle absorber estos cambios mediante estrategias de abstracción, sin tener que aplicar parches ad hoc a cada flujo de trabajo cada vez que cambia la red.
Qué abarca este capítulo
- Las interfaces que utilizan el Ejecutor y el Recolector para acceder a los dispositivos de red y cómo elegir la adecuada para cada dispositivo y operación
- Los entornos y métodos de prueba que permiten validar la automatización antes de su paso a producción
- Las estrategias de abstracción para gestionar la heterogeneidad de fabricantes y plataformas
- Las implicaciones de las redes en la nube, las redes de Kubernetes y las redes superpuestas para el diseño de la automatización
Qué queda fuera del capítulo
- La generación de configuraciones a partir de plantillas y el código de esas plantillas (los adaptadores del Ejecutor, capítulo 6)
- Los mecanismos de ejecución: cómo ejecutan una tarea las herramientas de automatización, incluidos los adaptadores que se comunican a través de cada interfaz (Ejecutor, capítulo 6)
- La cadena de recogida de telemetría: cómo llegan las métricas a la base de datos de series temporales (Observabilidad, capítulo 7)
El criterio es siempre el mismo: de cada interfaz, este capítulo trata el lado de la red y deja fuera el de la NAP. Esa delimitación estructura las tres funcionalidades que se presentan a continuación.
Funcionalidades#
La NAP solo puede interactuar con la red en la medida en que esta se lo permite. Todas las decisiones de diseño de los seis capítulos anteriores remiten, en última instancia, a una pregunta: ¿qué admite el dispositivo que hay al otro extremo de la conexión? Esto vale para la forma de almacenar la intención, ejecutar tareas, recoger telemetría, coordinar los flujos de trabajo y atender a quienes utilizan la plataforma. Este capítulo examina directamente esa restricción.
La restricción afecta a todos los bloques. Un dispositivo que solo ofrece una interfaz de línea de comandos (CLI) obliga al adaptador del Ejecutor a extraer los datos del texto que aparece en pantalla. Si un dispositivo carece de una ruta OpenConfig, el Recolector tiene que recurrir a una solución específica del fabricante o dejar un hueco en los datos. La topología limita lo que el Orquestador puede ejecutar en paralelo: un tamaño de lote seguro para una capa de acceso plana puede dividir en segmentos aislados un fabric leaf-spine si el lote afecta a varios spines a la vez.
El equipo de automatización redactó el contrato de cada uno de los demás bloques y puede modificarlo. El de la red hay que descubrirlo, varía según la versión del firmware y a veces contradice su propia documentación. Si no puedes fijar un contrato, al menos puedes dejarlo por escrito: la Fuente de Verdad (SoT) registra, junto al inventario, la versión del sistema operativo, las capacidades de la interfaz y la función del dispositivo en la topología, porque estos datos condicionan la elección del adaptador, el método de recogida y el grado de concurrencia. Sin ellos, la SoT tiene carencias que solo se manifiestan en tiempo de ejecución. La Figura 10.1 relaciona cada objetivo de la Red con la funcionalidad que permite alcanzarlo.
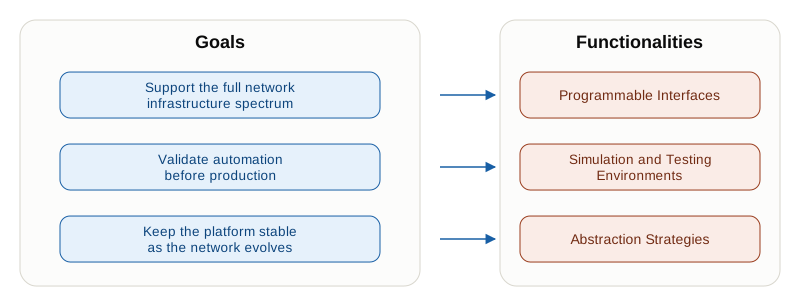
- Interfaces programables: los distintos tipos de red que debe automatizar la NAP y la interfaz que cada uno ofrece al Ejecutor y al Recolector.
- Entornos de simulación y pruebas: el conjunto de herramientas para la validación previa a la puesta en producción. Dónde encajan los distintos tipos de entornos de laboratorio, cómo se relacionan con el Patrón Saga (Saga Pattern) del capítulo 8 y cómo ampliarlos.
- Estrategias de abstracción: enfoques estructurales que permiten que la NAP se mantenga estable a medida que cambia la red subyacente, con independencia del fabricante, de la generación de la plataforma o del protocolo de la interfaz.
La primera funcionalidad condiciona todo lo que viene después, porque un dispositivo que no ofrece ninguna interfaz programable no se puede automatizar, sea cual sea el diseño del resto de la NAP.
Interfaces programables#
La red es heterogénea por naturaleza: reúne diversos tipos de infraestructura acumulados a lo largo de los años, cada uno con su propio modelo de interfaz, nivel de abstracción y grado de madurez de la automatización. A menudo, distintos equipos desarrollaron estas infraestructuras en paralelo. El capítulo 11 y el capítulo 14 examinan cómo se delimitan sus responsabilidades. Una NAP moderna puede abarcar simultáneamente switches de campus, fabrics de centros de datos, VPC en la nube, controladores de redes superpuestas, clústeres de Kubernetes, infraestructura WAN de proveedores de servicios y planos de reenvío gestionados por proveedores de hiperescala. La NAP debe admitirlos todos. El tipo de infraestructura determina qué interfaz está disponible. La NAP se adapta a esa realidad: no puede imponer una interfaz uniforme.
Según a qué se dedique tu empresa, puede que tengas que trabajar con distintos tipos de infraestructura de red. Estos son, a grandes rasgos, los escenarios:
La conmutación en campus y sucursales es el escenario principal que utilicé como ejemplo a lo largo de la parte 2: switches físicos de varios fabricantes y tres plataformas en un mismo parque de dispositivos. Los equipos de campus modernos ofrecen CLI, NETCONF y gRPC Network Management Interface (gNMI) simultáneamente. La automatización ha alcanzado un alto grado de madurez en los equipos de los últimos cinco a siete años. En los equipos heredados que aún utilizan firmware de hace una década, la madurez es desigual.
Los fabrics de centros de datos suelen tener una topología leaf-spine y a menudo proceden de un conjunto más reducido de fabricantes: Arista, Cisco Nexus, NVIDIA Cumulus o plataformas de redes abiertas diseñadas desde el principio para la automatización. Las interfaces son más uniformes que en las redes de campus y la gestión de cambios es más estricta. Las redes superpuestas EVPN/VXLAN añaden sobre el fabric un plano de gestión que puede tener su propia API, independiente de la interfaz de cada dispositivo. También es aquí donde primero se adoptan las plataformas de redes abiertas. SONiC y DENT ejecutan software de sistema operativo de red (NOS) sobre hardware de uso general, y las plataformas basadas en SONiC (Cisco 8000 y un ecosistema de ODM en expansión) ya son habituales tanto en los centros de datos que siguen el modelo de los proveedores de hiperescala como en los grandes centros de datos empresariales.
La infraestructura de los proveedores de servicios y de las redes WAN (routers de operadora, redes MPLS y fabrics con Segment Routing SRv6) plantea sus propios retos de automatización: la escala, la complejidad de los protocolos y la necesidad de gestionar tanto la configuración del plano de control como las políticas de ingeniería de tráfico. NETCONF y los modelos Yet Another Next Generation (YANG) están bien consolidados en este ámbito. Plataformas como Cisco IOS-XR y Junos ofrecen una cobertura madura de YANG. La NAP suele actuar sobre un controlador (SR-PCE, Crosswork, NSO) en lugar de hacerlo sobre cada dispositivo.
Redes en la nube: AWS VPC, Azure VNet, GCP VPC y otras, a las que se accede mediante API Representational State Transfer (REST) con consistencia eventual. Aquí no se «envía una configuración» a la espera de una confirmación síncrona: primero se acepta el cambio y después la red converge. El capítulo 6 explica qué supone esto para el Ejecutor: crear el recurso, consultar periódicamente su estado y verificar el resultado, además de utilizar tokens de corta duración en lugar de credenciales de dispositivo.
Las redes SD-WAN y las redes superpuestas (Cisco SD-WAN, Versa, VMware VeloCloud) se gestionan mediante un controlador. La automatización actúa sobre la API del controlador en lugar de hacerlo sobre cada dispositivo. La red física subyacente sigue existiendo, pero se gestiona íntegramente a través de la abstracción que ofrece la red superpuesta. Esto afecta tanto a la ejecución como a la observabilidad: el Ejecutor escribe las políticas en el controlador y la telemetría sobre el tráfico, la selección de rutas y la aplicación de las políticas también pasa por la interfaz norte del controlador.
Las redes de Kubernetes invierten por completo el modelo basado en dispositivos en la capa CNI. La red se define mediante objetos de la API de Kubernetes: NetworkPolicy, Services, Ingress y recursos personalizados de complementos CNI como Cilium o Calico. El dispositivo deja de ser un objetivo de automatización. La interfaz es la API de Kubernetes. Las políticas de red se expresan como código en lugar de como configuración de los dispositivos. Muchos entornos convergen en este modelo: intención declarativa, estado conciliado por un controlador y ausencia de acceso directo a los dispositivos.
Las DPU y las SmartNIC (NVIDIA BlueField, Intel IPU, Marvell Octeon) cambian el lugar donde se realiza el procesamiento de red. En algunos centros de datos, sobre todo en los de hiperescala y en los clústeres de inteligencia artificial (IA), cada servidor incorpora una DPU que asume funciones de red: encapsulación VXLAN, cifrado, aplicación de políticas de cortafuegos, balanceo de carga y microsegmentación. Estas funciones pasan de la unidad central de procesamiento (CPU) del host y de los equipos de red dedicados al firmware de la SmartNIC. Para la automatización, esto significa que el «dispositivo de red» ya no se limita al conmutador o al router del bastidor. Las funciones que antes se gestionaban a través de las API de equipos de red dedicados ahora se gestionan mediante el plano de gestión de la DPU y el SDK de su fabricante, un nuevo tipo de interfaz para el que las herramientas estándar de NETCONF y gNMI aún no ofrecen un acceso sencillo.
Las redes inalámbricas (Cisco Catalyst Center, Aruba Central, Juniper Mist) se basan en un controlador y la automatización actúa sobre su API. Esto es relevante siempre que el aprovisionamiento de VLAN abarque tanto los SSID inalámbricos como los puertos de los conmutadores de la red cableada, como ocurriría en el escenario del campus.
Las redes fuera de banda y las redes de gestión transportan el tráfico de todas las demás interfaces de esta lista. Las operaciones de escritura del Ejecutor y las de lectura del Recolector pasan en la práctica por servidores de consola, servidores de terminales, conmutadores de gestión y hosts de salto. Por eso, este es el único tipo de infraestructura cuyo fallo también deja fuera de servicio a la NAP. De ello se derivan dos consecuencias:
- Es un objetivo de automatización como cualquier otro. Las VRF de gestión, las ACL que determinan qué hosts pueden acceder al plano de gestión de un dispositivo y el acceso a los servidores de consola deben figurar en la SoT y configurarse de forma automatizada, aunque muchos equipos todavía los gestionan a mano.
- Requiere una política de cambios más estricta que el plano de datos. Si un cambio interrumpe la conectividad en banda, puedes restablecerla mediante el acceso fuera de banda. Si interrumpe la conectividad fuera de banda, alguien tiene que desplazarse hasta el emplazamiento. Cuando el dispositivo lo admite, el commit confirmado permite mitigar el riesgo en el propio dispositivo. Por eso, esta capacidad figura en la lista de comprobación de la sección Selección de interfaces por dispositivo, más adelante.
El bloque de Red abarca más que conmutadores, routers y controladores. También incluye los servicios de los que depende cada dispositivo y cada host, como Domain Name System (DNS), Dynamic Host Configuration Protocol (DHCP) y Network Time Protocol (NTP), y la NAP los automatiza como cualquier otro objetivo. Para poder utilizar una nueva VLAN de campus, debe existir su ámbito DHCP y el nombre de su puerta de enlace debe poder resolverse mediante DNS. Distingue los datos del servicio: los ámbitos y los registros forman parte de la intención y, en el ejemplo de campus del capítulo 5, son responsabilidad del IPAM. Los servidores que responden a las solicitudes forman parte de la red. Los productos DDI (DNS, DHCP e IPAM en un solo producto) suelen alojar tanto los datos como el servicio, de modo que una sola herramienta implementa dos bloques.
La lista no es exhaustiva. Lo importante es que automatizar cualquier red de cierta complejidad exige trabajar con varios de estos tipos de infraestructura a la vez. El Ejecutor y el Recolector deben dirigir cada operación al tipo de interfaz adecuado. La SoT debe modelar la intención en un nivel superior al de cada interfaz individual. De un modo u otro, la NAP debe asumir la complejidad de la red como una restricción de diseño.
Tipos de interfaces programables#
Cada tipo de infraestructura ofrece a la NAP uno o más tipos de interfaz. Un mismo conmutador físico puede ofrecer muchos a la vez. La NAP se adapta a las opciones disponibles y establece sus preferencias en función de la fiabilidad, la estructura y la escala. Ninguna regla universal impone un tipo de interfaz. La elección adecuada depende de lo que admita el dispositivo y de lo que requiera la operación.
- La CLI sobre Secure Shell (SSH) es universal, heredada y frágil. La extracción de datos de la salida en pantalla y el análisis de texto fallan cuando el firmware cambia el formato de salida o añade campos. Los códigos de error varían entre fabricantes y entre versiones de firmware. La CLI sigue siendo la única opción en los equipos más antiguos. Conviene reducir su uso al mínimo y evitar que los flujos de trabajo dependan de ella salvo para los dispositivos que carecen de alternativa (el último recurso). Así se configura la descripción de una interfaz:
interface GigabitEthernet0/1
description uplink-to-core- NETCONF es estructurado, es transaccional y, cuando funciona, da resultados correctos. Admite operaciones atómicas y reversiones cuando el dispositivo implementa las capacidades opcionales candidate y confirmed-commit, y su modelo de datos se puede analizar automáticamente. La capa de transporte (XML sobre SSH) suele ser fiable. Las carencias se encuentran en la capa del modelo de datos. La calidad de los modelos YANG de los fabricantes varía considerablemente: un dispositivo puede anunciar que admite NETCONF y, aun así, ofrecer modelos incompletos o propietarios para funciones que necesita la NAP. Los modelos YANG del IETF y de OpenConfig estandarizan la capa de intención. Los modelos YANG nativos de cada fabricante cubren las carencias. Así se configura la misma descripción de interfaz mediante NETCONF:
<config>
  <interfaces xmlns="urn:ietf:params:xml:ns:yang:ietf-interfaces">
    <interface>
      <name>GigabitEthernet0/1</name>
      <description>uplink-to-core</description>
    </interface>
  </interfaces>
</config>- RESTCONF es el equivalente de NETCONF basado en Hypertext Transfer Protocol (HTTP) y ofrece los mismos modelos YANG con la semántica de REST. Resulta útil cuando los equipos se manejan mejor con las herramientas de HTTP que con el transporte XML sobre SSH de NETCONF. El modelo de datos es el mismo. Solo cambia el transporte. La compatibilidad entre fabricantes es menos uniforme que en el caso de NETCONF. Así se configura la misma descripción de interfaz mediante RESTCONF:
PATCH /restconf/data/ietf-interfaces:interfaces/interface=GigabitEthernet0%2F1
Content-Type: application/yang-data+json

{
  "ietf-interfaces:interface": [
    {
      "name": "GigabitEthernet0/1",
      "description": "uplink-to-core"
    }
  ]
}- gNMI y gNOI son protocolos basados en gRPC Remote Procedure Call (gRPC). gNMI se encarga de la telemetría y de la lectura y escritura de la configuración. gNOI se encarga de los comandos operativos. Ambos son modernos y se adaptan bien al trabajo a gran escala. Cada vez más fabricantes los admiten, aunque sus modelos no siempre son compatibles entre sí. El capítulo 7 abordó gNMI desde la perspectiva del Recolector. Este capítulo trata el requisito previo que debe cumplir el dispositivo: debe admitir suscripciones gNMI en la versión del sistema operativo para la que está diseñada la NAP. Así se configura la misma descripción de interfaz con una SetRequest de gNMI:
path:  /interfaces/interface[name=GigabitEthernet0/1]/config/description
value: "uplink-to-core"- Las API REST de los fabricantes (eAPI, NX-API, Cumulus NVUE y otras similares) permiten la lectura automática, pero no siguen un estándar común entre fabricantes. Sirven para cubrir carencias cuando NETCONF o gNMI no están disponibles u ofrecen compatibilidad parcial con una operación concreta. Los conmutadores NVIDIA Cumulus ofrecen NVUE como interfaz programática principal: es una API REST estructurada con un esquema JavaScript Object Notation (JSON) uniforme. Arista y Cisco Nexus ofrecen eAPI y NX-API, respectivamente, como alternativas a NETCONF. Encapsula el uso de estas API en la capa de adaptadores y evita basar en ellas una NAP independiente del fabricante. Así se configura la misma descripción de interfaz mediante eAPI de Arista (JSON-RPC sobre HTTPS), con el nombre de interfaz que utiliza Arista:
{
  "jsonrpc": "2.0",
  "method": "runCmds",
  "params": {
    "version": 1,
    "cmds": [
      "enable",
      "configure",
      "interface Ethernet1",
      "description uplink-to-core"
    ],
    "format": "json"
  },
  "id": "1"
}- Las API de la nube y de los controladores siguen patrones REST con consistencia eventual. El modelo de operaciones asíncronas es un requisito de diseño, por lo que no debe tratarse como una limitación que haya que sortear. En los planos de gestión de SD-WAN, de redes inalámbricas y de DPU, la API del controlador suele ser la única interfaz disponible. Añadir una descripción a una VPC de AWS ilustra este patrón. La llamada indica que la operación se ha realizado correctamente, pero EC2 tiene consistencia eventual: una llamada de consulta (describe) inmediatamente posterior podría no mostrar aún la etiqueta, así que el Ejecutor realiza consultas periódicas antes de verificar el cambio:
POST https://ec2.eu-west-1.amazonaws.com/ HTTP/1.1
Content-Type: application/x-www-form-urlencoded
Authorization: AWS4-HMAC-SHA256 ...

Action=CreateTags
&ResourceId.1=vpc-0a1b2c3d4e5f67890
&Tag.1.Key=Description
&Tag.1.Value=uplink-to-core
&Version=2016-11-15- La API de Kubernetes es declarativa y uniforme entre fabricantes, y sus controladores se encargan de conciliar el estado. La automatización actúa sobre NetworkPolicy, Services y los recursos personalizados de CNI. No hay acceso directo a los dispositivos. El servidor de la API es la única interfaz. Esta es una política de aislamiento de red para el servicio
app-payments:
apiVersion: networking.k8s.io/v1
kind: NetworkPolicy
metadata:
  name: app-payments-isolation
  namespace: production
spec:
  podSelector:
    matchLabels:
      app: app-payments
  policyTypes:
  - Ingress
  ingress:
  - from:
    - namespaceSelector:
        matchLabels:
name: app-payments- CONFIG_DB de SONiC (Redis) es la interfaz nativa de las plataformas basadas en SONiC. La interfaz es el propio almacén de configuración del sistema operativo, sin un protocolo superpuesto. La sección SONiC y las redes abiertas explica cómo funciona. Esta es la misma descripción de interfaz expresada como fragmento de CONFIG_DB:
{
  "PORT": {
    "Ethernet0": {
      "description": "uplink-to-core",
      "admin_status": "up"
    }
  }
}Selección de interfaces por dispositivo#
Cuando un dispositivo ofrece varias interfaces, la NAP debe elegir una para cada tipo de operación y mantener esa elección de forma sistemática. Si un conmutador de campus ofrece CLI, NETCONF y gNMI a la vez, hay que tomar una decisión y evitar combinaciones que varíen según el flujo de trabajo o las preferencias de cada ingeniero. Elige un protocolo por tipo de operación y mantén esa elección. Evita usar dos protocolos para la misma operación.
La Figura 10.2 muestra la elección resultante para cada tipo de operación.
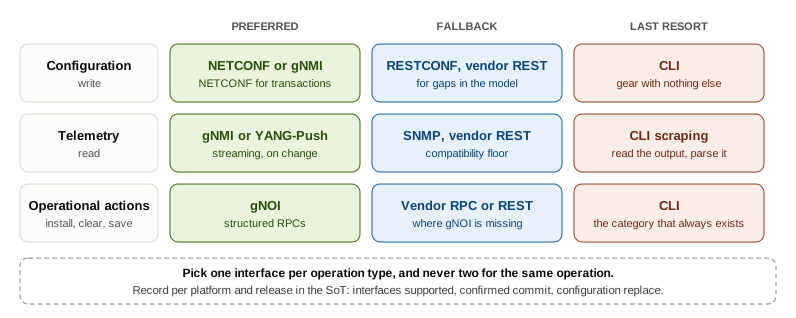
Lee la matriz por operación en lugar de por protocolo. Tanto gNMI como NETCONF permiten escribir la configuración y leer el estado, de modo que la columna de opciones preferidas refleja las ventajas operativas de cada protocolo sin atribuirle funciones exclusivas: las transacciones y la reversión que ofrece NETCONF lo convierten en la opción habitual para la configuración, y las suscripciones a flujos continuos de datos que ofrece gNMI lo convierten en la opción habitual para la telemetría. La columna de alternativas cubre las carencias de los modelos que están incompletos para una función concreta, y la CLI queda para los equipos que carecen de interfaces estructuradas.
La tercera fila es la que los equipos suelen olvidar. Incluso una plataforma moderna con cobertura completa de NETCONF sigue necesitando la CLI o gNOI para las acciones que quedan fuera del modelo de configuración, como poner los contadores a cero, instalar una imagen, guardar la configuración en ejecución o recopilar un paquete de diagnóstico para soporte. Cuando el dispositivo implementa gNOI, este protocolo ofrece una interfaz estructurada y la NAP debería darle preferencia frente a la extracción de datos de la salida en pantalla del mismo comando. Lo que la NAP debe evitar es actuar como si esta categoría no existiera y dejar que cada equipo tenga que improvisar bajo presión una vía de ejecución por CLI.
La lectura sigue el mismo orden. El capítulo 7 lo aplica a la recopilación de datos: primero, la telemetría en streaming, después, la exportación de flujos para saber quién utiliza la capacidad de la red, luego, Simple Network Management Protocol (SNMP) como mínimo común de compatibilidad y, en último lugar, la extracción de datos de la salida de la CLI.
Al evaluar el protocolo, conviene incluir en la lista de comprobación dos capacidades del dispositivo, porque determinan qué puede hacer la NAP con seguridad y varían según la plataforma y la versión:
- Commit con confirmación. El dispositivo aplica el cambio y lo revierte automáticamente si la NAP no lo confirma antes de que venza el plazo. Así, el propio dispositivo ofrece protección frente a un cambio que corte la conexión que la NAP utiliza para acceder a él. De esa protección depende que un cambio erróneo se resuelva con un reintento o que obligue a desplazarse hasta la sede. Como la compatibilidad varía, la SoT debe registrarla como atributo de cada plataforma. Un parque de dispositivos que combine plataformas con y sin esta capacidad necesita la alternativa descrita en el capítulo 6: una instantánea previa al cambio y una vía externa de reversión. El capítulo 16 muestra cómo se utiliza en un bucle cerrado.
- Sustitución de la configuración. Se trata de saber si el dispositivo puede aceptar una configuración declarada completa y eliminar lo que ya no figura en ella, en lugar de limitarse a incorporar elementos nuevos mediante una fusión. Las interfaces que solo admiten la fusión permiten añadir una VLAN, pero no hacer que el dispositivo vuelva a ajustarse a la intención, porque nada elimina las líneas que la intención ya no contiene. El capítulo 6 presenta la escala de operaciones, ordenadas de menor a mayor alcance del impacto: fusión, sustitución y sobrescritura. Aconseja elegir la de menor alcance que permita efectuar el cambio. Aquí importa la pregunta previa: ¿cuáles de las tres admite el dispositivo? Una plataforma que solo admite la fusión no permite la conciliación, y de ello depende que sea posible corregir en ella la desviación de la configuración.
Desde el punto de vista de los dos bloques arquitectónicos que interactúan con las interfaces programables:
El Ejecutor necesita idempotencia o, como mínimo, códigos de error fiables que distingan entre «ya existe» y «ha fallado». También necesita respuestas de error estructuradas y la capacidad de verificar el estado tras aplicar el cambio. El problema con
vlan-existsyduplicate-vlandel caso inicial se debió al incumplimiento de la primera condición: el significado de los códigos de error cambió entre versiones del firmware.El Recolector necesita lecturas estructuradas, suscripciones a telemetría en streaming y modelos de datos coherentes para que la capa de Observabilidad pueda prescindir de analizadores específicos para cada dispositivo. Cuando está disponible, gNMI es el protocolo preferido para las suscripciones: los datos se estructuran jerárquicamente y el dispositivo los valida según un esquema. Así se evita el análisis de texto específico de cada dispositivo que predominaba en la recopilación de datos en la época de SNMP.
Sin embargo, el código de error con el que empezaba el capítulo no estaba documentado en ninguna parte. El equipo lo descubrió al ejecutar el flujo de trabajo en un dispositivo. La siguiente funcionalidad responde a esta pregunta: ¿dónde ejecutas el flujo de trabajo por primera vez cuando lo único que se comporta como un dispositivo de red es un dispositivo de red?
Entornos de simulación y pruebas#
La red es infraestructura de producción. A diferencia de lo que ocurre con el backend de una aplicación, de entrada no hay un servidor de preproducción en el que hacer pruebas. Crear ese entorno es el cometido de esta funcionalidad. Sin él, se cumple lo que dice esta cita:
Todo el mundo tiene un entorno de pruebas. Hay quien tiene la suerte de contar además con un entorno de producción independiente.
Michael Stahnke
Probar la automatización de redes siempre ha sido más difícil que probar el código de una aplicación. Una red es un sistema distribuido con muchos componentes que el equipo de automatización no controla: los sistemas autónomos vecinos en los puntos de interconexión, los proveedores de tránsito aguas arriba, los CPE gestionados por los clientes, los clientes inalámbricos y la infraestructura en la nube operada por terceros. Un proveedor de servicios que prueba un cambio de política de enrutamiento no puede levantar un vecino Border Gateway Protocol (BGP) simulado de un proveedor de tránsito para validar el comportamiento en su conjunto. Una empresa que prueba un flujo de trabajo de conmutación por error de la WAN no puede controlar cómo responde el proveedor de MPLS.
Los entornos de simulación descritos en esta sección son la mejor alternativa disponible: reproducen lo que controla el equipo, asumen las limitaciones de lo que queda fuera de su control y centran la validación en la capa lógica, que es donde realmente están los errores.
He hecho pruebas en producción más veces de las que reconocería en una auditoría. Casi siempre salieron bien, y ahí está el peligro: cada acierto hacía que el siguiente atajo pareciera más seguro. El laboratorio existe para que «la última vez funcionó» deje de ser tu plan de pruebas.
La simulación también sirve a otro grupo que ya utilizaba los laboratorios mucho antes de la llegada de la automatización. En el laboratorio se valida un diseño nuevo antes de hacer ningún pedido de hardware. ¿Converge este plano de control EVPN tal como afirma el documento de diseño? ¿Sigue funcionando la topología de reflectores de rutas si se pierde uno de ellos? ¿Distribuye ECMP el tráfico en la topología leaf-spine tal como suponía el modelo de capacidad? Para ese trabajo importa más reproducir todo el comportamiento del sistema operativo de red (NOS) que arrancar deprisa. Por eso se lleva a cabo en los entornos basados en máquinas virtuales y en los laboratorios físicos que se describen más adelante, fuera de la cadena que se ejecuta en cada commit.
Ambos usos comparten las herramientas y poco más: la validación del diseño comprueba si la red funciona como debe y el control de preproducción comprueba si la automatización funciona como debe. Este capítulo dedica más espacio al segundo uso porque es el nuevo, pero un equipo que ya cuenta con un laboratorio de diseño dispone de casi todo lo que necesita para ese control.
La pirámide de pruebas del capítulo 2 (pruebas unitarias, de integración y de extremo a extremo) se aplica directamente aquí. Las pruebas unitarias validan cada módulo de automatización de forma aislada, normalmente con respuestas simuladas de los dispositivos. Las pruebas de integración validan interacciones de varios pasos: comprueban que la API de la SoT devuelve la estructura de datos esperada y que el adaptador del Ejecutor genera correctamente la configuración a partir de esos datos y de la plantilla y procesa bien la respuesta del dispositivo. Las pruebas de extremo a extremo validan el flujo de trabajo completo con algo que se comporta como un dispositivo de red real. Los entornos de simulación corresponden al nivel de pruebas de extremo a extremo.
Tipos de entorno#
El entorno adecuado depende de lo que deba validar la prueba. Hay toda una gama, desde entornos de alta fidelidad en los que merece la pena invertir para comprobar con garantías cómo se comportará la red en producción, hasta entornos de bajo coste adecuados para las cadenas habituales de CI/CD. La Tabla 10.1 los presenta en ese orden, desde el hardware real hasta la emulación más ligera, y termina con un método que no emula nada.
| Tipo de entorno | Arranque | Plano de control | Reenvío | Integración con CI/CD |
|---|---|---|---|---|
| Laboratorio con hardware físico | No procede (siempre encendido) | Sí | Por hardware | Manual |
| Emulación basada en máquinas virtuales | Minutos | Sí | Por software | Limitada |
| Emulación basada en contenedores | Segundos | Sí | Por software | Nativa |
| Análisis de la configuración | Segundos | Modelado | Modelado, sin paquetes | Nativa |
Los laboratorios con hardware físico constan de un bastidor con conmutadores y routers reales y suelen reproducir los patrones de la arquitectura de producción. Utilízalos para estudiar comportamientos específicos del hardware, hacer pruebas de rendimiento y ensayar escenarios que la emulación no puede reproducir en absoluto: la óptica, los transceptores, el comportamiento del reenvío en los ASIC y cualquier caso en el que se ponga a prueba el propio chip. El coste es considerable por la inversión de capital, el consumo eléctrico, el espacio y el trabajo que supone mantener la topología del laboratorio sincronizada con la arquitectura de producción. Los laboratorios que se apartan de los patrones de producción generan una falsa sensación de seguridad. Su valor es real. El reto es mantenerlos al día con constancia.
La emulación basada en máquinas virtuales ejecuta imágenes completas del NOS como máquinas virtuales. Utilízala para probar la interoperabilidad de protocolos, validar diseños y comprobar el comportamiento del NOS completo cuando lo que interesa es cómo se comporta la red. El reenvío se realiza por software, al igual que en los contenedores descritos a continuación. Por tanto, lo que aporta un laboratorio de máquinas virtuales es la posibilidad de usar el NOS completo, con todas sus funciones, el plano de control real y las rutas de ejecución del código del fabricante, más que una reproducción fiel del hardware. La contrapartida es el coste: más memoria y CPU por nodo, un arranque que tarda minutos en vez de segundos y una integración limitada con las cadenas automatizadas. Resulta poco práctico para las pruebas habituales de cada commit.
La emulación basada en contenedores utiliza imágenes ligeras de sistemas operativos de red que se ejecutan en contenedores conectados mediante enlaces virtuales. La topología arranca en segundos. Utilízala para probar la lógica de automatización, validar los contratos de interfaz y probar los flujos de trabajo. Esas tareas cubren la mayor parte de lo que debe comprobar una cadena. Es el punto de partida más práctico para la mayoría de los equipos y la opción predeterminada para el trabajo habitual de CI/CD: con cada cambio en la propia automatización, ya sea una nueva versión de un flujo de trabajo o una modificación de una plantilla, se ejecuta el mismo código del flujo de trabajo en una topología de contenedores. Así se detectan errores de lógica antes de llegar a producción. Los paquetes sí se reenvían: los pares veth transportan tráfico, las sesiones BGP se establecen y los enlaces troncales transmiten tramas. Lo que un contenedor no puede reproducir es el hardware: el comportamiento del reenvío en los ASIC, el rendimiento a velocidad de línea, la gestión de colas de calidad de servicio (QoS) y todo lo relacionado con la óptica. Para validar la lógica de automatización basta con el reenvío por software, y la inversión se amortiza con el primer incidente que evita.
El análisis de la configuración no arranca ningún dispositivo. Una herramienta como Batfish analiza las configuraciones generadas a partir de plantillas y construye con ellas un modelo de la red: qué rutas aprende cada dispositivo, qué ACL se aplica a un flujo o si dos rutas son realmente redundantes. Ofrece respuestas en segundos, abarca todos los dispositivos registrados en la SoT en vez de los pocos que caben en un laboratorio y no necesita imágenes de los fabricantes. Lo que no puede observar es el comportamiento en tiempo de ejecución, porque nada se ejecuta: un código de error, un problema de temporización o una peculiaridad del firmware como la del caso inicial. Por eso complementa la emulación en lugar de sustituirla. El análisis comprueba qué significa la configuración. La emulación comprueba qué hace la automatización.
Los gemelos digitales son réplicas de la topología de producción que se actualizan con datos de la Fuente de Verdad (los mismos modelos de dispositivo, la misma topología y la misma intención vigente, procesados por los mismos adaptadores que en producción) y con el estado actual que aporta la Observabilidad. Un gemelo digital refleja con exactitud cómo es el entorno de producción en ese momento. El coste operativo es considerable: mantener sincronizados el gemelo digital y el entorno de producción exige una conciliación continua. Es una inversión propia de equipos maduros que ya han validado su NAP a escala y necesitan el máximo grado de confianza antes de pasar a producción.
Montar ese entorno a mano, arrancando cada imagen y conectando cada enlace virtual, deja de ser práctico en cuanto la topología supera unos pocos nodos. Las herramientas de orquestación de laboratorios se encargan de esa tarea. Más adelante, la sección Panorama de soluciones de este capítulo compara esas herramientas. Lo primero es entender en qué punto de la secuencia de despliegue interviene el laboratorio.
La simulación como control previo al paso a producción#
El capítulo 8 presentó el Patrón Saga (Saga Pattern): cada paso de un flujo de trabajo lleva asociada una acción compensatoria que se ejecuta si falla un paso posterior. Así es posible recuperarse de un cambio fallido en producción. La simulación añade un paso antes de que empiece la saga. Ejecuta primero el flujo de trabajo sobre una topología simulada y un error de lógica solo te costará una simulación en vez de una reversión en 800 switches. Cuando un cambio se somete a este control, solo se ejecuta en el destino de producción si supera la simulación. La Figura 10.3 muestra este control.
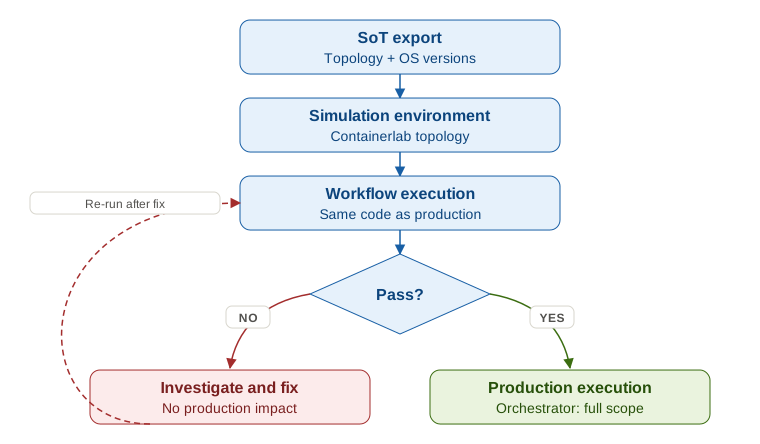
El control consta de cuatro pasos:
- La SoT exporta la definición de la topología para el ámbito del cambio, incluida la versión del sistema operativo de cada dispositivo de ese ámbito.
- Se crea el entorno de simulación con las imágenes correspondientes de cada fabricante y se fijan las versiones del sistema operativo que especifica el estado deseado en la SoT.
- El mismo flujo de trabajo que se ejecutará en producción se ejecuta primero en el entorno simulado.
- Si algún paso falla en la simulación, se investiga el fallo antes de proceder a la ejecución en producción.
El paso 2 es el que los equipos se saltan. La sección Limitaciones conocidas, más adelante, explica por qué ese paso determina el resultado.
Este control solo funciona cuando hay algo que se pueda instanciar, lo que lo limita al dominio físico. No puedes arrancar una controladora inalámbrica, un orquestador de SD-WAN o una VPC de nube en una topología de laboratorio, y esos dominios constituyen la mitad de los que se enumeraron en la sección Interfaces programables. También deben pasar un control, aunque necesitan uno distinto.
Para una controladora, el equivalente es un entorno de pruebas aislado para un inquilino o una instancia de la controladora fuera de producción. La mayoría de los fabricantes ofrece alguna de estas opciones y es la única forma de probar de verdad la API de una controladora. En la nube, el equivalente es una cuenta o un proyecto independiente junto con la simulación que ofrece el propio proveedor. Al ejecutar terraform plan contra la API real, obtienes la lista exacta de los recursos que el cambio crearía, modificaría y destruiría. Así se detecta la misma clase de errores que en una ejecución en laboratorio. Ambas opciones cuestan menos que un laboratorio de contenedores y ambas se omiten con más frecuencia porque ninguna tiene aspecto de laboratorio.
Una simulación satisfactoria solo supera el primer control de una secuencia que continúa en producción, oleada a oleada. Los controles entre oleadas son pasos del flujo de trabajo que el capítulo 8 describe en la sección Validación del estado operativo en el control de cada oleada.
Solo algunas solicitudes necesitan una ejecución en laboratorio, porque el laboratorio es el control más costoso. En el capítulo 11, este control se ejecuta como parte de la NAP y se determina qué cambios deben pasar por él: todos los que afectan a la propia automatización y las solicitudes cuya definición del flujo de trabajo lo exige, como las de alto riesgo.
Las topologías se mantienen bajo control de versiones y se sincronizan con las exportaciones de la SoT. Cuando un cambio requiere un laboratorio, el flujo de trabajo de cambio lo pone en marcha, de modo que el control se ejecuta sin que nadie tenga que acordarse de iniciarlo. El mismo laboratorio se utiliza también en capítulos posteriores. En el capítulo 16 se comprueba en él que un bucle cerrado funciona antes de aplicarlo en producción. En el capítulo 18, antes de que un agente proponga un cambio, es obligatorio simularlo para comprobar qué ocurriría.
Limitaciones conocidas#
El mapa no es el territorio.
Alfred Korzybski
La simulación reduce el riesgo. No lo elimina, y conviene señalar tres limitaciones antes de que un equipo tome una ejecución satisfactoria en el laboratorio como prueba concluyente.
Las diferencias de fidelidad del firmware. Una imagen de contenedor suele incluir código reciente del NOS, mientras que las peculiaridades que hacen fallar la automatización suelen encontrarse en el código antiguo. Si no fijas la imagen a la versión de firmware que la SoT registra para esos dispositivos, el laboratorio reproducirá el firmware que te gustaría tener en vez del que tienes en el bastidor. Fijar la versión fue lo que cambió el desenlace de la historia inicial: los nodos del fabricante C de aquella topología de containerlab ejecutaban la versión de producción y, por eso, vlan-exists apareció en el laboratorio en vez de en producción.
La simulación detecta de forma fiable errores de lógica, incumplimientos del contrato de interfaz, carencias de los modelos YANG y fallos a nivel de topología. Lo que no puede detectar es un estado del dispositivo que a nadie se le haya ocurrido reproducir.
La ausencia de equipos finales en uso. En el laboratorio no hay usuarios. No puedes simular cuatro mil equipos finales conectados, sus renovaciones de DHCP, sus suplicantes 802.1X, los cambios continuos de la tabla MAC de una planta en plena actividad ni el lector de tarjetas de acceso y la impresora de etiquetas que dejan de funcionar cuando se traslada la VLAN de la que dependen. Esta es la limitación más importante para el propio ejemplo del capítulo, porque un cambio de VLAN en un campus rara vez falla en el switch: falla en los equipos que estaban conectados a él.
Delimita con precisión el alcance de la simulación: valida el proceso de configuración, pero no el impacto en el servicio que reciben los equipos finales en uso. La comprobación del estado del servicio en el control de cada oleada cubre esa carencia. Y lo hace en producción, de oleada en oleada, que es precisamente la razón de ser de las oleadas.
El problema de las configuraciones únicas. La calidad de la simulación depende de la red que representa. Si tu parque de dispositivos tiene cientos de configuraciones personalizadas una a una, cada cual con su historial y sus excepciones, ninguna topología lo bastante pequeña para ejecutarse en una cadena de despliegue puede representarlo. Ese es el argumento práctico a favor de los patrones de diseño estandarizados, las plantillas de referencia y la configuración guiada por la SoT: una red bien diseñada se puede simular, y el valor del laboratorio se multiplica con el rigor del diseño.
Esto también convierte la simulación en un resultado del trabajo conjunto de los equipos de redes y de automatización. Quien sabe qué sedes son realmente idénticas y cuáles tienen excepciones sin documentar es un profesional de la ingeniería de redes. Sin ese conocimiento, la topología es una conjetura.
Un laboratorio demuestra que la NAP funciona con la red que tienes hoy. Nada te dice sobre el fabricante que se incorporará el próximo trimestre ni sobre la versión de firmware que volverá a cambiar un código de error. De ese problema se ocupa la última funcionalidad.
Estrategias de abstracción#
Incorporar un nuevo tipo de infraestructura no debe obligarte a reconstruir la NAP. En esta sección diseñamos la capa de automatización para que pueda adaptarse a los cambios, tanto a la heterogeneidad actual como a los tipos de infraestructura del año que viene.
La misma arquitectura sirve para una empresa, un proveedor de servicios o un operador a hiperescala. En cada dominio, la interfaz de red se sitúa entre la NAP y todo lo que hay detrás de esa interfaz. Es la única frontera que atraviesan tanto la ruta de escritura como la de lectura. Por eso basta un cambio de firmware para que la configuración y la telemetría dejen de funcionar a la vez. La Figura 10.4 muestra dos dominios. Un dominio de red superpuesta, accesible a través de la API de su controladora, añadiría otro con la misma estructura.
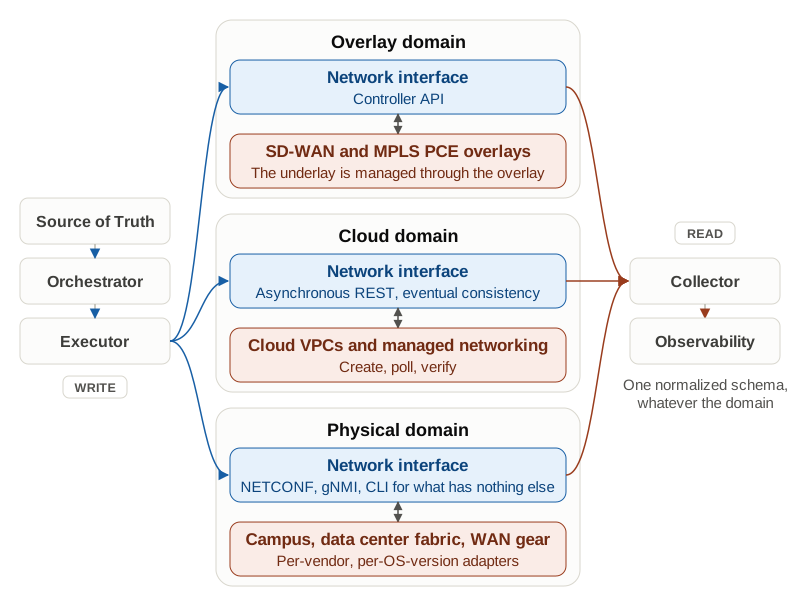
La Fuente de Verdad representa la intención de todos los dominios en un único modelo de servicio en la capa técnica. A continuación, los adaptadores del Ejecutor generan a partir de plantillas o traducen ese modelo al formato que espera cada elemento del inventario: líneas de CLI para un switch, una carga útil YANG para otro, el cuerpo de una solicitud API para una VPC de nube. El Orquestador puede ramificar el flujo de trabajo según el dominio de red. El Ejecutor selecciona el adaptador para cada destino a partir de los datos de la SoT y aplica el cambio a través de él.
Este reparto estructura toda la sección. La abstracción se realiza en dos lugares, cada uno con un único responsable:
- El modelo independiente del fabricante corresponde al bloque de Intención. La capa técnica describe la red una sola vez, en términos neutrales, y su esquema es el contrato que utiliza cada adaptador (capítulo 4). Incorporar un fabricante exige un adaptador nuevo, pero el modelo sigue siendo el mismo.
- Todo lo específico de cada fabricante corresponde a los adaptadores del Ejecutor. Generar la sintaxis de la plataforma a partir del modelo mediante plantillas o traducción, comunicarse mediante el protocolo, gestionar la sesión, seguir el modelo de funcionamiento del dispositivo y leer sus códigos de error son tareas del adaptador (capítulo 6). Un protocolo nuevo o una versión nueva del sistema operativo exige una versión nueva del adaptador, pero el modelo sigue siendo el mismo.
El Recolector es el equivalente del Ejecutor en la ruta de lectura. Hay un adaptador de recolección por protocolo que lee los datos del dispositivo, y el Procesador de Observabilidad normaliza el resultado conforme a un esquema común (capítulo 7). Muchas herramientas de recolección incorporan el Procesador: la misma herramienta alberga esa función, que sigue teniendo el mismo responsable. El fallo de la historia inicial estaba en la parte del adaptador encargada de enviar el cambio: la sintaxis de la VLAN era correcta, pero el adaptador interpretaba mal la respuesta del dispositivo.
Dimensiones de la heterogeneidad#
Antes de elegir una estrategia, conviene saber a qué tipo de heterogeneidad debe responder, porque cada tipo plantea un problema distinto. La Tabla 10.2 enumera las dimensiones y muestra cómo aborda la NAP cada una de ellas.
| Dimensión | Qué varía | Cómo responde el diseño de la NAP |
|---|---|---|
| Infraestructura física de varios fabricantes | Sintaxis de la CLI, modelos YANG y códigos de error | Un adaptador por plataforma que utiliza plantillas o un módulo para generar la sintaxis y envía el cambio a través de la interfaz del dispositivo |
| Generaciones de firmware (mismo fabricante) | Cambios de sintaxis o de comportamiento entre versiones del sistema operativo | El Ejecutor selecciona la versión del adaptador que corresponde a la versión del sistema operativo que indica el dispositivo |
| Red física frente a nube | Aplicación síncrona frente a llamadas REST asíncronas con consistencia eventual | El adaptador de nube traduce la intención en llamadas a la API mediante un módulo del proveedor. A continuación, crea el recurso, consulta su estado periódicamente y verifica el resultado |
| Red física frente a red superpuesta | Un controlador abstrae la red subyacente y pasa a ser el destino de las operaciones | El adaptador del controlador genera la política del controlador a partir de plantillas. El Ejecutor y el Recolector se comunican con el controlador, no con los dispositivos |
| Borde frente a núcleo | Alcance del impacto: el reinicio de un conmutador de acceso solo desconecta los hosts conectados a él. Un conmutador spine cuenta con redundancia, pero todos los racks dependen de él | El Orquestador ajusta el tamaño de cada lote según el alcance del impacto: desvía el tráfico de los spine de uno en uno, nunca incluye dos en el mismo lote y exige que la reversión en el núcleo pueda completarse dentro de la ventana de mantenimiento |
Todas las filas salvo la última corresponden a los adaptadores del Ejecutor. Lo que el dispositivo espera recibir determina la parte de generación a partir de plantillas o de traducción de cada adaptador. La forma de llegar al dispositivo o de recibir su respuesta determina la parte de entrega. La última fila es la excepción, porque el Orquestador solo percibe la heterogeneidad cuando esta cambia la forma de organizar un despliegue.
Tres estrategias permiten mantener pequeños los adaptadores. No hay que elegir entre ellas. Se aplican de forma acumulativa y en este orden:
- Empieza por el Patrón Adaptador (Adapter Pattern), que se explica en el capítulo 6. El Ejecutor cuenta con un adaptador por plataforma. Todos aceptan la misma entrada y cada uno genera la configuración a partir de plantillas o la traduce y después la entrega. El patrón funciona con el parque de dispositivos que tienes hoy y no exige nada a tus fabricantes. Su límite lo marca la amplitud del catálogo, no el número de dispositivos: cada nuevo fabricante, versión del sistema operativo o interfaz obliga a escribir o actualizar código.
- Adopta un modelo de datos común allí donde hayas comprobado mediante pruebas que el fabricante implementa las rutas que necesitas. Así reduces el trabajo de generación a partir de plantillas de cada adaptador, sin prescindir de los adaptadores.
- Unifica el sistema operativo solo donde aún puedas elegir la plataforma. En la mayoría de las organizaciones, eso solo ocurre cuando se construyen nuevos centros de datos.
La primera estrategia no necesita más explicación aquí. Las dos secciones siguientes tratan las otras dos estrategias y la última explica qué ocurre con las tres durante una migración de firmware.
Modelos YANG impulsados por la comunidad y la industria#
El Patrón Adaptador absorbe la heterogeneidad mediante código específico para cada fabricante. Un modelo de datos común aborda el problema un nivel más arriba. Si todos los fabricantes expusieran el mismo esquema para una misma función, se podría prescindir de la mayor parte de ese código específico: la NAP expresaría la intención una sola vez conforme a un modelo estándar y cabría esperar que funcionara en cualquier dispositivo que cumpliera el estándar.
En ingeniería de redes ya se ha hecho este experimento, y conviene recordar el resultado antes de apostar por él al diseñar una NAP. Las bases de información de gestión (MIB) de SNMP fueron el primer intento de crear un modelo de datos de red común. MIB-II, IF-MIB y BGP4-MIB proporcionaron a todos los fabricantes un vocabulario compartido para la monitorización básica, y las MIB privadas de empresa cubrieron el resto. El resultado se mantuvo en ambos aspectos: las MIB estándar funcionaban para los casos comunes, y todo lo que quedaba fuera de esos casos exigía trabajo específico para cada fabricante.
YANG hereda la misma división. Mejora el modelo, que es jerárquico y tiene un sistema de tipos rico, mientras que las MIB eran una tabla plana de OID. También mejora el transporte, que admite transacciones mediante NETCONF o gNMI, mientras que SNMP recurría al sondeo. Lo que no cambia es el coste relativo. Los estándares cubren los casos comunes. Para acceder al conjunto completo de funciones, las extensiones de los fabricantes siguen siendo inevitables.
En las redes de producción conviven tres familias de modelos YANG. Las diferencias entre ellas determinan cuál utiliza la NAP:
- Los modelos del IETF se desarrollan mediante el proceso de normalización del IETF y se publican como RFC o Internet-Drafts. Constituyen los estándares de base:
ietf-interfaces,ietf-routing,ietf-bgp. Su adopción es amplia pero lenta, y el proceso es riguroso pero lleva años. Los fabricantes suelen tardar entre dos y cuatro años desde la publicación en ofrecer sus implementaciones, y solo lo hacen en las plataformas más recientes. - Los modelos de OpenConfig los desarrolla el consorcio OpenConfig, un grupo impulsado por operadores del que forman parte Google, AT&T y Deutsche Telekom. OpenConfig revisa sus modelos con más rapidez que el IETF y presta más atención a las necesidades operativas. Cubre muchas de las mismas áreas funcionales, pero adopta decisiones distintas al diseñar los esquemas. La mayoría de los despliegues de gNMI en producción utilizan rutas de OpenConfig.
- Los modelos nativos de los fabricantes son las extensiones propias de cada fabricante:
Cisco-IOS-XE-native,junos-conf-root,arista-intf-augments. Exponen funciones que los modelos estándar no cubren y que suelen requerir un modelo nativo en cuanto se sale del conjunto de funciones comunes. Nokia SR OS sirve para poner a prueba tus suposiciones: sus modelos nativos (nokia-conf,nokia-state) ofrecen la interfaz completa, los modelos estándar solo cubren una parte y los equipos que lo automatizan en profundidad suelen acabar utilizando los modelos nativos. Tómalo como regla general y no como excepción. En cualquier plataforma, la pregunta no es si admite OpenConfig, sino cuáles de las rutas que realmente necesitas admite. La única forma de averiguarlo es consultar el dispositivo.
Estas tres familias son el equivalente en YANG de la división entre las MIB, con una capa intermedia adicional. Los modelos del IETF equivalen a las MIB estándar, los modelos nativos de los fabricantes equivalen a las MIB privadas de empresa y OpenConfig aporta la capa que SNMP nunca tuvo: un estándar redactado por los operadores que tendrán que aplicarlo en sus redes, en lugar de ser fruto únicamente de un proceso de normalización. En una red heterogénea hay que manejar las tres familias a la vez.
Así es un módulo YANG que define una interfaz (versión simplificada de ietf-interfaces):
module ietf-interfaces {
  container interfaces {
    list interface {
      key "name";
      leaf name      { type string; }
      leaf description { type string; }
      leaf enabled   { type boolean; default true; }
    }
  }
}La misma estructura aparece en OpenConfig (openconfig-interfaces) y en los modelos nativos de los fabricantes, pero cambian las rutas, los nombres de los nodos hoja y la semántica de los valores predeterminados. El módulo YANG define el esquema. El adaptador del Ejecutor establece la correspondencia entre el estándar y la implementación real del fabricante y envía el resultado al dispositivo mediante el protocolo correspondiente (NETCONF o gNMI).
En la práctica, el grado de implementación de OpenConfig varía de un fabricante a otro. Un dispositivo puede anunciar que admite OpenConfig y, sin embargo, implementar solo una parte del modelo: puede que funcionen las lecturas pero no las escrituras, o que funcione el modelo de interfaces pero falte el de BGP.
Además de las rutas que faltan, hay un problema más difícil de detectar: la incoherencia de los datos. Un dispositivo devuelve un valor para una ruta de OpenConfig, pero lo expresa en una unidad incorrecta, utiliza un tipo distinto o rellena con valores predeterminados del fabricante campos que deberían ser nulos. En un mismo dispositivo, una suscripción gNMI que funciona en modo SAMPLE puede fallar sin dar ningún aviso en modo ON_CHANGE.
Estas situaciones son el día a día de quienes operan en producción una NAP que utiliza OpenConfig con dispositivos de varios fabricantes (no son casos excepcionales). El estándar funciona sobre el papel, pero la implementación del fabricante exige la misma investigación dispositivo por dispositivo que el estándar debía evitar. OpenConfig reduce ese trabajo considerablemente, pero no lo elimina. Prevé pruebas específicas para cada dispositivo antes de utilizar una nueva ruta de OpenConfig en la automatización en producción.
Los productos de traducción YANG como Cisco NSO llevan esta idea hasta sus últimas consecuencias: el equipo escribe los datos conforme a un único modelo y los controladores del producto se encargan de las particularidades de cada fabricante. El capítulo 6 sitúa a NSO en el reparto de responsabilidades.
La abstracción aporta uniformidad a costa del acceso a determinadas funciones. Todos los fabricantes tienen funciones propietarias sin equivalente en los modelos estándar. Un equipo que utiliza OpenConfig debe elegir entre prescindir de la función, añadir una extensión del fabricante o mantener una vía alternativa específica de ese fabricante que prevalezca sobre la común. No hay una solución sencilla. La mayor parte del trabajo de automatización se concentra en funciones bien cubiertas por los modelos estándar (VLAN, BGP e interfaces). Las funciones propietarias son importantes, pero rara vez constituyen el caso de uso principal. Condiciona el uso de cada función a la versión del sistema operativo que indique el dispositivo y contrástala con la que figura en la SoT. Nunca des por sentado que todos los dispositivos admiten las mismas funciones.
SONiC y las redes abiertas#
Las dos estrategias anteriores absorben la heterogeneidad mediante adaptadores por plataforma que se ocupan de las particularidades de cada fabricante y modelos comunes que reducen el trabajo de traducción pendiente. Las redes abiertas abordan otra parte del problema. Si el mismo sistema operativo de red se ejecuta en hardware de varios fabricantes, desaparece la dimensión del fabricante: una sola interfaz de configuración, un solo modelo de datos y un solo adaptador, sean cuales sean los chips subyacentes. Unificar el sistema operativo de las distintas plataformas es la única estrategia de esta sección que elimina una dimensión de la heterogeneidad en lugar de absorberla. La limitación es que solo puedes aplicarla allí donde aún puedas elegir la plataforma.
La interfaz de configuración de SONiC es una base de datos Redis con un esquema estructurado según YANG. La interfaz es uniforme, permite el acceso programático y se diseñó desde el principio para la automatización. Aquí no hace falta el trabajo de desarrollar adaptadores específicos para cada fabricante que tanto esfuerzo exige en entornos físicos con equipos de varios fabricantes. La misma lógica de automatización funciona en todas las plataformas basadas en SONiC, sea cual sea el fabricante del hardware subyacente.
Así es una entrada de VLAN en la base de datos CONFIG_DB de SONiC:
{
  "VLAN": {
    "Vlan412": {
      "vlanid": "412"
    }
  },
  "VLAN_MEMBER": {
    "Vlan412|Ethernet0": {
      "tagging_mode": "untagged"
    }
  }
}Este JSON se carga en CONFIG_DB con config load o se escribe mediante la API REST de gestión de SONiC. No hay que analizar la salida de una CLI ni construir XML. La NAP escribe datos estructurados y orchagent de SONiC los concilia con las tablas de reenvío del hardware.
Este es el enfoque de diseño que promueven las redes abiertas: una interfaz de red concebida para la automatización en lugar de adaptada a ella a posteriori. Los equipos que incorporen plataformas basadas en SONiC junto a equipos de red tradicionales comprobarán que el adaptador de SONiC es el más sencillo de escribir y el más fiable en operación.
SONiC se ha extendido mucho más allá de sus orígenes en Microsoft Azure y la lista de fabricantes es mucho más larga. SONiC es ahora un proyecto de la Linux Foundation. Microsoft sigue siendo su principal contribuyente y otros fabricantes, como Arista, Dell, Cisco y NVIDIA, ejecutan SONiC en algunas de sus plataformas. Junto a ellos, fabricantes de diseño original (ODM) como Edgecore, Celestica y UfiSpace comercializan plataformas SONiC con marca propia. Hoy se pueden adquirir plataformas basadas en SONiC en la mayoría de las gamas de precio y rendimiento. Gracias a esa oferta, la estrategia de utilizar un único sistema operativo de red no se reduce a una forma más complicada de depender de un solo proveedor.
El caso de uso más consolidado es la red leaf-spine del centro de datos. Los operadores de centros de datos a hiperescala llevan alrededor de una década utilizando SONiC a gran escala, y los centros de datos empresariales empiezan a seguir sus pasos. Por eso, tanto las redes superpuestas EVPN/VXLAN como el enrutamiento BGP, el reparto de carga con ECMP y la compatibilidad con interfaces de 400G y 800G están ampliamente probados. El punto fuerte es la automatización: gNMI, YANG y CONFIG_DB, que utiliza Redis, son interfaces nativas desde el principio. Así, puedes gestionar un parque de dispositivos SONiC con las mismas herramientas que utilizas para cualquier otra plataforma compatible con gNMI.
Fuera de las redes de centro de datos, SONiC aún empieza a abrirse paso. Las plataformas de enrutamiento desagregadas, en las que SONiC se ejecuta en rúteres con un gran número de puertos, extienden el modelo de sistema operativo de red (NOS) abierto al enrutamiento. El proyecto principal de SONiC ya admite SRv6, la tecnología que utilizan los proveedores de servicios para la ingeniería de tráfico y la creación de segmentos lógicos de red (network slicing). Los despliegues en redes de campus siguen siendo poco frecuentes. La limitación está en el hardware, más que en el software: hay menos oferta de equipos en los formatos que se utilizan en los campus.
Para los equipos que hoy construyen nuevas redes de centro de datos, la cuestión de si SONiC está listo para producción ya está resuelta: sí lo está. Lo que queda por saber es si la variante de SONiC de cada fabricante y su ritmo de publicación de versiones seguirán alineados con el proyecto principal durante todo el ciclo de vida de la red. Si una variante se aparta de él, vuelves a necesitar el adaptador específico del fabricante que querías evitar al adoptar SONiC.
Gestión de la coexistencia de versiones durante la migración de firmware#
El Patrón Adaptador presupone que cada dispositivo ejecuta una versión conocida y estable del sistema operativo. Durante una actualización gradual del firmware, esa premisa deja de cumplirse: durante días o semanas, dispositivos que desempeñan la misma función y que gestiona la misma NAP ejecutan versiones distintas del sistema operativo al mismo tiempo. La capa de abstracción que ayer funcionaba con el firmware 10.12 puede que no funcione con el 10.13 hasta que se añada una nueva vía de ejecución en el adaptador.
La SoT registra el estado previsto de cada atributo sobre el que actúa la NAP, y la versión del sistema operativo es uno de ellos. La versión prevista es la que ha aprobado el equipo de operaciones. La versión en ejecución es la que comunica el dispositivo. Hasta aquí, la versión se trata como cualquier otro atributo.
Es la misma comparación entre intención y realidad que se aplica a las VLAN, los vecinos BGP y las descripciones de interfaces previstos. Lo que distingue a la versión del sistema operativo es la consecuencia de una discrepancia. Para la mayoría de los atributos, la discrepancia es una desviación que hay que conciliar. En el caso del sistema operativo, la versión también determina qué vía de ejecución sigue el adaptador, porque el firmware de un mismo fabricante se comporta de forma distinta según la versión. Por eso, antes de aplicar la configuración, el Ejecutor hace una comprobación ligera: lee del propio dispositivo la versión del sistema operativo en ejecución, porque el dispositivo es la fuente fiable de ese dato, y selecciona el adaptador correspondiente. Nunca da por hecho que la versión prevista ya esté desplegada.
La distinción tiene consecuencias prácticas. La SoT indica que un conmutador del fabricante C debería ejecutar la versión 10.13. El dispositivo comunica que ejecuta la 10.12.1006. Salvo que ese conmutador forme parte de una actualización planificada, la NAP no da por buena ninguna de las dos versiones. Se detiene y pregunta.
Lo que hace con la respuesta depende de la tarea. Si la tarea es la propia actualización del firmware o si la SoT indica que el dispositivo está en plena migración, la discrepancia es esperable: el Ejecutor selecciona el adaptador de la versión en ejecución y continúa. En cualquier otro caso, la discrepancia es una desviación y el Ejecutor se detiene. Comunica ambas versiones, las registra para el plan de actualización y los informes de desviaciones, y espera a que una persona decida. Si aplicas una configuración a un dispositivo que ejecuta una versión inesperada, el cambio puede toparse con comportamientos que nadie ha probado, desde códigos de error o valores predeterminados distintos hasta la ausencia de una función.
Una vez actualizado el dispositivo, cuando la versión en ejecución coincide con la prevista, la selección del adaptador se estabiliza. Durante una ventana de migración planificada pueden estar activas a la vez dos vías de ejecución del adaptador para un mismo fabricante.
El Ejemplo de implementación que aparece más adelante muestra este tipo de problema de principio a fin. Cualquier NAP que gestione un parque de dispositivos con varias versiones se encontrará con él. La forma sistemática de mitigarlo es utilizar una lógica de adaptación específica para cada versión y seleccionarla según la versión que se lea del dispositivo en el momento de la ejecución.
El panorama de soluciones solo abarca una de las tres funcionalidades de este capítulo. Las interfaces vienen dadas por la red, y los capítulos 4 y 6 ya cubren las herramientas en las que se apoyan las estrategias de abstracción. Lo que instalas es el entorno de simulación.
Panorama de soluciones#
En este apartado se presentan las herramientas de orquestación de laboratorios que construyen el entorno de simulación. A partir de una descripción de la topología, arrancan las imágenes de los sistemas operativos de red, establecen los enlaces virtuales entre ellas y desmontan todo el entorno cuando termina la prueba. Con este enfoque puedes crear el laboratorio y descartarlo después de usarlo, lo que permite utilizarlo tanto en una cadena de despliegue como en la formación de ingenieros de redes. Todos los bloques de la NAP pueden operar sobre él.
Las herramientas que se enumeran aquí sirven de ejemplo para explicar los distintos enfoques y no constituyen recomendaciones. Cada una da un peso distinto a la fidelidad, la velocidad y la facilidad de automatización. Evalúalas en función de las capacidades de tu equipo, las herramientas que ya utiliza y los entornos que realmente necesitas reproducir.
Tres preguntas permiten distinguir unas herramientas de laboratorio de otras. ¿Ejecuta la herramienta imágenes de contenedores o máquinas virtuales completas? ¿Ofrece una API que pueda invocar una cadena de despliegue o una interfaz gráfica que maneja un ingeniero? Y ¿describe la topología en términos de cableado, indicando qué nodo se conecta a qué puerto, o en términos de servicios, indicando qué nodos ejecutan BGP?
Herramientas basadas en contenedores y listas para una cadena de despliegue
- containerlab: a partir de un archivo declarativo de topología, ejecuta contenedores de sistemas operativos de red (Arista cEOS, FRR, SONiC, VyOS y otros) y los conecta mediante enlaces virtuales. Es el estándar de facto para los laboratorios de contenedores. Una topología arranca en segundos, lo que convierte a containerlab en el punto de validación habitual en CI/CD.
- clabernetes: distribuye containerlab por un clúster de Kubernetes en lugar de ejecutarlo en una sola máquina, de modo que las simulaciones se ejecutan en paralelo sin esperar en una cola. Para equipos en los que el único servidor de laboratorio se ha convertido en un cuello de botella.
- netlab: describe lo que debe hacer la topología («estos tres nodos ejecutan BGP», «estos nodos comparten una VLAN») y genera tanto el archivo de containerlab como la configuración inicial de cada fabricante. Para laboratorios que reproducen un modelo de red de producción sin tener que conectar cada enlace a mano.
- vrnetlab: empaqueta como contenedores las imágenes de máquinas virtuales de los fabricantes. Así se incorpora un nodo IOS-XR o Junos a una topología de containerlab. Para fabricantes que no publican imágenes de contenedor.
Herramientas basadas en máquinas virtuales y orientadas al uso gráfico
- EVE-NG y GNS3: ofrecen emulación con máquinas virtuales completas, admiten equipos de numerosos fabricantes, reproducen todo el comportamiento del NOS, incluido el plano de datos, y permiten diseñar la topología desde una interfaz gráfica. Sirven para probar protocolos y diseños, trabajar con plataformas heredadas y comprobar la interoperabilidad entre fabricantes. El coste se aprecia en el consumo de recursos, el tiempo de arranque y la integración limitada con las cadenas de despliegue.
Herramientas basadas en modelos, sin emulación
- Batfish: herramienta de código abierto para el análisis de configuraciones. Lee las configuraciones generadas a partir de plantillas y responde a preguntas sobre alcanzabilidad, enrutamiento y ACL sin arrancar ningún dispositivo. Esto permite realizar una comprobación de bajo coste antes de ejecutar la prueba en el laboratorio, sin sustituirla.
Herramientas comerciales
- Cisco Modeling Labs: laboratorio gestionado y compartido de máquinas virtuales que ofrece una API REST allí donde EVE-NG y GNS3 se quedan en la interfaz gráfica. Para entornos centrados en Cisco que necesitan máquinas virtuales de IOS-XE, IOS-XR y NX-OS.
Hay una pregunta común a todas estas herramientas: ¿puede una cadena de despliegue poner en marcha la topología sin intervención humana? Con containerlab, clabernetes, netlab y vrnetlab sí se puede. Por eso son las herramientas que acaban utilizándose en CI/CD. EVE-NG y GNS3 se manejan principalmente desde la interfaz gráfica y encajan en el flujo de trabajo de diseño. Cisco Modeling Labs queda a medio camino entre ambos grupos. Si un equipo quiere que la validación se ejecute por sí sola con cada cambio en la automatización y con cada solicitud cuya definición así lo exija, necesita al menos una herramienta del primer grupo, independientemente de qué otras utilice junto a ella.
La segunda cuestión, si se describe el cableado o el servicio, se entiende mejor con código. Una topología de containerlab indica qué nodo se conecta a qué puerto. En este caso son dos conmutadores con imágenes de dos fabricantes distintos, sin relación con las plataformas del campus:
name: two-switch-lab
topology:
  nodes:
    s1:
      kind: cisco_cat9kv                      # VM-backed: no vendor container
      image: vrnetlab/cisco_cat9kv:17.9.4
    s2:
      kind: arista_ceos                       # native container image
      image: ceos:4.31.2F
  links:
- endpoints: ["s1:eth1", "s2:eth1"]En netlab, un escenario similar de dos nodos describe la finalidad de la topología. A partir de esa descripción, netlab genera el cableado y la configuración inicial de cada fabricante sobre una solución de virtualización como containerlab:
nodes:
  s1:
    device: iosvl2
    module: [ vlan ]
  s2:
    device: eos
    module: [ vlan ]

links:
  - s1:
    s2:

vlans:
  app-payments:
    id: 412
links: [ s1-s2 ]Como orientación inicial, a la mayoría de los equipos les basta con containerlab, porque desde esta herramienta pueden acceder a todas las imágenes que necesitan, incluidas las máquinas virtuales de los fabricantes una vez empaquetadas con vrnetlab. Añade netlab cuando escribir a mano los archivos de topología deje de ser un mero preparativo y se convierta en el grueso del trabajo. Añade clabernetes cuando ya no baste con un solo servidor.
Las herramientas cambian más deprisa que el problema que pretenden sortear. La forma más sencilla de verlo es seguir una ejecución de principio a fin.
Ejemplo de implementación#
Hemos seguido la misma red de campus a lo largo de toda la parte 2 y, en cada capítulo, hemos dado por hecho que el dispositivo del otro extremo se comportaría como indica su documentación. Aquí ponemos a prueba esa premisa antes de que un posible error tenga consecuencias en producción.
Escenario: El flujo de trabajo de VLAN del campus está listo tras ocho semanas de desarrollo, con tres fabricantes modelados y la idempotencia probada en un laboratorio de tres nodos. El equipo quiere desplegarlo en 800 conmutadores repartidos por los edificios del A al F. Antes de ese despliegue, el flujo de trabajo se ejecuta en una simulación del edificio B: 24 conmutadores, 8 de cada fabricante, cada uno con una imagen fijada a la versión del sistema operativo que la SoT registra para ese dispositivo.
Requisitos:
- Construir la topología de simulación a partir de la Fuente de Verdad, sin definirla a mano
- Fijar cada imagen a la versión del sistema operativo que la SoT registra para ese dispositivo
- Ejecutar el mismo código del flujo de trabajo que se utilizará en producción, sin ramas exclusivas de la simulación
- Comprobar el estado observado tras la ejecución en lugar del código de salida del flujo de trabajo
- Detectar un fallo de interfaz específico de un fabricante antes de tocar ningún dispositivo de producción
- Una vez superada la simulación, extender el despliegue a producción por tandas, en lugar de hacerlo en una sola operación
Bloques implicados:
- Fuente de Verdad: contiene el inventario del edificio B, la versión del sistema operativo prevista para cada dispositivo y el estado de las VLAN del que debe partir la simulación
- Orquestación: ejecuta en el entorno de simulación el mismo flujo de trabajo que ejecutará después en producción y aplica acciones de compensación cuando falla un paso
- Ejecución: aplica la configuración mediante el adaptador de cada fabricante, que es donde finalmente se localiza el error
- Observabilidad: proporciona el estado posterior al cambio que se comprueba en cada punto de control
- Presentación: recibe la solicitud y devuelve el resultado, sin que nada de esto le afecte
- La Red:
- Interfaces programables: NETCONF para configurar los 24 nodos, gNMI o SNMP para la telemetría según la plataforma y la semántica de errores propia de cada fabricante que subyace a estas interfaces
- Entornos de simulación y pruebas: netlab sobre containerlab, con los nodos del fabricante C fijados a la rama de firmware de producción
- Estrategias de abstracción: un registro de adaptadores que selecciona el adaptador según el fabricante y la versión del sistema operativo
A diferencia de lo que ocurre en casi toda la parte 2, este ejemplo menciona herramientas concretas. Lo que se quiere mostrar es que la fidelidad de las imágenes determina el resultado, y eso no se puede ilustrar con un diagrama de bloques genéricos. Cualquier herramienta equivalente de la sección Panorama de soluciones cumple la misma función. Las plataformas de los dispositivos conservan sus denominaciones genéricas, como en toda la parte 2: fabricante A, fabricante B y fabricante C. Lo importante es que son tres y que una de ellas se comporta de forma distinta a lo que indica su propia documentación.
Secuencia de implementación#
La ejecución consta de seis pasos y solo el último afecta a producción. La Figura 10.5 muestra el recorrido, incluido el fallo que obligó a hacer una corrección y repetir la ejecución. La lista que sigue detalla cada paso.
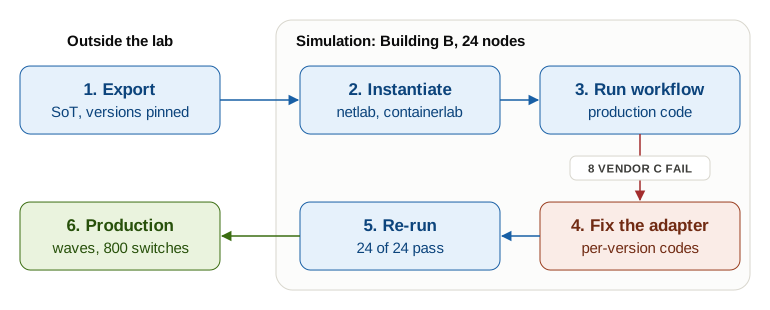
Exporta la topología desde la Fuente de Verdad. La SoT contiene el inventario del edificio B e indica la versión prevista del sistema operativo de cada dispositivo. Hay 8 conmutadores del fabricante A con la versión 8.4.2, 8 del fabricante B con la 5.2.1 y 8 del fabricante C con la 10.12.1006, de una rama de firmware anterior a la 10.13 de ese fabricante. La exportación genera una definición de topología de netlab que incluye los tipos de nodo, las etiquetas de las imágenes de los fabricantes correspondientes a las versiones previstas y el estado inicial de las VLAN en la simulación: las VLAN 409, 410 y 411 ya están configuradas en todos los conmutadores, igual que en producción. Este último detalle hace que 412 sea el identificador adecuado para la prueba, porque en el capítulo 4 se asigna el siguiente identificador libre del intervalo reservado para el edificio.
Crea una instancia del entorno de simulación. netlab genera un archivo de topología de containerlab a partir de los datos exportados. containerlab se ejecuta en un servidor Linux compartido del entorno de CI/CD del equipo. Dimensionar el servidor es la parte menos vistosa. Solo una de las tres plataformas ofrece una imagen de contenedor nativa, que requiere unos 2 GB por nodo. Las otras dos utilizan máquinas virtuales de los fabricantes encapsuladas con vrnetlab, que requieren entre 4 y 6 GB cada una. Con esa combinación, los 24 nodos necesitan unos 110 GB en el momento de máxima demanda, por lo que el laboratorio se ejecuta en un servidor de 128 GB. Un laboratorio de 24 nodos que usara exclusivamente contenedores necesitaría 48 GB. Los nodos del fabricante C ejecutan una imagen fijada a la versión 10.12.1006, la que figura en la SoT, con independencia de la que distribuya hoy el fabricante. En tres minutos, los 24 nodos ya están en marcha y responden por sus interfaces de gestión. El arranque de los nodos que utilizan máquinas virtuales ocupa la mayor parte de ese tiempo.
Ejecuta el flujo de trabajo de producción en el entorno de simulación. El Orquestador inicia el flujo de trabajo del capítulo 8 con el inventario de simulación como destino en lugar del inventario de producción. El resto del flujo de trabajo se mantiene idéntico, condición indispensable para que el resultado tenga valor. Se completan los tres primeros pasos. Se comprueba que los registros de la SoT estén completos y la comprobación previa confirma que la VLAN 412 no existe en ninguno de los 24 nodos. Se supera el control de aprobación conforme a la política propia del entorno de simulación. Es la configuración de esa política, y no una rama del flujo de trabajo, la que designa a la cadena de despliegue como responsable de la aprobación.
En el cuarto paso, el Ejecutor despliega la configuración en paralelo en los 24 conmutadores simulados. Se crea la VLAN 412 en todos los nodos y la ejecución termina con éxito. A continuación, el control de simulación ejecuta por segunda vez el mismo flujo de trabajo. Es la comprobación de idempotencia del capítulo 6: al ejecutar de nuevo la tarea, nada debería cambiar.
Los ocho nodos del fabricante A indican que no ha habido cambios. Los ocho nodos del fabricante B indican que no ha habido cambios. Los ocho nodos del fabricante C fallan, todos con
vlan-exists. La comprobación de idempotencia del adaptador del fabricante C interpretaduplicate-vlancomo una operación que no requiere cambios, pero no contemplavlan-exists, por lo que el Ejecutor comunica un fallo. El fallo de un tercio de los nodos afectados supera con creces el umbral definido para el cambio, así que la ejecución se detiene y no se supera el control. Así se reproduce en el laboratorio la segunda ejecución del relato inicial.No se ha tocado ningún dispositivo de producción. El fallo solo ha costado el tiempo de arranque de los contenedores y treinta minutos de investigación.
Diagnostica el problema y corrígelo. Las notas de la versión 10.12 del fabricante C explican lo ocurrido. La versión 10.11.1 introdujo
vlan-existsen sustitución deduplicate-vlanpara indicar la detección de una VLAN duplicada, y la 10.13 recuperóduplicate-vlanpor coherencia con el resto de la gama del fabricante. La corrección consiste en añadirvlan-existsa la lista de códigos de error que utiliza el adaptador del fabricante C para comprobar la idempotencia, teniendo en cuenta la versión del sistema operativo: las versiones de la 10.11 a la 10.12.x devuelvenvlan-exists, y la 10.13 y posteriores devuelvenduplicate-vlan. El registro de adaptadores ahora selecciona el adaptador según la versión en ejecución.Antes de repetir la ejecución, el equipo incorpora al control de simulación el estado esperado tras el cambio: al término de ambas ejecuciones, la VLAN 412 debe existir en los 24 nodos, la segunda ejecución no debe haber cambiado nada y la compensación de la Saga no debe haberse activado en ningún momento. Es el mismo tipo de comprobación de estado que se realiza en los controles de cada oleada. El control solo se da por superado cuando el flujo de trabajo termina y la comprobación es satisfactoria.
Repite la ejecución en el entorno de simulación. El adaptador corregido se ejecuta sobre la misma topología de containerlab. Las dos ejecuciones se completan con éxito en los 24 nodos: la primera crea la VLAN 412, la segunda no cambia nada, la Saga termina sin necesidad de compensación y la SoT indica que la VLAN 412 está presente en todos los nodos del edificio B.
Extiende el despliegue a producción por oleadas. Superar el control de simulación solo autoriza la primera oleada del despliegue en el parque de dispositivos. El Orquestador ejecuta el mismo flujo de trabajo en los 24 conmutadores del edificio B en producción. El control de la oleada realiza sus cuatro comprobaciones con los datos de la capa de Observabilidad, sin consultar directamente los dispositivos. Se supera el control. A continuación se despliega el cambio en otros dos edificios y, después, en los restantes: 800 conmutadores repartidos entre los edificios del A al F, con cero fallos en los nodos del fabricante C. La solicitud del equipo de aplicaciones se cierra cuando el Orquestador termina y Observabilidad confirma, dentro de la ventana de convergencia, que la VLAN 412 está presente en todas las interfaces previstas.
Resumen de la solución#
No te saltes el control de simulación cuando el equipo se sienta seguro. Este control se ejecuta antes de que comience la Saga en producción. En esta ejecución, el control detectó una particularidad del firmware que pasaba inadvertida en las notas de la versión y ahorró el tiempo que el equipo del relato inicial tuvo que dedicar a averiguar qué conmutadores se habían configurado.
Lo que hizo posible detectar el error fue la fidelidad de la simulación, no el ingenio. La versión del sistema operativo en la simulación coincidía con la de producción porque la SoT registraba la versión que se ejecutaba en producción y la NAP ejecutaba exactamente el mismo código del flujo de trabajo en el entorno simulado. Una topología creada con las imágenes más recientes de los fabricantes habría superado la prueba sin problemas y el error habría salido a la luz a las 02:00 en el parque de dispositivos de producción. La inversión consiste en configurar containerlab, fijar las versiones de las imágenes y disponer de un mecanismo de exportación desde la SoT. A cambio, se detectan errores específicos de los dispositivos cuando aún cuesta poco corregirlos.
Los siete bloques arquitectónicos intervienen en esta ejecución, como han hecho a lo largo de la parte 2. La Red es el único bloque que el equipo no construyó y fue el que determinó el resultado del primer intento.
Una VLAN, una particularidad del firmware y los siete bloques cumpliendo su función. El resumen amplía la perspectiva desde este ejemplo hasta lo que te llevas de este capítulo y de la parte 2 en su conjunto.
Resumen#
La infraestructura de red es lo que da sentido a este marco de automatización. Existen otros marcos de automatización, pero el NAF se centra en las operaciones de red, por lo que este bloque condiciona a los demás.
Lo primero que debes tener en cuenta es la diversidad de las infraestructuras de red: hay distintos entornos (por ejemplo, redes de campus, proveedores de servicios de internet, centros de datos en la nube y servicios en la nube), así como distintas plataformas y fabricantes, cada uno con sus propias características. Una buena solución de automatización de redes debe poder dar cabida a todos ellos, tener en cuenta sus diferencias y las interfaces que ofrecen, y favorecer estrategias de abstracción que puedan reducir la complejidad del Ejecutor.
Además, utilizar la simulación en esta capa en entornos de preproducción permite evaluar una gama más amplia de posibles efectos sobre la infraestructura de producción y refuerza la confianza en los resultados de la automatización. Esto siempre ha sido difícil en el ámbito de las redes por su naturaleza distribuida, pero hay opciones que merece la pena considerar: los laboratorios con plataformas virtuales y el análisis de la configuración.
Con esto concluye la parte 2, dedicada a los siete bloques arquitectónicos del marco NAF. Ninguno funciona de forma aislada. Los contratos entre los bloques delimitan sus responsabilidades y te ofrecen un plan claro para asociar cada bloque con las herramientas que prefieras. La parte 3 pasa del diseño de los bloques a su funcionamiento conjunto como una plataforma de automatización de redes robusta.
Referencias#
- Network Programmability with YANG, Benoit Claise, Joe Clarke y Jan Lindblad (Addison-Wesley, 2019). La obra de referencia sobre modelos YANG, NETCONF y RESTCONF.
- Network Programmability and Automation, 2nd Edition, Matt Oswalt, Christian Adell, Scott S. Lowe y Jason Edelman (O’Reilly, 2023). Uso práctico de herramientas para NETCONF, gNMI y YANG.
- Infrastructure as Code, 2nd Edition, Kief Morris (O’Reilly, 2021). Infraestructura reproducible, verificable mediante pruebas y bajo control de versiones.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo