Presentación#
Seis semanas después de la puesta en producción, la automatización de VLAN funcionaba a la perfección y ¡todo el mundo estaba contento! Cada mañana llegaban tres o cuatro solicitudes de servicio nuevas de los equipos de aplicaciones y el Orquestador las tramitaba automáticamente: los despliegues se completaban con éxito y los switches quedaban configurados. Todo tenía una pinta estupenda.
La queja llegó un jueves. La persona responsable del equipo de aplicaciones preguntaba por qué las solicitudes de VLAN tardaban entre tres y cinco días laborables cuando en el portal ITSM figuraban como «enviadas». El equipo de redes revisó su cola: cero solicitudes pendientes y todos los despliegues completados con éxito. La automatización había procesado cada solicitud en menos de veinte minutos, pero los tickets del sistema ITSM seguían «En curso» porque nadie había desarrollado la integración que debía actualizarlos.
La automatización había hecho su trabajo, pero nadie fuera del equipo de redes podía verlo.
Una semana después, el equipo desplegó un portal de autoservicio para que los equipos de aplicaciones pudieran enviar solicitudes directamente y consultar su estado. A mediodía, el equipo de redes ya había recibido cuarenta y siete solicitudes de VLAN. Todas válidas y con el formato correcto. El problema era que el portal carecía de modelo de autorización y aceptaba solicitudes de cualquiera que tuviera la URL. Todas las solicitudes se ejecutaban con un único token de interfaz de programación de aplicaciones (API) con permisos de escritura. Además, no había límite de frecuencia, ni un paso de aprobación, ni un registro de auditoría que indicara quién había enviado cada solicitud.
La automatización funcionaba. El modelo de acceso fallaba.
Ambos fallos corresponden al bloque de Presentación. En un caso falta un mecanismo para comunicar los resultados y en el otro faltan controles de protección. Este capítulo aborda ambas carencias.
Fundamentos#
Todos los bloques arquitectónicos que hemos visto hasta ahora miran hacia dentro: hacia otros bloques o hacia el personal de ingeniería que conoce la plataforma de automatización de redes (NAP). La Fuente de Verdad (SoT) almacena la intención de red para los sistemas de automatización. El Ejecutor aplica los cambios a los dispositivos. El bloque de Observabilidad valida los resultados. El Orquestador los coordina a todos. Cada bloque puede tener una interfaz de usuario, una API o ambas, diseñadas para quienes lo han construido y lo operan, no para todas las personas que necesitan interactuar con él.
La capa de Presentación mira hacia fuera. Su cometido es poner toda la NAP al alcance de quienes la usan sin que tengan que conocer su funcionamiento interno. Piensa en el equipo de aplicaciones que solicita un servicio de red, en quien realiza una auditoría de seguridad y pregunta qué cambió el trimestre pasado o en la cadena de CI/CD de otro equipo que aprovisiona infraestructura sin intervención humana.
En el capítulo 3, el bloque de Presentación se situaba en el borde del marco NAF, de cara a las personas y a los sistemas externos. En el capítulo 8 vimos que los flujos de trabajo asíncronos requieren puntos de acceso para consultar el estado y mecanismos para recibir notificaciones. La capa de Presentación proporciona ambos.
La capa de Presentación cumple tres objetivos que se corresponden directamente con tres funcionalidades arquitectónicas.
Ofrecer una API estable, con autenticación y un modelo de acceso coherente. Cada consumidor, ya sea una persona o una máquina, debe interactuar con la NAP a través de un contrato con control de versiones y de acceso que no cambie sin previo aviso. Los bloques subyacentes se pueden sustituir, actualizar o reestructurar, pero el contrato que se ofrece a los consumidores debe permanecer estable. La autenticación y la autorización se aplican de forma centralizada en este límite para evitar duplicarlas en cada herramienta.
Ofrecer a cada tipo de consumidor la interfaz que mejor se adapte a su flujo de trabajo. Quien se dedica a la ingeniería de redes y quien dirige un equipo de aplicaciones tienen necesidades distintas, requieren distintos niveles de detalle técnico y esperan que la automatización se comunique con ellos de formas diferentes. La capa de Presentación ofrece varias vías de acceso: portales con interfaz gráfica, interfaz de línea de comandos (CLI) e integraciones de ChatOps. Todas utilizan la misma API y el mismo modelo de acceso y muestran el estado a quien inició la acción.
Conectar la NAP con los sistemas externos en ambos sentidos y comunicar los resultados por los canales que ya utilizan los consumidores. El equipo de aplicaciones ya trabaja en el sistema ITSM. Quien se encarga de la ingeniería ya tiene abierto el canal de chat. La cadena de publicación de versiones de otro equipo ya se ejecuta en la plataforma interna para desarrolladores (IDP). La NAP debe integrarse donde ya trabajan: debe recibir las solicitudes de sus sistemas y devolverles los resultados sin obligar a nadie a incorporar una herramienta nueva a su flujo de trabajo.
Qué queda dentro del alcance
- La capa de API: autenticación, autorización, control de versiones y limitación de la frecuencia de solicitudes para todos los consumidores
- Las interfaces de usuario construidas sobre esa API: portales con interfaz gráfica, CLI, ChatOps e interfaces móviles
- Las integraciones externas: flujos de trabajo de ITSM, plataformas de chat y mensajería y llamadas de retorno mediante webhooks a sistemas que esperan una respuesta, como las cadenas de CI/CD
- Las notificaciones salientes: llamadas de retorno para comunicar el estado, alertas push y eventos en canales de mensajería
- Los paneles operativos que se muestran a personas ajenas al área de ingeniería (control de acceso, delimitación del público e integración en portales; la arquitectura de métricas subyacente se trata en el capítulo 7)
Qué queda fuera del alcance
La capa de Presentación muestra lo que generan los demás bloques. Por sí misma no genera nada.
- Generar los datos que se muestran: las métricas, los registros y el estado operativo corresponden a Observabilidad
- Generar configuraciones a partir de plantillas y procesar las plantillas: de ello se encargan los adaptadores del Ejecutor (capítulo 6)
- Ejecutar los flujos de trabajo y generar sus registros de auditoría: de ello se encarga el Orquestador
- La lógica de negocio: decidir qué flujo de trabajo ejecutar, hacerse cargo de las reglas que determinan si una solicitud es válida y gestionar el estado de los flujos de trabajo son responsabilidades del Orquestador y de la Fuente de Verdad (véase la ADVERTENCIA al final de la sección Panorama de soluciones)
Funcionalidades#
Cada una de las tres funcionalidades cumple uno de los tres objetivos, como muestra la Figura 9.1. Se presentan en el orden en que intervienen al tramitar una solicitud.
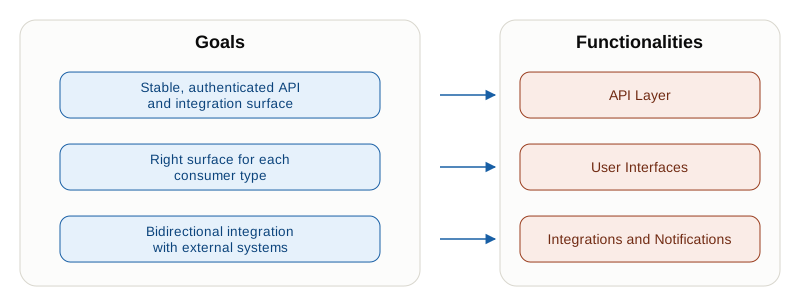
- Capa de API: el contrato y el modelo de acceso que utilizan todos los consumidores. El contrato es estable, tiene control de versiones, requiere autenticación y se hace cumplir mediante Control de acceso basado en roles (RBAC). La autenticación y los controles de acceso multiinquilino se aplican una sola vez, en esta capa, sobre la que se construyen todas las demás interfaces.
- Interfaces de usuario: las interfaces construidas sobre ese contrato. Los portales con interfaz gráfica, la CLI, las interfaces móviles y ChatOps son distintas formas de acceder a una misma API subyacente, no sistemas independientes con reglas propias.
- Integraciones y notificaciones: las conexiones con los sistemas externos y el envío de los resultados a esos sistemas. A la entrada, las solicitudes de los flujos de trabajo de ITSM y de los sistemas de mensajería se convierten en llamadas a la capa de API. A la salida se envían actualizaciones de tickets, mensajes de chat, avisos al personal de guardia y llamadas de retorno mediante webhooks, por ejemplo, a una cadena de CI/CD que espera una respuesta.
Capa de API#
La API de la capa de Presentación es la base. Todas las interfaces que utilizan los consumidores hacen llamadas a esta capa: el portal, la CLI, un formulario de ITSM, un bot de ChatOps o un agente de inteligencia artificial (IA). Aquí se aplican la autenticación, el RBAC, el control de versiones y la limitación de la frecuencia de solicitudes. Diséñala bien o todo lo que construyas sobre ella heredará sus problemas.
En el capítulo 5 vimos la API propia de la SoT: cómo consultan los sistemas de automatización los datos de intención, los patrones de consumo como Representational State Transfer (REST), GraphQL y los webhooks, y el modelo de lectura y escritura de la configuración de red. La API que nos ocupa tiene otra finalidad: es el contrato que se ofrece a quienes consumen la NAP en su conjunto. La API de la SoT responde a «¿Cómo debería estar la red?», mientras que la API de la capa de Presentación responde a «¿Qué está haciendo la NAP y cómo interactúo con ella?». Ambas pueden ser API REST, pero atienden a públicos distintos con modelos de acceso diferentes.
Esta sección se centra en el punto de entrada tal como lo ve el consumidor. A lo que hay detrás se le dedican capítulos propios en la parte 3: el capítulo 13 trata la identidad de los flujos de trabajo, el principio de mínimo privilegio y el aislamiento entre inquilinos, y el capítulo 12 explica cómo soporta la NAP la carga y las interrupciones del servicio. Aquí nos ocupan el contrato que ven los consumidores y los límites que les impone el punto de entrada.
El diseño que conviene adoptar es el patrón Pasarela de API (API Gateway) de la arquitectura de microservicios (Sam Newman, Building Microservices; Chris Richardson, microservices.io): un único punto de entrada para muchos servicios. La pasarela dirige cada llamada al bloque que la atiende, compone las respuestas que requieren varios bloques y resuelve en un solo lugar los aspectos comunes a todas las llamadas, como la autenticación, la limitación de la frecuencia de solicitudes y el control de versiones. Las pasarelas de la sección Panorama de soluciones se encargan del encaminamiento y de esos aspectos comunes. A ti te corresponde diseñar los recursos que ven los consumidores.
La pasarela no debe convertirse en un proxy. La API de Presentación no debe reproducir las interfaces internas de los bloques. Si expones un punto de acceso /v1/sot/vlans/ que reenvía las llamadas directamente a la API de la SoT, o un punto de acceso /v1/orchestrator/jobs/ que encapsula los identificadores de los trabajos del Orquestador, vinculas a los consumidores a detalles internos de implementación. Cuando sustituyas un bloque por otro, tendrás que actualizar cada cadena de CI/CD que haya almacenado esos identificadores.
La API de Presentación debe exponer conceptos propios de la NAP en su conjunto. Un punto de acceso /v1/requests/ representa una solicitud de servicio, sea cual sea el Orquestador que la haya procesado. Un punto de acceso /v1/services/vlan/ devuelve el estado actual de una VLAN combinando datos de la SoT y de Observabilidad, sin revelar qué bloque ha aportado cada dato. Los consumidores disponen así de un contrato estable y la implementación interna puede evolucionar libremente.
Lo mismo ocurre con las vistas específicas de cada consumidor. Un mismo registro de dispositivo le sirve a quien diagnostica un problema en un enlace de red, a quien calcula la amortización en el área financiera y a un flujo de trabajo que solo necesita una dirección de gestión. El capítulo 5 explica cómo construir esas vistas y qué coste tiene cada enfoque. Las vistas de la capa de Presentación se distinguen en dos aspectos: dan servicio a personas y sistemas externos a la NAP en lugar de a sus bloques internos, y a menudo combinan datos de varios bloques en una sola respuesta, como cuando muestran la intención de una VLAN junto con su estado de salud.
La API expone dos categorías de puntos de acceso:
Puntos de acceso de lectura: ofrecen el estado y el historial de los flujos de trabajo, los registros de auditoría y el estado de los servicios obtenido al combinar datos de los bloques de SoT y Observabilidad. Por ejemplo: «VLAN
app-payments: presente en 24 de los 24 switches del edificio B, puerta de enlace accesible, último cambio efectuado mediante la solicitud REQ-4471». El equipo de aplicaciones utiliza estas consultas para comprobar el estado de una solicitud, el personal de auditoría para revisar el registro de un cambio y el sistema de monitorización para verificar el estado de salud de la NAP.Puntos de acceso de escritura: permiten iniciar un flujo de trabajo, enviar una solicitud de servicio, aprobar o rechazar un paso pendiente de aprobación o cancelar un trabajo en curso. Los puntos de acceso de escritura exigen una autorización más estricta. Cada rol debe tener acceso a las operaciones de escritura que le correspondan: un miembro del equipo de aplicaciones puede enviar una solicitud, pero no iniciar cualquier flujo de trabajo. Un ingeniero de redes puede dar el visto bueno en un paso pendiente de aprobación, pero no modificar las definiciones de los flujos de trabajo.
La distinción entre lectura y escritura también influye en la estabilidad del contrato. Ambas necesitan control de versiones, pero sus fallos se manifiestan de forma distinta. El fallo de un punto de acceso de lectura pasa inadvertido en un panel que nadie consulta en un año. El fallo de un punto de acceso de escritura salta a la vista en una cadena de ejecución. Da a los puntos de acceso de lectura un plazo más largo entre el aviso de obsolescencia y la retirada.
Control de versiones y estabilidad#
Las API que se ofrecen a los consumidores deben tener versiones. La API de la capa de Presentación es el contrato y el funcionamiento interno de los bloques es la implementación. Una refactorización interna del Orquestador, la SoT o el bloque de Observabilidad debe preservar el funcionamiento de los clientes externos. El capítulo 11 desarrolla esta idea: la API es donde se concreta el contrato de la NAP con quienes la utilizan.
Indica la versión en el prefijo de la URL (/v1/, /v2/) en vez de usar una cabecera. Si algo falla a las 03:00 y estás buscando en los registros con grep, quieres distinguir /v1/ de /v2/ de un vistazo, sin tener que examinar las cabeceras de las peticiones.
Sin embargo, los cambios incompatibles que causan problemas rara vez están en la URL. Están en lo que significa una solicitud de red. Tomemos el punto de acceso de VLAN del campus. En la versión v1, POST /v1/requests/vlan recibía un vlan_id de quien enviaba la solicitud. Después, la capa de servicio del capítulo 4 empezó a determinar los identificadores de VLAN a partir del rango del edificio, y proporcionar un identificador en la solicitud pasó a ser una forma de eludir el diseño.
La versión v2 elimina ese campo. Durante el plazo previo a la retirada, la versión v1 sigue aceptándolo. Si una llamada a v1 incluye un identificador que no coincide con el que se obtendría según el diseño, se rechaza con un mensaje claro: «La VLAN 500 está fuera del rango reservado para el edificio B. Omite vlan_id». El identificador nunca se sustituye en silencio.
En una API de servicios de red, estos cuatro elementos forman parte del contrato y modificar cualquiera de ellos rompe la compatibilidad:
- Los campos de la solicitud y sus valores:
building,profiley los nombres de los perfiles. Cambiar el nombrestandardpordefaulthace que fallen todos los formularios de ITSM que ofrecen ese perfil. - El vocabulario de los estados: enviada, comprobaciones previas en curso, pendiente de aprobación, completada, completada parcialmente. Una integración con un sistema de tickets asigna a cada estado su equivalente exacto.
- El significado de «completada»: configuración aplicada o servicio validado por Observabilidad. Pasar del primer significado al segundo cambia el momento en que una cadena de publicación puede continuar, incluso si el contenido de la petición es idéntico.
- Los códigos de error: «edificio no encontrado» y «perfil no disponible» son los mensajes que el sistema de ITSM muestra a quien envía la solicitud, así que deben ser tan estables como los campos.
Anuncia los cambios incompatibles con una antelación de entre tres y seis meses mediante las cabeceras Deprecation y Sunset (RFC 9745 y RFC 8594), para que el consumidor se entere de la retirada a través de la propia API. La primera indica la fecha en que el punto de acceso se declaró obsoleto y la segunda, la fecha en que dejará de funcionar:
Deprecation: @1782864000
Sunset: Mon, 01 Jan 2027 00:00:00 GMT
Link: <https://docs/migration>; rel="deprecation"Autenticación y autorización#
La autenticación responde a la pregunta «¿quién eres?». La autorización responde a «¿qué tienes permiso para hacer?».
Muchos equipos implementan primero la autenticación y después la autorización. Descubren que autenticar y autorizar resuelven problemas distintos cuando alguien envía cuarenta y siete solicitudes con un token válido que nunca debería haber tenido.
Patrones de autenticación para plataformas de automatización de redes:
- Integración con SSO / LDAP: el estándar en las empresas. El personal de ingeniería y los equipos de aplicaciones se autentican con su identidad corporativa. No hay que gestionar credenciales aparte y el acceso se revoca automáticamente cuando alguien deja la empresa.
- OAuth 2.0 / OIDC: para sistemas externos y usuarios del portal web. Genera tokens de corta duración en lugar de credenciales de larga duración.
- Tokens de API con alcance limitado: para el acceso programático desde cadenas de CI/CD y scripts de automatización. Cada token tiene un conjunto concreto de permisos y una caducidad definida. Usar un mismo token de administración para todos los consumidores no sirve para autenticarlos: equivale a compartir una contraseña que no se puede revocar sin dejar a todos los clientes sin acceso a la vez.
Implementa la autorización mediante RBAC. Define los roles en función de las responsabilidades operativas de cada persona, en vez de las funciones que ofrece la herramienta. La Figura 9.2 muestra un modelo que suele servir de punto de partida en la automatización de redes. Hay otros modelos válidos: puede que tu organización necesite menos roles o que deba definirlos con mayor precisión.
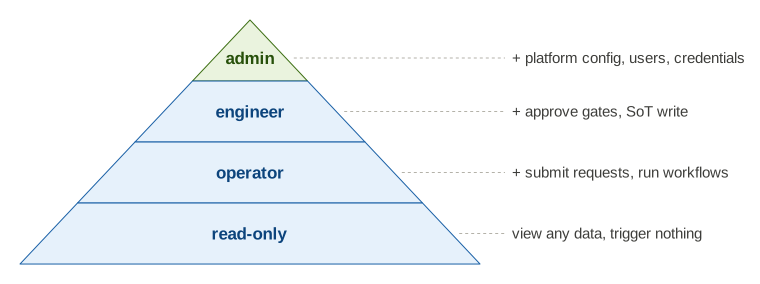
read-only: consultar cualquier dato, sin poder iniciar accionesoperator: enviar solicitudes de servicio e iniciar flujos de trabajo aprobados de antemano (el patrón de automatización preaprobada (Pre-Approved Automation Pattern) del capítulo 15)engineer: dar el visto bueno en los pasos de aprobación, gestionar por completo los flujos de trabajo, escribir en la SoT y consultar todos los registros de auditoríaadmin: configurar la NAP, gestionar usuarios y rotar credenciales
Cada rol hereda todos los permisos del rol inmediatamente inferior. Quien tiene el rol de ingeniería puede hacer todo lo que permite el rol de operación y, además, dar el visto bueno en los pasos de aprobación, escribir en la SoT y gestionar flujos de trabajo. Excluir la aprobación del rol de operación impide que quien solicita un cambio lo apruebe. La regla de separación de funciones del Orquestador (capítulo 8) impide que quien tiene el rol de ingeniería apruebe una solicitud que haya enviado personalmente.
El control de acceso mediante RBAC se aplica en el punto de entrada a la API. Los bloques subyacentes solo reciben llamadas de API autenticadas procedentes de la capa de Presentación y no gestionan por su cuenta la identidad de los consumidores. Esto tiene dos consecuencias que debes tener en cuenta desde el diseño inicial. Cada consulta se limita al ámbito del inquilino que la realiza, de modo que el equipo de aplicaciones del edificio B nunca ve las solicitudes del equipo de instalaciones para el edificio A. El capítulo 13 profundiza en ese aislamiento.
Además, el registro de autorización recoge tanto las solicitudes denegadas como las aprobadas, porque en una auditoría importa tanto saber quién intentó hacer qué y recibió una negativa como saber qué se permitió. El capítulo 13 también amplía el modelo de las personas a los propios flujos de trabajo mediante la identidad de las cargas de trabajo, las políticas basadas en atributos y el principio de mínimo privilegio.
Tipos de API#
REST es la opción predeterminada. Es más sencillo gestionar las versiones, entender el comportamiento y almacenar en caché las respuestas con REST que con GraphQL. Los equipos de automatización de redes rara vez necesitan la flexibilidad que ofrece GraphQL para que el consumidor defina sus consultas, y la complejidad añadida supone un coste operativo considerable. La excepción es una vista que consulta varios bloques en cada petición. Si una pantalla del centro de operaciones de red (NOC) necesita mostrar, para un conmutador, los datos del dispositivo, los servicios que aloja, su circuito de enlace ascendente y cualquier solicitud abierta que le afecte, tiene que hacer cuatro llamadas REST por dispositivo o una sola consulta GraphQL. En ese caso se justifica elegir GraphQL, aunque rara vez es la opción adecuada para empezar.
La interfaz Model Context Protocol (MCP) es el punto de acceso para la IA en la capa de Presentación. El personal de operaciones accede a la NAP a través de una CLI y los equipos de aplicaciones, a través de un portal. Los agentes basados en un Modelo de lenguaje de gran tamaño (LLM) acceden a través de un servidor MCP. Este servidor es la puerta de entrada para agentes que vienen de fuera de la NAP, como el asistente de un ingeniero o el agente de otro equipo. Los agentes que el Orquestador ejecuta dentro de la NAP utilizan las interfaces de herramientas de cada bloque (capítulo 8). El capítulo 18 desarrolla sobre esas interfaces la arquitectura completa de agentes.
Lo que cambia es quién dirige la interacción. Un cliente REST sigue una secuencia fijada en el código: una cadena de CI/CD llama a POST /v1/requests/vlan y después consulta periódicamente GET /v1/requests/{id}. Un agente decide en tiempo de ejecución a qué herramienta llamar a continuación tras leer cada resultado. Esa libertad lo hace útil para responder a preguntas abiertas y explica por qué todo agente que acceda por esta puerta está sujeto a dos reglas:
- Comprueba la autorización por herramienta, no por conexión. Cada herramienta exige un rol concreto que se comprueba en cada llamada. Así, por mucho que un agente encadene cinco herramientas de lectura, sigue sin poder acceder a una operación de escritura para la que nunca recibió permiso.
- No asignes al agente un rol propio permanente. Un agente interactivo actúa con la identidad de la persona que lo invoca, y el registro de auditoría identifica a ambos. Un agente autónomo se ejecuta con una identidad de servicio limitada a herramientas de lectura, y sus operaciones de escritura pasan por el mismo paso de aprobación que las de una persona.
Los cuatro roles anteriores cubren ambos casos. Lo que cambia es quién realiza la llamada. El modelo de acceso es el mismo.
Protección del punto de entrada#
Todos los consumidores acceden a la NAP a través de esta capa, así que es aquí donde debes imponerles límites. El capítulo 12 explica cómo la NAP en su conjunto sigue funcionando bajo carga y ante fallos parciales. Esta sección se centra en los tres aspectos que aporta el punto de entrada.
Limitar la frecuencia de las peticiones protege los bloques que hay detrás del punto de entrada. Si no se limita esa frecuencia, los consumidores automatizados acabarán saturando la cola del Orquestador. Para que se produjera el incidente de las cuarenta y siete solicitudes no hizo falta que nadie actuara con mala intención: bastaron un equipo motivado, una URL y la ausencia de límites. Aplica tres tipos de límites en el punto de entrada a la API:
- Límites por token: número de peticiones por minuto y por consumidor.
- Límites de ráfaga: número de peticiones que pueden estar en curso al mismo tiempo.
- Límites por operación: un flujo de trabajo de actualización de firmware nunca debe ejecutar más de una instancia a la vez en un mismo dispositivo.
Si una petición supera el límite, responde con el código Hypertext Transfer Protocol (HTTP) 429 y una cabecera Retry-After. De lo contrario, la cola se llena sin dar señales y el problema solo se manifiesta horas después, cuando se agota el tiempo de espera.
Mantén la capa sin estado. Al centralizar la autenticación, la disponibilidad de la NAP depende por completo de la de esta capa a ojos de quienes acceden desde fuera. Por eso, no guardes en ella nada que pueda perderse al reiniciarla: el estado de los flujos de trabajo corresponde al Orquestador, que lo almacena de forma persistente, y un flujo de trabajo en curso debe llegar a su fin tanto si alguien puede seguir su progreso como si no. El paso de aprobación es la única excepción, porque espera a una persona que accede por esta puerta. Por eso debes definir expresamente qué ocurre cuando se agota el tiempo de espera.
Que la capa no tenga estado no significa que no almacene nada. Su registro de autorización, las URL de devolución de llamada registradas, las vistas guardadas y las preferencias de notificación ocupan poco espacio, pero también necesitan copias de seguridad. Los eventos pendientes de entrega tampoco forman parte del estado de la capa. Permanecen en el bus de mensajes persistente descrito en el capítulo 12, de modo que tras un reinicio se reanuda la entrega sin perder los eventos.
Prepárate para el día en que falle la puerta de entrada. Proteger la puerta de entrada también implica evitar que todo dependa de ella. Cada bloque conserva su propia interfaz y unas pocas credenciales locales de administración para el día en que esta capa deje de estar disponible. Las custodian personas concretas del equipo de ingeniería y nunca se entregan a quienes usan la NAP. La parte 3 describe la vía de acceso de emergencia que utiliza esas credenciales: el procedimiento en el capítulo 11, el escenario de indisponibilidad de la NAP en el capítulo 12 y la gobernanza de ese acceso en el capítulo 13.
Hay un punto que corresponde a este capítulo porque afecta a las interfaces: procura que la NAP sea más rápida que la vía alternativa para las operaciones más frecuentes del equipo de ingeniería. Si aprobar un cambio a través del portal exige cuatro clics e iniciar sesión y con Secure Shell (SSH) basta un comando, el portal sale perdiendo.
La API determina qué puede solicitar cada consumidor. Las interfaces que se construyen sobre ella determinan cómo lo solicita.
Interfaces de usuario#
Las interfaces de usuario se construyen sobre la API. Ofrecen distintas formas de acceder a una misma NAP, cada una adecuada para un tipo de consumidor. El modelo RBAC se aplica por igual en todas las interfaces.
Cada interfaz que añades es una interfaz que debes mantener al día con las demás. Cuando un flujo de trabajo incorpora un dato de entrada obligatorio, su validación pasa a formar parte del contrato de la API, pero hay que añadir el campo a mano al formulario de ITSM, al portal, a las opciones de la CLI y al comando de chat. De cada cambio suele encargarse una persona distinta. Esta multiplicación del trabajo es la razón práctica de más peso para ofrecer menos interfaces de las que en principio querrías y concentrar todas las reglas en la API.
Interfaz gráfica y portal de autoservicio#
Si decides crear un portal web, será la interfaz más completa para quienes no se dedican a la ingeniería de automatización y la que ofrecerá la pantalla de aprobación. Su diseño se basa en la presentación progresiva de la información: mostrar a cada público el nivel de detalle que necesita sin exponer la complejidad subyacente.
El equipo de aplicaciones ve tres estados de la solicitud: enviada, en curso y completada. El detalle del estado se expresa en lenguaje llano, por ejemplo, «comprobaciones previas en curso en 24 switches», en lugar de mostrar identificadores de tareas del Orquestador. Quien se encarga de la ingeniería de red ve los resultados de las comprobaciones previas de cada dispositivo, el punto de aprobación con las opciones de aprobar o rechazar y, si lo necesita, la traza completa del flujo de trabajo. Quien administra la plataforma lo ve todo, incluidas la configuración y las consultas de auditoría.
La vista de ingeniería determina si el punto de aprobación permite ejercer un control real. Aprobar un cambio en 24 switches a las 02:00 debería llevar menos de un minuto. Eso solo es posible si la pantalla responde a cuatro preguntas sin obligar a quien aprueba el cambio a buscar la respuesta a una quinta:
- ¿Qué cambia exactamente? La configuración generada a partir de plantillas para un dispositivo representativo de cada plataforma, en lugar de un identificador de tarea o de las 24 comparaciones de configuración.
- ¿Qué han revelado las comprobaciones previas? El resultado de cada dispositivo: comprobación superada, fallida u omitida. Los fallos aparecen primero, cada uno con su motivo. Las 21 comprobaciones superadas son lo de menos.
- ¿Qué ha cambiado desde la última ejecución? Un cambio parecido a los cuarenta anteriores se aprueba enseguida. Si afecta a dispositivos con una función nueva o a una plataforma con la que el flujo de trabajo nunca ha operado, merece la pena dedicarle esos treinta segundos más. La pantalla es lo que permite ver esa diferencia.
- ¿Qué ocurre si no se hace nada? La pantalla indica cuándo vence el plazo y qué acción se ha configurado para entonces: continuar, abortar o escalar la solicitud (el capítulo 8 establece las reglas).
Todo lo demás debe quedar a un clic de distancia. Una pantalla de aprobación que de entrada muestra un identificador de flujo de trabajo y un enlace al Orquestador vuelve a cargar sobre quien debe aprobar el cambio el trabajo que el punto de aprobación debía ahorrarle.
Las interfaces de lectura y las de escritura tienen requisitos de diseño distintos. Un panel de estado de solo lectura puede ser relativamente permisivo: cualquier persona del equipo de ingeniería que utilice la NAP puede ver el estado actual de sus solicitudes. La vía de escritura (enviar una solicitud, dar el visto bueno en un punto de aprobación o cancelar una tarea en curso) requiere validar los datos de entrada, pedir confirmación e indicar con claridad qué sucederá antes de hacer efectiva la acción.
He visto equipos crear portales en los que el botón de envío del formulario de solicitud de un nuevo servicio llama directamente a la API del Orquestador, sin ninguna capa de validación entre el formulario y el flujo de trabajo. Esto supone un problema: cuando alguien introduce una subred que entra en conflicto con una asignación existente, recibe como mensaje de error una traza de pila del Orquestador sin formato, molesta para quien la recibe y sin indicación clara de cómo proceder.
Cuesta encontrar el equilibrio entre ofrecer la funcionalidad necesaria y mantener ligera la capa: comprobar un dato de entrada no es lógica de negocio, pero hacerse cargo de las reglas sí lo es. Siempre que sea posible, la capa de Presentación debe pedir a la SoT que valide los datos antes de que la solicitud llegue al Orquestador y, si hay un error, convertir la respuesta de la SoT en un mensaje claro que indique cómo corregirlo. Así, cada bloque resuelve los problemas que le corresponden sin que se propaguen a los demás.
La adopción se puede medir y conviene hacerlo. De lo contrario, afirmar que «el portal funciona» sigue siendo una cuestión de opinión. El capítulo 11 mide la adopción de la NAP en su conjunto y el capítulo 15 trata cada servicio de red como un producto cuya interfaz es esta capa. Hay tres indicadores específicos de las interfaces:
- Proporción de solicitudes por interfaz. Cuántas llegan a través del portal, del sistema ITSM, de la API y de la CLI. Si al cabo de seis meses solo el 5 % de las solicitudes pasa por el portal, ya tienes respuesta a la pregunta de si conviene crear un portal o integrar la NAP con una herramienta existente.
- Tiempo hasta el primer cambio de estado. Cuánto tiempo pasa desde el envío hasta que quien ha hecho la solicitud ve un estado distinto de «enviada». Este es el dato que faltaba en la historia inicial: la automatización fue rápida y la información sobre su progreso nunca llegó.
- Dónde se producen los rechazos. Detectar un error de validación en el formulario cuesta poco. Si un flujo de trabajo falla por un dato que el formulario debería haber detectado como erróneo, el defecto está en el formulario. La proporción entre ambos casos te indica si la validación se hace en el lugar adecuado.
Esas cifras suelen apuntar en la misma dirección. Un portal que no encaja en la forma de trabajar de un equipo pierde terreno frente a una integración más sencilla en la herramienta que todo el mundo abre cada mañana. Un equipo de aplicaciones envía sus solicitudes de forma más sistemática si puede hacerlo desde el sistema ITSM que ya utiliza a diario. Quien debe aprobar un cambio responde antes si la solicitud de aprobación llega al canal de chat que ya tiene abierto durante un incidente. Cuando puedes elegir entre crear una interfaz y ofrecer la funcionalidad en la herramienta que ya conoce la gente, la integración es casi siempre el primer paso más acertado.
Interfaz de línea de comandos#
La CLI de la NAP es distinta de la CLI de los dispositivos, de la que se ocupa el capítulo 10. Es la interfaz de línea de comandos de la propia NAP: una herramienta que el equipo de ingeniería utiliza para iniciar, inspeccionar y gestionar la automatización sin abrir un navegador.
El equipo de ingeniería prefiere la CLI por las mismas razones por las que prefiere los scripts de shell a las interfaces gráficas para las tareas repetitivas: la facilidad para combinar comandos, la rapidez y la posibilidad de utilizarlos en scripts. Puedes asignar un alias a un comando de la CLI, pasar su salida a otros comandos mediante una tubería, ejecutarlo en un bucle sobre una lista de dispositivos, incorporarlo a un procedimiento operativo o guardarlo bajo control de versiones en un repositorio junto a la infraestructura que gestiona. Con un clic en el portal no puedes hacer nada de eso.
Durante un incidente a las 02:00, teclear un comando de memoria en cinco segundos es más rápido que dedicar veinte segundos a navegar por un portal y autenticarse. El equipo de ingeniería también confía más en las herramientas de CLI para las operaciones críticas: los parámetros quedan a la vista en el historial de la shell, se pueden auditar y se pueden reproducir.
En las cadenas de CI/CD, una CLI devuelve códigos de salida estructurados (0 indica éxito y cualquier otro valor indica fallo) que se corresponden directamente con las condiciones de éxito o fallo de la cadena, sin necesidad de analizar la salida. A menudo, esas cadenas pertenecen a otros equipos y se ejecutan en la IDP (capítulo 11). Por ejemplo, si una aplicación necesita una VLAN antes del despliegue de una versión, su cadena ejecuta netauto workflow run vlan-deploy --params params.json --wait con una cuenta de servicio cuyos permisos se limitan a ese flujo de trabajo. El cambio de red se sigue ejecutando como un flujo de trabajo de cambio en el Orquestador. La cadena se limita a solicitarlo y esperar.
Principios de diseño de una CLI para la NAP:
- Comandos con una estructura uniforme de sustantivo y verbo (
workflow run,workflow status,request list) que se corresponda de forma predecible con las operaciones de la API - Salida legible por máquinas mediante la opción
--json, para que los scripts de la cadena puedan analizar el resultado - Configuración adaptada al entorno: la dirección de acceso a la API y el token se leen de un archivo de configuración o de variables de entorno, en lugar de fijarse en el código de los scripts
- El mismo modelo RBAC para la API y la CLI: un token con permisos de operación no puede iniciar operaciones que requieran permisos de administración, sea cual sea la interfaz utilizada
Antes hay que preguntarse si merece la pena crear una CLI, y la respuesta suele ser «todavía no». Merece la pena crear una CLI para la NAP cuando el equipo de ingeniería ya escribe scripts que utilizan la API y cada integrante ha creado su propia herramienta para invocarla. A esas alturas ya mantienes varias CLI de uso particular, sin una gestión común de los tokens ni control de versiones. Hasta entonces, una API documentada y la propia CLI del Orquestador cubren las mismas necesidades. Fíjate en la duplicación: cuando una tercera persona escribe la misma función auxiliar de autenticación, la CLI ya ha justificado su coste.
Mensajería instantánea y dispositivos móviles#
Slack, Teams y otras plataformas similares desempeñan dos funciones en la automatización de redes: sirven de canal de notificaciones (la capa de Presentación les envía eventos) y de interfaz de interacción (el equipo de ingeniería envía comandos a través de ellas). Tener en cuenta esta doble función influye en la arquitectura: el mismo espacio de trabajo que recibe las notificaciones de alerta debería admitir flujos de aprobación. Así, quienes ya supervisan esos canales tienen que cambiar de contexto menos veces.
La Figura 9.3 muestra una aprobación de principio a fin, con la llamada a la API correspondiente a cada paso.
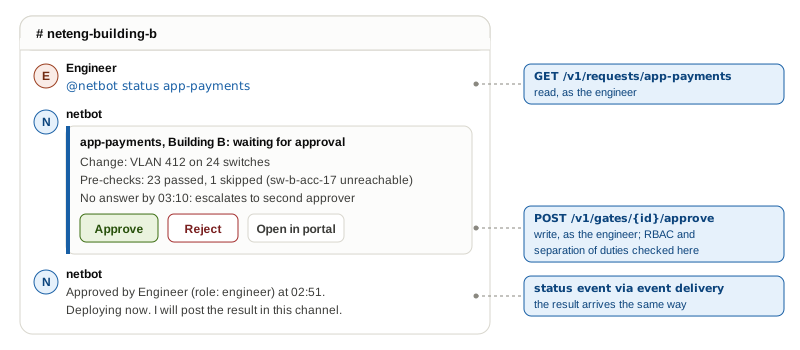
Como interfaz de interacción, las plataformas de mensajería utilizan bots que traducen órdenes conversacionales en llamadas a la API. El bot apenas tiene lógica propia: analiza el mensaje, lo convierte en una llamada a la API de la capa de Presentación con la identidad de quien lo envía y da a la respuesta el formato adecuado para el canal. Así funcionan las aprobaciones, las consultas de estado y las acciones rápidas como @netbot compliance-check B. Se aplica el mismo modelo RBAC: el bot autentica al personal de ingeniería mediante SSO y reenvía cada solicitud con un token cuyos permisos se limitan al rol de quien la envía. Así, quien tenga acceso de solo lectura no podrá iniciar un flujo de trabajo ni por chat ni desde el portal.
Esta interfaz existe desde hace varios años, pero la llegada de los LLM la ha revolucionado por completo: lo que antes exigía una sintaxis fijada en el código y difícil de usar se ha convertido en una interacción en lenguaje natural parecida a una conversación entre personas. De hecho, ChatOps es una interfaz cada vez más habitual a medida que los usuarios adoptan asistentes de IA (como ChatGPT) y los conectan a herramientas basadas en agentes en lugar de recurrir a las órdenes preconfiguradas de los primeros bots. La idea es la misma, pero el impacto y el alcance crecen de forma exponencial.
La interfaz móvil llega a quienes el portal no alcanza: por ejemplo, a una persona del equipo técnico que, frente a un bastidor y con las manos ocupadas, escanea el código de barras de un dispositivo para consultar su estado de automatización (gestionado, último despliegue hace 14 días, sin cambios pendientes) y confirma la sustitución de una tarjeta de línea. Sigue el mismo patrón que el chat. El teléfono llama a la misma API con el rol de esa persona y lo único que cambia es el tamaño de la pantalla, que es más pequeña.
Documentación e informes#
Quienes consultan información sobre la automatización sin operarla necesitan dos tipos de documentos. Ambos se generan a partir de datos en vivo de la NAP y nunca se redactan a mano. La documentación de cada servicio reúne su definición en la SoT, el estado que muestra Observabilidad y el historial de cambios del Orquestador. Los procedimientos operativos generados a partir de las definiciones de los flujos de trabajo describen lo que la automatización hace en la práctica. Los informes ofrecen resúmenes periódicos a responsables y auditores: resúmenes semanales de cambios, exportaciones de datos de cumplimiento procedentes del registro de auditoría y del registro de autorizaciones, y tendencias de los acuerdo de nivel de servicio (SLA). Ambos tipos de documentos se generan a partir de los datos mediante plantillas y se regeneran con cada cambio.
Este libro sigue el mismo patrón: se escribe una sola vez en Markdown y a partir de ese texto se generan un sitio web, un libro impreso y un libro electrónico.
Los paneles siguen el reparto de responsabilidades que establece el capítulo 7: Observabilidad se encarga de ellos y esta capa los integra para que otros públicos puedan consultarlos.
Todas las interfaces que hemos visto hasta ahora presuponen que quien las utiliza acude a la NAP. En la última funcionalidad, es la NAP la que se pone en contacto con quien la utiliza.
Integraciones y notificaciones#
La capa de Presentación se conecta con sistemas externos en ambos sentidos, y la Figura 9.4 muestra los dos uno junto al otro.
En el sentido de entrada, una integración convierte un evento de otro sistema en una llamada a la capa de API. Un webhook de ITSM o una orden de chat se convierte en una solicitud a la API como cualquier otra, con la misma autenticación y el mismo RBAC, de modo que las integraciones no abren una segunda vía de acceso.
En el sentido de salida, la NAP se pone en contacto con sistemas que no están esperando la respuesta a una llamada propia. Un componente de entrega de eventos de la capa de Presentación se ocupa de tres tareas. Se suscribe a los eventos de estado del Orquestador y dirige cada uno a quien lo necesita. Envía el evento en el formato que espera cada destino: una actualización de un ticket, un mensaje de chat, un aviso de guardia o un webhook. Y sigue intentándolo cuando un destino no responde. Si tras el último reintento sigue sin poder entregarse, el evento pasa a una cola de mensajes no entregados, donde queda a la espera de que alguien lo revise en vez de perderse.
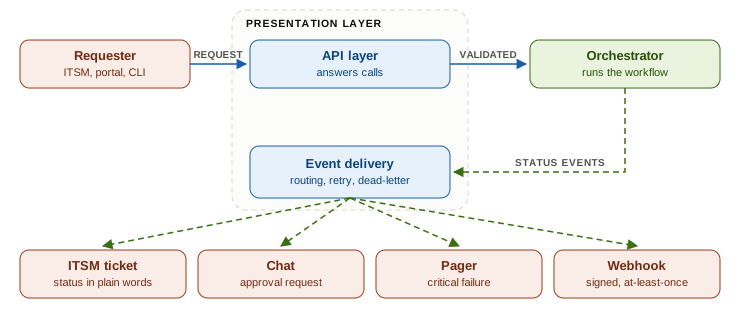
A pequeña escala, un solo componente gestiona ambos patrones sin complicaciones. A mayor escala, la entrega de eventos salientes (con su lógica de reintentos, sus colas de mensajes no entregados y su gestión de suscripciones) suele convertirse en un componente independiente con sus propias necesidades operativas. Es el bloque de entrega de eventos de la Figura 9.4. Por eso este modelo distingue los dos patrones como funcionalidades separadas.
Integración con ITSM#
Las plataformas ITSM pueden ocupar dos posiciones distintas en una arquitectura de automatización de redes, como muestran los paneles 2 y 3 de la Figura 9.5 en la sección Panorama de soluciones. La distinción importa a la hora de diseñar la arquitectura:
- La plataforma ITSM es la capa de Presentación: sus formularios definen la interfaz de usuario, su motor de flujos de trabajo gestiona las aprobaciones y notificaciones, y las llamadas a la API de automatización se realizan desde los propios flujos de trabajo de ITSM. En este modelo no hay integración externa porque la plataforma ITSM no es externa a la capa de Presentación: es la propia capa de Presentación.
- Existe una capa de Presentación dedicada y la plataforma ITSM es uno de los sistemas consumidores con los que se sincroniza: las solicitudes llegan mediante webhooks de ITSM y las actualizaciones de estado vuelven a los tickets de ITSM.
También es habitual un tercer papel: la plataforma ITSM como fuente de datos para la SoT. Cuando la base de datos de gestión de la configuración (CMDB) contiene los registros de referencia de activos o servicios, del tipo que el capítulo 5 asigna al sistema de gestión de activos, la SoT puede federar esos registros. El estado descubierto que se guarda en esa misma CMDB sigue siendo responsabilidad de Observabilidad. En este papel, la plataforma ITSM no interviene en la interfaz de automatización que utilizan los usuarios.
El resto de esta sección describe el patrón de integración (segundo punto). Elige el patrón en el que ITSM actúa como capa de Presentación (primer punto) cuando el motor de flujos de trabajo, el modelo de aprobación y el sistema de notificaciones de la plataforma ITSM cubran los tipos de solicitudes que recibes. Así te ahorras una capa independiente entre los usuarios y los bloques arquitectónicos.
La integración con ITSM es lo que construyes cuando quienes utilizan la automatización no deberían necesitar saber que existe la NAP. El equipo de aplicaciones ya trabaja en una plataforma ITSM. La interfaz que le resulta más fácil de usar es la que ya utiliza.
Un formulario de ITSM titulado «Solicitud de un nuevo servicio de red» recoge exactamente los campos que necesita el modelo de la SoT y los envía en el formato estructurado que espera la capa de API. El formulario es la interfaz de quien hace la solicitud, que nunca ve la llamada a la API. Al enviar el formulario, la plataforma ITSM llama a la capa de API con su propia cuenta de servicio e incluye en la solicitud la identidad de quien la ha presentado. La capa de API autoriza la solicitud en función del rol de quien la presenta, no del rol de la cuenta de servicio: un token de integración compartido con permisos propios reproduciría el problema del token único de administración del relato inicial.
A continuación, la capa de API pide a la SoT que valide la carga útil y reenvía la solicitud al Orquestador.
Esa frase, «exactamente los campos que necesita el modelo de la SoT», encierra un problema de mantenimiento: el formulario reside en una herramienta que gestiona otro equipo y el modelo que reproduce pertenece al tuyo. Cuando se añade un campo obligatorio a la SoT, el formulario sigue enviando solicitudes sin él y es quien presenta la solicitud quien recibe el rechazo, en vez de quien modificó el modelo. Trata el formulario como cualquier otro consumidor de la API sujeto a control de versiones. Añadir un campo obligatorio al modelo rompe la compatibilidad y exige respetar el periodo de retirada gradual descrito antes. Antes de publicar el cambio, alguien valida la carga útil del formulario con el nuevo esquema en la instancia de pruebas de la plataforma ITSM.
Una vez enviada la solicitud, el ticket debería reflejar el estado del flujo de trabajo casi en tiempo real: «Validación de la SoT completada», después «Comprobaciones previas en curso: 24 conmutadores», luego «Control de aprobación: pendiente del visto bueno de ingeniería» y, por último, «Completado: 24/24 conmutadores configurados». Esta sincronización bidireccional es más compleja que un webhook que se ejecuta una sola vez. Se encarga de ella el componente de entrega de eventos, mediante una suscripción persistente a los eventos de estado del Orquestador o un proceso de conciliación que los consulta periódicamente y los convierte en actualizaciones del ticket.
En muchas organizaciones, el ticket de ITSM constituye el registro de gestión del cambio. La capa de Presentación debe garantizar que el ticket contenga información suficiente para cumplir los requisitos de gestión de cambios, aunque el registro de auditoría de referencia resida en el Orquestador. Los dos registros se dirigen a públicos distintos: el ticket de ITSM sirve a quien presenta la solicitud y a su responsable, mientras que el registro de auditoría del Orquestador sirve a quien se ocupa de la ingeniería de red y a quien audita el cumplimiento. El capítulo 13 hace obligatorio ese vínculo mediante un control que impide desplegar en producción sin un ticket aprobado.
La integración con ITSM tiene sus límites. Es adecuada para flujos de trabajo estructurados en los que las solicitudes se presentan mediante formularios y tienen estados definidos. No es adecuada para consultas operativas en tiempo real, para inspeccionar trazas complejas de flujos de trabajo ni para operaciones avanzadas en las que el personal de ingeniería necesita iterar con rapidez. Diseña la NAP teniendo en cuenta que la plataforma ITSM cubre la mayoría de las solicitudes de quienes no forman parte del equipo de ingeniería y que una CLI o un portal específico cubre el resto.
Notificaciones push y entrega mediante webhooks#
El encaminamiento de los eventos para su entrega se define mediante configuración, sin necesidad de escribir código. Cuando un flujo de trabajo termina, llega a un control de aprobación o falla, el personal de ingeniería recibe los detalles de los fallos en un canal dedicado a operaciones, los equipos de aplicaciones reciben el estado final en el ticket de ITSM y el personal de ingeniería de guardia recibe los avisos de fallos críticos a través del sistema de avisos de guardia.
El relato inicial mostraba lo que ocurre cuando falta este mecanismo. El equipo de aplicaciones esperó entre tres y cinco días laborables por un trabajo que ya había terminado. El motivo no fue la lentitud de la automatización, sino que nada le indicó que el trabajo estaba hecho. Si la finalización de un flujo de trabajo no se comunica a quien lo solicitó, para esa persona el trabajo sigue pendiente. El fallo es invisible desde dentro de la NAP: todos los paneles están en verde mientras alguien sigue esperando.
La entrega mediante webhooks es el equivalente en sentido saliente de los webhooks entrantes. Si quien inicia un flujo de trabajo registra en ese momento una URL de devolución de llamada, recibe el resultado mediante HTTP POST cuando termina el flujo. Las garantías de entrega, la política de reintentos y el esquema de la carga útil forman parte del contrato de la API y, por tanto, deben quedar por escrito.
Una opción predeterminada viable es la entrega al menos una vez: reintenta la entrega un número limitado de veces con intervalos de espera que aumenten exponencialmente. Si se agotan los intentos, envía el evento a la cola de mensajes no entregados y genera una alerta. Nunca lo descartes en silencio.
La entrega al menos una vez implica que el consumidor recibirá en ocasiones dos veces la misma notificación de finalización. Por eso cada carga útil incluye un identificador de evento y el identificador de la ejecución del flujo de trabajo, y el consumidor los utiliza para eliminar duplicados, tal como exige el capítulo 8 para los eventos entrantes. Firma la carga útil para que quien la reciba pueda distinguir tu devolución de llamada de un POST enviado por otra persona o sistema. Una devolución de llamada que falla en silencio, sin reintentos, sin registro y sin alerta, es peor que la ausencia de devolución de llamada, porque quien hizo la solicitud da por hecho que el resultado se ha entregado.
Esas tres funciones describen lo que debe ofrecer la capa. Lo poco habitual es que solo tengas que construir una pequeña parte.
Panorama de soluciones#
El panorama de soluciones del capítulo de Presentación es distinto al de cualquier otro capítulo de la parte 2. Apenas hay herramientas que se dediquen exclusivamente a la Presentación. Cada bloque ya tiene su propia interfaz de usuario. La cuestión arquitectónica no es «¿qué herramienta de Presentación debería usar?». Es «¿cuándo me bastan las interfaces integradas de cada bloque y cuándo debo construir una capa de Presentación dedicada por encima de ellas?».
Las herramientas que se enumeran aquí sirven de ejemplo para ilustrar los conceptos, no como recomendaciones. Evalúalas teniendo en cuenta las capacidades de tu equipo, las herramientas que ya utiliza y sus restricciones operativas.
En las NAP maduras conviven dos modelos.
Modelo integrado: utiliza la interfaz de usuario que incorpora cada bloque para atender a quienes lo usan. El equipo de ingeniería utiliza el portal del orquestador para gestionar los flujos de trabajo, la interfaz web de la SoT para consultar el inventario y los paneles de observabilidad para conocer el estado de la red. Este modelo funciona cuando todas las personas que usan la plataforma son de ingeniería, conocen las herramientas y no necesitan vistas que combinen información de varios bloques. La carga operativa es baja porque no hay sistemas adicionales que mantener en funcionamiento.
Modelo de Presentación dedicada: construye o adopta una capa por encima de los bloques que ofrezca una experiencia unificada. Es necesario cuando el personal ajeno a ingeniería necesita acceso, cuando necesitas ver el estado de varios bloques en una sola vista o cuando los permisos que incorpora cada herramienta no se ajustan bien a los requisitos de RBAC.
En la práctica, esos dos modelos dan lugar a tres posibles ubicaciones para la capa, que la Figura 9.5 muestra una junto a otra.
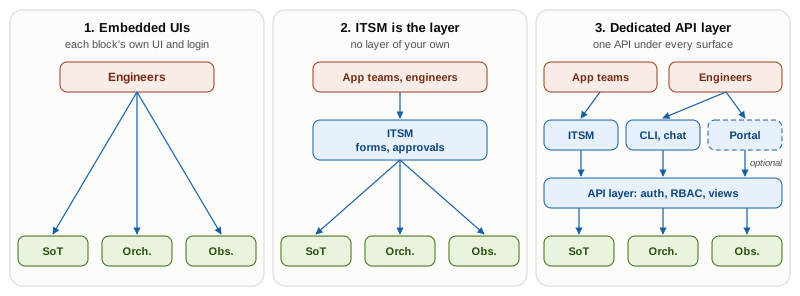
El primer panel muestra el modelo integrado. Los otros dos muestran dos variantes del modelo dedicado: el ITSM asume todas las funciones de la capa o sitúas una capa de API propia bajo todas las interfaces. Esa capa de API es la misma tanto si las interfaces que tiene por encima son las que ya se utilizan, como el ITSM, una CLI o un chat, como si incluyen un portal que construyes tú. El portal es un añadido opcional sobre la capa de API y no supone una arquitectura distinta.
Los productos del mercado se agrupan en seis enfoques, cada uno de los cuales tiene cabida en alguno de los paneles:
- Interfaz de usuario integrada en cada bloque (portal de AWX, interfaz de usuario de Nautobot, Grafana), panel 1: para equipos de ingeniería, cuando es aceptable gestionar el RBAC por herramienta y no hace falta una vista que abarque varios bloques.
- ITSM como interfaz principal (ServiceNow, Jira Service Management), panel 2 o una de las interfaces del panel 3: para empresas cuyo personal ajeno a ingeniería ya trabaja en el ITSM con flujos de solicitud basados en formularios.
- Portal de autoservicio a medida (una aplicación en React, Vue o Django), el portal opcional del panel 3: cuando el personal ajeno a ingeniería necesita acceso, con RBAC unificado y aprobaciones en régimen de autoservicio.
- Pasarela de API (Kong, AWS API Gateway, NGINX), la capa de API del panel 3: se encarga del enrutamiento y de las funciones comunes del patrón Pasarela de API (API Gateway) cuando varios consumidores tienen requisitos distintos de autenticación, limitación de la tasa de solicitudes y aplicación de reglas de versionado.
- Portales nativos de red (Itential, la interfaz de usuario northbound de NSO), panel 3 como producto adquirido en vez de desarrollado internamente: productos centrados en la red que incorporan RBAC y adaptadores para ITSM.
- Portal para desarrolladores (Backstage), una interfaz del panel 3 compartida con otras plataformas internas: para grandes organizaciones con muchas plataformas internas que necesitan un único punto de entrada.
Cómo elegir entre las opciones#
Construir una capa de Presentación dedicada no debería ser la opción predeterminada. La Figura 9.6 muestra las tres preguntas que debes plantearte primero. Cada uno de los cuatro resultados corresponde a un panel de la Figura 9.5: los dos primeros, a los paneles 1 y 2, respectivamente, y los dos últimos, al panel 3, con o sin portal.
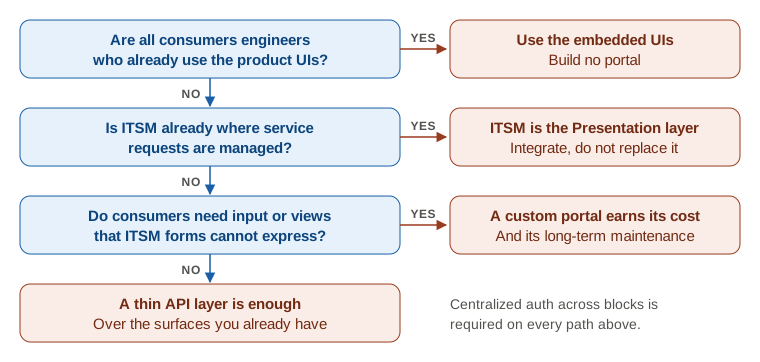
La figura muestra los tres puntos de decisión. Hay otras tres condiciones que no introducen nuevas ramas, pero que condicionan la respuesta sea cual sea el camino que sigas.
El control de acceso centralizado es un requisito en cualquier caso. Si necesitas aplicar la autorización de manera uniforme en varios bloques, necesitas una capa de API que centralice el control de acceso, sean cuales sean las interfaces cliente que la utilicen. Ese requisito es independiente de la decisión sobre el portal.
El compromiso importa más que la capacidad. Si tienes dudas sobre si podrás mantener un portal a medida durante años, empieza por la integración con el ITSM y construye un portal solo cuando compruebes que el ITSM se queda corto para los patrones de acceso que tienes en la práctica.
Algunos datos de entrada no encajan en un formulario. Los campos complejos (fragmentos de YAML, parámetros de topología, vistas previas de la asignación de subredes), la validación en el propio formulario con respecto al modelo de la SoT o las vistas de estado detalladas que permiten profundizar por dispositivo suelen ir más allá de lo que los constructores de formularios de ITSM resuelven bien. Cuando quienes usan la NAP necesitan ese nivel de detalle con regularidad, un portal compensa su coste operativo.
El error más común es construir un portal a medida antes de comprobar que existe una necesidad real.
Una pregunta pesa más en esta decisión que cualquier argumento arquitectónico: ¿quién se encarga de mantenerlo? Un portal a medida es una aplicación web. Requiere conocimientos de desarrollo frontend, un proceso de publicación de versiones, la aplicación de parches a las dependencias y alguien a quien puedas localizar si el portal falla al mismo tiempo que la red. Un equipo de redes que carezca de esas competencias y de una forma fiable de recurrir a quienes las tienen no debería construir un portal por mucho que la arquitectura lo justifique. Es una cuestión que tiene más que ver con la composición del equipo que con la estructura del sistema. El capítulo 14 aborda las competencias que una NAP exige que desarrolle la organización.
Entender cómo funcionan por dentro las interfaces de usuario integradas es importante para decidir cómo personalizarlas. NetBox y Nautobot se basan en Django (Python). Sus interfaces web son vistas de Django y sus API REST utilizan puntos de acceso de Django REST Framework. Infrahub utiliza FastAPI. El «componente de Presentación» de estas herramientas de SoT es un marco de desarrollo web maduro que puedes personalizar mediante complementos, vistas a medida y extensiones de los serializadores. La ventaja es que está bien documentado y preparado para producción. El inconveniente es que realizas las personalizaciones dentro de un marco diseñado principalmente para el caso de uso de la SoT, no para el de un portal de autoservicio.
La capa de Presentación debe ser ligera. Es una interfaz, no un sistema. Traduce, autentica y enruta. La lógica de negocio corresponde al Orquestador y a la Fuente de Verdad. En cuanto la capa empieza a tomar decisiones de automatización, a reintentar por su cuenta las operaciones fallidas o a guardar las reglas que determinan qué cambios son válidos, desaparece la separación y ya no podrás hacer evolucionar ambos lados de forma independiente.
Así funciona la capa en teoría. El ejemplo siguiente sigue el paso de una solicitud por la capa desde tres perspectivas: la de quien la presenta, la de quien la aprueba y la de quien la audita.
Ejemplo de implementación#
Escenario: La misma solicitud de servicio de VLAN, vista desde fuera. Un equipo de aplicaciones necesita app-payments en el edificio B, alguien del equipo de ingeniería de redes tiene que aprobar la solicitud durante su tramitación y, tres meses después, una persona del equipo de auditoría pregunta quién la autorizó. Ninguna de las tres partes debería tener que aprender a manejar la NAP para conseguir lo que necesita.
Requisitos:
- Un único contrato de API común a todas las interfaces, con la autenticación y la autorización aplicadas una sola vez en esa capa
- Una vía para presentar solicitudes a través del sistema que quien las presenta ya utiliza a diario
- Una interfaz de aprobación con el detalle justo para que quien revise la solicitud en ingeniería pueda tomar una decisión
- Un estado expresado en el vocabulario de quien presenta la solicitud, sin recurrir a identificadores de tareas
- Una vista de auditoría de solo lectura que permita saber, meses después, quién, cuándo y qué versión
- Ninguna lógica de negocio en estos componentes: la capa de Presentación expone lo que deciden los demás bloques
Bloques implicados:
- Fuente de Verdad: valida la solicitud con respecto al modelo de red y conserva el registro del estado anterior y posterior al cambio que consulta quien lo audita
- Orquestación: ejecuta el flujo de trabajo, emite los eventos de estado a los que se suscriben las interfaces y detiene el flujo en el punto de aprobación
- Ejecución y Observabilidad: llevan a cabo el trabajo y lo verifican, sin que ninguno de los tres grupos vea esas operaciones
- Presentación:
- Capa de API: tres tokens con alcance limitado por rol, un solo contrato y una única comprobación de autorización
- Interfaces de usuario: un formulario de ITSM para quien presenta la solicitud y un portal a medida para quien la revisa en ingeniería y quien la audita
- Integraciones y notificaciones: recibe solicitudes del ITSM y envía actualizaciones de tickets, solicitudes de aprobación y avisos al personal de guardia
Al igual que en el resto de la parte 2, en este ejemplo se omiten deliberadamente los nombres de productos. Lo que puedes trasladar a otros contextos es la elección de la interfaz para cada grupo de usuarios y el hecho de que todas comparten un único contrato de API subyacente.
A estas alturas, la solicitud de VLAN del campus ya se ha modelado, almacenado, desplegado, validado y coordinado de extremo a extremo. Cada uno de esos capítulos la ha descrito desde dentro, como algo que hace la NAP. Este capítulo la examina desde fuera, empezando por la persona del equipo de desarrollo de aplicaciones que rellenó el formulario.
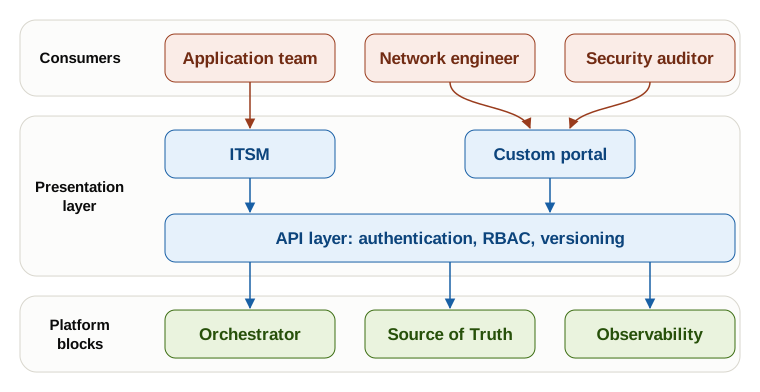
Este campus utiliza una capa dedicada, la del tercer panel de la Figura 9.5, que consta de tres componentes. El ITSM es la interfaz principal para el conjunto de la organización: los equipos de aplicaciones presentan solicitudes y siguen su estado sin salir del ITSM, que las canaliza a través de la API de la capa de Presentación como parte de la automatización de sus propios flujos de trabajo.
Un portal a medida con una vista de auditoría da servicio a los equipos de ingeniería y cumplimiento normativo: el personal de ingeniería de redes revisa allí los resultados de las comprobaciones previas y decide si da el visto bueno en los puntos de aprobación, y el personal de auditoría de seguridad consulta los registros compuestos de los cambios mediante la interfaz de auditoría de solo lectura del portal. Ambas interfaces comparten la misma capa de API, que forma parte de la propia capa de Presentación y aplica la autenticación, el RBAC y las reglas de versionado antes de que las solicitudes lleguen a los bloques subyacentes.
Tres grupos de usuarios, dos interfaces#
La capa de API aplica los permisos de tres de los cuatro roles definidos anteriormente. El equipo de aplicaciones tiene el rol operator. A través del ITSM, cuya cuenta de servicio transmite la identidad de quien presenta cada solicitud, el equipo consulta sus propias solicitudes y envía otras nuevas. Con su token engineer, el personal de ingeniería de redes consulta todas las solicitudes de su ámbito y las aprueba o rechaza en los puntos de aprobación. Con su token read-only, el personal de auditoría consulta los registros de auditoría de toda la NAP y carece de acceso de escritura. El rol admin no interviene en este flujo, y precisamente por eso se mantiene como rol independiente. Ambas interfaces pasan por la capa de API. La Figura 9.7 muestra el resultado.
El equipo de aplicaciones, a través del ITSM. El equipo envía solicitudes y quiere saber cuándo está listo el servicio y, si algo falla, qué ha ocurrido. Nunca debería tener que abrir el Orquestador ni la SoT. Su punto de entrada es el ITSM y la API de la NAP queda siempre fuera de su vista.
Quien desarrolla la aplicación rellena un formulario del ITSM con el nombre del servicio (
app-payments), el edificio (B) y el perfil (standard), además del equipo solicitante y la justificación de negocio para el tique. Al enviarse el formulario, el ITSM llama directamente a la capa de API de la NAP como parte de la automatización de sus propios flujos de trabajo. La capa de API autentica la cuenta de servicio del ITSM, autoriza la operación según el roloperatorde la persona que la solicita, pide a la SoT que valide los datos recibidos con su modelo de datos y remite la solicitud estructurada al Orquestador.La validación puede fallar si el edificio solicitado no corresponde a ninguna ubicación de la SoT o si el perfil no se ofrece allí. En ese caso, la SoT rechaza la solicitud y la capa de API devuelve de inmediato un error estructurado, antes de que se inicie ningún flujo de trabajo del Orquestador. El ITSM actualiza el tique con un motivo claro del fallo: «No se ha encontrado el edificio C en el registro de ubicaciones» o «El perfil high-security no se ofrece en el edificio B». El equipo de aplicaciones ve el rechazo en su tique y puede corregir la solicitud sin recurrir a ingeniería de redes. No se crea ningún estado parcial del flujo de trabajo ni hace falta una reversión del patrón Saga, porque el flujo nunca llegó a iniciarse.
Aquí también entran en juego las protecciones que faltaban en el relato inicial. Esa misma semana, la cadena de publicación de versiones del equipo de pagos reintenta en bucle un envío fallido con su propio token de servicio. Tras enviar 20 solicitudes en un minuto, supera el límite por token. La capa de API responde con
429yRetry-After: 60, y las solicitudes que exceden el límite nunca llegan a la cola del Orquestador. Los duplicados que sí llegaron llevan la misma clave de deduplicación, por lo que el Orquestador inicia un único flujo de trabajo en vez de 20.A medida que avanza el flujo de trabajo, la capa de Presentación convierte los eventos de estado del Orquestador en las actualizaciones del tique que se enumeran en la sección Integración con el ITSM. El equipo de aplicaciones ve cómo se actualiza su tique sin saber siquiera que existen el Orquestador, la SoT o el Ejecutor.
El personal de ingeniería de redes, a través del portal. Recibe la notificación que genera el flujo de trabajo al llegar al punto de aprobación (paso 3 del capítulo 8). Necesita consultar los resultados de las comprobaciones previas de los 24 conmutadores de destino, tomar una decisión y poder examinar el resultado. Su interfaz ofrece más detalle que el formulario del ITSM, aunque sigue limitada al ámbito de su equipo.
Cuando el flujo de trabajo llega al punto de aprobación, el Orquestador detiene la ejecución y emite un evento. La capa de Presentación lo recibe, identifica a la persona de ingeniería de redes responsable del edificio B y envía a su canal de Slack una solicitud de aprobación con un enlace directo a la página de revisión. La página muestra los resultados de las comprobaciones previas de cada conmutador: cuáles se superaron, cuáles fallaron, cuáles se omitieron y por qué. La persona responsable aprueba o rechaza la solicitud desde el portal. La acción queda registrada con el detalle de quién dio la aprobación, desde qué interfaz, a qué hora y con qué token.
En ese mismo punto se aplica la separación de funciones. Una persona de ingeniería de redes que ha solicitado una VLAN de laboratorio en el edificio B abre la página de revisión de su solicitud y ve que no hay ningún botón para aprobarla. Una llamada directa a la API también falla y devuelve
403, porque la regla del Orquestador te impide aprobar tu propia solicitud (capítulo 8). La denegación queda anotada en el registro de autorizaciones igual que cualquier aprobación.El personal de auditoría de seguridad, a través de la vista de solo lectura del portal. Tres meses después, quiere saber quién solicitó esta VLAN, quién la aprobó, qué versión del flujo de trabajo se ejecutó y en qué estado estaban los conmutadores antes y después del cambio. Su interfaz no permite iniciar acción alguna.
Tres meses después, la persona que realiza la auditoría de seguridad consulta la API de la capa de Presentación: «Muéstrame el registro completo del cambio de la VLAN app-payments en el edificio B». El punto de acceso de auditoría, de solo lectura, reúne información de tres fuentes:
- El registro de auditoría del Orquestador (sección Trazabilidad del capítulo 8): qué versión del flujo de trabajo se ejecutó, las entradas y salidas de cada paso y las acciones de compensación del patrón Saga, si las hubo
- El historial de cambios de la SoT (capítulo 5): el estado de la definición de la VLAN antes y después del cambio
- El registro de autorizaciones de la propia capa de Presentación: quién envió la solicitud, qué token utilizó, quién dio el visto bueno en el punto de aprobación y cuándo, y qué intentos se denegaron para esa misma solicitud, si los hubo
La respuesta es un documento estructurado que la persona que realiza la auditoría puede adjuntar al registro de gestión del cambio. Ninguno de los tres bloques subyacentes se diseñó para generar por sí solo este registro conjunto. La capa de Presentación lo ha elaborado a partir de las API de los tres bloques con el token de solo lectura de quien realiza la auditoría.
El mismo flujo de trabajo de seis pasos del capítulo 8 ha atendido a tres grupos de usuarios a través de dos interfaces, sin que ninguno haya tenido que aprender cómo funciona la NAP.
Resumen#
Hasta este capítulo nos hemos centrado en los bloques internos de la arquitectura. Pero ningún bloque funciona de forma aislada. La NAP se integra con personas u otros sistemas externos, y la capa de Presentación hace posible esa integración mediante una capa de API e interfaces de usuario.
La capa de API es la base. Ofrece acceso a toda la NAP a través de una capa coherente y fácil de usar que oculta los detalles internos y proporciona así protecciones implícitas para operar la plataforma con eficacia. Admite distintos tipos de interacción, incluidas las de los agentes a través de MCP. En todos los casos, garantiza que se respeten los límites de seguridad y que el rendimiento sea escalable y fiable, aspectos que se tratan en la parte 3.
La adopción de la automatización de redes depende en gran medida de que cada perfil de usuario disponga de interfaces adecuadas a sus necesidades y capacidades. Ninguna interfaz sirve para todo el mundo. Adáptate a los distintos grupos de usuarios, crea la mejor interfaz para cada uno y reconoce que, en ocasiones, algunas personas pueden necesitar interfaces directas con los bloques internos para determinadas interacciones. Y no olvides las interacciones salientes: cómo se comunicará la NAP por iniciativa propia con entidades externas para responder con la mayor rapidez posible cuando haga falta.
Por último, para cerrar la parte 2, centrémonos en la propia Red, que se trata en el capítulo 10.
Referencias#
- Designing Web APIs, de Brenda Jin, Saurabh Sahni y Amir Shevat (O’Reilly, 2018). Trata el diseño y el versionado de API y la experiencia de desarrollo. Es la base de la sección Capa de API.
- API Design Patterns, de JJ Geewax (Manning, 2021). Catálogo sistemático de patrones para organizar y nombrar recursos y definir interacciones en API coherentes y escalables.
- Building Microservices, 2nd Edition, de Sam Newman (O’Reilly, 2021). Pasarelas de API y autenticación en el perímetro.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo