Orquestación#
El equipo de automatización de redes había establecido un proceso sólido, con los datos de intención en la Fuente de Verdad y varios playbooks bien probados para las operaciones más habituales. Sobre el papel, desplegar un nuevo servicio de VLAN era un proceso totalmente automatizado. En la práctica, llevaba media jornada.
La ingeniera que solía encargarse de la tarea conocía la secuencia. Primero, validar los datos de la Fuente de Verdad (SoT). Después, ejecutar el playbook de comprobaciones previas, revisar la salida, identificar los dispositivos en los que se habían producido fallos y decidir si seguir adelante. A continuación, lanzar el playbook de despliegue y esperar un rato. Por último, ejecutar el playbook de validación y actualizar el ticket a mano. Si alguna ejecución fallaba a mitad de camino, había que revertir los cambios antes de que alguien se diera cuenta. La ingeniera había documentado todo el proceso paso a paso en una guía operativa, pero nadie más lo dominaba por completo.
Cuando la ingeniera se ausentó, los despliegues de VLAN se paralizaron. Nadie más conocía la secuencia exacta de pasos para ejecutar la automatización. Más adelante, un ingeniero júnior intentó seguir la secuencia con ayuda de la guía operativa, pero confundió el orden de los pasos y la red pasó seis horas con los cambios aplicados solo en parte.
Había automatización, pero la coordinación seguía siendo manual.
Aquella ingeniera era el nexo entre las piezas. En este capítulo veremos cómo puede un sistema asumir esa función. Cada bloque arquitectónico que hemos visto hasta ahora hace bien una cosa. La Fuente de Verdad almacena la intención. El Ejecutor la aplica. El Recolector obtiene el estado. Observabilidad interpreta ese estado. Cada bloque tiene su especialidad y hace falta algo que los conecte, que decida cuándo debe actuar cada uno, qué hacer con el resultado y cómo recuperarse si algo sale mal.
Ese nexo es el Orquestador, el bloque arquitectónico que convierte un conjunto de herramientas de automatización en un sistema que funciona como una unidad. Coordina los demás bloques, decide cuándo se ejecutan, gestiona los fallos de forma controlada y registra cada decisión. Y hace todo esto sin que alguien del equipo de ingeniería tenga que intervenir para dirigir el flujo a mano.
Yo he desempeñado ese papel. Durante un tiempo sentí que tenía el puesto asegurado: nadie podía sustituirme. Luego vi la otra cara. Mis responsables tampoco querían cambiarme de puesto, porque hacerlo les crearía un problema. Me esperaban años haciendo el mismo trabajo por el simple hecho de que solo yo sabía hacerlo. Para crecer profesionalmente, tienes que conseguir que alguien pueda sustituirte. Así también mejora tu equipo, porque lo que tú sabías queda recogido en el flujo de trabajo, donde todo el mundo puede consultarlo.
Fundamentos#
En el capítulo 3 situamos al Orquestador en el centro del marco NAF como el bloque que coordina a todos los demás. Este capítulo muestra cómo el Orquestador establece el orden en que intervienen la Fuente de Verdad, el Ejecutor y Observabilidad, y cómo gestiona todo lo que puede salir mal entre una intervención y la siguiente.
Sin orquestación, lo que ejecutas no es una automatización. Ejecutas scripts que alguien tiene que invocar en el orden correcto y en el momento adecuado, y cuyos resultados tiene que interpretar correctamente. Solo es automatización de nombre.
El Orquestador debe cumplir cinco objetivos:
Coordinar de principio a fin flujos de trabajo en los que intervienen varios bloques. Un despliegue consta de toda una secuencia de acciones: validar la intención en la SoT, realizar las comprobaciones previas, aplicar la configuración, validar el resultado e informar a las partes interesadas. El Orquestador coordina toda la secuencia.
Reaccionar a los eventos automáticamente, tanto si los inicia una persona como si no. Una aprobación en un portal de servicios, una alerta de Observabilidad o una comprobación de cumplimiento programada deberían poder activar un flujo de trabajo sin que nadie tenga que ponerlo en marcha a mano.
Funcionar de forma fiable a gran escala. Un flujo de trabajo que actúa sobre 800 switches en paralelo debe completarse de forma fiable. Debe poder continuar tras un reinicio. Debe gestionar los fallos parciales sin perder el trabajo que ya han completado los dispositivos en los que la operación ha tenido éxito.
Dar visibilidad a la ejecución y permitir detectar cualquier manipulación de los registros. El personal de operaciones necesita ver qué se está ejecutando ahora mismo. El personal de auditoría necesita ver qué se ejecutó el mes pasado, quién inició la ejecución, qué versión del flujo de trabajo se ejecutó y qué resultado produjo cada paso. Un mismo sistema debe cubrir ambas necesidades.
Gestionar las definiciones de los flujos de trabajo como software de producción. Un flujo de trabajo que realiza despliegues en 800 switches no se puede modificar a la ligera. Hay que guardar de forma persistente la propia lógica del flujo, versionarla, probarla y pasarla a producción con el mismo rigor que cualquier otro código que se ejecute en producción.
Qué entra en su ámbito
- Coordinar otros bloques arquitectónicos
- Definir la lógica de los flujos de trabajo y las dependencias entre pasos
- Gestionar la activación de los flujos de trabajo desde distintas fuentes
- Seguir el estado de los flujos de trabajo y generar registros de auditoría
- Decidir si hay que revertir los cambios cuando falla algún paso
Qué queda fuera de su ámbito
- Ejecutar cambios en los dispositivos (de eso se encarga el Ejecutor)
- Almacenar el estado operativo de la red (de eso se encarga Observabilidad)
- Almacenar la intención de red (de eso se encarga la Fuente de Verdad)
Un error habitual es construir un Orquestador que duplique las funciones de ejecución o almacenamiento de los bloques vecinos. La interfaz entre los bloques debe mantenerse bien definida.
Un Orquestador que además almacena credenciales, gestiona el inventario de dispositivos o ejecuta su propio motor de configuración se ha convertido en otra cosa. Si tu herramienta de orquestación empieza a asumir responsabilidades de otros bloques, tienes un problema de acoplamiento en la arquitectura que más adelante te costará resolver.
El ámbito del Orquestador delimita sus responsabilidades. La siguiente pregunta es qué necesita dentro de esos límites para alcanzar sus cinco objetivos.
Funcionalidades#
Como muestra la Figura 8.1, hay cinco funcionalidades fundamentales, una para cada objetivo.
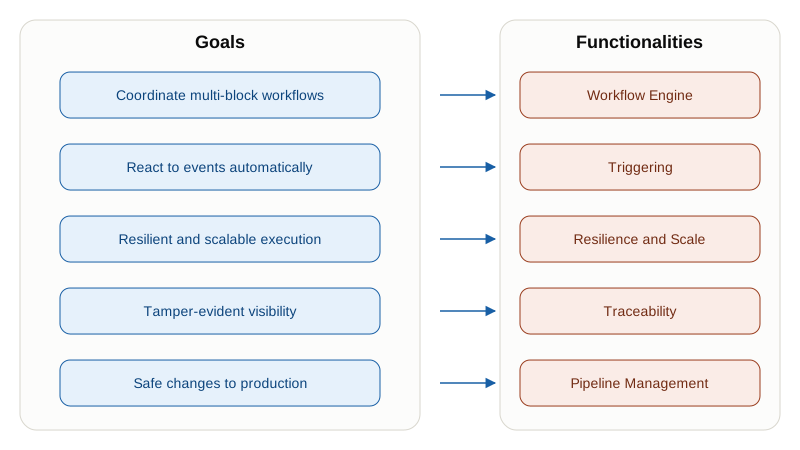
- Motor de flujos de trabajo: determina cómo se estructuran los flujos de trabajo y cómo se coordinan sus pasos. Define un proceso de varios pasos, lo ejecuta y sigue su evolución como una unidad.
- Activación: determina cómo y cuándo se inician los flujos de trabajo y qué ocurre desde el punto de vista de quien los solicita. Una llamada a una interfaz de programación de aplicaciones (API), una ejecución programada o un mensaje en una cola implican distintas expectativas sobre cuánto tendrá que esperar quien inicia el flujo.
- Resiliencia y escala: permiten que los flujos de trabajo se completen de forma fiable incluso si se producen fallos o el volumen de trabajo es elevado. El flujo de trabajo puede continuar tras un reinicio, realizar reintentos y revertir cambios cuando haga falta, y ejecutarse de forma concurrente en cientos de dispositivos sin que el procesamiento de cada dispositivo se convierta en un cuello de botella.
- Trazabilidad: consiste en seguir el estado del flujo de trabajo y generar registros de auditoría que permitan detectar cualquier manipulación. Así queda constancia de cada paso y se puede rastrear cada decisión mucho después de la ejecución.
- Gestión del ciclo de vida de los flujos de trabajo: consiste en tratar las definiciones de los flujos de trabajo como software de producción. Guárdalas de forma persistente, versiónalas y pásalas a producción de forma segura.
Dedicaremos una sección a cada funcionalidad, en ese orden, empezando por el motor del que dependen todas las demás.
Motor de flujos de trabajo#
El motor de flujos de trabajo es el núcleo del Orquestador. Define procesos de varios pasos, los ejecuta, sigue su estado y gestiona las relaciones entre sus pasos.
Empieza por elegir el enfoque de coordinación, porque esa decisión condiciona todo lo demás. Hay cuatro enfoques y la Figura 8.2 los muestra uno junto a otro.
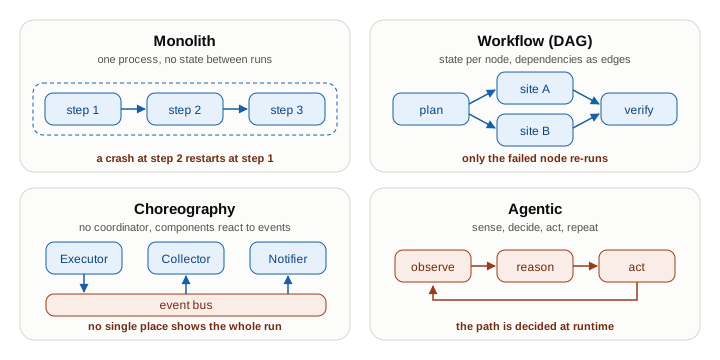
Monolito (programa imperativo): un único script (por ejemplo, en Python o Go) invoca cada paso en orden, espera cada resultado y decide qué hacer a continuación. Es fácil de escribir y muchos equipos empiezan por aquí. El problema es la durabilidad: si el script se interrumpe por un fallo en el paso 5 de 10, tienes que volver a empezar desde el principio. El estado no se conserva entre ejecuciones. Tampoco puedes ejecutar pasos en paralelo sin escribir tú mismo la lógica de gestión de hilos. Funciona para operaciones pequeñas y rápidas, pero falla bajo carga o cuando la infraestructura es poco fiable. Esto es lo que ya ofrece el bloque Ejecutor: un script que invoca alguien del equipo de operaciones. Llamarlo orquestación es mucho decir.
Flujo de trabajo (basado en un DAG): aquí se ve con más claridad en qué consiste la orquestación. Los pasos se definen mediante un grafo dirigido acíclico, en el que cada nodo es una tarea y las aristas representan dependencias. El motor lleva la cuenta del estado de cada nodo: si reinicias el proceso tras un fallo, solo se repiten los pasos que han fallado o han quedado incompletos. El paralelismo está incorporado: las ramas independientes se ejecutan de forma concurrente. Es el enfoque más utilizado para los cambios de red que constan de varios pasos y también el más contrastado. Más adelante en este capítulo, la sección Panorama de soluciones compara las herramientas de esta categoría.
Coreografía (basada en eventos, sin coordinador central): no hay Orquestador. Cada componente reacciona a los eventos que publican los demás: el Ejecutor publica «despliegue completado», el sistema de Observabilidad consume el evento y ejecuta la validación, y el sistema de notificaciones consume el resultado de la validación. El acoplamiento entre componentes es débil, lo que facilita añadir nuevos consumidores. El inconveniente es que no hay un único lugar donde consultar el estado del flujo de trabajo en su conjunto. Para diagnosticar fallos que afectan a varios servicios hay que correlacionar eventos de distintos sistemas. Este enfoque funciona para patrones reactivos sencillos, pero se complica a gran escala.
Coordinación con agentes (bucle de percepción, razonamiento y acción): un sistema de inteligencia artificial (IA) hace de capa lógica. El agente observa el estado actual (a partir de los datos de Observabilidad o de la SoT), razona sobre qué acción hace falta e invoca al Ejecutor. No sigue un grafo de flujo de trabajo predefinido, sino que toma decisiones en tiempo de ejecución. Este enfoque sacrifica determinismo para ganar flexibilidad y constituye la base arquitectónica de las redes autónomas. La sección Orquestación con agentes lo trata en profundidad. El capítulo 18 lo amplía para abordar la autonomía dentro de los límites que fija una persona.
La mayoría de los equipos empiezan con un monolito y pasan a los flujos de trabajo basados en un DAG a medida que madura su automatización. La coreografía es más difícil de aplicar bien en las operaciones de red: exige resolver bien la auditoría y la trazabilidad, algo que un coordinador central te ofrece sin apenas esfuerzo adicional. Los enfoques con agentes ya se utilizan, pero todavía no son la opción habitual para operar redes en producción.
Vale la pena examinar la coreografía con más detalle, porque muchos equipos ya la usan sin haberla elegido. Si una alerta de Observabilidad llega a un bus de mensajes, un servicio de corrección la consume y llama al Ejecutor, y un servicio de notificaciones consume el resultado, tienes un flujo de trabajo coreografiado. Nadie lo diseñó así. Fue creciendo con cada nuevo suscriptor.
Te das cuenta al depurar, no al diseñar. Cuando una corrección no se lleva a cabo, ningún sistema puede decirte por sí solo por qué. Compruebas si se disparó la alerta y si se publicó. Después compruebas si el consumidor estaba en ejecución, si llamó al Ejecutor y si el Ejecutor falló. Cada componente registró correctamente su parte, pero ninguno tiene una visión completa de la ejecución. La coreografía te permite mantener un acoplamiento débil y añadir consumidores sin tocar el productor. A cambio, pierdes la posibilidad de consultar toda la ejecución en un único sitio, salvo que incorpores trazas que abarquen todos los componentes (Capítulo 12).
Hay otra forma que queda fuera de estas cuatro: el bucle de conciliación. Es un controlador que se ejecuta continuamente, compara el estado de la red con la intención y actúa ante cualquier diferencia. Es adecuado para tareas que nunca terminan, como mantener la configuración ajustada a la intención. Un flujo de trabajo es adecuado para tareas con un principio y un fin. Ambos se complementan. En el Capítulo 16 se construye un bucle de conciliación que, cuando decide actuar, inicia un flujo de trabajo basado en un DAG en el Orquestador.
Patrones de flujo de trabajo basados en DAG#
Dentro del enfoque basado en DAG, los tres patrones que muestra la Figura 8.3 cubren la mayoría de los flujos de trabajo de automatización de redes que se usan en la práctica:
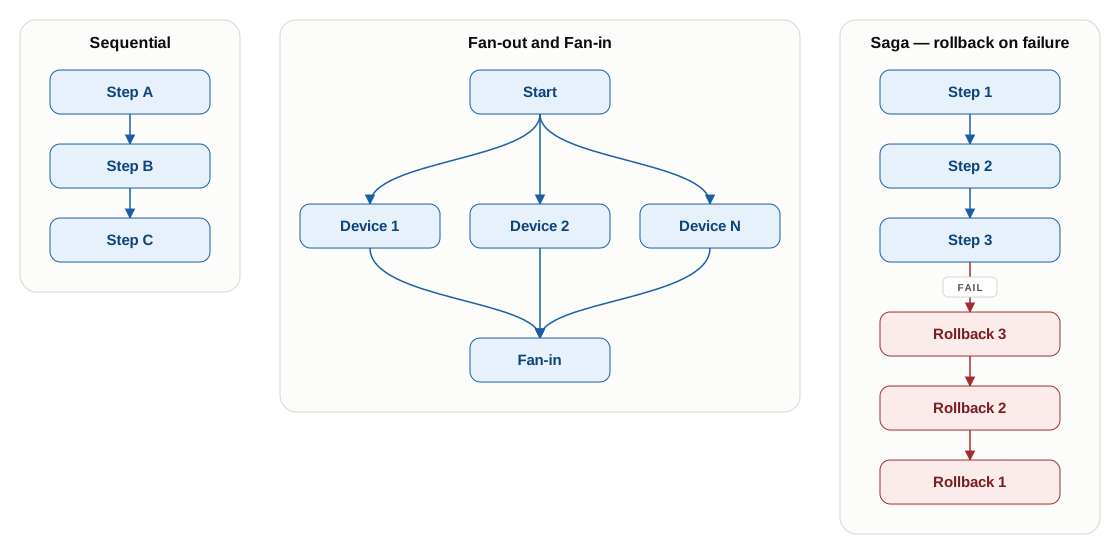
Secuencial (Sequential): Los pasos se ejecutan uno tras otro. Cada uno depende de que el anterior termine correctamente. Es adecuado cuando hay que seguir un orden estricto: validar la intención, hacer las comprobaciones previas, ejecutar y, por último, verificar.
Paralelo (fan-out/fan-in): Varios pasos independientes se ejecutan de forma concurrente. Un paso de distribución lanza muchas tareas en paralelo (una por dispositivo o una por edificio). Un paso de convergencia espera a que todas terminen antes de continuar. Es esencial para las operaciones que abarcan cientos de dispositivos: sin esa distribución, una operación que tarda 10 segundos por dispositivo tarda más de dos horas si se ejecuta en serie en 800 dispositivos.
Patrón Saga (Saga Pattern): En los flujos de trabajo de larga duración, cada paso lleva asociada una acción de compensación. Así, si se produce un fallo a mitad del proceso, se puede deshacer lo hecho y evitar que el cambio quede aplicado a medias. En la orquestación, la reversión consiste en ejecutar la acción inversa de cada paso que terminó correctamente, sin volver a ejecutar todo el flujo de trabajo. La sección Reversión y compensación explica cómo funcionan estos mecanismos y cuánto cuesta implementarlos.
El Patrón Saga también sirve de base para el despliegue progresivo por oleadas (progressive wave rollout), que consiste en desplegar cambios de red por oleadas. La oleada 1 abarca un pequeño grupo de dispositivos de prueba. Si tiene éxito, el flujo de trabajo se extiende a la oleada 2 y así sucesivamente hasta la oleada N. Si falla una oleada, la compensación revierte esa oleada y la política de despliegue del cambio determina si se mantiene el cambio en las oleadas anteriores (Capítulo 11).
Es el equivalente en redes de un despliegue canario: el mismo rigor con el que los equipos de software controlan el paso de una fase a la siguiente al publicar versiones de código se aplica a los cambios de red. El Capítulo 11 explica cómo la plataforma de automatización de redes (NAP) determina el tamaño de las oleadas, toma una instantánea de cada una y hace cumplir las condiciones para avanzar. Más adelante en este capítulo, la sección Validación del estado de la red antes de pasar a la siguiente oleada explica el control que se aplica entre oleadas.
La ramificación condicional es una propiedad que pueden tener los tres patrones, no un cuarto patrón: el camino que se sigue depende del estado en tiempo de ejecución. ¿Se ha superado la comprobación previa? Sigue la rama de ejecución. ¿Ha fallado? Sigue la rama que interrumpe el proceso y envía una notificación. Un flujo de trabajo secuencial puede ramificarse entre pasos, uno con distribución puede hacerlo por dispositivo y una Saga decide si hace falta compensar. Sea cual sea la forma, la definición del flujo de trabajo contiene nodos de decisión que evalúan un resultado y eligen qué se ejecuta a continuación.
El Listado 8.1 reúne los tres patrones en una sola definición de flujo de trabajo. Es el núcleo del flujo de trabajo para las VLAN del campus que se presenta en la sección Ejemplo de implementación. Los tres pasos se ejecutan uno tras otro, según el patrón secuencial. Cada paso distribuye el trabajo entre los switches por lotes, según el patrón paralelo. Y el paso que modifica la red lleva asociada una acción de compensación, según el Patrón Saga.
workflow: vlan-service-deploy
steps:
  - id: pre-check
    run: executor.precheck
    fan_out:
      over: inputs.devices
      batch_size: 50           # concurrency control, not parallelism for its own sake
      failure_threshold: 0.10  # abort if more than 10% of devices fail the pre-check

  - id: deploy
    needs: [pre-check]
    run: executor.apply
    fan_out:
      over: steps.pre-check.output.reachable
      batch_size: 50
      failure_threshold: 0.05  # an additive VLAN tolerates a few stragglers; a security change would be 0
    compensate: executor.remove_vlan

  - id: validate-result
    needs: [deploy]
    run: observability.assert_state
    fan_out:
      over: steps.deploy.output.changed
delay: 90s # convergence plus three 30 s telemetry intervalsLee las claves needs y verás el grafo: cada paso indica a qué pasos espera y el motor deduce el orden a partir de esas dependencias. El patrón paralelo se expresa en fan_out, y los dos parámetros que aparecen al lado son los que importan en la práctica. batch_size limita qué parte de la red cambia a la vez. failure_threshold determina cuándo hay que parar. Su valor varía según el paso por los motivos que explica la sección Control de la concurrencia. La clave compensate de deploy vincula ese paso con la compensación del Patrón Saga, que se explica más adelante.
Gestión de dependencias#
Los pasos de un flujo de trabajo rara vez están aislados. El motor debe poder expresar y hacer respetar tres tipos de dependencias:
Dependencias de datos: La tarea B no puede empezar hasta que la tarea A termine y produzca un resultado que B consuma. El motor pasa los resultados de un paso a otro como datos estructurados. Por ejemplo, el paso de comprobación previa pasa la lista de dispositivos accesibles al paso de ejecución, que así no vuelve a consultarlos.
Dependencias con varias entradas (convergencia): Un paso espera a varias ramas paralelas antes de continuar. El motor mantiene el estado de cada rama y solo activa el paso de unión cuando se cumple el criterio de finalización configurado: que terminen todas las ramas, que terminen N de M o que una termine correctamente por primera vez.
Dependencias externas: A veces un paso debe esperar a que ocurra algo fuera del sistema para poder continuar. Se abre una ventana de cambios. Una persona da su aprobación. Un dispositivo vuelve a estar accesible tras un reinicio. El motor debe admitir estados de espera con tiempos de espera máximos configurables y vías de escalado definidas para los casos en que el suceso esperado nunca se produce.
Las dependencias determinan en qué orden se ejecutan los pasos. La siguiente sección explica qué pone en marcha el flujo de trabajo.
Activación#
Un flujo de trabajo tiene que empezar de alguna manera. La activación responde a dos preguntas: qué hace que se inicie el flujo de trabajo y qué ocurre después desde el punto de vista de quien lo invoca.
Tres modos cubren todo el espectro, desde la activación manual hasta la totalmente automatizada:
Llamada a la API: El orquestador expone un punto de acceso Hypertext Transfer Protocol (HTTP). La llamada puede hacerla manualmente una persona del equipo de operaciones, un botón de la interfaz de usuario o un sistema externo cuando se produce un evento: un portal de servicios, la Fuente de Verdad o una cadena de CI/CD. El mecanismo es el mismo en todos los casos. Lo que cambia es quién inicia la llamada y si esta incluye datos estructurados sobre el evento. Es adecuado para cualquier cambio que deba iniciarse de inmediato, tanto si lo inicia una persona como si lo hace un sistema.
Activación programada: Una programación de tipo cron inicia el flujo de trabajo a la hora configurada. Comprobaciones de cumplimiento cada noche, auditorías de firmware semanales, informes de capacidad mensuales. La mayoría de los orquestadores admiten este modo de forma nativa. Algunos equipos usan un planificador externo que llama a la API del orquestador.
Cola de mensajes: El Orquestador consume mensajes de una cola (Kafka, NATS, RabbitMQ) e inicia un flujo de trabajo por cada mensaje. Así se desacopla el productor de eventos del orquestador: el productor publica y continúa con su trabajo, y el orquestador procesa los mensajes a su ritmo. Es adecuado para flujos de eventos de gran volumen en los que la garantía de entrega como máximo una vez que ofrecen las llamadas directas a la API resulta insuficiente.
La elección entre envío activo (llamada a la API) y recogida por parte del receptor (cola de mensajes, activación programada) depende del volumen y del grado de acoplamiento que puedas tolerar. Las llamadas a la API son más sencillas, pero requieren que el emisor conozca el punto de acceso del orquestador. Las colas de mensajes escalan mejor con flujos de gran volumen, pero añaden infraestructura que hay que gestionar.
Una vez iniciado el flujo de trabajo, quien lo invoca necesita saber qué respuesta esperar. Las opciones son los modos síncrono y asíncrono que ofrece el Ejecutor (Capítulo 6). Lo que cambia al pasar al nivel del flujo de trabajo es la duración. Un flujo de trabajo puede durar minutos u horas, por lo que el modo síncrono solo es adecuado para los flujos cortos, de menos de 30 segundos. La mayoría de los casos de uso interactivos empiezan en modo síncrono y alcanzan su límite la primera vez que un despliegue de 10 minutos agota el tiempo de espera del cliente de la API.
Todo flujo que afecte a más de unos pocos dispositivos se ejecuta de forma asíncrona: quien lo invoca recibe de inmediato un identificador de ejecución y después consulta el estado periódicamente o registra una función de retorno. Esto condiciona la forma en que las personas reciben información sobre el estado. La capa de Presentación (Capítulo 9) debe ofrecer puntos de acceso para consultar el estado y enviar notificaciones automáticas. Así, quienes usan la plataforma pueden seguir los flujos de trabajo que han iniciado sin mantener abierta una conexión HTTP. Un modo híbrido que inicia el flujo de forma asíncrona y permite bloquear la llamada en un punto de acceso de espera síncrona evita tener que elegir el modo de antemano.
Idempotencia en flujos de trabajo activados por eventos: Cuando Observabilidad dispara una alerta o la SoT emite un evento de cambio, varios sistemas pueden reaccionar a la vez. Una misma alerta puede dispararse dos veces y una cola de mensajes puede entregar el mismo mensaje más de una vez. Todo flujo de trabajo activado por eventos debe ser idempotente: ejecutarlo dos veces con los mismos datos de entrada produce el mismo resultado que ejecutarlo una sola vez. En la orquestación, esto suele requerir una clave de deduplicación: un identificador único que el orquestador comprueba antes de iniciar una nueva ejecución. Si ya hay una ejecución en curso con esa clave, rechaza la solicitud duplicada o ponla en cola.
Patrón de bucle cerrado (Closed-Loop Pattern): Observabilidad detecta una desviación (la configuración de un dispositivo se ha apartado de la intención) y dispara una alerta que inicia un flujo de trabajo de corrección. El Orquestador corrige por sí solo las desviaciones de bajo riesgo, como la de un servidor Network Time Protocol (NTP), y deriva a una persona las que podrían afectar al tráfico.
En el Capítulo 16 se desarrolla este bucle en detalle, y en el Capítulo 17 se amplía para abarcar un servicio cuya configuración es correcta pero que no funciona bien.
La activación determina cuándo se inicia un flujo de trabajo. La siguiente cuestión es si resiste todo lo que ocurre después.
Resiliencia y escala#
Esto es lo que distingue a un orquestador con el que creas prototipos de otro en el que confías a las 03:00 en producción. Que un flujo de trabajo se ejecute de forma fiable en condiciones ideales no te dice nada sobre si resistirá un reinicio del coordinador en plena ejecución, si sabrá gestionar que 40 de 800 dispositivos no superen las comprobaciones previas o si podrá degradarse de forma controlada cuando una dependencia nunca se resuelva. La próxima vez que tu orquestador se vea a prueba, no será en una demostración.
La resiliencia en la capa de ejecución, que se trata en el Capítulo 6, abarca la idempotencia y los reintentos en cada dispositivo: si un playbook falla en un dispositivo, vuelve a ejecutarlo en ese dispositivo. El Capítulo 6 deja para esta sección la durabilidad del flujo de trabajo en su conjunto. El escalado del propio orquestador, incluida la alta disponibilidad, el escalado horizontal de los procesos de trabajo y la carga de la base de datos durante las ejecuciones simultáneas, es una cuestión de infraestructura que se aborda en el Capítulo 12.
Seis patrones dotan de resiliencia a un flujo de trabajo. Un último apartado trata los fallos que se producen entre bloques.
Estado duradero#
Un motor que guarda en memoria el estado del flujo de trabajo lo pierde todo al reiniciarse. Puede valer para experimentar con scripts, pero se queda corto para la automatización en producción. Con un estado duradero, aunque falle el orquestador, queda constancia de hasta dónde ha llegado el flujo de trabajo: qué pasos han terminado, qué resultados han producido y cuáles quedan pendientes. Cuando el orquestador vuelve a estar operativo, reanuda el flujo donde lo dejó.
Las distintas soluciones ofrecen esa garantía de formas diferentes. Algunas, al reiniciarse, vuelven a ejecutar la función del flujo de trabajo a partir del historial de eventos registrado, de modo que el estado de las ejecuciones en curso sobrevive a una caída. Otras guardan el estado de cada trabajo en una base de datos y reanudan la ejecución desde el último paso confirmado.
Veámoslo con un ejemplo. Un despliegue se distribuye entre 800 conmutadores en lotes de 50 y el proceso del orquestador se detiene de forma inesperada tras el sexto lote. Al reiniciarse, el motor lee su propio registro: los lotes del primero al quinto están confirmados y el sexto se envió, pero no consta su resultado. No vuelve a ejecutar los cinco primeros. Vuelve a ejecutar el sexto, el único cuyo resultado desconoce.
Esa repetición solo es segura gracias a la idempotencia en el dispositivo: enviar la misma definición de VLAN a un conmutador que ya la tiene no cambia nada. El estado duradero en la capa de orquestación solo funciona gracias a la idempotencia en la capa de ejecución, y viceversa. Si el Ejecutor no es idempotente, por bien que se reanude el flujo, volverá a aplicar el cambio a dispositivos que ya lo habían aplicado, y descubrirás cuáles de tus playbooks son menos repetibles de lo que creías.
Estrategias de reintento#
No todos los fallos son iguales. Si un dispositivo ha dejado de responder unos instantes durante un reinicio del firmware, conviene reintentar la operación. Si ha devuelto un error de autorización permanente, no: reintentarlo no servirá de nada y puede activar las políticas de bloqueo.
La configuración de los reintentos debe distinguir entre:
- Fallos transitorios: cortes breves de red, tiempos de espera agotados en la API o contención temporal por los recursos. Reintenta la operación con intervalos de espera que aumenten exponencialmente.
- Fallos permanentes: credenciales incorrectas, dispositivo en modo de mantenimiento o configuración que no es aplicable a ese tipo de dispositivo. Interrumpe la operación y escala la incidencia.
La definición del flujo de trabajo debe especificar la política de reintentos de cada paso, porque una comprobación previa y un envío de configuración fallan de formas distintas. Una comprobación previa es de lectura, así que cinco intentos no cuestan nada y, si un dispositivo sigue sin responder, se omite sin que falle todo el flujo. El envío de configuración es una operación de escritura, así que solo se intenta una vez. Si se agota el tiempo de espera, puede que la configuración ya se haya aplicado. Al reintentarlo a ciegas, un dispositivo puede acabar con el cambio aplicado dos veces o solo a medias.
Reversión y compensación#
Cuando un flujo de trabajo de despliegue falla a mitad de la ejecución, tienes tres opciones: dejar el despliegue a medias, corregirlo manualmente o revertirlo de forma automática. En la mayoría de las operaciones de red, dejar el despliegue a medias es peligroso: los dispositivos que han recibido la nueva configuración se comportarán de forma distinta de los que no la han recibido.
El Patrón Saga (Saga Pattern) aborda este problema. Cada paso declara su transacción de compensación y, si el flujo completa los pasos anteriores a N y falla en el paso N, ejecuta las acciones de compensación en orden inverso, desde el paso N-1 hasta el 1. En un despliegue de VLAN, el flujo reserva la VLAN 412 en la SoT, el paso de despliegue la envía a los 24 conmutadores del edificio B y el paso de verificación posterior falla. La saga ejecuta la compensación del paso de despliegue, que elimina la VLAN de esos 24 conmutadores. A continuación, libera la reserva y solo entonces comunica el fallo.
Liberar la reserva no equivale a revertir la intención. La reserva asigna un identificador de VLAN a esa ejecución para impedir que dos ejecuciones obtengan el mismo. La intención de quien diseñó el cambio permanece en la Fuente de Verdad incluso si falla el despliegue, como explica el apartado Verificar, registrar o revertir del Capítulo 11.
Fíjate en el nivel al que actúa cada mecanismo. Si un dispositivo falla durante el paso de despliegue, el Ejecutor lo restaura con su propio mecanismo de reversión dentro de esa misma tarea. La saga actúa un nivel por encima, sobre pasos completos que ya habían terminado.
El Patrón Saga exige definir las transacciones de compensación de antemano, al diseñar el flujo de trabajo. Esto supone más trabajo al principio. La alternativa es descubrir a las 02:00 que tu red se encuentra en un estado que ningún manual de operaciones describe. El Listado 8.2 declara las acciones de compensación de cada paso.
# Every step that changes something declares how to undo it. The engine runs
# these in reverse order, and only for the steps that actually succeeded.
steps:
  - id: reserve-vlan-id
    run: sot.allocate_vlan
    compensate:
      run: sot.release_vlan
      args: { vlan_id: "{{ steps.reserve-vlan-id.output.vlan_id }}" }

  - id: deploy
    run: executor.apply
    compensate:
      run: executor.apply                            # the inverse of a declarative push
      args:                                          # is another declarative push
        state: absent
        scope: "{{ steps.deploy.output.changed }}"   # only the devices that took it
on_failure: halt_and_pageHay tres aspectos de esa definición en los que es fácil equivocarse. Un envío de configuración declarativa se compensa con otro envío declarativo que indica state: absent, no con una lista de comandos en orden inverso. De ahí que la idempotencia en el dispositivo sea un requisito previo. El scope comprende los dispositivos que realmente cambiaron, no todos los destinatarios del paso, porque revertir un dispositivo que nunca llegó a aplicar el cambio supone hacer un cambio que nadie pidió. Y la elección de on_failure: halt_and_page es deliberada. Si la propia reversión falla en un dispositivo, seguir adelante deja el parque de dispositivos en dos estados distintos sin que conste qué dispositivos están en cada uno. Eso es peor que detenerse con un problema conocido y una persona identificada como responsable.
Comprobación del estado de la red tras cada oleada#
Condicionar el paso a cada oleada a lo que demuestran las comprobaciones es uno de mis patrones favoritos para ganarme la confianza en despliegues críticos: superar un control aporta pruebas y evita depender del optimismo. El control entre oleadas es un paso del flujo de trabajo como cualquier otro, de ahí que se trate en este capítulo. Ejecuta una serie de aserciones y, si fallan, la saga compensa esa oleada y detiene el despliegue. Los marcos de pruebas encajan aquí por el mismo motivo: un conjunto de pruebas es un flujo de trabajo y su resultado determina qué rama seguir.
Los controles siguen una secuencia: primero la simulación, después una oleada piloto y luego oleadas cada vez mayores. Entre una y otra, una comprobación del estado de la red determina si se da paso a la siguiente. Si una oleada falla, se revierte. Las anteriores se mantienen o se revierten según lo estipulado en la política del cambio. El Capítulo 10 trata la simulación y el Capítulo 11, el funcionamiento del despliegue: cómo se determinan el tamaño y el alcance de las oleadas, cómo toma la NAP una instantánea de cada oleada antes de modificarla, en qué consiste un umbral de interrupción y cómo se hace cumplir la secuencia de avance.
Este apartado trata el propio control: qué se entiende por «buen estado» tras una oleada y cómo lo comprueba el flujo de trabajo. El Orquestador es responsable del control y de la decisión que se tome. La Observabilidad proporciona y analiza los datos que evalúa el control. Otra cuestión es si el dispositivo admite un determinado protocolo de interfaz o una ruta Yet Another Next Generation (YANG) concreta. El Capítulo 6 aborda esta cuestión para las interfaces de configuración, el Capítulo 7 para las rutas de recolección y el Capítulo 10 para la propia red.
Empieza por lo que tiene que demostrar una comprobación del estado de la red. Un control que solo comprueba si el envío de configuración ha devuelto una respuesta de éxito apenas demuestra nada. En el caso que abre el Capítulo 10, una versión del firmware respondió vlan-exists e indicó que había fallado un cambio que en realidad se había aplicado. Con la misma facilidad, un dispositivo puede indicar que un cambio se ha aplicado correctamente aunque no haya surtido efecto. Por eso, la comprobación siempre evalúa el estado observado, nunca el resultado de la escritura.
El Ejecutor ya define tres niveles de verificación, ordenados de menor a mayor tanto por lo que demuestran como por su coste: estado de la configuración, estado operativo y estado del servicio (Figura 6.3 del Capítulo 6). El control de cada oleada comprueba los tres niveles. Añade además una cuarta comprobación que solo importa cuando el siguiente paso es ampliar el alcance.
Estado de la configuración. El objeto que debía crear el flujo de trabajo existe y tiene los atributos previstos. La VLAN 412 figura en la tabla de VLAN de todos los conmutadores de la oleada, se llama
app-paymentsy está permitida en los enlaces ascendentes previstos.Estado operativo. El dispositivo ha hecho efectiva la configuración: la VLAN está activa, las interfaces que pertenecen a ella están operativas y el enlace troncal reenvía su tráfico.
Estado del servicio. Un host de la VLAN 412 llega a su puerta de enlace. Esta aserción demuestra que el cambio ha logrado lo que se pedía y es la que se omite con mayor frecuencia. Conviene tomarse en serio el motivo: hace falta un equipo de prueba dentro de la VLAN de destino y ese equipo cuesta más de lo que parece. Se necesita una dirección por VLAN, un host accesible o una pequeña máquina virtual por sede y monitorización de los propios equipos de prueba. También hace falta una excepción de seguridad: un host capaz de llegar a las puertas de enlace de todas las VLAN de todos los clientes cruza precisamente los límites de segmentación que esas VLAN deben imponer.
En la práctica, se busca una cobertura representativa en vez de exhaustiva: instala equipos de prueba en unas pocas sedes representativas, uno por clase de VLAN en vez de uno por VLAN, y aplícales la misma política de segmentación que a quienes vayan a conectarse allí.
Deja claro qué queda sin cubrir con esa solución de compromiso. Llegar a una SVI demuestra que funcionan el trayecto por el enlace troncal y la puerta de enlace. No demuestra que exista el ámbito DHCP ni que 802.1X autorice a un suplicante real a acceder a la nueva VLAN, y son esos los fallos que sufren los usuarios en una planta de un edificio del campus. Cuando sea imposible instalar un equipo de prueba, indícalo en la definición del control en vez de eliminar la aserción, para que todo el mundo sepa que el control certifica la configuración y no la conectividad.
Nada más ha cambiado. El cambio no ha alterado lo que ya funcionaba. Los contadores de errores de las interfaces se mantienen en los valores de referencia previos al cambio, ninguna interfaz que antes estuviera operativa ha caído y se mantienen tanto el número de sesiones Border Gateway Protocol (BGP) como el de vecinos del protocolo de árbol de expansión.
La cuarta comprobación es propia del control de la oleada, y conviene aclarar por qué las otras tres no la cubren. Los niveles 1 a 3 comprueban si el cambio ha funcionado. La cuarta comprueba si ha dejado de funcionar algo más. Solo puedes responder a esa pregunta si acotas el alcance y tienes una referencia conocida con la que comparar, y la oleada es el primer momento en que cuentas con ambas cosas. La respuesta también determina si es seguro ampliar el alcance, la única decisión que justifica la existencia de este control.
Algunas condiciones no pueden esperar al control, porque deben cumplirse durante la oleada, además de después. Son los invariantes del cambio, condiciones que se mantienen antes, durante y después de cualquier cambio, sea cual sea. Ya conoces la mayoría. La NAP conserva la vía de gestión del dispositivo, de ahí que, al enviar la configuración, se utilice un commit confirmado si la plataforma lo admite (Capítulo 10).
Cada campo tiene un único responsable, de modo que nunca hay dos procesos de escritura que entren en conflicto por él (Capítulo 5). Una oleada nunca deja fuera de servicio a los dos miembros de un par redundante, por lo que cada sede conserva su capacidad mínima de servicio. Incluye los invariantes en la definición del flujo de trabajo junto a las aserciones del control y compruébalos tanto antes de dar paso a la oleada como después de aplicarla.
Ejecuta las cuatro comprobaciones una vez transcurrida la ventana de convergencia, nunca justo después de enviar la configuración. Una red es un sistema distribuido y necesita tiempo para estabilizarse. Esa ventana forma parte de la especificación del control.
La cuarta comprobación necesita una referencia, y definirla supone la mayor parte del trabajo. Además, ese trabajo nunca termina. Cada incidente añade una comprobación que las oleadas posteriores deberán superar para evitar que se repita el problema. Toma la lectura justo antes de que empiece la oleada, de la misma fuente que consultará el control después, y haz la comparación cuando haya transcurrido la ventana de convergencia.
Distingue luego los dos tipos de comprobación, porque requieren reglas distintas. Para el número de vecinos y el estado activo o inactivo de una interfaz, el criterio es binario. Cualquier diferencia es un fallo, y punto. Con los contadores de errores no ocurre lo mismo. El contador de un puerto de acceso de un campus puede permanecer una hora en cero errores de CRC y luego incrementarse por motivos ajenos al cambio.
Por eso, el control compara la tasa de errores durante la ventana con la misma tasa medida antes, con una tolerancia que se fija para cada clase de contador y se recoge en la definición del control. Un control que exija una variación nula en los contadores de errores fallará por el ruido de las mediciones, y un control que falle por ese motivo acabará por ignorarse (he visto muchos controles caer en desuso por esta razón).
Dónde se ejecutan las aserciones importa tanto como lo que comprueban. Por defecto, lo más adecuado es consultar la capa de Observabilidad. La telemetría de los distintos fabricantes ya está normalizada, de modo que una misma definición del control sirve para todos los fabricantes del parque de dispositivos. Los marcos de pruebas que consultan directamente los dispositivos cubren lo que queda fuera del alcance de la Observabilidad, sobre todo las comprobaciones que requieren un comando operativo y para las que no hay una vía de telemetría.
Queda la pregunta que determina si merece la pena tener un control. ¿Qué hace cuando no recibe respuesta alguna? La ausencia de datos significa que la oleada ha fallado. No cuenta como un resultado satisfactorio, un reintento ni una advertencia. El control suele consultar el estado a través de la red que el cambio acaba de modificar. Por eso, si una oleada ha dejado inoperativa la VRF de gestión en cincuenta conmutadores, el control recibe exactamente lo mismo que si la telemetría aún no hubiera llegado: nada. Si el silencio cuenta como éxito, el control da por buena precisamente la oleada que más necesita detener, y lo hace en silencio, sin que el equipo se dé cuenta.
Para distinguir ambos casos basta con aplicar una regla. Si la telemetría solo se ha retrasado, llegará dentro de la ventana de convergencia, así que el control espera hasta que esta termina antes de emitir un resultado. Si la telemetría no va a llegar nunca, la espera no resuelve nada, y el control debe distinguir entre un dispositivo que comunica un valor inaceptable y otro que no comunica valor alguno. Por eso, el control comprueba primero el número de dispositivos. Todos los dispositivos incluidos en la oleada deben figurar en el conjunto de resultados antes de que se evalúe ningún umbral. Si una oleada de 50 dispositivos devuelve 46 filas, el resultado es un fallo con cuatro nombres, y esos cuatro nombres son el dato más útil que proporcionará el control en todo el día.
Dos marcos de pruebas cubren estas necesidades. Con cualquiera de ellos, el equipo puede expresar el estado esperado tras el cambio mediante aserciones ejecutables que se conservan bajo control de versiones junto al flujo de trabajo. Así, el control se revisa igual que el cambio que supervisa.
- pyATS es un marco de pruebas para dispositivos. Sus analizadores específicos de cada plataforma convierten la salida de los comandos en datos estructurados, y un motor de comparación identifica las diferencias entre el estado anterior y el posterior al cambio. La biblioteca de analizadores es el motivo para elegirlo, porque ya cubre cientos de combinaciones de plataformas y comandos. El libro de Capobianco y Wade, citado en las referencias de este capítulo, trata pyATS en profundidad.
- Robot Framework es un marco de pruebas basado en palabras clave. Sus pruebas se leen como frases, y las palabras clave para trabajar con los dispositivos suelen proceder de una pequeña capa de Python que envuelve una biblioteca como NAPALM. Elígelo cuando otras personas, además de quienes escribieron los controles, deban poder confiar en ellos.
Ambos marcos se mencionan únicamente como ejemplos para ilustrar la explicación, sin que ello suponga una recomendación.
Una prueba mínima de pyATS que comprueba la presencia de una VLAN tras el despliegue:
from pyats import aetest

class VlanValidation(aetest.Testcase):
    @aetest.test
    def verify_vlan_exists(self, device):
        output = device.parse('show vlan brief')
        assert '412' in output['vlans'], f"VLAN 412 missing on {device.name}"

    @aetest.test
    def verify_vlan_name(self, device):
        output = device.parse('show vlan brief')
assert output['vlans']['412']['name'] == 'app-payments'device.parse depende de que Genie disponga de un analizador para ese comando en esa plataforma. Si no existe, la propia prueba analiza la salida o consulta el mismo estado a través de una interfaz estructurada.
En Robot Framework, la misma comprobación se lee como una frase. Quien deba dar su aprobación puede entender qué comprueba el control aunque no lo haya escrito. La comprobación utiliza una pequeña biblioteca de palabras clave que encapsula NAPALM:
*** Settings ***
Library    Collections
Library    NapalmKeywords.py    # a thin wrapper exposing NAPALM getters as keywords

*** Variables ***
@{DEVICES}    sw-b-acc-01    sw-b-acc-02    sw-b-dst-01

*** Test Cases ***
VLAN 412 Is Present On All Switches After Deployment
    FOR    ${hostname}    IN    @{DEVICES}
        Connect And Check VLAN    ${hostname}    ${412}    app-payments
    END

*** Keywords ***
Connect And Check VLAN
    [Arguments]    ${hostname}    ${vlan_id}    ${vlan_name}
    Open Device    ${hostname}
    ${vlans}=    Get VLANs
    Dictionary Should Contain Key    ${vlans}    ${vlan_id}
    Should Be Equal    ${vlans}[${vlan_id}][name]    ${vlan_name}
[Teardown] Close DeviceSi encadenas los controles, obtienes la estructura de un despliegue progresivo, tal como muestra la Figura 8.4, incluido lo que ocurre cuando falla una oleada.
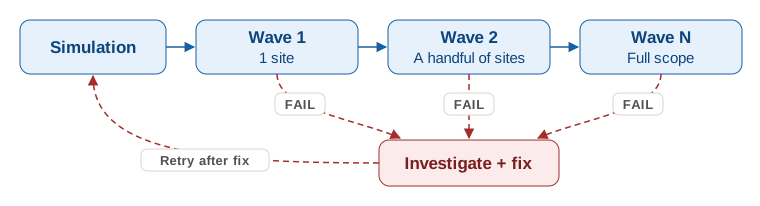
Cuando se despliega un servicio de VLAN de campus en todos los edificios, las oleadas se organizan por edificios. Primero se ejecuta la simulación, después se despliega el servicio en un solo edificio, luego en dos edificios más y, por último, en el resto del parque de dispositivos. Un equipo que desplegara el mismo flujo de trabajo en 100 centros de datos seguiría esta secuencia: simulación, 1 sede piloto, 2 sedes, 4, 8, 16 y, por último, las demás.
La estructura es la misma a ambas escalas. En cada oleada se ejecuta el mismo control con un alcance mayor. Si la oleada 4 pone de manifiesto algo que la simulación no pudo detectar, como un comportamiento propio de un hardware concreto o un estado particular de una sede, el despliegue se detiene en la oleada 4, sin llegar a la sede 100.
El despliegue progresivo es lento a propósito. Cada oleada lleva tiempo. Hay que esperar los resultados de la validación, revisar los fallos y decidir si se continúa. A los equipos acostumbrados a desplegarlo todo de una vez, el proceso les parece demasiado lento hasta que la primera oleada detecta un defecto que habría afectado a los 800 conmutadores a la vez. Más vale ir despacio y sobre seguro que equivocarse por ir deprisa.
¿Qué tamaño debería tener cada oleada? La Figura 8.5 muestra el equilibrio entre la duración del despliegue y la exposición en la ampliación de 800 conmutadores, suponiendo que en cada oleada transcurran 30 minutos desde el envío de la configuración hasta que se supera el control. Las curvas son ilustrativas.
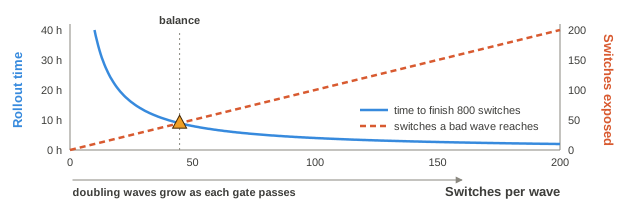
No hay un único tamaño correcto. Con oleadas de 10 conmutadores, el impacto de un cambio defectuoso es reducido, pero el despliegue se alarga hasta las 40 horas. Con oleadas de 200, el despliegue termina en 2 horas, pero una sola oleada defectuosa llega a 200 conmutadores antes de que el control la detenga. Por eso se duplica el tamaño de las oleadas. Las primeras se sitúan a la izquierda del gráfico, cuando la confianza aún es baja, y cada control superado permite que la siguiente oleada avance un paso hacia la derecha.
Control de la concurrencia#
Distribuir el trabajo entre 800 dispositivos a la vez saturará la mayoría de las capas de ejecución. Controlar la concurrencia desde la capa de orquestación implica lo siguiente:
- Ejecución por lotes: ejecuta la tarea en N dispositivos en paralelo, espera a que termine el lote y pasa a los N siguientes. Así controlas el alcance del impacto. Si una configuración defectuosa pone de manifiesto un problema, aún no habrás tocado los 800 dispositivos.
- Limitación del ritmo de ejecución: la capa de ejecución tiene unos límites y el Orquestador debe respetarlos. Evita que la cola del Orquestador se llene con 800 trabajos simultáneos.
- Umbrales de éxito parcial: define qué se considera un éxito cuando se trabaja a escala. Configurar correctamente 798 de 800 dispositivos podría ser suficiente para continuar. Si solo se configuran bien 600 de 800, el flujo de trabajo debería detenerse y escalar el problema.
La elección del umbral exige criterio y depende del cambio, no de la herramienta. En el ejemplo de este capítulo, el umbral forma parte de la definición del flujo de trabajo, que lo pasa a la tarea de ejecución. Cuando una NAP ejecuta muchos flujos de trabajo, el Capítulo 11 traslada el umbral a una política de despliegue común a todo el parque de dispositivos, que lo fija en función del nivel de riesgo del cambio. Así se evita que cien flujos de trabajo definan cien umbrales distintos. Tres preguntas bastan para decidir en la mayoría de los casos:
- ¿Qué ocurre en la práctica con un dispositivo que se queda atrás? Que un conmutador se quede sin una etiqueta de monitorización no afecta a su funcionamiento. Que se quede sin la mitad de una ACL abre un agujero de seguridad.
- ¿Es poco costoso aplicar una corrección hacia delante a los dispositivos que se han quedado atrás? ¿O se agrava la incoherencia con cada hora que persiste?
- ¿Se puede revertir el cambio en los dispositivos en los que sí se ha aplicado?
Un cambio descriptivo o de monitorización puede darse por bueno con un 95 % de éxito y completarse en los dispositivos restantes en la siguiente pasada. Un cambio de seguridad o de reenvío debería aplicarse por completo o no aplicarse en absoluto, porque una política aplicada a medias deja la red en un estado que nadie ha diseñado. Sea cual sea la cifra que elijas, especifica qué ocurrirá con los dispositivos que queden fuera del umbral: si se dejarán como están y se abrirá una incidencia, si se programarán reintentos o si se revertirá el cambio junto con el del resto. Un umbral que no indica cómo proceder después solo traslada el problema a la bandeja de entrada de otra persona.
Un solo proceso de escritura por dispositivo. Agrupar los cambios en lotes limita la parte de la red que un flujo de trabajo modifica de una vez. No impide que dos flujos de trabajo modifiquen el mismo dispositivo a la vez, como ocurre cuando coinciden el despliegue de una VLAN y la conciliación de una desviación de la configuración, o las solicitudes de dos equipos sobre un conmutador compartido.
Antes de que un paso escriba en un dispositivo, el Orquestador obtiene un bloqueo temporal sobre él. El bloqueo caduca para que una ejecución que se interrumpa por un fallo no pueda retener el dispositivo indefinidamente. Mantén el bloqueo solo mientras dure la interacción con el dispositivo y libéralo antes de validar el cambio. Así, el siguiente flujo de trabajo solo espera unos segundos y no lo que dura toda la verificación. Si un flujo de trabajo no consigue el bloqueo, espera o termina con un fallo controlado. Nunca escribe a la vez que otro. Los bucles cerrados de la Parte 5 siguen la misma regla. Un cambio manual de emergencia pausa la conciliación automática en los dispositivos que modifica (Capítulo 16).
Tiempo de espera e Interruptor de circuito (Circuit Breaker)#
Los flujos de trabajo que se quedan esperando indefinidamente son un problema de fiabilidad. Todo paso que pueda quedarse bloqueado debe tener un tiempo de espera configurado. Si se agota ese tiempo, el flujo de trabajo debe tener definida la acción que corresponde: escalar el problema, omitir el paso o abortar la ejecución.
El patrón interruptor de circuito amplía este mecanismo a los fallos repetidos: si un paso falla más de N veces en un intervalo determinado, deja de intentarlo y genera una alerta. Así se evita que un solo dispositivo inaccesible mantenga un flujo de trabajo abierto durante horas. El Capítulo 12 aplica a escala los tiempos de espera, las esperas crecientes entre reintentos y los interruptores de circuito en todos los puntos de interacción de la NAP.
Resiliencia en las interacciones entre bloques#
Los patrones anteriores abordan los fallos que se producen durante la ejecución dentro del propio Orquestador mediante el estado persistente, los reintentos, la reversión, los controles entre oleadas, la gestión de la concurrencia y los tiempos de espera. Pero los flujos de trabajo también fallan en las interacciones entre bloques, y esos fallos requieren un tratamiento distinto.
Si se agota el tiempo de espera cuando el Orquestador llama a la API de la SoT, la respuesta adecuada es distinta de la que corresponde cuando el Ejecutor comunica un fallo de dispositivo. Si se agota el tiempo de espera de la SoT, el Orquestador no puede comprobar que la intención que está a punto de desplegar siga vigente. Si continúa con los datos de la caché, corre el riesgo de aplicar una configuración desactualizada.
Lo correcto suele ser abortar la ejecución y volver a intentarlo. Si un evento de la capa de Presentación, como un webhook de aprobación, nunca llega, puede que se haya rechazado la solicitud, que la integración esté averiada o que el mensaje se haya perdido. Cada caso requiere una vía de recuperación distinta: la falta de aprobación no es un fallo transitorio que justifique reintentos indefinidos.
La definición del flujo de trabajo debe clasificar explícitamente los fallos en las interacciones entre bloques:
- Dependencia no disponible (SoT, Observabilidad): el flujo de trabajo no puede continuar de forma segura. Finaliza la ejecución de forma controlada, emite un evento de diagnóstico y evita reintentar la operación con datos desactualizados.
- Dependencia degradada (lectura parcial de la SoT, retraso en Observabilidad): el flujo de trabajo puede continuar si se reconoce expresamente que opera con un grado de confianza menor. Registra el estado degradado antes de continuar.
- Fallo de un bloque posterior (el Ejecutor ha devuelto un error o el Recolector no ha devuelto datos): aplica los patrones de reintento y reversión anteriores, pero clasifica con precisión el origen del fallo para que tanto la alerta como el registro de auditoría identifiquen el bloque correcto.
Un flujo de trabajo que trate todos los fallos como errores de dispositivo que admiten reintentos volverá a intentar la operación con una integración de la SoT averiada hasta agotar su presupuesto de reintentos y avisar a la persona de guardia con un diagnóstico equivocado. La clasificación de los fallos en las interacciones entre bloques marca la diferencia entre un flujo de trabajo que detecta el fallo y se detiene enseguida y otro que falla sin que quede claro el motivo.
Clasificar los fallos solo sirve si alguien puede consultarlos después. De eso se ocupa la siguiente funcionalidad.
Trazabilidad#
Cuando algo falla a las 03:00, hay dos preguntas que exigen una respuesta inmediata: ¿en qué estado se encuentra el flujo de trabajo y quién lo inició?
Cuando el equipo de auditoría haga preguntas tres meses después, el mismo registro debe permitir responderlas. ¿Qué se ejecutó y con qué versión de la definición del flujo de trabajo? ¿Qué datos recibió cada paso como entrada, qué salida produjo y cuál fue el resultado final?
Son preguntas distintas con grados de urgencia distintos, pero las respuestas proceden de la misma fuente: el estado del flujo de trabajo y su registro de auditoría.
La trazabilidad es un requisito transversal de la NAP. La Fuente de Verdad registra cada cambio en la intención y Observabilidad registra cada cambio en el estado de la red. Pero ninguno de esos registros te dice quién inició un flujo de trabajo, en qué orden se ejecutaron los pasos ni qué dio lugar al resultado. Solo el registro de auditoría del Orquestador aporta esa información. Como el Orquestador coordina todos los demás bloques, su traza es la referencia para saber todo lo que ocurrió en el conjunto del sistema de automatización a raíz de un evento concreto.
El estado del flujo de trabajo es distinto del estado de la red. Conviene tener presente esta distinción. En el Capítulo 7, «estado» se refería al estado operativo de la red: contadores de las interfaces, sesiones BGP y unidad central de procesamiento (CPU) de los dispositivos. En el Capítulo 4, «estado» se refería al estado deseado almacenado en la SoT. En el Capítulo 6, «estado de ejecución» se refería al progreso de una tarea: en qué dispositivos se aplicó el cambio y en cuáles falló. Aquí, «estado» se refiere al estado del flujo de trabajo: de todos los pasos de la ejecución, cuáles han terminado, cuáles siguen en curso, cuáles han fallado y qué ha producido cada uno. El Ejecutor sigue el progreso de los dispositivos dentro de cada paso y el Orquestador sigue el progreso de los pasos.
Ambos estados están relacionados (un paso del flujo de trabajo produce cambios en el estado de la red que Observabilidad valida después), pero se almacenan de forma distinta, se consultan de forma distinta y sirven para fines distintos. No los confundas.
Cada ejecución de un flujo de trabajo pasa por los estados de una máquina de estados del flujo de trabajo definida, como muestra la Figura 8.6:
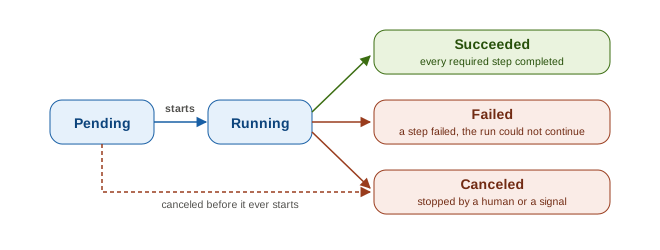
- Pendiente: se ha recibido la solicitud de ejecución, pero la ejecución aún no ha comenzado
- En curso: se están ejecutando los pasos
- Completada con éxito: todos los pasos obligatorios han terminado correctamente
- Fallida: un paso ha fallado y el flujo de trabajo no ha podido continuar
- Cancelada: una persona o una señal externa ha detenido la ejecución
Cada paso del flujo de trabajo tiene su propio estado. Si una ejecución se distribuye entre varios dispositivos y solo tiene éxito en parte de ellos, debe mostrar exactamente en cuáles se completó la operación, en cuáles falló y cuáles se omitieron. El mensaje «El flujo de trabajo ha fallado» no sirve de mucho sin el desglose por dispositivo.
A efectos de auditoría, el registro de cada ejecución de un flujo de trabajo debe contener, como mínimo:
- Quién o qué inició la ejecución: la identidad de la persona, el nombre del sistema o el ID del evento que la desencadenó
- Cuándo comenzó y cuándo terminó
- Qué versión de la definición del flujo de trabajo se ejecutó
- Todos los datos de entrada que recibió el flujo de trabajo
- La salida de cada paso
- El resultado final
El registro debe dejar constancia de cualquier manipulación: no debe ser posible editarlo a posteriori. En entornos regulados, el registro de auditoría del Orquestador es el registro de gestión de cambios. Si este registro se puede alterar, el sistema de gestión de cambios no es fiable (más detalles en el Capítulo 13).
Operación bajo control de cambios
Al servir de registro de cambios, el Orquestador debe someter la aprobación a reglas que la propia herramienta desconoce. Tres de ellas aparecen en casi todas las políticas de cambios:
Quién puede aprobar. La separación de funciones suele impedir que apruebe el cambio la misma persona que inició la ejecución y, a menudo, también quien escribió el flujo de trabajo. El Orquestador dispone de ambas identidades, así que puede hacer cumplir la regla en vez de dejarla en manos de las buenas prácticas de cada persona.
Qué ocurre si se agota el tiempo de espera. Resulta cómodo que el control de aprobación dé paso al cambio automáticamente cuando nadie responde, pero en un entorno regulado es indefendible: un cambio ha llegado a producción sin que nadie lo apruebe. Define explícitamente para cada flujo de trabajo qué debe ocurrir si se agota el tiempo de espera. Hay tres opciones (continuar, abortar o remitir la solicitud a una segunda persona con autoridad para aprobarla). Registra qué acción se ejecutó. La indicación «Aprobado al agotarse el tiempo de espera» debe figurar en el registro, sin que nadie tenga que deducirlo de la ausencia de una aprobación.
Qué cambios se hacen al margen del flujo de trabajo. Habrá noches en las que alguien configure un dispositivo a mano. El Capítulo 11 trata la vía del procedimiento de acceso de emergencia y el Capítulo 13 aborda las reglas que la rigen. Aquí lo importante es que el Orquestador registre como evento que se ha eludido el flujo de trabajo, de modo que el registro de auditoría muestre esa discontinuidad en vez de pasarla por alto.
La mayoría de las herramientas de orquestación escriben los registros de auditoría en una base de datos que ellas mismas controlan. Esto puede bastar, según tus requisitos de cumplimiento. Algunas organizaciones exportan los registros de auditoría de la orquestación a un sistema externo que solo permite añadir entradas (un SIEM o un almacén de registros de escritura única). Así evitan que los manipule alguien con acceso a la base de datos, incluida cualquier persona que pueda ejecutar consultas en la base de datos del propio orquestador.
Todo esto presupone que la propia definición del flujo de trabajo es correcta. Mantenerla así exige el mismo trabajo que mantener cualquier software en producción.
Gestión del ciclo de vida de los flujos de trabajo#
Desde el punto de vista de la arquitectura, un flujo de trabajo que configura 800 conmutadores en producción es software de producción. El reto está en cómo almacenas, validas y promueves las definiciones de los flujos de trabajo para que su lógica sea tan fiable como la infraestructura que gestionan.
La definición del flujo de trabajo codifica decisiones: qué comprobaciones previas ejecutar, qué hacer si un dispositivo es inaccesible y qué se considera un resultado satisfactorio. Modificarla sin cuidado cambia lo que ocurrirá en cada dispositivo sobre el que actúe el flujo de trabajo la próxima vez que se ejecute.
He visto equipos que, sin darse cuenta, dejaron inservibles flujos de trabajo en producción al editar su definición directamente en la interfaz de usuario de la herramienta de orquestación. Nadie lo advirtió hasta que la siguiente ejecución llegó a un tipo de dispositivo que el paso modificado no gestionaba correctamente. El cambio hecho desde la interfaz no pasó por ninguna revisión ni prueba, y no había forma de revertirlo.
Con las definiciones gestionadas en Git, las definiciones de los flujos de trabajo se guardan bajo control de versiones. En cada despliegue, la herramienta de orquestación toma la definición de Git y descarta como fuente las modificaciones locales de la interfaz de usuario. Así dispones de un historial, un proceso de revisión y la posibilidad de volver a cualquier versión anterior.
Hay dos formas habituales de promover una nueva versión de un flujo de trabajo:
Versiones azul/verde del flujo de trabajo: mantén dos versiones del flujo de trabajo en producción. La versión estable actual gestiona todos los flujos de trabajo activos y la nueva versión recibe las nuevas ejecuciones tras un periodo de validación. El tráfico solo se transfiere cuando se ha demostrado que la nueva versión es estable.
Despliegue canario: al principio, la nueva versión del flujo de trabajo solo se encarga de unas pocas ejecuciones. En un flujo de trabajo de actualización de firmware, podrías aplicar la nueva versión a 10 dispositivos antes de extenderla a todo el parque de dispositivos. Los problemas salen a la luz cuando el despliegue alcanza los 10 dispositivos, sin tener que llegar a los 800.
Ambas estrategias se combinan con pruebas de la definición antes de que llegue a producción:
- Modo de simulación: ejecuta el flujo de trabajo con datos de entrada reales, pero omite los pasos que modifican la red. Comprueba que la lógica produce la secuencia de acciones esperada.
- Entorno de preproducción: un subconjunto de dispositivos dedicado a probar los cambios en los flujos de trabajo antes de ejecutarlos en producción.
- Ejecución en sombra: ejecuta la nueva versión en paralelo con la actual, pero descarta sus resultados. Compara las salidas para detectar divergencias antes de pasar a la nueva versión.
Cuatro reversiones, cuatro responsables. Revertir la definición de un flujo de trabajo significa volver a una versión anterior de su lógica: cambias la referencia de Git, vuelves a desplegar la definición y la siguiente ejecución utiliza la versión anterior. Es la cuarta operación que la parte 2 denomina reversión. La Figura 8.7 muestra las cuatro juntas porque, cuando un equipo las confunde, acaba revirtiendo lo que no corresponde.
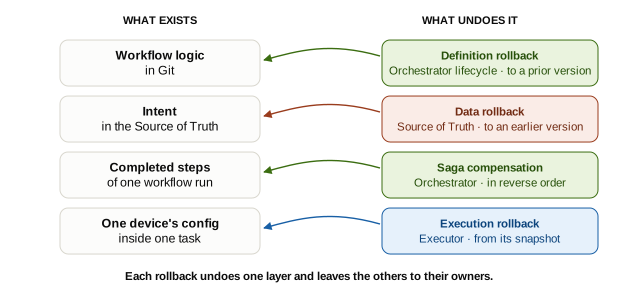
Cada una tiene su propio desencadenante y deja intactas las demás capas:
- Reversión de la definición: se aplica cuando una versión del flujo de trabajo es defectuosa. Cambia lo que hará la siguiente ejecución y deja intacto todo lo que ya se ha desplegado.
- Reversión de los datos: responde a una decisión de quien opera la red o del Orquestador tras un despliegue fallido. Devuelve la intención a una versión anterior y deja la red tal como está hasta que un flujo de trabajo vuelva a desplegarla.
- Compensación de la Saga: se activa cuando falla un paso posterior o cuando los fallos superan el umbral fijado para el cambio. Deshace los pasos completados y conserva la intención en la Fuente de Verdad para que la siguiente ejecución vuelva a intentarlo.
- Reversión de la ejecución: se activa cuando un dispositivo falla durante una tarea. Restaura ese dispositivo a partir de la instantánea previa al cambio y deja intactos los dispositivos y los pasos en los que todo ha ido bien.
Lee dos veces qué deja intacto cada una.
Todas las funciones anteriores presuponen que alguien ha definido el flujo de trabajo de antemano. Hay un modelo que prescinde de ese supuesto.
Orquestación con agentes#
Esta sección presenta la red autónoma que se construye en el Capítulo 18 desde la perspectiva del Orquestador. La coordinación con agentes que vimos en la sección Motor de flujos de trabajo funciona de otra manera: en lugar de seguir un DAG predefinido, un agente de IA que se apoya en Modelos de lenguaje de gran tamaño (LLM) recibe un objetivo y determina la secuencia de acciones en tiempo de ejecución.
El agente observa el estado actual a través de los bloques de Observabilidad y de la SoT, razona sobre qué acción permite cerrar la brecha con el objetivo, invoca al Ejecutor y vuelve a observar el estado para verificar el resultado. Si el resultado difiere de lo esperado, vuelve a razonar. La lógica de decisión no está codificada en la definición de un flujo de trabajo, sino en el propio razonamiento del modelo.
Una interfaz como Model Context Protocol (MCP) hace posible este funcionamiento en toda la NAP. Cada bloque arquitectónico expone un servidor MCP con un conjunto definido de herramientas que el agente puede invocar durante su ciclo de razonamiento. El servidor de la SoT permite consultar los dispositivos y la intención. El de Observabilidad permite consultar el estado y comprobar el cumplimiento. El del Ejecutor permite iniciar trabajos y consultar periódicamente su estado. El agente invoca estas herramientas en la secuencia que requiera la situación, dentro de los límites que fija quien diseña el flujo de trabajo, sin que esta persona tenga que programar de antemano todas las combinaciones posibles. Estos agentes se ejecutan dentro de la NAP y el Orquestador los gestiona como a cualquier otro proceso de trabajo.
Los flujos de trabajo basados en DAG y la orquestación con agentes son compatibles. Los flujos de trabajo basados en DAG son la opción adecuada para operaciones rutinarias y bien definidas: despliegues de VLAN, comprobaciones de cumplimiento y actualizaciones de firmware. Son operaciones frecuentes, requieren registros de auditoría predecibles y no deberían depender del razonamiento de un LLM. La capa de agentes se ocupa de las situaciones nuevas: medidas correctivas ante incidentes, investigación de anomalías y situaciones en las que solo es posible determinar la secuencia de acciones adecuada una vez que se comprende el estado actual. Los dos enfoques pueden coexistir en una misma NAP: cuando una situación no encaja en ningún patrón conocido, el DAG deriva la ejecución a un flujo de trabajo con agentes.
Esta sección presenta el patrón. El Capítulo 18 desarrolla toda la arquitectura a partir de él: cómo colaboran los agentes y dónde se ejecutan, cómo los gestiona la NAP como a un equipo, con identidades, niveles de riesgo y aprobaciones, y cómo un agente se gana el paso del Modo Sombra (Shadow Mode) a producción.
Esas cinco funciones y la variante con agentes describen lo que debe hacer un Orquestador. Las herramientas que lo hacen adoptan enfoques muy distintos.
Panorama de soluciones#
El mercado de herramientas de orquestación abarca una amplia gama de modelos, desde plataformas específicas para redes hasta motores de flujos de trabajo de propósito general. La pregunta rara vez es «¿cuál es la mejor?» y casi siempre es «¿cuál encaja con nuestra forma de trabajar?».
Soluciones basadas en Ansible
- AWX / Ansible AAP: plantillas de flujos de trabajo en YAML, con la interfaz de usuario como vía principal de trabajo. El Orquestador y el Ejecutor forman un solo sistema: los trabajos de Ansible se gestionan de forma nativa, sin capa de traducción, y la gestión de Control de acceso basado en roles (RBAC), las credenciales y el inventario está unificada. Es la opción más directa si ya utilizas Ansible como capa de ejecución.
Soluciones específicas para redes
- Itential: un entorno visual de desarrollo con poco código, diseñado para las operaciones de red, con adaptadores listos para usar con ITSM, IPAM y dispositivos de distintos fabricantes. Para equipos de redes empresariales que necesitan integrar varios sistemas sin escribir código a medida.
Motores de flujos de trabajo de propósito general
- Prefect: los flujos de trabajo son funciones de Python con decoradores. Como cada flujo es software, se prueba, se versiona y se observa igual que el código de una aplicación. Para equipos que se manejan bien con Python y quieren aplicar prácticas de ingeniería de software a la orquestación.
- Temporal: un motor de ejecución duradera. Si se produce una caída en plena ejecución, el flujo de trabajo se recupera reproduciendo su historial de eventos registrados. La compensación de la Saga es un mecanismo nativo del motor. Para flujos de larga duración (por ejemplo, actualizaciones de firmware y despliegues a gran escala) en los que tanto la ejecución parcial como la reversión deben ser fiables.
- Windmill: una herramienta ligera centrada en scripts. Cada nodo del flujo de trabajo es un script independiente que puede escribirse en cualquier lenguaje. Para equipos pequeños que quieren flexibilidad para definir su propia lógica y pocos componentes que mantener en funcionamiento.
Las herramientas que se enumeran aquí son ejemplos con fines explicativos, no recomendaciones. Cada una tiene su propia arquitectura, con distintas ventajas e inconvenientes. Evalúalas teniendo en cuenta las capacidades de tu equipo, las herramientas que ya utiliza y sus restricciones operativas.
Todas estas herramientas plantean la misma cuestión de arquitectura: ¿tu herramienta de orquestación también hace de motor de ejecución o son componentes independientes? AWX/AAP reúne ambos en uno. Prefect, Temporal y Windmill son orquestadores que invocan herramientas de ejecución independientes (Ansible, scripts a medida o API). El modelo integrado es más sencillo de operar. El modelo separado te da más flexibilidad para sustituir el motor de ejecución de forma independiente. El Capítulo 2 presentó las ventajas e inconvenientes de esta decisión en Acoplamiento mínimo, cohesión máxima.
En AWX/AAP, las plantillas de flujos de trabajo hacen de Orquestador y las plantillas de trabajos individuales de Ansible hacen de Ejecutor, aunque ambas se ejecuten dentro del mismo producto. Un equipo que concentra toda la lógica en las plantillas de trabajos y utiliza las plantillas de flujos de trabajo solo para encadenarlos ha construido, en la práctica, un Orquestador a partir de primitivas de ejecución.
Pierde visibilidad, la posibilidad de configurar los reintentos, opciones de reversión y las funciones propias del flujo de trabajo (por ejemplo, el registro de auditoría, los puntos de aprobación y los mecanismos para lanzar notificaciones). En cambio, un equipo que incorpora lógica de negocio a las plantillas de flujos de trabajo (bifurcaciones condicionales basadas en datos externos o selección dinámica del inventario) sí utiliza AWX como orquestador. La limitación surge cuando el diseño no separa la Orquestación de la Ejecución.
Estas herramientas comparten muchas capacidades: tanto Prefect como Windmill ejecutan Python, y tanto Prefect como Temporal pueden invocar Ansible. En la práctica, si tu equipo trabaja principalmente con Ansible y quiere añadir el mínimo de componentes, las plantillas de flujos de trabajo de AWX son la opción natural. Si quieres definir los flujos de trabajo en código, poder probarlos y aplicar prácticas de ingeniería de software, tanto Prefect como Windmill sirven, cada uno con un modelo operativo distinto. Si el requisito principal es que la ejecución perdure ante un fallo parcial, el modelo de reproducción de eventos de Temporal está diseñado expresamente para ello. Toma estas indicaciones como punto de partida para tu evaluación, no como una respuesta definitiva.
Basta de teoría. Veamos el bloque completo en acción con un servicio de la red de campus que hemos seguido a lo largo de la parte 2.
Ejemplo de implementación#
Hasta este capítulo hemos visto el ejemplo del campus por partes. En el Capítulo 4 y el Capítulo 5 se modeló y almacenó la intención: el identificador de la VLAN, la subred y los switches de destino. En el Capítulo 6, el Ejecutor generó a partir de plantillas la configuración correspondiente a esa intención para cada plataforma y la envió a los switches del campus. En el Capítulo 7, validamos el despliegue y empezamos a monitorizar el servicio.
Lo que nunca abordamos fue quién coordina todo eso. En cada capítulo dábamos por supuesto que alguien del equipo de ingeniería ejecutaba cada paso manualmente. Aquí hacemos explícito ese supuesto y sustituimos a esa persona por un flujo de trabajo.
Escenario: El equipo de aplicaciones ha solicitado un nuevo segmento de aplicaciones: la VLAN app-payments, con el prefijo 10.12.4.0/24, que debe desplegarse en los switches de acceso y distribución del edificio B en las tres plataformas del campus. La solicitud llegó a través de un portal ITSM y acaba de recibir la aprobación definitiva. Esa aprobación activa un webhook, el Orquestador lo recibe y se inicia el flujo de trabajo de despliegue del servicio de VLAN.
Requisitos:
- Validar que la intención de la Fuente de Verdad esté completa antes de que se actúe sobre ningún dispositivo
- Ejecutar en paralelo las comprobaciones previas en todos los switches de destino y detener el flujo si fallan demasiados
- Esperar la aprobación de una persona, con un tiempo de espera máximo definido y dejando constancia de la decisión
- Desplegar a través del Ejecutor en lugar de configurar los dispositivos directamente
- Validar el resultado de cada dispositivo a través de Observabilidad, sin basarse en el código de salida del trabajo
- Revertir los cambios solo en los dispositivos que hayan fallado y comunicar el resultado por el mismo canal por el que llegó la solicitud
Bloques implicados:
- Fuente de Verdad: almacena la definición del servicio de VLAN y los registros de dispositivos que el flujo de trabajo toma como referencia para la validación
- Ejecución: aplica la configuración cuando el Orquestador decide que ha llegado el momento
- Observabilidad: aporta la validación por dispositivo que permite distinguir el éxito del fallo parcial
- Presentación: recibe la solicitud y devuelve el resultado a través del portal ITSM
- Orquestación:
- Motor de flujos de trabajo: un DAG de seis pasos que se ramifica en función del resultado de cada uno
- Activación: el evento que llega a través de un webhook de aprobación inicia el flujo de forma asíncrona
- Resiliencia y escala: la ejecución se distribuye en paralelo por el parque de dispositivos, con un umbral de fallos. Por debajo del umbral, el Ejecutor restaura los dispositivos que han fallado. Por encima, la Saga compensa el paso completo
- Trazabilidad: un registro de auditoría por ejecución que indica quién la aprobó, qué se ejecutó y qué produjo cada paso
- Gestión del ciclo de vida del flujo de trabajo: la propia definición del flujo de trabajo se guarda en el sistema de control de versiones, no en la interfaz de usuario de la herramienta
Este ejemplo omite deliberadamente los nombres de los productos. Cualquiera de las herramientas de la sección Panorama de soluciones puede desempeñar cualquiera de las funciones. Lo que puedes reutilizar es la estructura del flujo de trabajo, sea cual sea la marca de cada componente. Por el mismo motivo, y como en toda la parte 2, las plataformas de los dispositivos se describen de forma genérica: lo que importa es que hay tres.
Flujo de implementación#
El flujo de trabajo consta de seis pasos, desde la validación de la intención hasta la elección de la vía que se sigue según el resultado. La Figura 8.8 muestra el recorrido completo, con sus tres posibles desenlaces, e indica en cada paso a qué bloque se llama. A continuación se detalla cada paso.
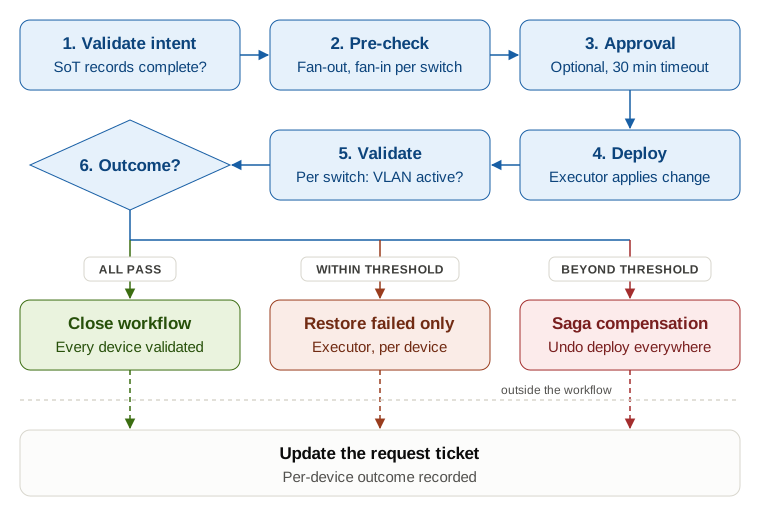
Validar la intención. El Orquestador consulta la Fuente de Verdad para confirmar que los registros de los dispositivos y la definición de la VLAN están completos antes de que se realice ninguna operación en la red. La SoT ya realizó la validación estructural al guardar los datos. Aquí se comprueba que estén presentes todos los datos que necesita este flujo de trabajo, como la dirección de gestión de cada conmutador de destino. Esta comprobación preventiva corresponde al Orquestador, no al Ejecutor: el Ejecutor debe recibir datos válidos para no encontrarse con datos erróneos en pleno despliegue. Si falla alguna comprobación, el flujo de trabajo se interrumpe y actualiza el ticket de la solicitud para indicar qué falta exactamente. (El Capítulo 4 explica cómo se estructura la validación en la SoT).
Realizar las comprobaciones previas en paralelo. El flujo de trabajo abre una rama en paralelo para cada conmutador de destino. Cada rama realiza una comprobación previa ligera de la accesibilidad del conmutador, el estado de la tabla de VLAN y la capacidad disponible. El paso de convergencia clasifica los resultados y determina qué rama seguir. El umbral de fallos es configurable. Lo importante para la orquestación es que se sigue un patrón de distribución y convergencia (fan-out/fan-in) con ramificación condicional. (El Capítulo 6 describe los patrones de ejecución de las comprobaciones previas).
Esperar la aprobación. Antes del despliegue en producción puede solicitarse la aprobación de una persona. Una persona del equipo de ingeniería dispone de 30 minutos para aprobar o rechazar la solicitud. Si nadie responde, este flujo de trabajo remite la solicitud a una segunda persona con autoridad para aprobarla. El registro muestra qué vía se siguió. El Orquestador mantiene el flujo de trabajo en espera, pendiente de una dependencia externa, hasta que llega la aprobación o vence el plazo.
Exigir aprobación es una decisión de política, no de arquitectura. Los equipos con un alto grado de madurez suelen eliminar este paso y sustituir la aprobación humana por umbrales de confianza automatizados derivados de los resultados de las comprobaciones previas: si su cobertura supera el 95 % y no se ha detectado ningún fallo crítico, el flujo continúa automáticamente. Los equipos que aún están adquiriendo confianza conservan el paso de aprobación. Ambas opciones son válidas en etapas distintas. El Capítulo 13 explica qué cambios pueden aprobar por sí solos los controles de seguridad y el Capítulo 14 explica cómo se gana un equipo esa confianza.
Desplegar. El Orquestador inicia la tarea del Ejecutor, le pasa los parámetros del paso de validación de la SoT y espera el resultado. El Ejecutor se encarga del resto. Así funciona la separación de responsabilidades: el Orquestador decide actuar y el Ejecutor actúa.
Validar en paralelo. Tras el despliegue, el flujo vuelve a distribuir el trabajo y ejecuta una tarea de validación por cada conmutador de destino: ¿aparece la VLAN en la tabla de VLAN? ¿Están las interfaces en el estado esperado? El paso de convergencia clasifica los resultados en tres categorías: éxito total, éxito parcial o fallo. (El Capítulo 7 explica qué valida la capa de Observabilidad y cómo lo hace).
Elegir la vía que corresponde al resultado. Si el éxito es total, el flujo de trabajo se cierra: se actualiza el ticket de la solicitud y se publica un resumen en el canal del equipo. Un fallo parcial que se mantiene dentro del umbral fijado para el cambio no activa la compensación de la saga: el Orquestador encarga al Ejecutor que restaure únicamente los dispositivos que no superaron la validación, y los que la superaron conservan su configuración. Si el fallo supera el umbral, se activa la compensación y la saga deshace el paso de despliegue en todos los dispositivos en los que se aplicó el cambio. En el ticket de la solicitud queda registrado el resultado de cada dispositivo.
Resumen de la solución#
Este flujo de trabajo muestra cómo colaboran todos los bloques arquitectónicos del marco NAF descrito en el Capítulo 3. El webhook del portal de servicios (Presentación, Capítulo 9) activó el flujo y la Fuente de Verdad proporcionó la intención. El Ejecutor la aplicó a la Red, el Recolector y la Observabilidad validaron el resultado y el Orquestador coordinó la secuencia completa.
La ingeniera del relato inicial sigue aquí. Es ella quien revisa la solicitud de aprobación cuando se activa ese paso y quien investiga el fallo parcial que el Patrón Saga señaló y no pudo resolver del todo. Sigue siendo la experta. El orquestador no le ha quitado ese conocimiento. Le ha quitado la carga de tener que recordar toda la secuencia, volver a ejecutarla paso a paso y ser la única persona capaz de hacerlo.
Resumen#
La orquestación conecta los bloques de la arquitectura. El motor de flujos de trabajo define cómo se implementa cada proceso: establece los pasos que hay que seguir en cada caso y combina las integraciones con los demás bloques. Hay varias formas de definirlo, desde un monolito tradicional o un DAG hasta la coreografía o la coordinación mediante agentes. En la parte 5 descubrirás cómo resuelve la Orquestación distintos casos de uso.
Todo empieza con la activación del flujo de trabajo, ya sea porque alguien lo solicita a través de la Presentación, porque cambia la Intención o porque se detecta una desviación. La Orquestación debe proporcionar flujos de trabajo que resuelvan los casos de uso más frecuentes. Cuando no haya un flujo adecuado, deja por defecto la decisión en manos de una persona. La lógica de los distintos pasos del flujo de trabajo debe gestionarse como código para que sea sostenible. En esos pasos es importante ofrecer la resiliencia y la escalabilidad adecuadas (más detalles en la parte 3) y garantizar la trazabilidad en todos los casos. La Orquestación es el bloque que conserva el historial completo de un proceso automatizado e integra las trazas de los distintos bloques en un único flujo coherente.
Pero incluso una orquestación eficaz necesita ofrecer una buena experiencia a quienes la utilizan. El Capítulo 9 explica cómo interactúan las personas u otros sistemas externos con la plataforma de automatización de redes.
Referencias#
- Building Microservices, 2nd Edition, Sam Newman (O’Reilly, 2021). Compara la orquestación con la coreografía, describe la coordinación basada en sagas y analiza las ventajas e inconvenientes de los modelos de motor de flujos de trabajo que se presentan en la sección Motor de flujos de trabajo.
- Enterprise Integration Patterns, Gregor Hohpe y Bobby Woolf (Addison-Wesley, 2003). El catálogo de referencia de patrones de mensajería y de flujos de trabajo. Sirve de base para los patrones de activación y de gestión del ciclo de vida de los flujos de trabajo que se describen en las secciones Activación y Gestión del ciclo de vida del flujo de trabajo.
- Designing Data-Intensive Applications, Martin Kleppmann (O’Reilly, 2017). Trata la coordinación basada en eventos, el estado persistente y el procesamiento de cada evento exactamente una vez. Estos conceptos fundamentan los requisitos de estado, trazabilidad y deduplicación de la sección Trazabilidad.
- Release It!, 2nd Edition, Michael T. Nygard (Pragmatic Bookshelf, 2018). Describe los reintentos, los tiempos de espera máximos, los interruptores de circuito y los patrones de estabilidad. De esta obra proceden las propiedades descritas en la sección Resiliencia y escala.
- Cisco pyATS: Network Test and Automation Solution, John Capobianco y Dan Wade (Cisco Press, 2024). Guía completa de pyATS y Genie para automatizar pruebas de red. Abarca los analizadores sintácticos, la validación estructurada del estado y la integración en cadenas de CI/CD.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo