Observabilidad#
Una noche falló un módulo de ventiladores en un router del núcleo de la red de un proveedor de servicios. El fallo pasó inadvertido y no se activó ninguna alerta. Dentro del router, el problema provocó una reacción en cadena. El subsistema de gestión térmica de las tarjetas de línea detectó una temperatura elevada y empezó a limitar el rendimiento de los ASIC de reenvío para proteger el hardware. El caudal de un enlace de tránsito en producción cayó un 40 %.
El sistema de monitorización no detectó nada. Los sensores de temperatura que consultaba estaban en el módulo supervisor del chasis y no en cada tarjeta de línea. Las consultas mediante Simple Network Management Protocol (SNMP) se ejecutaban cada cinco minutos e indicaban que el dispositivo funcionaba correctamente. Los contadores de interfaz mostraban una caída del caudal, pero el sistema la consideró normal porque no se había configurado un umbral específico para ese patrón.
Tres horas después, un cliente abrió una incidencia para reclamar por el incumplimiento del acuerdo de nivel de servicio (SLA). La persona de guardia del equipo de ingeniería revisó el sistema de monitorización y no vio nada. A continuación, se conectó al router por SSH, vio la alarma de fallo de ventilación y apagó y volvió a encender el módulo de ventiladores. Así resolvió la incidencia en cuestión de minutos. Se informó al cliente y se documentaron tanto la incidencia como el incumplimiento del SLA, pero nunca se confirmó la causa raíz.
Cuando la persona encargada de la investigación en el equipo de redes examinó el router, este llevaba horas funcionando con normalidad. No había datos de temperatura de las tarjetas de línea ni registro alguno de la limitación del rendimiento que permitieran relacionar la caída del caudal con el fallo de ventilación. El informe de la incidencia concluyó: «Posible problema de hardware, resuelto al reiniciar el hardware».
Cuatro meses después volvió a ocurrir en otro router (la historia siempre se repite, aunque a veces tarde más).
El problema no era la falta de un umbral. Era la cobertura incompleta. El sistema de monitorización no recogía todos los datos necesarios para detectar el problema porque los datos de temperatura de las tarjetas de línea solo estaban disponibles a través de gRPC Network Management Interface (gNMI). Nadie había configurado la ruta de recogida de esos datos porque nadie había redactado un procedimiento operativo para los fallos de ventilación.
La monitorización tradicional de redes busca fallos: ¿está operativa la interfaz? ¿Supera el 90 % el uso de la unidad central de procesamiento (CPU)? ¿Responde este servicio? Es útil, pero es un enfoque reactivo: estás pendiente de que algo falle.
La observabilidad es distinta. Consiste en entender por qué algo falla o está a punto de fallar. Va más allá de constatar que «ese dispositivo está caído» para preguntar «¿por qué está caído?, ¿qué deja de funcionar por esa caída?, ¿qué impacto tiene en el negocio?». Con la automatización de redes, la observabilidad se convierte en el bucle de realimentación: tú observas algo, el sistema lo detecta, decide cómo responder, actúa y comprueba que la solución ha funcionado. Así se cierra el bucle. En el Capítulo 16 se construye ese bucle para que la configuración se mantenga fiel a la intención y en el Capítulo 17 se amplía para que el servicio siga funcionando correctamente.
Este capítulo explica cómo ver lo que ocurre en tu red: qué datos recoger y cómo hacerlo, cómo almacenarlos y generar alertas a partir de ellos y cómo presentarlos para que quienes los consulten puedan tomar decisiones. También aborda algo que la mayoría de los equipos pasa por alto: vigilar el propio sistema de automatización, que es donde los fallos pasan inadvertidos.
Aquí tratamos dos bloques arquitectónicos, Recolector y Observabilidad, porque están estrechamente relacionados.
Este capítulo se inspira en gran medida en el libro Modern Network Observability (Packt), que escribí con David Flores y Josh VanDeraa. Si quieres pasar a la práctica y aprender a implementar un sistema con la pila Telegraf-Prometheus-Grafana (TPG) y otras herramientas, te lo recomiendo sin reservas. En AutoCon5, David y yo también presentamos Rethinking Network Monitoring, una charla disponible en YouTube que complementa este capítulo.
Los fabricantes y productos que se mencionan en este capítulo se citan a modo de ejemplo, no como recomendaciones. Cada ejemplo ilustra una categoría. La elección adecuada para tu red depende de los factores que se analizan en el capítulo.
Fundamentos#
No puedes gestionar lo que no puedes medir.
Seguramente ya monitorizas tu red. Usas SNMP, consultas System Logging Protocol (Syslog) y tienes paneles que muestran la utilización de los enlaces. Eso es la monitorización: te indica si las cosas funcionan.
Pero la automatización de redes necesita algo más. Cuando cambia tu red (quizá porque la propia automatización la ha modificado), necesitas saber de inmediato si ese cambio provoca algún fallo. Cuando recibes una alerta, necesitas contexto: ¿a qué clientes afecta? ¿Qué servicios han fallado? ¿Cuál es el alcance del impacto? La monitorización te avisa de que algo va mal, pero para automatizar necesitamos saber qué falla, dónde y a quién afecta. Medir es la parte fácil. El bloque de Observabilidad permite que la automatización de redes tenga en cuenta el contexto.
La diferencia fundamental es esta:
- Monitorización: ¿Está operativa la interfaz? ¿Es alto el uso de CPU? Son preguntas sencillas que se responden con un sí o un no.
- Observabilidad: ¿Por qué se cayó la interfaz? ¿A qué afecta la caída? ¿Cómo la solucionamos de forma automática? ¿Qué ocurrió antes para que se llegara a esta situación?
Tanto si compras un producto como si montas tu propia pila, la arquitectura subyacente es la misma y los patrones de este capítulo se aplican en ambos casos. Lo primero es decidir cómo vas a operar el sistema de observabilidad:
Sistema monolítico (por ejemplo, SolarWinds o LibreNMS): un solo producto lo hace todo. Lo instalas, lo configuras y listo. Encaja bien si tu red es sencilla y no tienes experiencia en DevOps. Encaja mal si buscas flexibilidad o tu red es poco habitual, porque tienes que ceñirte al modelo del producto.
SaaS en la nube (por ejemplo, Datadog, New Relic o Kentik): el proveedor se encarga de todo. El despliegue es rápido, te ahorras los quebraderos de cabeza de la infraestructura y dispones de paneles atractivos desde el primer momento. Pero pagas cada mes en función del volumen, tus datos se alojan en los servidores del proveedor (algo relevante para ciertos requisitos de cumplimiento normativo) y, cuando alcanzas los límites del servicio, no puedes ir más allá. He visto equipos que gastaban 50.000 dólares al mes en servicios SaaS de observabilidad y se preguntaban por qué la dirección financiera estaba descontenta.
Sistema de construcción propia (por ejemplo, Prometheus + Grafana o la pila TPG): tienes total flexibilidad, evitas depender de un único proveedor y, a gran escala, los costes son más favorables. Pero ahora te toca gestionar bases de datos, colas de mensajes y la infraestructura de los recolectores. Si no cuentas con personal que sepa operar esos componentes, dedicarás más tiempo a arreglar el sistema de observabilidad que a arreglar la red.
La pregunta de fondo es ¿tienes un equipo capaz de operarlo? Si lo tienes, constrúyelo. Si no, cómpralo. No te engañes sobre cuál es tu situación.
Una vez tomada esa decisión, surgen dos preguntas más:
- ¿Dónde se ejecuta? ¿En tus instalaciones (lo controlas todo, pero te encargas de operarlo), en la nube (lo opera el proveedor, pero tus datos salen de tu red) o en un entorno híbrido (una parte en tus instalaciones y otra en la nube)?
- ¿Cuál es el modelo de costes? ¿Se paga por dispositivo? ¿Por métrica recibida? ¿Una suscripción de tarifa fija? Cuando recoges millones de puntos de datos por minuto, el efecto de estas decisiones en la factura se nota enseguida.
Cómo evolucionar a partir del sistema que ya utilizas
Nadie parte de cero. Tienes un sistema de gestión de red (NMS), llevas años haciendo consultas por SNMP, acumulas infinidad de umbrales que alguien ajustó hace años y cuentas con un centro de operaciones de red (NOC) cuyo personal se ha formado en el uso de una consola concreta. La arquitectura de este capítulo es el destino, no el primer paso, y el riesgo está en la migración.
Mantén ambos sistemas en paralelo durante un tiempo. El antiguo sigue generando alertas mientras la nueva cadena de procesamiento se gana tu confianza. Es normal que convivan unos meses. Para que ese periodo tenga fin, define de antemano qué significa «ganarse la confianza»: la nueva cadena debe detectar los mismos incidentes, con menos falsos positivos, durante un plazo definido.
Sigue este orden, porque cada paso reduce el coste del siguiente:
- Primero, el inventario dinámico. Configura el nuevo sistema de recogida para que consulte la Fuente de Verdad (SoT) en vez de una lista que se mantiene a mano. Aunque de momento no cambie nada más, ya no se te escaparán los dispositivos nuevos.
- Un tipo de datos, un caso de uso. Por ejemplo, los contadores de interfaz para evaluar la capacidad o el estado de las sesiones Border Gateway Protocol (BGP) de un solo servicio. Un caso acotado basta para comprobar la cadena de extremo a extremo: recogida, normalización, almacenamiento, generación de alertas y panel de visualización.
- Las alertas que de verdad exigen actuar. Migra las reglas que despiertan a alguien de guardia, no las cuatro mil que nunca se activan. La mayoría de los umbrales de un sistema antiguo nunca han llegado a generar una alerta o, si la han generado, nadie ha actuado. Cuando menos cuesta eliminarlos es durante la migración.
- Lo que apenas se usa, para el final o para nunca. Algunas funciones del sistema antiguo solo hacen falta una vez por trimestre. Dejarlas ahí un año más es una decisión legítima.
Apaga el sistema antiguo cuando lleve un mes sin que nadie lo consulte, no cuando lo diga el plan del proyecto.
El sistema de observabilidad tiene que resolver varias cuestiones:
Observarlo todo de forma automática. ¿Se conecta un dispositivo nuevo? Debería empezar a enviar datos sin que nadie tenga que registrarlo a mano. ¿Entra en funcionamiento un nuevo servicio? Ya está bajo supervisión. Para ello, el sistema de observabilidad tiene que integrarse con tu Fuente de Verdad y así saber qué hay en la red.
Gestionar entornos heterogéneos con datos de calidad. Probablemente tu red reúna dispositivos de varios fabricantes, proveedores de servicios en la nube, servidores Linux y contenedores. Cada uno ofrece formas distintas de acceder a sus datos. Y olvídate de los intervalos de cinco minutos: cuando la automatización está aplicando cambios, necesitas datos casi en tiempo real.
Correlacionar datos de distintas capas. Un servidor va lento. ¿Está congestionada la red o es un problema de la base de datos? Necesitas datos de los dispositivos de red, de los servidores y de las aplicaciones. Todos tienen que hablar el mismo idioma para que puedas relacionarlos.
Crecer sin colapsar. Las redes crecen. Cuando recoges un millón de métricas por segundo, las arquitecturas tradicionales se vienen abajo. Necesitas sistemas diseñados desde el primer día para funcionar a gran escala.
Permitir que las personas analicen los datos con criterio. Da a quienes analizan tus datos acceso a consultas potentes para que puedan responder a sus propias preguntas sin depender exclusivamente de paneles predefinidos. Necesitan tanto datos en tiempo real como datos históricos (para analizar tendencias y detectar anomalías).
Detectar los problemas y poner en marcha la solución de forma automática. En la mayoría de los casos, la automatización debería responder a los problemas sin esperar a que intervenga nadie. Solo debería avisar a la persona de guardia cuando no sea capaz de resolver el problema. Y esa alerta debería explicar qué falla.
Muéstrale a cada persona lo que necesita ver. Un panel no sirve de nada si muestra demasiada información o si la información es inadecuada. Dale al equipo de operaciones de red su propia vista, al de negocio la suya y al de ingeniería la suya. Así, cada persona ve lo que le ayuda a hacer su trabajo.
Por último, antes de detallar las siete funcionalidades que permiten alcanzar estos objetivos, veamos qué abarca la Observabilidad.
Qué entra en su ámbito
La Observabilidad explica qué hace la red. No decide cómo debe ser la red ni la modifica.
El bloque se encarga del estado observado, es decir, del registro de lo que hace realmente la red, a lo largo de todo el recorrido que va desde el contador de un dispositivo hasta el panel que alguien consulta para tomar medidas. Abarca la recogida, la normalización, la distribución, el almacenamiento y el análisis de los datos, así como la generación de alertas y las vistas que se construyen sobre todo ello. Hay tres aspectos que es fácil pasar por alto:
- La observación a varios niveles, para que unos mismos datos de base permitan responder a una pregunta técnica, a una operativa y a una de negocio.
- El envío de datos de vuelta a las cadenas de CI/CD, para que las pruebas automatizadas y la validación posterior a los cambios dispongan de datos reales con los que contrastar los resultados.
- La observabilidad del propio sistema de automatización: los Recolectores, los procesadores y el sistema de alertas son servicios de producción y necesitan monitorización como cualquier otro.
Qué queda fuera de su ámbito
- Definir la intención de red: determinar cómo debe ser la red (responsabilidad de Intención/SoT)
- Ejecutar cambios en la red: llevar a la práctica las medidas correctivas (responsabilidad del Ejecutor)
- Orquestar flujos de trabajo: coordinar medidas correctivas que constan de varios pasos (responsabilidad del Orquestador)
Funcionalidades#
Como muestra la Figura 7.1, a cada uno de esos siete objetivos le corresponde una funcionalidad que permite alcanzarlo.
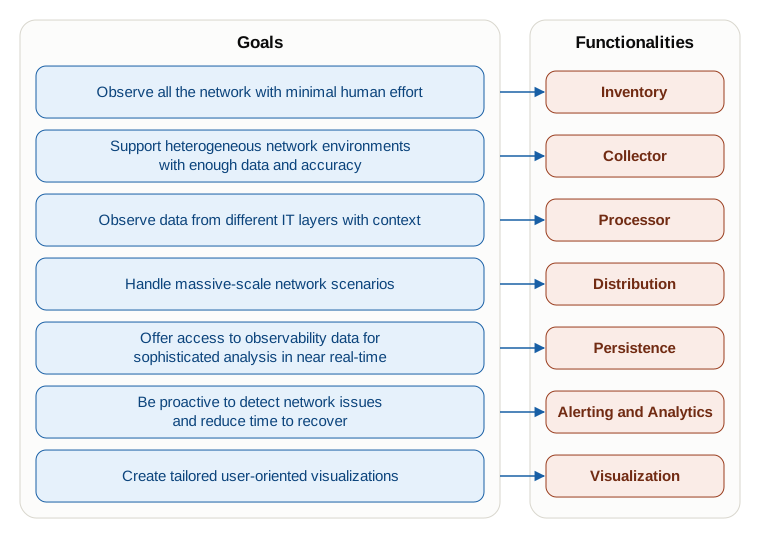
Inventario: sabe qué observar. Obtiene de la Fuente de Verdad los datos de los dispositivos y servicios y las referencias a sus credenciales. Proporciona a cada componente posterior los elementos que debe observar y sus metadatos. Añade un dispositivo a la SoT y su monitorización se activa sin que nadie tenga que darlo de alta en el sistema de monitorización.
Recolector: obtiene datos observados de la red, tanto por petición (sondeo) como por envío desde el origen (transmisión en continuo). SNMP para los equipos antiguos, transmisión en continuo con gNMI para los dispositivos modernos, syslog para los eventos, datos de flujo como los de NetFlow y IP Flow Information Export (IPFIX) para el tráfico y capturas de paquetes para el diagnóstico en profundidad. Cada método ofrece una velocidad y un nivel de detalle distintos, y puedes combinar varios.
Procesador: normaliza datos heterogéneos conforme a un único esquema y los enriquece con información de contexto. Las métricas de un fabricante no se parecen en nada a las de otro, los registros llegan como texto sin estructurar y los datos de flujo llegan en formato binario. El procesador lo traduce todo a un lenguaje común e indica a qué dispositivo, cliente y servicio corresponde cada valor.
Distribución: transporta de forma fiable los datos y los eventos desde los Recolectores hasta los sistemas de persistencia y alertas, pasando por los procesadores. A gran escala, una cadena secuencial se convierte en el cuello de botella. Aquí es donde los buses de mensajes y las plataformas de transmisión en continuo desacoplan las etapas y permiten que cada una escale de forma independiente.
Persistencia: almacena los datos normalizados en un sistema que permite incorporarlos, conservarlos y consultarlos a gran escala. Las métricas necesitan una base de datos de series temporales y los registros necesitan otro tipo de base de datos. Ambas deben responder en milisegundos a consultas que abarcan millones de puntos de datos. No todas las bases de datos ofrecen el mismo rendimiento en estas condiciones.
Alertas y análisis: convierte los datos en acciones. Las métricas en bruto no desencadenan nada por sí solas, así que las reglas y los umbrales permiten detectar las condiciones que te interesan y generar eventos. Si el uso de CPU supera el 90 %, comprueba si una ventana de mantenimiento lo explica. Si no es así, pasa el evento al Orquestador o avisa a alguien de guardia.
Visualización: presenta los datos y los eventos en paneles e informes adaptados a cada público. Los datos que nadie consulta se desperdician, y un panel que lo muestra todo no muestra nada. Cada público dispone de una vista que responde a sus propias preguntas y permite examinar los detalles y comparar los datos con el histórico.
Estas funcionalidades pueden verse como una cadena de procesamiento de datos, o extracción, transformación y carga (ETL), tal como muestra la Figura 7.2:
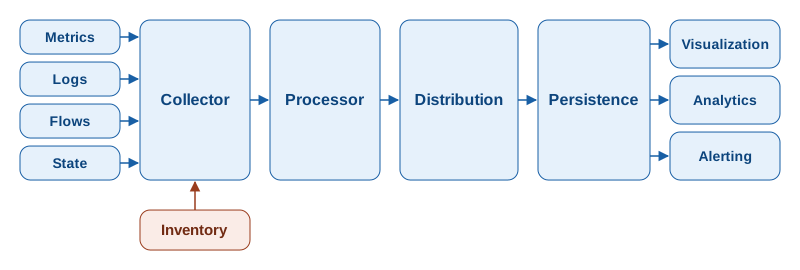
Estas dos figuras sirven de guía para el resto del capítulo. Cada funcionalidad tiene su propia sección, en el orden que ocupa en la cadena. La primera ni siquiera maneja datos observados: su cometido es determinar qué hay que observar.
Inventario#
La primera pregunta que debe responder el bloque de Observabilidad es qué hay que monitorizar.
Ya tienes estos datos en algún sitio: en el inventario de tu Fuente de Verdad. Tienes los nombres de los dispositivos, los identificadores de los servicios, las direcciones Internet Protocol (IP), información sobre qué son y si están activos, y las credenciales. No dupliques esos datos a mano. Impórtalos automáticamente.
De tu SoT necesitas lo siguiente:
- Un nombre o identificador único para cada dispositivo o servicio (para asegurarte de que has identificado el correcto)
- Cómo acceder a él: dirección IP, nombre de host y credenciales (si necesitas solicitarle datos de forma activa)
- Qué es: el tipo y el fabricante (para saber qué Recolectores son compatibles)
- Si está activo: si está previsto, en servicio o en proceso de retirada (para no generar alertas por interrupciones previstas)
Además de estos datos básicos, puede que también te interesen:
- Particularidades del sistema operativo o del dispositivo: algunos dispositivos utilizan protocolos distintos y otros son antiguos y requieren un tratamiento especial
- Contexto: quién es responsable del dispositivo o servicio, dónde se encuentra y qué clientes dependen de él (información útil para filtrar las alertas y los datos de los paneles)
¿Por qué automatizar esta tarea en vez de elaborar una lista a mano? Porque a la gente se le olvida actualizar las listas. Se añaden dispositivos, nadie avisa al equipo de monitorización y, de repente, pierdes visibilidad. En cambio, si el sistema de observabilidad lee los datos de tu SoT, en cuanto añades allí un dispositivo, empieza a monitorizarlo automáticamente.
Para obtener estos datos de inventario, tienes dos patrones básicos:
- Consulta periódica (Pull): el sistema de Observabilidad consulta la SoT periódicamente en busca de novedades. Es sencillo, pero si algo cambia entre dos consultas, el cambio te pasa inadvertido.
- Notificación (Push): cuando se produce un cambio en la SoT, esta avisa automáticamente al sistema de observabilidad mediante webhooks o un bus de mensajes. Es más rápido y fiable, aunque suele ser algo más complejo porque hay que hacer ajustes en ambos lados.
Entre ambos patrones hay un tercero: un servicio de inventario dinámico (dynamic inventory service) como Consul o etcd. La SoT escribe los elementos que se deben observar en un almacén de clave-valor, cada recolector vigila las claves que le interesan y los cambios llegan a los recolectores en cuestión de segundos sin que ninguna de las partes necesite conocer a la otra.
El descubrimiento de servicios al estilo de Prometheus lee directamente de este tipo de almacén. Por eso es el patrón habitual en las pilas de software de la era de los contenedores, y se aplica igual de bien a las redes tradicionales. Para un equipo de redes tiene dos ventajas: los recolectores pueden reiniciarse o escalar horizontalmente sin volver a leer toda la SoT, y si un recolector pierde la conexión con el almacén, sigue funcionando con la última lista conocida de elementos que debe observar.
Si los datos de tu SoT son de calidad y la integración es real, sin tener que copiar y pegar a mano, el inventario se actualiza automáticamente y ningún dispositivo nuevo se queda sin monitorizar.
Una vez definido qué se va a observar, llega el momento de recoger datos operativos.
Recolector#
Tus datos tienen que venir de algún sitio. Los Recolectores conectan tu red con tu sistema de observabilidad. Se encargan de solicitar datos a tus dispositivos (o de recibir los que estos envían) y de introducirlos en la cadena de procesamiento. Si los recolectores no hacen bien su trabajo, nada de lo que viene después sirve.
Según quién controle el flujo de datos, hay dos enfoques fundamentales:
- Pasivo o por envío: tus dispositivos envían datos al recolector. Piensa en los servidores syslog que reciben mensajes de registro de los routers o en los recolectores IPFIX que se mantienen a la escucha de registros de flujo. El dispositivo decide qué enviar y cuándo.
- Activo o por petición: el recolector solicita datos a los dispositivos. Se conecta a cada uno y obtiene información mediante SNMP, gNMI o interfaces de programación de aplicaciones (API) Representational State Transfer (REST). El recolector tiene el control: decide qué pedir y cuándo.
La transmisión en continuo de tipo dial-in combina ambos enfoques. El recolector inicia la suscripción y, a partir de ese momento, el dispositivo envía datos hasta que se le indica que pare. Por eso, ninguno de los dos enfoques la describe por sí solo. Más adelante se trata este caso en el patrón de telemetría en continuo.
También puedes clasificar los recolectores según su forma de despliegue:
- Sin agente: no hay que instalar software en los dispositivos. Un servidor central de recogida, que suele ejecutarse en otro equipo, se conecta a cada dispositivo por separado. Es sencillo para empezar, pero puede convertirse en un cuello de botella a medida que aumenta la escala.
- Con agente: instala un agente ligero en cada dispositivo o servicio. Los agentes envían datos a un punto central o los obtienen directamente de fuentes locales. Es un enfoque más distribuido y más fácil de escalar, aunque hay más componentes que gestionar.
Sea cual sea el método de recogida, conviene destacar los distintos tipos de datos que pueden interesar en un entorno de automatización de redes. Los clasifico en cuatro grandes categorías, que se muestran en la Figura 7.3:
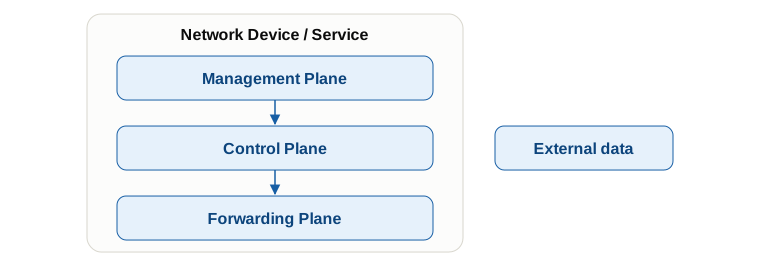
- Plano de gestión: estado, configuración, registros y estadísticas del dispositivo. En este grupo se encuentran los protocolos SNMP, syslog, gNMI, NETCONF y RESTCONF.
- Plano de control: en él se ejecutan los protocolos que construyen las tablas de reenvío, como Open Shortest Path First (OSPF), Intermediate System to Intermediate System (IS-IS) y BGP. Puedes observarlo a través del estado de los protocolos (sesiones, vecinos y tablas de enrutamiento) y mediante telemetría diseñada para este plano, como BGP Monitoring Protocol (BMP).
- Plano de reenvío: es el plano por el que circulan los paquetes (por ejemplo, a través de las interfaces de red) y el más exigente por el volumen de datos y la velocidad a la que se generan. La observación de este plano no debe interferir en el reenvío de paquetes. En este grupo se encuentran las sondas activas, como ping y traceroute, y herramientas como tcpdump, IPFIX, sFlow, NetFlow, IP SLA, Packet Sampling (PSAMP) y Extended Berkeley Packet Filter (eBPF).
- Datos externos: esta categoría incluye todo lo que no es específico de los dispositivos de red. En ella caben, por ejemplo, los datos del proveedor de un circuito y el contacto asociado a una interfaz concreta, que pueden proceder de un sistema externo de gestión de activos, o los datos de sensores físicos del internet de las cosas (IoT).
Observar tiene un coste. Lo pagan tanto el dispositivo como la red. Empieza por el dispositivo. Cada sondeo y cada suscripción consumen recursos del dispositivo, y esos recursos son los del mismo plano de control que intentas proteger. Recorrer una tabla de enrutamiento o una tabla Address Resolution Protocol (ARP) de gran tamaño puede saturar la CPU del módulo supervisor durante todo el recorrido. Una suscripción con un intervalo de 100 ms consume memoria y capacidad de procesamiento del dispositivo mientras está activa. Incluso recoger ocho métricas de cada uno de los 48 puertos cada 30 segundos supone una carga apreciable para el dispositivo cuando todo funciona con normalidad.
La Figura 7.4 muestra la relación entre el intervalo de sondeo y el coste cuando se usa un mismo intervalo para todo el parque de dispositivos. Las curvas son ilustrativas.
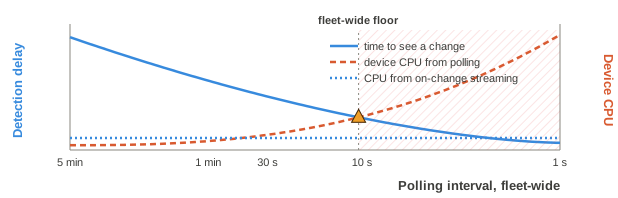
Trata la recogida de datos como una carga que añades a un sistema en producción. Mide el uso de CPU del dispositivo antes y después de habilitar una nueva vía de recogida y escalona los sondeos para que no respondan cientos de dispositivos en el mismo segundo. Recoge datos a intervalos inferiores a un segundo solo en las pocas interfaces que lo necesiten. Para los estados que cambian con poca frecuencia, como el de las sesiones BGP o el de las interfaces, utiliza una suscripción por cambio: el dispositivo solo envía datos cuando cambia el valor, como muestra la línea horizontal de puntos de la Figura 7.4. El modo de fallo es concreto y conocido: la monitorización provoca el mismo incidente que debía detectar.
La red también paga el coste. La telemetría genera más tráfico cuando algo va mal y todos los dispositivos informan a la vez. Si dispones de una red de gestión fuera de banda, dale preferencia para la recogida: así mantienes la telemetría fuera del camino de datos y, si la malla está congestionada, es la única forma de que la alerta sobre esa congestión consiga salir de ella. Si el volumen es elevado, plantéate dedicar una red a la telemetría o, como mínimo, asignarle una clase de calidad de servicio (QoS) para que, durante una interrupción, los datos que la describen no sean lo primero que se descarte. Si todo comparte un único camino, indícalo expresamente en el diseño y acepta que la observabilidad se degradará junto con la red que observas.
Estas cuatro categorías se resumen en dos preguntas fundamentales:
- Qué recoger: ¿Métricas? ¿Registros? ¿Registros de flujo? Cada tipo tiene sus propios modelos de datos. SNMP cuenta con bases de información de gestión (MIB), los equipos modernos exponen modelos Yet Another Next Generation (YANG) mediante gNMI y las aplicaciones usan OpenTelemetry. Lo ideal sería contar con un estándar universal que te permitiera correlacionar datos de todas las fuentes, pero todavía no existe. Por eso, puede que tengas que crear tu propia capa de traducción para convertir todos esos formatos en una representación común (de eso se encarga a continuación la capa de procesamiento).
- Cómo obtener los datos: ¿Qué protocolo utilizar? SNMP es antiguo pero estable, gNMI es moderno y te envía datos continuamente, e IPFIX registra el tráfico que circula. La elección depende de lo que quieras observar.
La Tabla 7.1 resume qué datos puedes recoger y con qué herramientas:
| Tipo de datos | Protocolos / métodos de recogida | Notas / ejemplos |
|---|---|---|
| Métricas | SNMP, extracción mediante HTTP y CLI, OpenTelemetry (OTLP), transmisión continua mediante gNMI | Métricas de dispositivos, de hosts y de aplicaciones |
| Registros | OTLP, lectura de ficheros a medida que se añaden líneas, syslog | Registros de aplicaciones, de sistema y estructurados |
| Trazas | OTLP | Trazado distribuido entre servicios |
| Flujos de red | NetFlow, IPFIX | Flujos de tráfico, análisis de origen y destino |
| Datos específicos de cada protocolo | BMP, BGP, ARP, OSPF | Monitorización de BGP (BMP), tablas ARP, tablas BGP, tablas OSPF |
| Capturas de paquetes | PCAP (libpcap), SPAN / TAP | Inspección de paquetes completos, diagnóstico en profundidad |
La extracción de datos de la CLI es frágil (los fabricantes cambian el formato de salida), lenta (extraer el contenido de la pantalla y analizar el texto consume muchos recursos), poco fiable (algunos comandos agotan el tiempo de espera de forma imprevisible) y escala muy mal. Si tu dispositivo es tan antiguo que solo dispone de CLI, sustitúyelo o acepta que tendrás una observabilidad limitada. No construyas toda tu pila de monitorización en torno al mínimo común denominador.
Antes de decidir qué recoger, empieza por el problema que intentas resolver. Esa decisión determina todo lo demás. ¿Quieres detectar la saturación de una interfaz? ¿Monitorizar la convergencia de BGP? ¿Seguir el tráfico DDoS? El problema determina qué datos necesitas y con qué frecuencia.
En los últimos tiempos se han extendido varios patrones para recoger datos con más frecuencia o unificar los métodos de recogida:
Telemetría en flujo continuo (Streaming telemetry)
Los dispositivos envían datos de forma continua mediante modelos YANG. Configuras las suscripciones y los datos fluyen en tiempo real. Hay dos modalidades, que se muestran en la Figura 7.5:
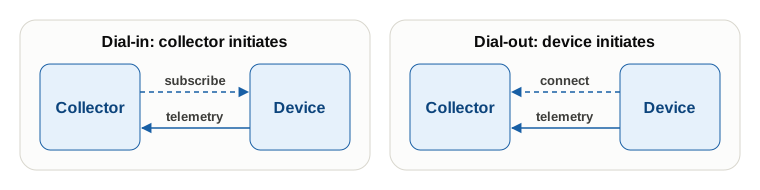
- Dial-In: El recolector pide al dispositivo que empiece a transmitir (el recolector inicia la conexión).
- Dial-Out: El dispositivo se configura de antemano para enviarte los datos de forma continua (el dispositivo inicia la conexión).
La latencia es mucho menor que con el sondeo y el dispositivo mantiene el control del flujo.
Los protocolos que admiten la transmisión continua lo hacen de distintas maneras, y esas diferencias determinan cómo diseñas las suscripciones:
- gNMI define el modelo de suscripción al que se refiere la mayoría de los ingenieros de redes cuando habla de telemetría en flujo continuo. Una suscripción funciona en uno de estos tres modos:
ONCE(se envía un conjunto de actualizaciones y se cierra la RPC),POLL(la RPC permanece abierta y el cliente solicita los datos cuando los necesita) ySTREAM(la RPC permanece abierta y el dispositivo de destino sigue enviando datos). Dentro de una suscripciónSTREAM, se elige un modo para cada ruta:SAMPLE(una actualización por intervalo de muestreo),ON_CHANGE(una actualización solo cuando cambia el valor) oTARGET_DEFINED(el dispositivo decide para cada nodo hoja). - NETCONF con YANG-Push es el equivalente del IETF. El RFC 8639 define las suscripciones a notificaciones YANG y el RFC 8641 las amplía a las actualizaciones del almacén de datos, con los mismos dos criterios de envío, periódico y por cambio, más un periodo de amortiguación que limita la frecuencia con que una suscripción por cambio puede generar notificaciones.
- OpenTelemetry Protocol (OTLP) también transmite datos de forma continua, pero no es un mecanismo de suscripción: nadie solicita una ruta. Un agente envía la telemetría que ya ha recogido y puede ejecutarse en el propio dispositivo o en un recolector situado junto a él. En ambos casos, OTLP interviene después de los dos mecanismos anteriores. El apartado sobre OpenTelemetry que aparece más adelante lo trata con más detalle.
- La exportación de flujos y eventos (IPFIX, sFlow, BMP, syslog) funciona por iniciativa del emisor. No hay que negociar ninguna suscripción: configuras el dispositivo para que envíe los datos y el recolector se queda a la escucha.
Antes de basar tu diseño en la figura anterior, ten presente que la modalidad dial-out no forma parte de la especificación de gNMI. La especificación define dial-in y deja dial-out para el futuro, por lo que cualquier implementación de dial-out que encuentres será específica del fabricante. En lugar de añadir una modalidad dial-out a gNMI, OpenConfig definió un túnel gRPC Remote Procedure Call (gRPC) genérico. Comprueba qué admiten realmente tus plataformas antes de dar por hecho que el patrón es portable.
Con la telemetría en flujo continuo, si reduces lo suficiente el intervalo de muestreo, puedes responder a una pregunta que queda por completo fuera del alcance del sondeo. De eso se ocupa la telemetría de alta frecuencia (HFT). Una microrráfaga es un pico de tráfico que dura entre unos microsegundos y unos pocos milisegundos: lo bastante para llenar una cola y provocar descartes de paquetes, pero tan poco que la utilización media del enlace en cinco minutos sigue siendo del 30 %. El cliente ve pérdidas, el panel de monitorización muestra capacidad de sobra y la discusión que viene después le resulta familiar a cualquiera que haya operado la malla de red de un centro de datos.
Hay dos formas de detectar estas ráfagas. Con un intervalo de muestreo inferior a un segundo, los contadores permiten detectar las más largas. Un valor habitual es 100 ms. La exportación desde el propio ASIC permite detectar las demás: el conmutador registra la ocupación de las colas con una resolución que ninguna suscripción podría transmitir. Ambos mecanismos se han convertido en requisitos habituales en las mallas de red para el entrenamiento de modelos de inteligencia artificial (IA), donde el patrón de tráfico normal es el envío simultáneo de datos desde varios nodos de trabajo sincronizados hacia un mismo destino (incast).
El coste se aprecia en el volumen de datos, y la diferencia es considerable: pasar de un intervalo de 5 segundos a uno de 100 ms multiplica por 50 el volumen de datos. Por eso, la telemetría de alta frecuencia casi siempre se combina con el filtrado en el recolector y la agregación cerca del dispositivo. Ambas técnicas se tratan más adelante en esta sección. Muestrea cada 100 ms solo en las interfaces donde importen las microrráfagas. Y, como se explica en la sección sobre persistencia, reduce la resolución de los datos para el análisis a largo plazo.
Métricas expuestas por HTTP (HTTP-exposed metrics)
La extracción de métricas por HTTP (a petición del recolector) es sencilla y escala bien. SNMP también funciona así, pero la novedad tiene un alcance más concreto de lo que suele darse a entender: los sistemas operativos de red basados en Linux permiten ejecutar un exportador de Prometheus en el propio conmutador. Las métricas llegan entonces por HTTP, en un formato que tu pila de monitorización de sistemas ya entiende, sin necesidad de analizar ninguna MIB como paso intermedio. La Tabla 7.2 indica de dónde proceden estas métricas.
| Fuente | Qué componente expone las métricas | Ejemplo de métrica (tráfico de una interfaz) |
|---|---|---|
| NVIDIA Cumulus Linux | node_exporter, que instalas tú, como en cualquier host Debian | node_network_receive_bytes_total{device="swp1"} 9.21e+10 |
| SONiC | Uno de los varios exportadores instalados en el conmutador, como node_exporter | node_network_receive_bytes_total{device="Ethernet0"} 1.234e+12 (con node_exporter) |
| Arista DANZ Monitoring Fabric | El controlador DMF, en /api/v1/metrics/prometheus, no el sistema operativo del conmutador | device_interface_in_octets_total |
Fíjate en la tercera fila: es el controlador el que expone las métricas, no el sistema operativo del conmutador. En los conmutadores Arista EOS que no forman parte de una malla de este tipo, la forma habitual de obtener datos en formato Prometheus es mediante un recolector que consulta gNMI, siguiendo el patrón de telemetría en flujo continuo descrito antes. Comprueba qué exponen tus propias plataformas antes de basar tu diseño en este método, porque los planes fallan cuando se confunde «el sistema operativo de red (NOS) es Linux» con «el NOS incluye un exportador».
Las métricas expuestas por HTTP facilitan mucho el trabajo de los numerosos equipos de infraestructura que ya han unificado su monitorización de sistemas en Prometheus, porque los datos de red llegan en un formato que su pila de monitorización ya entiende.
La extracción por consulta ofrece baja latencia, métricas casi en tiempo real y etiquetas detalladas. El recolector inicia las consultas y controla de forma centralizada su frecuencia y su tiempo de espera, por lo que este enfoque encaja bien con la observabilidad a escala de la nube.
OpenTelemetry
OpenTelemetry es un estándar independiente del proveedor y un conjunto de herramientas para recopilar, procesar y exportar datos de telemetría. Proporciona un lenguaje y una cadena de procesamiento comunes para las métricas, los registros y las trazas de redes, sistemas y aplicaciones.
No sustituye a protocolos de red como SNMP, NetFlow, gNMI o BMP. Lo que estandariza es la forma de representar y transportar la telemetría después de recopilarla.
En la monitorización de redes tradicional, los modelos de datos son diversos y cada proveedor utiliza sus propios esquemas y nombres, lo que dificulta la correlación entre capas (red ↔ sistema ↔ aplicación). OpenTelemetry facilita esa correlación al proporcionar:
- Un modelo de datos común para métricas, registros y trazas
- Un protocolo de transporte estándar (OTLP) sobre gRPC o HTTP
- Una única cadena de procesamiento para varios tipos de señales
La parte de OpenTelemetry dedicada a las redes aún está en desarrollo. Las convenciones semánticas para las métricas del hardware de red definen nombres como
hw.network.io,hw.network.packetsyhw.network.bandwidth.utilization, pero todos siguen marcados como Development. Tómalos como una indicación del rumbo que se sigue, no como un contrato: los nombres aún pueden cambiar y hoy casi ningún dispositivo de red emite estas métricas de forma nativa.
La implementación de referencia es OpenTelemetry Collector, que recibe, procesa y exporta telemetría con independencia del proveedor. Grafana Alloy y Telegraf son alternativas compatibles tanto con OTLP como con sus respectivos ecosistemas. Los tres recopilan datos de distintos exportadores y los escriben en distintos sistemas de almacenamiento: las métricas en bases de datos de series temporales (TSDB) compatibles con Prometheus, los registros en Loki, Elasticsearch o ClickHouse, y las trazas en Tempo o Jaeger.
Adoptar OpenTelemetry va más allá de elegir herramientas: es una decisión de arquitectura sobre cómo unificar tu cadena de observabilidad. Puedes elegir entre dos enfoques:
Basado en los protocolos nativos: cada tipo de señal viaja de extremo a extremo por su protocolo nativo (gNMI a Prometheus, syslog a Elasticsearch, NetFlow a ClickHouse). Cada cadena está optimizada para su señal. El coste de este enfoque es mantener varias cadenas independientes sin un modelo de datos común, lo que encarece la correlación entre tipos de señales.
Basado en OTel de forma nativa: las señales se convierten a OTLP lo antes posible y pasan por una única cadena hasta un sistema de almacenamiento unificado. Resulta sencillo correlacionar métricas, registros y trazas porque comparten un modelo de datos. El inconveniente es que la compatibilidad de los dispositivos de red con OTel aún está madurando: los dispositivos de la mayoría de los fabricantes no emiten datos en OTLP de forma nativa, por lo que hace falta una capa de adaptación (de gNMI a OTel, de SNMP a OTel) que complica la operación.
La recomendación práctica hoy es que adoptes OTel para las señales relacionadas con las aplicaciones que cuentan con buen soporte por parte de los proveedores, como la telemetría de la propia plataforma de automatización de redes (NAP), el estado de los servicios y los registros estructurados de las aplicaciones. Conserva las cadenas basadas en protocolos nativos para la telemetría de red tradicional (sondeo mediante SNMP, transmisión continua mediante gNMI) hasta que madure el soporte de OTel en los dispositivos. Diseña la cadena para que ambos enfoques puedan funcionar en paralelo. Imponer ahora un único estándar exige un adaptador por cada plataforma de red que integres.
OpenTelemetry también ofrece una respuesta a una cuestión que el Procesador debe resolver en cualquier caso: a qué modelo común debe ajustar los datos la cadena al normalizarlos. Si existen convenciones de OTel para tus señales, adóptalas. Si no existen, define tu propio modelo, como se explica en el apartado Normalización, y mantenlo lo bastante próximo al de OTel para poder adoptar un modelo común más adelante.
Es probable que OpenTelemetry se convierta en el formato común. Empezar por utilizarlo para monitorizar la propia NAP, es decir, para la metamonitorización que se aborda más adelante en este capítulo, es un primer paso de bajo riesgo que te permite familiarizarte con él antes de extender su uso a los dispositivos de red.
La mayoría de los recolectores comparten una estructura de tres etapas: entrada, procesamiento y salida.
Arquitectura del Recolector#
Todo recolector se puede descomponer en tres partes (en algunos recolectores son módulos intercambiables y en otros están fijadas en el código). La Figura 7.6 muestra las tres.
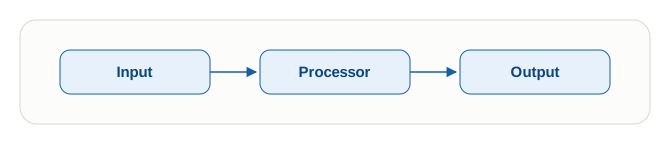
- Entrada: define qué hay que observar y con qué parámetros.
- Procesador: es opcional, pero conviene procesar los datos cuanto antes para que tengan una estructura coherente desde el principio. El procesamiento puede llegar a ser muy complejo y afectar al rendimiento a gran escala, por lo que no es necesario realizarlo todo en esta etapa. El siguiente apartado, dedicado al Procesador, explica en qué otros puntos se puede ejecutar.
- Salida: define cómo incorpora el recolector los datos a la cadena. Puede enviarlos directamente a otros bloques, como el de procesamiento o el de persistencia, o utilizar el componente de distribución para trabajar a mayor escala.
Hay muchos recolectores, cada uno con distintas capacidades, como Telegraf, Grafana Alloy, gNMIc, pmacct o GoFlow2, pero todos utilizan una arquitectura similar. Las soluciones «completas» de observabilidad de redes, como SuzieQ y Kentik, también incorporan sus propios recolectores para los datos que manejan. Al elegir un recolector, aunque a veces necesites varios, sopesa cuatro factores:
- Capacidades de los dispositivos: ¿qué protocolos admiten tus dispositivos?
- Volumen de datos: un volumen alto exige transmisión continua. Si el volumen es bajo, puedes recurrir al sondeo.
- Requisitos de latencia: datos casi en tiempo real o a los intervalos habituales.
- Conocimientos del equipo y compatibilidad del ecosistema con tu sistema de almacenamiento.
Por dónde empezar si empiezas ahora. Lo anterior es un catálogo de opciones, no una lista de tareas. Empieza por la opción más avanzada que admita cada plataforma y sigue este orden de preferencia:
- Telemetría en transmisión continua siempre que esté disponible. Una suscripción gNMI, YANG-Push sobre NETCONF o un exportador que se ejecuta en el propio dispositivo y se consulta por HTTP te proporcionan datos estructurados a intervalos de segundos en vez de minutos. Las dos primeras opciones también permiten enviar los datos cuando hay cambios.
- Exportación de flujos cuando necesites saber quién utiliza la capacidad. «¿Quién utiliza esta capacidad?» es una pregunta distinta de «¿Cuánta capacidad se utiliza?», y ningún contador de interfaz responde a la primera.
- SNMP solo para los dispositivos que no ofrezcan nada mejor. Es el mínimo común para garantizar la compatibilidad, más que una elección de diseño. Construir la cadena en torno a SNMP significa diseñarla en función de la entrada más limitada y tener que adaptarla después para incorporar todo lo demás.
- Extracción de datos de la CLI como último recurso. Llegado ese punto, en realidad eliges entre renovar el hardware y aceptar que parte del parque de dispositivos quede sin monitorizar.
Las demás técnicas de este apartado, como la captura de paquetes, eBPF y la telemetría a intervalos inferiores a un segundo, responden a preguntas específicas. Adopta cada una cuando se te plantee la pregunta correspondiente, no porque aparezca en este capítulo.
La etapa de procesamiento del propio recolector da paso a la siguiente función: el Procesador, que manipula los datos en varios puntos de la cadena.
Procesador#
Los datos en bruto que llegan de los recolectores son heterogéneos. Los dispositivos exportan las métricas de distintas maneras, los registros son texto sin estructurar y los valores pueden estar en unidades diferentes. La capa de procesamiento pone orden en esos datos para que resulten útiles.
Objetivo: en cuanto se reciben los datos, deben ajustarse a estándares comunes que permitan reunir señales de múltiples fuentes, correlacionarlas y enriquecerlas con contexto adicional. Sin este paso de procesamiento, las cadenas de observabilidad se fragmentan enseguida, lo que dificulta las consultas y encarece su operación. Los datos se pueden procesar en varios puntos según la escala, la complejidad y los requisitos operativos.
Estos procesadores pueden ejecutarse en distintas etapas de la cadena de observabilidad según el caso de uso:
- Integrado en el Recolector: es la mejor opción para tareas ligeras de normalización y filtrado en una etapa temprana
- Procesador dedicado: necesario a gran escala para el enriquecimiento dinámico y las transformaciones complejas
- Capa de persistencia: adecuada para las reglas de registro y las agregaciones a largo plazo (la normalización siempre debe hacerse antes)
- Capa de alertas: genera eventos a partir de los datos almacenados y aplica la lógica de negocio
Las siguientes operaciones de procesamiento son habituales en las cadenas de observabilidad.
Normalización#
Los datos llegan en distintos formatos. Las métricas de un fabricante no se parecen en nada a las de otro, syslog utiliza texto y NetFlow utiliza un formato binario. La normalización convierte todo ello a un formato común para que tu sistema de almacenamiento no tenga que entender 50 dialectos distintos.
La normalización se reduce a dos acciones: imponer una estructura a los datos y unificar los nombres que utilizan distintas fuentes para una misma entidad, como un dispositivo, una interfaz o una métrica.
Hay un tercer aspecto que es fácil pasar por alto: la alineación temporal. Todas las correlaciones de este capítulo presuponen que una marca de tiempo de un dispositivo representa el mismo instante que la marca de tiempo equivalente de otro. Esto solo se cumple si todo el parque de dispositivos está sincronizado y la cadena especifica qué reloj toma como referencia. Comprueba que Network Time Protocol (NTP) funcione correctamente, monitorízalo y guarda todos los datos en UTC. Decide después si cada registro llevará la marca de tiempo del dispositivo o la del recolector: la diferencia entre ambas es el retardo de recopilación, y mezclarlas distorsiona todas las comparaciones posteriores sin que se advierta. Un dispositivo cuyo reloj se ha desviado dos minutos no genera ningún error. Produce una correlación incorrecta y nada lo señala.
Estructuración
Los dispositivos emiten los datos en el formato que les conviene. Tu tarea es convertirlos a un formato adecuado para el análisis. Por ejemplo:
A partir de registros: analizar la sintaxis del texto sin estructurar para convertirlo en datos estructurados.
Mar 18 14:22:11 leaf01 IFACE-5-STATE: swp1 oper-state changed from UP to DOWNa
{
  "timestamp": "2026-03-18T14:22:11Z",
  "level": "NOTICE",
  "device": "leaf01",
  "component": "interface",
  "event": "oper_state_change",
  "interface": "swp1",
  "previous_state": "UP",
  "current_state": "DOWN"
}
A partir de métricas: imponer una sintaxis coherente, por ejemplo, el formato de Prometheus:
<metric name>{<labels>} <value>interface_admin_state{hostname="leaf01", ifname="swp1"} 1 interface_oper_state{hostname="leaf01", ifname="swp1"} 0 interface_speed_bps{hostname="leaf01", ifname="swp1"} 100000000000 interface_in_errors_total{hostname="leaf01", ifname="swp1"} 0 interface_out_errors_total{hostname="leaf01", ifname="swp1"} 12A partir de tablas: algunas herramientas, como SuzieQ, organizan los datos en vistas tabulares del estado indexadas por tiempo:
| hostname | ifname | adminState | operState | speed | inErrors | outErrors |
|----------|--------|------------|-----------|-------|----------|-----------|
| leaf01   | swp1   | up         | up        | 100G  | 0        | 0         |
| leaf01   | swp1   | up         | down      | 100G  | 0        | 12        |
Cambio de nombres y unificación: las distintas fuentes de telemetría describen un mismo concepto con nombres y rutas diferentes, y con distintas convenciones o valores para las etiquetas. Un ejemplo es el estado operativo:
- OpenConfig: /interfaces/interface/state/oper-status value: UP tags: source=192.0.2.1 and interface_name=eth1
- SNMP: ifOperStatus{ifName="GigabitEthernet0/1", device="router01"} 1
- Native Prometheus: interface_oper_state{interface="swp1", host="leaf01"} 1La normalización unifica estas representaciones en un modelo coherente que abarca el nombre del objeto, el cambio de nombre de las etiquetas y el valor (aplicando la misma conversión de unidades):
intf_oper_state{name="eth1", device="192.0.2.1"} 1
intf_oper_state{name="GigabitEthernet0/1", device="router01"} 1
intf_oper_state{name="swp1", device="leaf01"} 1Enriquecimiento#
El enriquecimiento añade a los datos de observabilidad información que va más allá de lo observado. Estas dimensiones adicionales permiten utilizar los datos de formas más sofisticadas. Por ejemplo, puedes averiguar que las métricas corresponden a un dispositivo que desempeña una función concreta en la red y actuar en consecuencia.
Hay dos enfoques principales para el enriquecimiento:
Ampliar los datos: añade metadatos o etiquetas para complementar los datos observados. Estos datos adicionales pueden ser estáticos, como
org=my-companypara etiquetar todos tus datos, o dinámicos, si proceden del contexto de recogida, comocollector_id=1234. También pueden derivarse de los propios datos observados: a partir dehostname=rtr-1, crea la etiquetalocation=BCN01cruzando el nombre del equipo con la SoT.intf_oper_state{ name="swp1", device="leaf01", role="leaf", location="BCN01" } 1Crear datos nuevos: siguiendo el patrón de métricas informativas (info metrics) del ecosistema de Prometheus, podemos generar métricas que solo contienen datos de contexto sobre el objeto, sin medición alguna. En etapas posteriores de la cadena de observabilidad, estas métricas permiten incorporar más dimensiones al análisis, como verás en la sección Alertas y análisis.
device_info{
    name="leaf01",
    role="leaf",
    vendor="arista",
    model="7050SX3",
    platform="eos",
    os_version="4.29.2F",
    location="BCN01",
    rack="AB1",
    rack_unit="U32",
    environment="prod"
} 1
Las métricas informativas son un tipo de dato curioso: la información relevante está en las etiquetas y no en el valor (por ejemplo, el 1 de las métricas anteriores). Así, una base de datos de series temporales (TSDB) que solo almacena números puede contener texto, como el nombre de un modelo.
Ambos enfoques añaden etiquetas y contexto. Esto amplía las posibilidades de las alertas y del análisis. Pero conviene tener en cuenta el coste:
- Cardinalidad: cada etiqueta nueva multiplica el número de series temporales. La combinación de dispositivos × interfaces × métricas ya tiene una cardinalidad alta. Si añades etiquetas sin cuidado, las necesidades de almacenamiento se disparan y las consultas se ralentizan. Elígelas con criterio.
- Frecuencia de actualización: ni el bastidor donde se encuentra un dispositivo ni su IP de gestión cambian cada segundo. No consultes los datos de enriquecimiento con la misma frecuencia que las métricas volátiles. Las actualizaciones basadas en eventos funcionan mejor y reducen las consultas a tu Fuente de Verdad.
- Resiliencia: si tu Fuente de Verdad deja de estar disponible, el enriquecimiento se detiene. Guarda los datos en caché para poder seguir operando, aunque sea en modo degradado. Tu automatización depende de estos datos, así que asegúrate de que sean fiables en todo momento.
Transformación#
La transformación deriva métricas nuevas a partir de métricas en bruto, a menudo agregando muchas series en una sola. Por ejemplo, combina el tráfico entrante de todas las interfaces de los conmutadores leaf y spine en una sola métrica de «ancho de banda utilizado en la fabric» para seguir su evolución. Así combinas datos existentes para responder a preguntas más amplias o alimentar paneles. Por ejemplo:
- record: fabric:in_bps
  expr: |
    sum by (fabric) (
      rate(interface_in_octets_total[5m]) * 8
      * on (hostname, name) group_left (fabric)
        sot_interface_info{role=~"leaf|spine"}
)En el ecosistema de Prometheus se habla de reglas de registro, pero yo prefiero llamarlas métricas compuestas.
Componer métricas de esta forma ofrece tres ventajas. Reutilización: la métrica de ancho de banda de la fabric se define una sola vez y todas las alertas, paneles e informes leen el mismo valor, así que nadie discute sobre quién hizo la consulta correcta. Una definición común para alertas y gráficos: una alerta que se activa a partir de fabric:in_bps y un gráfico que representa esa misma métrica nunca discrepan. Así se eliminan todos los incidentes que empiezan con «la alerta indica un 80 %, pero el panel muestra un 60 %». Rendimiento de las consultas: la agregación, que es costosa, se ejecuta una vez por intervalo de evaluación en lugar de cada vez que se actualiza un panel. La diferencia importa cuando la agregación abarca miles de interfaces.
El coste es el espacio de almacenamiento y un elemento más que mantener. Cada métrica compuesta se almacena junto con los datos en bruto de los que procede, y hay que actualizar su definición cuando cambian las etiquetas subyacentes. Por eso, compón solo las métricas que consultas repetidamente, aunque puedas componer muchas más.
La agregación es la otra forma de reducir el volumen: elimina las dimensiones que no necesitas para responder a la pregunta que planteas a los datos. Resume los contadores de las interfaces por dispositivo o los de los dispositivos por sede. Aquí también encajan el cálculo de tasas a partir de contadores y la agrupación de valores en intervalos de un histograma. Ambas técnicas son útiles en análisis muy diversos.
Filtrado#
Descarta cuanto antes lo que sobra. No merece la pena almacenar todas las líneas de los registros. Tampoco importan todas las métricas de interfaz (quizá no te interesen las interfaces de loopback). Cuanto antes filtres, menos recursos desperdiciarás en almacenamiento y procesamiento. Las listas de inclusión (conserva solo esto) son más seguras que las de exclusión (descarta aquello).
El filtrado empieza en la suscripción, antes de llegar al procesador. Solicita solo las rutas que necesitas y descarta después lo que se haya colado. Con gNMIc, ambas operaciones se definen en la configuración:
subscriptions:
  interface-counters:
    paths:
      - /interfaces/interface/state/counters
    mode: sample
    sample-interval: 30s

processors:
  drop-loopbacks:
    event-drop:
      tags:
        - "^Loopback.*"

outputs:
  prom:
    type: prometheus
    event-processors:
- drop-loopbacksLa suscripción hace que el dispositivo envíe únicamente contadores de interfaz. Después, el procesador descarta las interfaces de loopback, que ningún filtro de rutas puede excluir porque una interfaz de loopback es una interfaz como cualquier otra. El orden importa: cuanto más acotada esté la suscripción, menos trabajo tendrá que hacer cada etapa posterior.
Muestreo#
Incluso después del filtrado, el volumen puede seguir siendo excesivo. El muestreo conserva una parte representativa y limita el paso del resto. Aplica un muestreo probabilístico («conserva el 10 % de estos registros de flujo»), selecciona las K métricas con los valores más altos («almacena solo las 100 interfaces con más tráfico») o limita la tasa por origen («máximo de 1000 métricas por dispositivo»). A medida que los datos de la base de datos envejecen, agrégalos para ahorrar espacio (los datos con una resolución de 5 segundos pasan a ser medias de 5 minutos).
Un ejemplo concreto para una fabric de 2000 interfaces: conserva lecturas de los contadores cada 100 ms en los 40 enlaces ascendentes que transportan tráfico entre bastidores, cada 10 segundos en todos los puertos de acceso y ninguna en los puertos desactivados administrativamente. Al cabo de 24 horas, agrega las series de 100 ms en medias de 10 segundos y, al cabo de 30 días, en medias de 5 minutos. Los enlaces ascendentes mantienen la resolución que permite detectar microrráfagas y el coste de almacenamiento de esa resolución corresponde a las 40 interfaces que la necesitaban, de un total de 2000.
El mismo criterio se aplica más adelante en la cadena, cuando decides qué datos almacenar de forma persistente y cuáles descartar.
Las cadenas de observabilidad eficaces distribuyen el procesamiento entre varias capas en función de las herramientas, la escala y las restricciones operativas.
Distribución#
Las cadenas lineales sencillas (recolector → procesador → base de datos) no escalan bien. Si la base de datos se ralentiza, se acumulan datos en el recolector. Si necesitas actualizar el procesador, tienes que detener la recogida. Todos los componentes están estrechamente acoplados y el conjunto es frágil.
Aquí entran en juego los intermediarios de mensajes. La Figura 7.7 muestra cómo encajan.
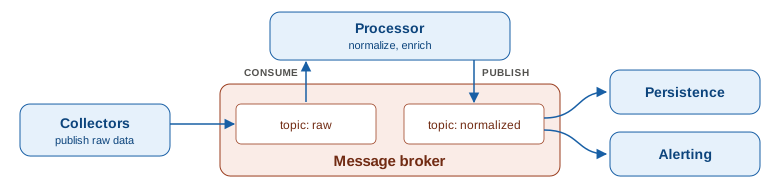
Los intermediarios de mensajes como Apache Kafka o NATS se sitúan entre productores y consumidores. Los productores (recolectores) publican mensajes en temas y los consumidores (bases de datos, sistemas de alertas) los leen a su propio ritmo. Un procesador cumple ambas funciones: consume un tema con datos en bruto y publica el resultado normalizado en otro, de modo que cada etapa de la cadena puede cambiar sin tocar las demás. Ninguna de las partes necesita conocer a la otra, lo que aporta tres ventajas:
- Escalado: cada componente escala de forma independiente.
- Resiliencia: si un consumidor va despacio, los datos quedan en cola y se evita su pérdida.
- Flexibilidad: los mismos datos alimentan varios sistemas de destino sin duplicarse en origen. Puedes actualizar o reiniciar un componente sin afectar a los demás.
El intermediario actúa como un búfer que absorbe los picos de carga. Encontrarás más información sobre los patrones de escalado y fiabilidad en el Capítulo 12.
El intermediario como ventana de observación
Un intermediario de mensajes hace algo más que transportar datos. También puede retener el flujo completo durante un breve periodo, el suficiente para analizarlo sin pagar el coste del almacenamiento persistente. La Figura 7.8 muestra cómo funciona: todo el caudal de datos llega al intermediario y solo dos tipos de datos pasan al almacenamiento persistente.
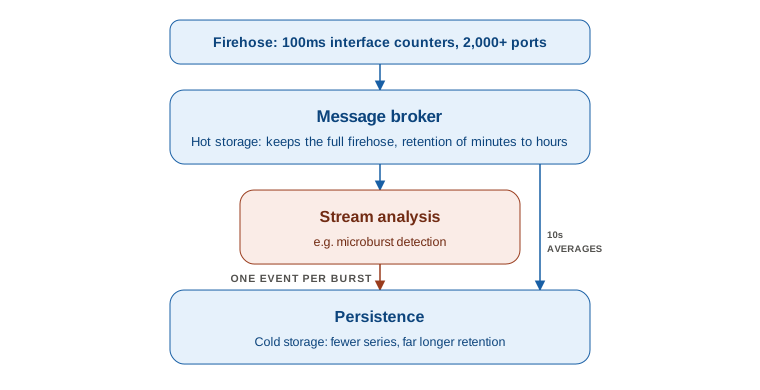
Esto es una ventana de observación: un periodo de retención breve, de minutos u horas, durante el que se conserva todo el flujo tal como llegó. Ninguno de esos datos se almacena de forma persistente en el sentido que veremos en la siguiente sección, así que el volumen se gestiona ajustando el periodo de retención en lugar de asumir una factura de almacenamiento. Con la persistencia, el equilibrio se invierte. Conservas muchos menos datos durante mucho más tiempo y pagas por cada serie que añades hasta que vence su periodo de retención.
Por eso merece la pena analizar el flujo de datos a medida que llega. Almacenar de forma persistente las lecturas de los contadores de interfaz cada 100 ms en una fabric de 2000 puertos resulta demasiado caro, pero hacerlas pasar por un intermediario es perfectamente asequible. Aplica la detección de microrráfagas al flujo y guarda de forma persistente solo lo que detecte: un evento por ráfaga en lugar de 20 000 muestras por segundo. Los datos que dieron lugar al evento quedan obsoletos en menos de una hora y eso es aceptable porque el evento se conserva más tiempo.
Guarda una muestra de menor resolución junto con el evento y conservarás la tendencia sin almacenar el flujo completo. Las medias de diez segundos o de un minuto de esos mismos contadores cuestan una fracción de lo que cuestan las series en bruto, y el evento y la serie de menor resolución responden a preguntas distintas. El evento indica que se produjo una ráfaga a las 02:41:13 en este puerto. La serie de menor resolución indica si las ráfagas son cada vez más frecuentes en esa fabric. Ninguno de los dos sustituye al otro y conservar ambos sigue siendo mucho más barato que almacenarlo todo de forma persistente.
Por eso el componente de alertas y análisis lee de ambos orígenes. Consulta los datos persistentes para responder a preguntas sobre tendencias y datos históricos. Analiza el flujo para responder a las preguntas cuyos datos sería prohibitivo almacenar, porque ahí se concentra el volumen.
El intermediario te da una ventana de observación. Todo lo que deba conservarse más allá de esa ventana pasa al siguiente bloque.
Persistencia#
Una vez procesados los datos, necesitas un lugar donde guardarlos. La capa de base de datos almacena todos tus datos de observabilidad. Debe gestionar volúmenes enormes, admitir consultas rápidas y mantener los costes en niveles razonables.
Las métricas, los registros, los flujos y las trazas son los contenidos más evidentes, pero aquí también tienen cabida otros dos tipos de datos. Es fácil olvidarse de ambos hasta que hacen falta para resolver un incidente:
Estado observado: es el registro estructurado del estado real de la red: qué interfaces están configuradas, qué vecinos ve cada dispositivo, qué rutas están instaladas y qué VLAN están presentes en cada enlace troncal. Es la contrapartida de la Intención del Capítulo 4: describe cómo es la red en realidad, frente a cómo debería ser. Poder consultar este registro te permite responder a preguntas complejas y útiles, como «¿qué dispositivos perdieron un vecino OSPF entre las 02:00 y las 02:10?», sin iniciar sesión en ningún equipo. La detección de desviaciones compara este estado con la intención. La herramienta que tradicionalmente desempeña esta función es la base de datos de gestión de la configuración (CMDB): registra qué hay en la red, mientras que la SoT declara qué debería haber.
Copias de seguridad de la configuración: se guarda la configuración en ejecución de cada dispositivo a intervalos programados y con cada cambio. En una investigación posterior a un incidente, esa copia es el único registro de las instrucciones que realmente recibió el dispositivo.
Un repositorio de copias de seguridad de configuraciones es un almacén de credenciales, lo hayas previsto o no. Las configuraciones de los dispositivos contienen hashes de contraseñas locales, comunidades SNMP, secretos compartidos de RADIUS y TACACS+, claves MD5 de BGP y claves precompartidas de túneles. El capítulo 4 insiste en que la SoT guarde referencias en lugar de secretos, y el repositorio de copias de seguridad es donde más a menudo se descuida esa práctica. Aplícale los mismos controles de acceso, cifrado y registro de auditoría que al gestor de secretos, elimina los datos sensibles que puedas al incorporar cada copia y evita que se convierta en esa cómoda copia de solo lectura a la que todo el mundo tiene acceso.
Las buenas bases de datos para observabilidad comparten varios rasgos:
- Tratamiento del tiempo: cada dato lleva por naturaleza una marca de tiempo. Estas bases de datos optimizan las consultas por intervalos y los cálculos por ventanas temporales.
- Alta capacidad de escritura: las métricas llegan sin parar. Estas bases de datos las incorporan sin perder rendimiento.
- Multidimensionalidad: las métricas llevan etiquetas (dispositivo, interfaz, ubicación). Estas bases de datos permiten consultarlas y agregarlas con eficiencia.
- Consultas flexibles: hacen falta lenguajes expresivos (por ejemplo, Prometheus Query Language (PromQL) y Log Query Language (LogQL)) para explorar los datos sin esquemas predefinidos.
- Gestión del ciclo de vida: el volumen almacenado crece deprisa. Estas bases de datos permiten controlar los costes mediante la retención, la reducción de resolución y el borrado de datos.
- Flexibilidad del esquema: aparecen métricas nuevas continuamente. Estas bases de datos se adaptan a los cambios sin migraciones costosas.
¿Qué tipos de bases de datos dan buen resultado?
Ninguna base de datos resuelve a la perfección todas las cargas de trabajo de observabilidad, y quien te diga lo contrario quiere venderte algo. Esto es lo que funciona en la práctica:
Bases de datos de series temporales: empieza por aquí. Prometheus ganó la batalla de las métricas. Su modelo de datos (métricas con etiquetas) se convirtió en el estándar de facto y PromQL es el lenguaje de consulta que todo el mundo conoce.
Bases de datos columnares: aquí reina ClickHouse. Es increíblemente rápido para agregar registros y analizar flujos. Si necesitas consultar miles de millones de filas para elaborar informes o realizar análisis históricos, esta es tu herramienta. Los archivos Parquet sirven para cargas de trabajo analíticas que no requieren escrituras en tiempo real, como las de SuzieQ.
Bases de datos de búsqueda textual: para buscar en registros no estructurados, Elasticsearch es la opción consolidada. Loki adopta un enfoque más ligero: indexa las etiquetas en lugar del texto completo, lo que reduce los costes de operación a cambio de búsquedas más lentas cuando el criterio es arbitrario. Plataformas comerciales como Splunk ofrecen funciones de análisis maduras. Hay algo más importante que la elección del producto: la mayoría de los equipos invierten demasiado en buscar en los registros y demasiado poco en generar registros estructurados, cuando los eventos estructurados ya reducen de entrada la necesidad de buscar en texto libre.
Mi recomendación: empieza con Prometheus (o una herramienta similar) para las métricas y con Loki (o una herramienta similar) para los registros. Añade ClickHouse (o una herramienta similar) cuando necesites análisis históricos en profundidad. Con ese conjunto de herramientas podrás trabajar a gran escala antes de necesitar algo más sofisticado.
Esta clasificación no es absoluta. La mayoría de las herramientas encajan principalmente en una categoría, pero también incorporan características de otras, sobre todo de las bases de datos de series temporales.
Al diseñar el almacenamiento importan dos conceptos: la cardinalidad (cuántos valores distintos puede tomar una etiqueta) y la dimensionalidad (cuántas etiquetas tiene una métrica). Piensa en una sola métrica, los bytes recibidos por interfaz, con dos etiquetas: device (800 valores) e interface (48 valores). Son 38 400 series temporales. Añade una tercera etiqueta, vlan, con 100 valores, y esa misma métrica pasa a tener hasta 3,8 millones de series.
Cada etiqueta multiplica el total por su propia cardinalidad, así que una sola etiqueta mal elegida puede multiplicar por cien el espacio de almacenamiento y ralentizar todas las consultas. Es uno de los mayores retos de la observabilidad, y las principales defensas son el filtrado, la agregación y el muestreo que se describen en la sección Procesador. Cuando un solo nodo deja de ser suficiente, el capítulo 12 explica cómo federar la capa de Observabilidad.
Elige cada base de datos en función de las preguntas que deba responder. SuzieQ almacena sus datos en archivos columnares Apache Parquet porque sus consultas son relacionales, no de series temporales. Una pregunta típica es «¿Qué rutas están presentes en los switches spine pero faltan en alguno de los switches leaf?». Para responder hay que filtrar por muchos atributos, combinar tablas (interfaces, vecinos, rutas) y comparar filas de distintos dispositivos en un mismo instante. Un almacén columnar está diseñado para eso. Una TSDB puede contar rutas, pero para encontrar las que faltan harían falta más etiquetas de las que puede gestionar con soltura.
Conservar los datos durante más tiempo. La retención es lo que dispara los costes de almacenamiento, y hay dos formas de conservar el historial sin pagar el precio íntegro. La reducción de resolución conserva menos detalle. El almacenamiento en frío mantiene el detalle, pero lo traslada a un medio más barato.
La reducción de resolución hace asequible la retención a largo plazo. Un contador muestreado cada 10 segundos genera 8640 puntos por serie al día. Si calculas la media por intervalos de 5 minutos, obtienes 288. Conserva ambas series y tendrás respuesta a dos preguntas distintas: los datos en bruto te sirven para diagnosticar el incidente de esta semana y los datos agregados, para elaborar el plan de capacidad del próximo trimestre. La Tabla 7.3 recoge las etapas habituales.
| Etapa | Resolución | Retención habitual | Qué permite averiguar |
|---|---|---|---|
| Datos en bruto | 10 s o menos | De 24 horas a 7 días | Qué ocurrió durante el incidente |
| Primera agregación | De 1 a 5 minutos | De 30 a 90 días | Tendencia del mes pasado, revisión posterior al incidente |
| Segunda agregación | 1 hora | De 1 a 3 años | Planificación de la capacidad, crecimiento interanual |
Hay dos reglas. Decide para qué sirve cada etapa antes de fijar su plazo de retención, porque «guardarlo todo durante un año» es una decisión presupuestaria disfrazada de decisión técnica. Y elige la agregación para cada métrica: calcular la media de los valores de utilización es razonable, pero si promedias un pico, perderás la microrráfaga en cuya captura invertiste el presupuesto de recolección. Conserva el máximo junto a la media siempre que el pico sea la señal que buscas.
El almacenamiento en frío es la segunda forma de reducir costes. Los datos que superan el plazo de retención de la propia base de datos pasan a medios más baratos, por lo general al almacenamiento de objetos, donde las consultas son más lentas pero cada gigabyte cuesta una fracción del precio original. Muchos almacenes de series temporales y de registros admiten de forma nativa esta distribución por niveles.
Un lago de datos lleva la idea más lejos. Los datos de observabilidad, tanto en bruto como procesados, se guardan en almacenamiento de objetos en un formato columnar abierto, como Parquet, junto a datos de otros ámbitos. Cualquier motor de análisis puede consultarlos más adelante. Sirve para abordar preguntas que aún nadie se ha planteado, por ejemplo, para elaborar un modelo de capacidad u obtener datos de entrenamiento para la detección de anomalías que veremos más adelante en este capítulo. El precio son unas consultas lentas y un esquema que tienes que gestionar tú.
Los datos almacenados solo justifican su coste si se actúa a partir de ellos. La siguiente función los convierte en eventos que pueden consumir otros procesos de automatización o que pueden dar pie a la intervención humana.
Alertas y análisis#
Las alertas convierten los datos en acciones. Tu objetivo es hacerlas llegar a la automatización. Avisa a una persona cuando la automatización no pueda resolver el problema.
Las alertas pasan por cuatro etapas, como muestra la Figura 7.9:
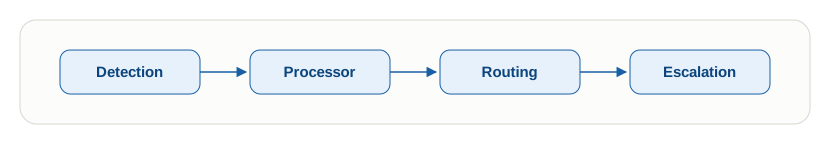
- Detección: identifica algo que no se comporta como debería.
- Procesamiento: añade contexto a la alerta. ¿Es crítica? ¿Leve? ¿Una falsa alarma? Correlaciona las alertas relacionadas para reducir el ruido.
- Encaminamiento: envía la alerta al sistema de orquestación (para ejecutar flujos de trabajo), a los equipos (Slack) o al sistema de gestión de incidentes (PagerDuty).
- Escalado: si falla la automatización, una persona se hace cargo.
Configurar alertas es fácil. Lo difícil es evitar la fatiga por alertas. He visto centros de operaciones de red (NOC) con 10 000 alertas activas que ya nadie mira. Llegados a ese punto, lo único que tienes por toda monitorización es ruido que te sale caro.
Así puedes remediarlo:
Dirige la mayoría de las alertas a la automatización y deja la intervención humana en segundo lugar. Si una persona ve una alerta, debería ser porque la automatización ha intentado resolver el problema y ha fallado. ¿Una interfaz sube y baja sin parar? La automatización comprueba si hay tareas de mantenimiento, desactiva y vuelve a activar el puerto y abre una incidencia con el fabricante. El personal de guardia solo recibe un aviso si la automatización no puede resolver el problema.
La corrección automática es una forma de automatización como cualquier otra y necesita las mismas protecciones. Necesita una simulación antes de la primera acción real y un límite al alcance del impacto para que una sola regla no pueda actuar sobre todo el parque de dispositivos. También necesita un paso de aprobación para cualquier acción que quede fuera del conjunto acordado de acciones seguras, así como una vía de reversión. El capítulo 6 describe esos controles y el capítulo 8 explica quién determina en qué orden se aplican. Una alerta que desencadena un cambio sin protecciones es peor que una alerta que nadie lee.
Sustituye la mayoría de los umbrales estáticos. «CPU > 80 %» a menudo no sirve de nada: un 80 % puede ser normal en ese dispositivo. Conserva los umbrales estáticos para límites estrictos, como los de potencia óptica o el de un disco lleno. Utiliza referencias dinámicas: genera una alerta cuando algo se aparte de su patrón histórico y no de una cifra arbitraria.
Agrupa las alertas relacionadas. Cuando caiga un switch del núcleo, recibirás 500 alertas de los dispositivos que dependen de él. Muestra una sola: «Switch del núcleo caído, 500 dispositivos afectados». No 500 alertas individuales.
Exige un procedimiento de actuación para cada alerta. Si no puedes poner por escrito qué debe hacer quien reciba la alerta, elimínala. En serio. Si la acción es «investigar», eso no es una acción, es una pérdida de tiempo.
Mide la calidad de las alertas. Haz un seguimiento de la tasa de falsos positivos. Corrige o elimina cualquier alerta que supere el 10 % de falsos positivos. Mide cuánto tiempo se tarda en acusar recibo. Si las alertas pasan horas sin que nadie acuse recibo, no son lo bastante importantes como para justificar su existencia.
El objetivo no es «tener una monitorización exhaustiva». El objetivo es «avisar al personal de guardia solo de lo que requiere intervención humana».
El papel de la IA y de AIOps en la observabilidad#
La IA va a revolucionar la automatización, pero hoy la mayor parte de lo que se vende como «observabilidad con IA» es simple detección de anomalías con presupuesto de marketing. Aun así, aporta valor real si la despliegas bien. Esta sección explica qué aporta la IA a la observación de la red. Dejar que los agentes de IA decidan y actúen en función de lo que observan es un paso distinto, que se trata en el capítulo 18.
Esto es lo que funciona en la práctica:
Detección de anomalías: el aprendizaje automático (ML) supera a los umbrales estáticos a la hora de aprender qué es «normal» para cada dispositivo. Un uso de CPU del 85 % puede ser normal en el dispositivo A y un desastre en el B. El ML aprende esa diferencia automáticamente. Hoy esto es lo mínimo que cabe esperar, no tiene nada de mágico.
Correlación de alertas: cuando fallan 50 cosas a la vez, el ML puede agruparlas y sugerir que «la causa raíz probablemente sea el conmutador del núcleo». Esto ahorra horas de diagnóstico. Pero sigue haciendo falta que alguien lo compruebe: el ML se equivoca al identificar la causa raíz con suficiente frecuencia como para que, si actúas sin verificarla, acabes dejando fuera de servicio algo que funcionaba bien.
Previsión de capacidad: al ML se le dan bastante bien las previsiones del tipo «según la tendencia, este enlace se saturará en 6 semanas». Lo hace mejor que una persona que estima la tendencia a ojo en un gráfico. Sigue haciendo falta criterio humano para decidir si la previsión merece atención.
Lo que se vende con promesas exageradas:
Análisis automático de la causa raíz: todos los proveedores lo prometen. Ninguno lo consigue de forma fiable. Recibirás sugerencias, a veces buenas, pero eso de que «la IA ha diagnosticado y resuelto el problema» es algo que se dice en las demostraciones, y las demostraciones se eligen con cuidado.
Redes con autorrecuperación: la automatización puede resolver problemas conocidos con soluciones conocidas. Eso no es IA, es buena ingeniería. La verdadera «autorrecuperación» ante problemas nuevos aún no existe. Cuando un proveedor te haga una demostración, pídele que te enseñe los casos en los que falla. El Capítulo 17 explica dónde está realmente ese límite y hasta dónde puedes llegar con la automatización de problemas conocidos.
«AIOps sustituye a tu NOC»: no. inteligencia artificial para operaciones de TI (AIOps) ayuda a tu NOC a trabajar con mayor eficacia. ¿Y el criterio humano, el conocimiento del contexto de negocio y la capacidad de resolver casos límite? Eso sigue dependiendo de las personas.
En resumen: usa el ML para detectar anomalías y priorizar alertas. Mantén una actitud escéptica ante todo lo demás hasta que lo hayas probado en tu propia red. Las demostraciones de los proveedores suelen salir bien, pero no reflejan las condiciones reales de tu red.
Para ponerlo a prueba, haz un ejercicio concreto. Toma 90 días del historial de tu red, reproduce esos datos en la herramienta y responde a tres preguntas. ¿Detectó los incidentes que realmente se produjeron y con cuánta antelación respecto a tus umbrales actuales? ¿Cuántos avisos por semana y por ingeniero resultaron ser falsas alarmas, sabiendo que de esa cifra depende que alguien siga leyendo los avisos? Y cuando agrupó alertas, ¿la causa que señaló era el problema que solucionaste? Si en la primera pregunta la herramienta supera a tus umbrales actuales y en la segunda sale bien parada, merece la pena activarla. Si no puedes evaluarla con tu propio historial, es una demostración, diga lo que diga la etiqueta.
La interfaz entre la alerta y la acción#
Una alerta que lee una persona es una notificación. Una alerta que consume un sistema de automatización es un contrato. Estos dos destinatarios tienen requisitos distintos, y confundirlos es uno de los motivos más frecuentes por los que las cadenas de alertas fallan en el punto de conexión con el Orquestador.
La Figura 7.10 muestra cómo una sola regla de detección envía la alerta a ambos destinatarios mediante una plantilla de carga útil para cada uno.
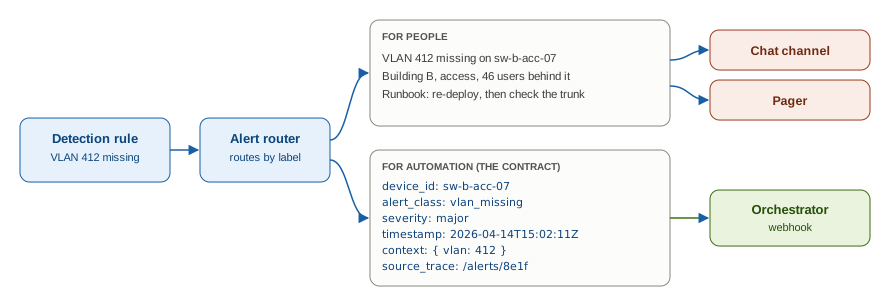
Cuando una alerta está destinada a la automatización, una máquina debe poder consumir su carga útil sin tener que analizar texto. Para ello hacen falta datos estructurados, no una línea de asunto pensada para que la lea una persona. Como mínimo, la carga útil de una alerta destinada a la automatización debería incluir:
- Identidad del dispositivo: un identificador canónico que coincida exactamente con el del registro de la SoT (no un nombre de host que pueda diferir entre el DNS y la CMDB).
- Clase de alerta: un tipo estable, definido en una enumeración, que permita al Orquestador encaminar la alerta (no una descripción de texto libre que cambie cuando alguien edite la regla de alerta).
- Gravedad: un valor de una enumeración definida en lugar del valor numérico de un umbral.
- Marca de tiempo: la hora del evento en UTC y en formato ISO 8601, en lugar de la hora de entrega de la notificación.
- Contexto pertinente: la métrica o el estado concreto que ha activado la alerta, en un campo que el Orquestador pueda leer directamente (por ejemplo,
"interface": "Ethernet0/1", en vez de incluir ese dato en el texto del mensaje). - Referencia al origen: un enlace o una referencia al evento sin procesar en el sistema de Observabilidad para que el Orquestador pueda volver a consultarlo y obtener más contexto.
Si la carga útil cumple este contrato, el Orquestador puede encaminar la alerta al flujo de trabajo adecuado, pasar la identidad del dispositivo a la consulta de la SoT e invocar al Ejecutor con parámetros estructurados, sin tener que analizar cadenas de texto. Si la carga útil incumple el contrato, el Orquestador se ve obligado a analizar texto escrito para personas, y ese análisis falla cada vez que cambia la descripción de la alerta.
Define este contrato antes de crear las reglas de alerta. Quienes redactan reglas pensando en que las personas puedan leerlas producen mensajes difíciles de procesar de forma automática. Quienes escriben para ambos destinatarios producen mensajes que no sirven bien a ninguno. La solución más sencilla es establecer dos rutas paralelas: un formato de alerta para las personas (Slack, PagerDuty) y otro para la automatización (cola de mensajes, punto de acceso de un webhook). La misma regla de detección activa ambas rutas, cada una con una plantilla de carga útil distinta según el destinatario.
Las alertas son lo que dice el sistema cuando hay que hacer algo. La última funcionalidad se ocupa de lo que muestra cuando alguien quiere echar un vistazo.
Visualización#
Todos los datos observados deberían ser útiles para quienes toman decisiones, así que la visualización orientada a los usuarios debe responder a sus necesidades reales. Esa es la finalidad de este bloque, la capa de paneles e informes.
Voy a ser claro: la mayoría de los paneles son pésimos. O se limitan a mostrar métricas que solo sirven para que la dirección se sienta bien («¡Un 99,99 % de tiempo de actividad!») o sueltan un vómito de datos (50 gráficos por pantalla y nadie sabe qué significa ninguno).
El principio más importante es la jerarquía. La Figura 7.11 muestra el recorrido que propone, desde una vista amplia con poco detalle hasta otra más acotada que permite profundizar. Para crear paneles que de verdad ayuden, sigue estas pautas:
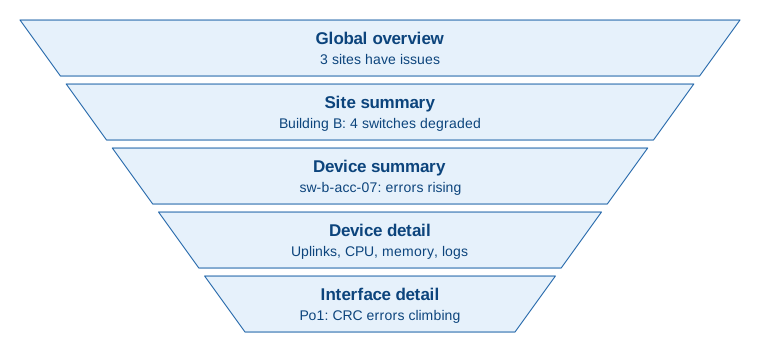
Relevancia. Diseña para tomar decisiones, no para decorar. Cada componente del panel debe responder a una pregunta concreta o desencadenar una acción específica. Si alguien mira un gráfico y no sabe qué hacer con él, elimínalo o rediseñalo.
Claridad. Muestra problemas, no datos en bruto. Los indicadores verdes, amarillos y rojos comunican mejor que las cifras, y cada elemento de la pantalla debe tener una finalidad. «Utilización de la interfaz: 45 %» no sirve de nada. «Utilización de la interfaz: normal» o «ADVERTENCIA: tendencia a la saturación» sí permiten decidir cómo actuar.
Jerarquía. Es mejor poder profundizar por niveles que tener un único panel enorme. Empieza con un resumen del estado general («Hay problemas en 3 sedes»). Haz clic en una sede para ver el estado de sus dispositivos. Haz clic en un dispositivo para ver sus interfaces. Cinco paneles, cada uno con un propósito claro, son mejores que un único panel en el que todo está amontonado.
Destinatarios. Adapta la vista a quien la consulta. El personal del NOC necesita ver el estado operativo en tiempo real y poder profundizar por niveles. La dirección necesita resúmenes de tendencias e información sobre el impacto en el negocio. El personal de ingeniería necesita acceso a los datos en bruto e interfaces de consulta. Un panel que intenta servir a todo el mundo no sirve a nadie.
Interactividad. Hazlo interactivo o ahórrate el esfuerzo. Los paneles estáticos envejecen mal. Permite filtrar, ampliar la vista y ajustar los intervalos de tiempo para que el panel sirva para investigar en vez de limitarse a mostrar imágenes.
Y aquí va la opinión polémica: la mayoría de los equipos tienen demasiados paneles. He visto organizaciones con más de 200 paneles en las que cada persona consulta 2. Elimina los paneles que nadie usa. Si nadie mira un panel en 3 meses, es que no importa.
El límite entre Visualización y Presentación
Los paneles que usan datos de observabilidad para tomar decisiones operativas (¿qué está pasando ahora mismo?, ¿funciona bien este servicio?) pertenecen a Observabilidad, porque los datos determinan su diseño: qué métricas existen, cómo se organizan las alertas y qué recorridos de consulta por niveles admite la capa de persistencia. La forma en que esos paneles llegan a los usuarios sin perfil técnico, se integran en un portal de autoservicio o se incorporan a los flujos de trabajo de gestión de cambios corresponde a Presentación (Capítulo 9). La mayoría de las herramientas de visualización cubren ambas funciones, y Grafana es la más habitual, pero siguen siendo dos cuestiones distintas aunque las resuelva una misma herramienta.
El éxito o el fracaso de la visualización depende de cómo la perciban quienes la usan, así que entrevista a esas personas y hazlas partícipes del diseño.
Con esto quedan cubiertas las siete funcionalidades. Antes de poder confiar en ellas, hay que vigilar un sistema más: la propia automatización.
Observabilidad del sistema de automatización#
La mayoría de los equipos dotan de observabilidad a la red. Pocos hacen lo mismo con el propio sistema de automatización, y ese punto ciego impide que crezca la confianza en la automatización, porque el sistema a menudo falla en silencio. No se activa ninguna alerta, porque puede que sea precisamente el sistema encargado de generarlas el que haya dejado de funcionar.
Un playbook que termina con código de salida 0 tras un despliegue en cero dispositivos no genera ningún error. Una instancia de Telegraf que deja de sondear en silencio un protocolo específico de un fabricante no genera ninguna alerta por falta de datos, salvo que añadas instrumentación específica para detectarlo. Si una tarea de sincronización de la SoT falla a las 02:00 y deja el inventario con 12 horas de desfase, todas las ejecuciones posteriores usarán listas de dispositivos desactualizadas y nada indicará que eso ha ocurrido.
Qué monitorizar en la NAP
Orquestación:
- Evolución de la tasa de éxito de las tareas: un aumento gradual de la tasa de fallos avisa con antelación de que algo se está degradando
- Duración de la ejecución: si una tarea que suele tardar 4 minutos tarda 40 minutos, hay un problema en la NAP, en la red o en ambas
- Tareas que permanecen en estado pendiente o en ejecución más tiempo del previsto
- Frecuencia de las reversiones: un aumento de la tasa de reversiones suele indicar un defecto en los datos de intención o en las plantillas
- Número de dispositivos a los que llega cada tarea frente al previsto: si un despliegue solo llega a 10 dispositivos en lugar de 800, puede que haya fallado la sincronización del inventario sin dar ningún error
Fuente de Verdad:
- Tiempo de respuesta y tasa de errores de la API: si la API de la SoT es lenta, se atascarán todas las tareas de ejecución que la consulten
- Estado de la tarea de sincronización de cada fuente: hora de la última sincronización correcta y número de fallos consecutivos
- Integridad de los datos: cuántos registros de dispositivos carecen de campos obligatorios de los que depende la ejecución
Observabilidad:
- Marca de tiempo de la última recolección correcta por dispositivo: si un dispositivo pasa tres intervalos consecutivos sin sondearse, en la práctica queda fuera de la monitorización
- Retraso de la recolección en el parque de dispositivos: si aumenta la antigüedad media de los datos, el recolector se está quedando atrás
- Ciclos de sondeo perdidos por protocolo: los fallos de SNMP y las interrupciones de las suscripciones gNMI deben contabilizarse por separado y generar alertas distintas
A medida que se extienden las operaciones a cargo de agentes, la única forma de saber qué hacen es observarlos desde una posición neutral. No puedes fiarte de lo que dicen sobre sí mismos. Valida su comportamiento real.
Los fallos de automatización más difíciles de detectar se dan en trabajos que finalizan correctamente sin cambiar nada. Es el problema de los fallos silenciosos. Si un filtro de inventario defectuoso hace que un playbook ejecute un despliegue sobre cero dispositivos, el playbook terminará con el código de salida 0. La única forma de detectar esta clase de fallos es instrumentar la ejecución para medir el resultado: «¿Ha cambiado de estado el número previsto de dispositivos?» en vez de «¿Ha terminado sin errores el proceso del trabajo?».
Esto implica añadir métricas de resultado a los trabajos de ejecución: un contador de dispositivos configurados correctamente, un indicador del número de dispositivos que han necesitado una reversión y una comprobación de que el trabajo ha actuado sobre al menos N dispositivos antes de darlo por satisfactorio.
Recomendación de arquitectura: monitoriza la NAP con una pila de observabilidad mínima e independiente del sistema de observabilidad principal al que la NAP da soporte. Si la instancia principal deja de funcionar, las alertas de la NAP deben seguir operativas. Una pila secundaria ligera (o un servicio SaaS de alertas) que supervise únicamente la salud de los componentes centrales de la automatización (AWX, Telegraf, la API de la SoT y los trabajos de sincronización) ofrece una protección que el sistema de observabilidad principal no puede proporcionarse a sí mismo.
Esto enlaza directamente con el Capítulo 8 (Orquestación): informar de su propio estado operativo debe ser una función prioritaria de un Orquestador que funciona correctamente. Si no puedes observar el Orquestador, tampoco puedes observar la automatización que coordina.
La Parte 3 toma esta lista como punto de partida. El Capítulo 11 ejecuta la pila independiente en la plataforma interna para desarrolladores (IDP) y el Capítulo 12 define las métricas de salud de la NAP y las convierte en niveles de servicio.
Con esto hemos cubierto las siete funciones y el sistema que se supervisa a sí mismo. Antes de ver cómo trabajan juntas en una red real, veamos qué herramientas cubren cada función.
Panorama de soluciones#
La observabilidad no tiene un único mercado de herramientas. Cada función tiene el suyo, y el trabajo de integración está en los puntos de unión entre funciones. Cuando un equipo empieza a elegir la pila por el panel de control, que es la parte visible, suele descubrir las limitaciones decisivas dos capas más abajo: en los protocolos que admite el recolector y en los datos que puede albergar el sistema de almacenamiento.
- Inventario convierte la Fuente de Verdad en una lista actualizada de dispositivos que los recolectores consultan para saber cuáles deben sondear. Las opciones incluyen el descubrimiento de servicios a partir de la SoT, los registros de servicios (Consul, etcd) y el descubrimiento mediante archivos o DNS que ofrece el propio recolector. La diferencia está en si un dispositivo que se da de alta hoy se sondea hoy mismo sin que nadie tenga que editar una lista.
- Recolector se comunica con los dispositivos mediante sus protocolos y extrae datos de la red. Hay agentes multiprotocolo (Telegraf, OpenTelemetry Collector), agentes específicos para gNMI (gNMIc) y agentes orientados al estado (SuzieQ). Se distinguen por los protocolos que admiten. Por muchas otras funciones que desempeñe bien, un recolector sin soporte para SNMP deja fuera tus plataformas más antiguas.
- Procesador normaliza, enriquece y filtra los datos, y obtiene datos derivados antes de que se almacene nada. Las opciones incluyen las cadenas de procesamiento integradas en el recolector, los procesadores de flujos de datos y la cadena de procesadores de OpenTelemetry Collector. Se distinguen por si la transformación se define mediante configuración o código y por si puedes probarla antes de incorporarla al flujo de datos.
- Distribución lleva los datos de los recolectores a los sistemas de almacenamiento y los distribuye a varios consumidores. Las opciones incluyen la recogida periódica de datos a petición del consumidor (scraping), los intermediarios de mensajes (Kafka, NATS) y las cadenas OTLP. La recogida a petición es más sencilla de operar. Un intermediario permite volver a procesar los mensajes y tener consumidores independientes, a costa de mantener un sistema más.
- Persistencia guarda cada tipo de dato en un sistema de almacenamiento diseñado para él. Las opciones incluyen almacenes de métricas (Prometheus, VictoriaMetrics, Mimir, InfluxDB), almacenes de registros (Loki, Elasticsearch) y almacenes relacionales o de grafos para los datos de estado. Se distinguen por el lenguaje de consulta, el modelo de retención y reducción de la resolución, y el punto a partir del cual un solo nodo deja de ser suficiente.
- Alertas y análisis evalúa las condiciones y decide adónde se envía cada resultado. Las opciones incluyen los motores de reglas propios del sistema de almacenamiento con un enrutador de alertas (Alertmanager), las plataformas dedicadas a la gestión de incidentes y las extensiones de detección de anomalías. La diferencia está en si una regla puede comparar los datos con la intención y en si el enrutamiento distingue las alertas destinadas a una persona de las destinadas al Orquestador.
- Visualización presenta los datos a cada público. Las opciones incluyen paneles de control de propósito general (Grafana), consolas NMS de los fabricantes y vistas diseñadas específicamente para redes. Se distinguen por el soporte para múltiples fuentes de datos, ya que un panel que no puede combinar las métricas con los metadatos del inventario muestra cifras sin contexto.
Hay dos cuestiones que afectan a toda la lista. La primera es cuántas de estas funciones conviene cubrir con un solo producto. Una plataforma de un único proveedor que abarque desde la recolección hasta la visualización exige menos trabajo de integración y es más difícil de sustituir por partes. Si combinas siete componentes, puedes sustituirlos por separado y la integración corre de tu cuenta. Ambas opciones son válidas y el factor decisivo suele ser la variedad de protocolos que necesita tu parque de dispositivos.
La segunda cuestión es OpenTelemetry, que, al ser una especificación y no un producto, abarca varias funciones a la vez. Adoptarlo supone apostar por que un formato de transmisión común y una convención semántica común perduren más que cualquiera de los componentes que conectes. Para una cadena de procesamiento greenfield, esa apuesta es cada vez más razonable. Para un parque de dispositivos que ya funciona con SNMP, supone una migración. La sección Fundamentos explica en qué orden abordarla.
Solo queda ver cómo trabajan juntas estas funciones en una red real.
Ejemplo de implementación#
Seguimos con la red de campus del Capítulo 6, donde el bloque de Ejecución extendió el nuevo servicio de VLAN del edificio B a todos los edificios. Ahora toma el relevo la Observabilidad: primero, para comprobar en el estado real de la red que el despliegue ha tenido éxito y, después, para monitorizar de forma continua la salud del servicio en todo el campus.
Escenario: Se despliega un nuevo segmento de servicio de VLAN en unos 800 conmutadores de campus de tres fabricantes. El equipo de operaciones necesita confirmar que el segmento está activo y es coherente en todos los dispositivos previstos, detectar cualquier desviación si un conmutador pierde la VLAN y supervisar la salud del tráfico a lo largo del tiempo, sin comprobaciones manuales dispositivo por dispositivo.
Requisitos:
- Validar tras el despliegue que la pertenencia a la VLAN está activa y es coherente en todos los conmutadores de destino
- Alertar de cualquier desviación de la configuración: ausencia de la VLAN en un conmutador o cambios inesperados en los enlaces troncales que transportan la VLAN
- Supervisar la salud del tráfico del servicio mediante los niveles de utilización y las tasas de error de cada puerto de acceso
- Detectar picos repentinos de tráfico (variaciones superiores al 50 %) que puedan indicar que hay flujos mal encaminados
- Conservar los datos durante 30 días con una resolución de 30 segundos para diagnosticar problemas, y los agregados de 5 minutos durante un año para planificar la capacidad
- Integrarse con la Fuente de Verdad para obtener el inventario de dispositivos y los datos de intención de la VLAN
- Activar flujos de trabajo de orquestación para corregir automáticamente las desviaciones que se detecten
Bloques implicados:
- Fuente de Verdad: contiene el inventario de dispositivos, el perfil de monitorización de cada dispositivo y la definición del servicio de VLAN que sirvió de base para el despliegue
- Ejecución: desplegó el servicio y es el bloque al que vuelve a recurrir el flujo de corrección
- Orquestación: recibe las alertas que llevan una etiqueta de automatización y ejecuta el flujo de trabajo de corrección
- Observabilidad:
- Inventario: sincroniza con la SoT la lista de dispositivos que se van a sondear, de modo que un conmutador que se da de alta hoy se sondea hoy mismo
- Recolector: sondea las plataformas más antiguas mediante SNMP y se suscribe a los datos de las más recientes mediante gNMI
- Procesador: normaliza los datos de ambos protocolos conforme a un único modelo de métricas y los enriquece con la sede, la función y el servicio que constan en la SoT
- Distribución: los recolectores exponen las métricas para su recogida periódica, por lo que, a esta escala, la cadena sigue funcionando a petición del consumidor
- Persistencia: conserva unas 307 000 series con una resolución de 30 segundos durante 30 días
- Alertas y análisis: aplica reglas de desviación y saturación y dirige las alertas a la automatización o a las personas
- Visualización: ofrece una familia de paneles por público y permite pasar de la vista del campus al detalle de cada interfaz
El flujo que se describe a continuación se organiza por funciones. A diferencia de la mayoría de los capítulos de la Parte 2, este deja los nombres de los productos para el final, porque el libro complementario muestra cómo construir esta misma pila en la práctica. Todos son de código abierto, así que puedes montarla por tu cuenta. Ninguna de estas elecciones constituye una recomendación. Como en el resto de la Parte 2, las plataformas de los dispositivos se describen de forma genérica: lo que importa es que hay tres y que no todas utilizan el mismo protocolo.
Arquitectura de la solución#
Empieza por estimar la escala: unos 800 conmutadores de campus × 48 puertos × 8 métricas dan unas 307 000 series temporales activas. Esa cifra queda muy por debajo de lo que maneja con holgura un solo nodo de una base de datos de series temporales, alrededor de un millón de series, pero la capa de recolección necesita más de una instancia para repartir la carga que supone sondear 800 dispositivos cada 30 segundos.
Tres de las siete funciones determinan la elección de los productos porque sus requisitos son los más difíciles de cumplir. Las otras cuatro se derivan de ellas: el Inventario es un pequeño servicio de sincronización, el Procesador se ejecuta dentro del Recolector, la Distribución a esta escala se limita a la recogida periódica de métricas y las Alertas se apoyan en el lenguaje de consulta de la Persistencia. Estas son las necesidades de las tres funciones:
- El Recolector debe admitir varios protocolos porque, en este parque de dispositivos, las plataformas más antiguas utilizan SNMP y las más recientes, gNMI. También necesita procesadores que normalicen los datos de ambos protocolos conforme a un mismo modelo antes de que lleguen al siguiente componente. Para sondear 800 dispositivos cada 30 segundos, una sola instancia va muy justa, por lo que se despliegan dos o tres instancias y un registro de servicios coordina qué dispositivos le corresponden a cada una. No dimensiones esa capa a partir de una fórmula. Observa el consumo real de CPU y memoria y comprueba si cada ciclo de recolección termina dentro de su intervalo. Añade instancias cuando la duración del ciclo empiece a acercarse a la del intervalo y automatiza el ajuste allí donde el entorno de ejecución admita el escalado automático. Ampliar la capacidad de recolección cuesta poco y predecir cuánta hará falta es difícil, así que es preferible medirla a estimarla.
- Persistencia necesita un lenguaje de consulta lo bastante expresivo para formular las condiciones de alerta, porque en este diseño las reglas de alerta se definen mediante consultas y no mediante umbrales sobre una sola serie. Unas 307 000 series son un volumen habitual para cualquier base de datos de series temporales. Lo que marca la diferencia es el lenguaje de consulta.
- Visualización necesita más de una fuente de datos, porque un cuadro de mando útil combina las métricas con los metadatos del inventario que indican a qué sede, función y servicio corresponde cada métrica. Si la capa de cuadros de mando solo puede leer el almacén de métricas, muestra cifras sin contexto.
Arquitectura
La Figura 7.12 muestra los componentes principales y sus funciones:
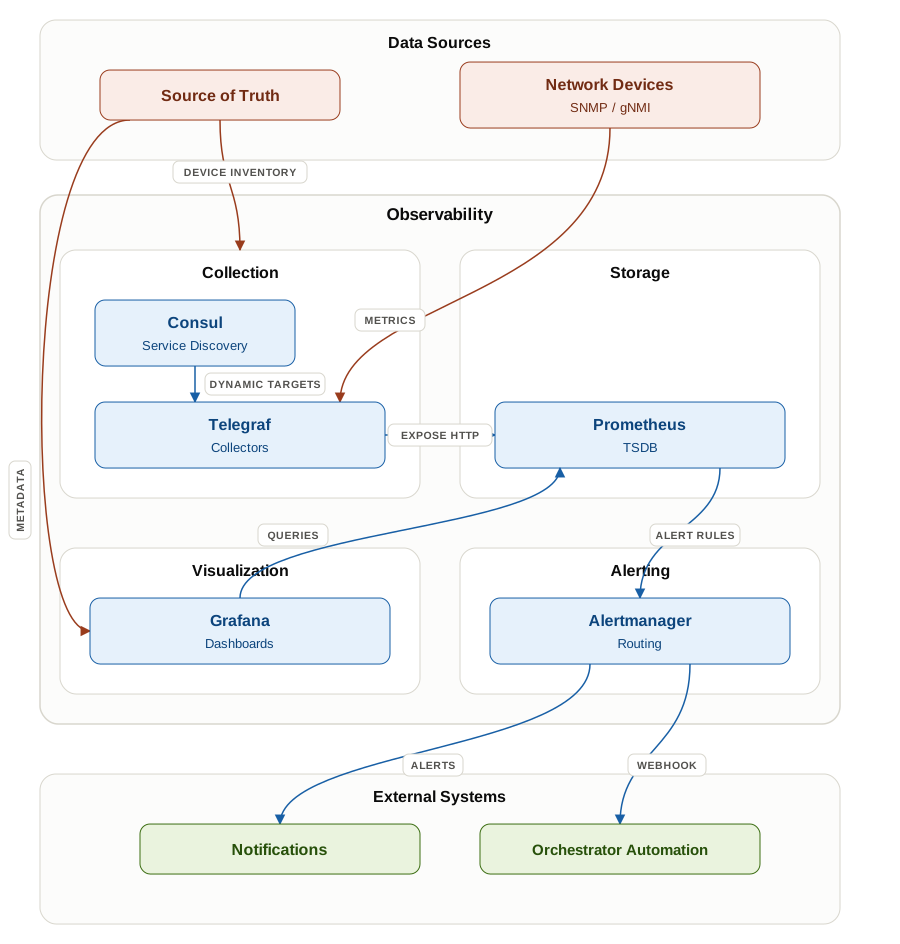
El libro Modern Network Observability describe esta arquitectura en detalle. Si buscas un enfoque práctico con un escenario que puedas probar en el laboratorio, dale una oportunidad.
Flujo de implementación#
Las siete funciones intervienen en orden y cada una pasa el resultado a la siguiente:
Identificar los dispositivos que se van a monitorizar. La Fuente de Verdad define qué dispositivos hay que monitorizar y asigna a cada uno un perfil de monitorización y una referencia a sus credenciales. Un servicio ligero de sincronización, un script que se activa mediante webhooks, mantiene al día un registro de servicios. Así, la función de Inventario proporciona a los recolectores una lista de dispositivos que se actualiza automáticamente, sin que nadie tenga que mantenerla a mano.
Recopilar. El Recolector utiliza ese registro para el descubrimiento de servicios y empieza a sondear cada dispositivo en cuanto aparece. Utiliza SNMP en las plataformas más antiguas y gNMI en las más recientes.
Normalizar y enriquecer. El Procesador se ejecuta dentro del Recolector. Convierte los códigos de estado en etiquetas, cambia los nombres de los campos para ajustarlos al modelo común y añade los datos de sede, función y servicio que obtiene de la SoT. Después publica el resultado en un punto de acceso HTTP para su recogida periódica.
Almacenar. Persistencia utiliza el mismo registro de servicios para localizar esos puntos de acceso, recoge sus datos periódicamente y conserva las series durante 30 días con una resolución de 30 segundos. Las reglas de registro precalculan la utilización de las interfaces y las tasas de transferencia, tal como establece el patrón de métricas compuestas de la sección sobre el Procesador. Una copia con resolución reducida a 5 minutos conserva un año de histórico para planificar la capacidad.
Detectar. Las reglas de alerta expresan las condiciones que se quieren detectar: falta una VLAN donde la SoT indica que debería estar, la utilización supera el 80 % durante cinco minutos o el tráfico varía más de un 50 %. Un enrutador de alertas decide el destino de cada alerta. Aquí es donde se aprecia la utilidad del contrato que vincula las alertas con las acciones. Las alertas con la etiqueta
automation: enabledllegan al webhook del Orquestador como mensajes con datos estructurados. Las demás se envían a un canal de chat o a un servicio de avisos de guardia según su gravedad.Mostrar. Visualización ofrece una familia de cuadros de mando para cada público: tendencias de uso del ancho de banda en todo el campus, interfaces con mayor saturación y vistas detalladas de cada dispositivo con mapas de calor de sus interfaces. Las variables de plantilla permiten filtrar por sede, función o dispositivo. Los cuadros de mando consultan el almacén de métricas para obtener las cifras y la SoT para obtener los metadatos que les dan contexto.
Actuar. El Orquestador recibe un mensaje con datos estructurados que alerta de una desviación: falta la VLAN 412 en un conmutador donde, según la SoT, debería estar. El Orquestador ejecuta el flujo de trabajo de corrección al amparo de una autorización de cambio vigente para esta clase de desviaciones (Capítulo 16). Encarga al Ejecutor que vuelva a desplegar la VLAN únicamente en ese conmutador y después pide a Observabilidad que confirme la corrección. Así se cierra el bucle. El Capítulo 8 explica cómo se coordinan estos pasos.
En este ejemplo, Nautobot actúa como Fuente de Verdad, Consul como registro de servicios y Telegraf como Recolector y Procesador. Prometheus se encarga de la Persistencia, Alertmanager del enrutamiento de alertas y Grafana de la Visualización. Todos los componentes son de código abierto y se pueden sustituir. Si cambias la base de datos de series temporales, los pasos del 4 al 6 conservan su estructura y solo cambia la sintaxis de sus consultas. La Figura 7.12 muestra este mismo flujo con esos componentes.
Resumen de la solución#
Ventajas operativas:
- Menos trabajo manual de monitorización gracias a la integración con la SoT
- Detección proactiva de problemas con una latencia inferior a un minuto
- Corrección en bucle cerrado que reduce el Tiempo medio de recuperación (MTTR) de horas a minutos
- Contexto detallado gracias a la combinación de métricas y datos de inventario
Consideraciones de escalabilidad:
- La arquitectura actual da servicio a unos 800 conmutadores de campus con dos o tres instancias distribuidas del Recolector detrás de un registro de servicios. Para incorporar más edificios o dispositivos basta con añadir instancias del Recolector sin rediseñar la arquitectura
- Persistencia admite unas 307 000 series con margen de crecimiento. Un solo nodo admite hasta un millón de series aproximadamente antes de que sea necesario recurrir a la federación o a un sistema de almacenamiento distribuido
Con este ejercicio se cierra el capítulo: siete funciones, una red de campus y una pila de herramientas que podrías poner en marcha esta misma semana.
Resumen#
La monitorización (u Observabilidad) existe desde hace mucho tiempo, pero no todo el mundo la asocia con la automatización de redes. La Observabilidad es un bloque fundamental de la arquitectura de automatización de redes porque permite comprender cómo se comporta realmente la red. Ves cuál es su estado real, más allá del que deseas.
En este capítulo también he incluido el bloque del Recolector porque considero que está estrechamente integrado con el de Observabilidad. Juntos forman una pila completa que permite conocer el estado de la red. El proceso empieza con el descubrimiento de la red a partir de la Intención mediante un inventario dinámico y continúa con la recogida, el procesamiento y la distribución de los datos. Por último, una vez almacenados los datos, las funciones de alerta, análisis y visualización los utilizan para enviar un evento al Orquestador o proporcionar una visualización adecuada a la capa de Presentación.
También es importante incluir la observabilidad de la propia NAP y mantenerla desacoplada de la observabilidad de la red. Vigila el sistema de monitorización para que no queden puntos ciegos.
El bloque que sigue de forma natural a Observabilidad es Orquestación, que se trata en el Capítulo 8 y puede recibir los resultados de Observabilidad y decidir cómo actuar.
Referencias#
- Modern Network Observability, David Flores, Christian Adell y Josh VanDeraa (Packt, 2024). Un enfoque práctico de la observabilidad de redes con herramientas de código abierto como Telegraf, Prometheus y Grafana.
- Observability Engineering, Charity Majors, Liz Fong-Jones y George Miranda (O’Reilly, 2022). Explica la diferencia entre monitorización y observabilidad y los motivos para utilizar la telemetría de alta cardinalidad basada en eventos que sustenta el modelo de datos de este capítulo.
- Site Reliability Engineering, Betsy Beyer, Chris Jones, Jennifer Petoff y Niall Richard Murphy (O’Reilly, 2016). Monitorización, las cuatro señales de oro y diseño de SLI y SLO. (Texto completo disponible gratuitamente en línea.)
- Network Programmability and Automation, 2nd Edition, Matt Oswalt, Christian Adell, Scott S. Lowe y Jason Edelman (O’Reilly, 2023). Telemetría en flujo continuo, gNMI y recogida de datos guiada por modelos que alimentan los bloques de Recolector y Observabilidad.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo