Ejecución#
Un playbook llevaba meses ejecutándose sin problemas. Se ejecutaba en los tres switches de acceso del laboratorio y tardaba dos minutos de principio a fin, siempre sin errores. Había llegado el momento de ejecutarlo en todo el inventario de la red (800 switches). ¿Qué podía salir mal? Nadie esperaba problemas.
La realidad fue otra. Los primeros 600 dispositivos ejecutaron el playbook sin problemas, pero después el trabajo empezó a ralentizarse. Más tarde, se quedó bloqueado. El servidor RADIUS no pudo atender las 150 solicitudes simultáneas de autenticación SSH. Empezó a rechazar conexiones y el trabajo se quedó bloqueado en 150 dispositivos a mitad de la ejecución. Un ingeniero tuvo que forzar manualmente la terminación del trabajo.
Ese no era el mayor problema. Tras el fallo, nadie sabía qué switches habían aplicado el cambio (los 600 que habían terminado), en cuáles había quedado a medias (los 150 en los que se había bloqueado el trabajo) ni cuáles eran los 50 a los que el trabajo nunca había llegado. No había ningún informe sobre el estado de la ejecución. El siguiente intento parecía obvio: volver a ejecutar el playbook y confiar en que la idempotencia les sacara del apuro. Así fue, pero nadie podía darlo por hecho, porque no la habían validado antes.
El incidente puso de manifiesto algo importante: habían diseñado la automatización para el laboratorio, no para la red real. Una capa de ejecución fiable debe tener en cuenta muchas variables que, en este caso, no habían considerado debidamente.
La mayoría de la gente entiende la automatización de redes así: «tomar los mismos datos y hacer algo en la red sin que una persona tenga que conectarse a la interfaz de línea de comandos (CLI)». Apostaría a que la mayoría de quienes se inician en la automatización de redes empiezan por ahí. Y sí, eso es lo que hace el bloque de Ejecución. Pero, como has visto a lo largo del libro, la automatización de redes va más allá de ese primer paso y la Ejecución es solo un componente de la arquitectura.
El bloque de Ejecución interactúa directamente con la red en las operaciones más peligrosas, como los cambios de configuración o los reinicios. Así que no te saltes este capítulo.
En este capítulo explicaré qué objetivos persigue este bloque, qué funciones abarca y qué capacidades internas necesita para cumplir esos objetivos.
Fundamentos#
La Ejecución define cómo llegan las acciones a la red. El bloque de Intención determina el qué y la Orquestación, el cuándo.
En los primeros proyectos de automatización de redes, un primer logro puede ser un script que, al indicarle un dispositivo y el nombre de una interfaz, la desactive y la vuelva a activar. Lo que empieza con ese único script acaba convirtiéndose en un sistema mucho más sofisticado.
¿Qué necesita hacer realmente un sistema de ejecución? Hay cinco aspectos importantes:
Ten a punto los datos adecuados. Antes de ejecutar nada, necesitas saber qué vas a ejecutar (la intención), dónde (en qué dispositivos) y cómo acceder a ellos (credenciales y datos de conexión). Para ello, debes obtener el inventario y el estado deseado de la Fuente de Verdad (SoT) (encontrarás más detalles en el capítulo 4 y el capítulo 5) y, a veces, consultar los datos de observabilidad para conocer las condiciones actuales. Sin esta integración, tu motor de ejecución se limita a ejecutar comandos a ciegas. Por tu salud mental, evítalo.
Inicia la ejecución cuando haga falta, ya sea ahora o más adelante. A veces necesitas una ejecución inmediata: un ingeniero pulsa «Desplegar» y espera que el despliegue comience en ese momento. Otras veces, la ejecución debe esperar: puede que haya que desplegar durante la ventana de mantenimiento, esperar a que un dispositivo esté en línea o reaccionar a un evento de observabilidad. El sistema debe admitir tanto activaciones síncronas como asíncronas.
Haz un seguimiento del estado a lo largo del tiempo. Las operaciones que abarcan toda la red no son instantáneas. Un despliegue en cientos de dispositivos puede llevarte horas. ¿En qué dispositivos ha terminado correctamente? ¿En cuáles ha fallado? ¿Cuáles siguen pendientes? La gestión del estado también permite la idempotencia (ejecutar dos veces la misma tarea y obtener el mismo resultado), la reversión (deshacer lo que acabas de hacer) y la reanudación (retomar el trabajo donde lo dejaste tras un fallo). Sin un seguimiento del estado, te lo juegas todo a una carta en cada ejecución.
Ejecuta de forma fiable a escala. Un script que funciona con 5 dispositivos a menudo falla (o pierde rendimiento) con 500. Puede que necesites ejecución en paralelo, gestión de errores, reintentos, límites de frecuencia y funciones de simulación. El sistema debe gestionar los fallos parciales de forma controlada, indicar con claridad qué ha salido mal y no dejar nunca la red en un estado indefinido. Cada operación necesita su propia estrategia. Algunas son rápidas y se ejecutan en paralelo. Otras son lentas y se ejecutan en serie.
Trabaja con cualquier dispositivo o plataforma de red. Probablemente tu red incluya switches y routers de varios fabricantes, cortafuegos de otros, dos nubes públicas y equipos Linux. Cada uno requiere una sintaxis propia, utiliza protocolos distintos y tiene sus propias pautas de funcionamiento. Tu capa de ejecución necesita adaptadores para todos ellos: cada adaptador toma la intención, que es independiente del fabricante, la convierte a la sintaxis de su plataforma y la entrega. Así, el resto de la automatización no necesita tener en cuenta esas diferencias.
Estos cinco objetivos también delimitan el bloque: qué hace el propio Ejecutor y qué deja en manos de los bloques vecinos.
Qué entra en su ámbito
- Generar a partir de plantillas o traducir la intención de la capa técnica a la sintaxis de cada plataforma mediante adaptadores versionados
- Conectarse a los dispositivos de red mediante cualquiera de los protocolos admitidos
- Aplicar cambios de configuración, ejecutar comandos operativos, transferir archivos y reiniciar dispositivos
- Gestionar el estado de la ejecución y seguir su progreso
- Gestionar errores, reintentos y reversiones
- Informar a la Orquestación sobre la ejecución
Qué queda fuera de su ámbito
- Decidir qué configurar (corresponde a la Intención)
- Orquestar flujos de trabajo complejos con varios pasos y decidir cuándo iniciarlos (corresponde a la Orquestación)
- Almacenar y analizar a largo plazo los resultados de la ejecución (corresponde a la Observabilidad)
Piensa en la ejecución como en el motor de un coche: proporciona potencia y movimiento, pero no decide adónde ir ni cuándo girar. Esas decisiones las toma quien conduce (la Orquestación) siguiendo un mapa (la Intención).
A continuación veremos qué funciones debe ofrecer este bloque para alcanzar esos objetivos.
Funciones#
Cinco funciones trabajan en conjunto para modificar el estado de la red de forma segura y fiable. La Figura 6.1 muestra qué objetivo cumple cada una.
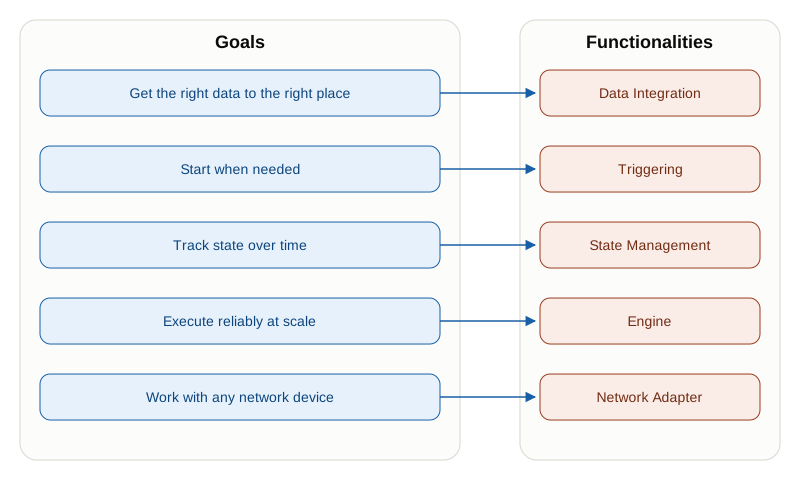
- Integración de datos. Deja preparados la intención, el inventario y las credenciales antes de que se ejecute nada. Para ello, obtiene datos de la Fuente de Verdad, de la observabilidad y del sistema de gestión de secretos.
- Activación. Inicia la ejecución de forma síncrona cuando una persona espera la respuesta y de forma asíncrona cuando quien la espera es otro componente.
- Gestión del estado. Lleva un seguimiento del punto en que se encuentra la ejecución y del estado de los dispositivos. Así hace posibles la idempotencia, la reanudación y la reversión.
- Motor. Ejecuta la tarea. Determina cómo se expresa la lógica, qué parte se ejecuta a la vez, desde dónde se ejecuta y qué ocurre si una parte falla.
- Adaptador de red. Genera a partir de plantillas o traduce la intención a la sintaxis de cada plataforma, utiliza sus protocolos y gestiona las conexiones subyacentes. Así, ningún componente por encima de esta capa necesita saber qué sintaxis o interfaz utiliza un dispositivo.
Estos componentes forman una cadena: la integración de datos proporciona los datos de entrada, la activación pone en marcha el proceso, el motor ejecuta las tareas mediante los adaptadores de red y la gestión del estado hace un seguimiento de todo el proceso de principio a fin.
Siguiendo ese orden, veamos primero qué integraciones de datos necesita este bloque.
Integración de datos#
Hay muchas integraciones distintas, pero la fundamental es la integración con la Fuente de Verdad, que permite saber qué hacer y dónde hacerlo.
De todos los datos de intención, el punto de partida es el Inventario. Los datos del inventario definen los dispositivos de destino. Ya lo vimos en el capítulo 4, pero, como mínimo, necesitas:
- Destino: dirección Internet Protocol (IP) o nombre de dominio completo (FQDN) para acceder al dispositivo, o bien un identificador y una cuenta si se trata de un servicio en la nube
- Plataforma/SO: tipo de dispositivo o servicio, fabricante o proveedor y versión (estos datos determinan qué protocolo y qué sintaxis debes utilizar para los artefactos de configuración)
- Credenciales: nombre de usuario y contraseña, claves de Secure Shell (SSH), tokens de interfaz de programación de aplicaciones (API) y rutas de los certificados
- Parámetros de conexión: puerto SSH, tiempos de espera y puntos de acceso de la API
Ese es el mínimo. También puedes obtener más datos de la capa técnica de la Fuente de Verdad para ajustar el comportamiento de un trabajo. Por ejemplo, la ubicación, la función (spine/leaf/edge) o el entorno (producción/preproducción) pueden cambiar la forma en que el Ejecutor ejecuta su lógica.
Los datos del inventario siempre proceden del bloque de Intención, aunque en muchos casos ese límite no está tan claro. Por ejemplo, Ansible, una herramienta muy popular para implementar el Ejecutor, utiliza archivos YAML (host_vars, group_vars). Los datos de esos archivos pertenecen al bloque de la Fuente de Verdad. Como ya hemos visto, una herramienta puede implementar muchas funciones y muchas herramientas pueden implementar una misma función.
El inventario nunca contiene credenciales, solo referencias a ellas. La Fuente de Verdad indica qué secreto utiliza cada dispositivo. Al iniciar el trabajo, el Ejecutor resuelve esa referencia y conserva el valor solo mientras dura el trabajo. El Ejecutor debe admitir varias fuentes de credenciales y permitir que se sustituyan las credenciales predeterminadas para un dispositivo concreto, porque rara vez todo un parque de dispositivos comparte una sola cuenta. Más adelante en este capítulo veremos qué consecuencias tiene para la seguridad gestionar esto de forma incorrecta.
Por último, lo esencial de la integración con la Fuente de Verdad es la propia intención, es decir, qué quieres configurar o cambiar:
- Datos de la capa técnica: la propia intención, independiente del fabricante, que el adaptador expresa en la sintaxis del dispositivo mediante plantillas o por traducción.
- Comandos: comandos concretos de la CLI o llamadas a la API que se ejecutan para realizar operaciones en el dispositivo.
- Archivos: imágenes de software para actualizaciones y archivos de configuración para importar.
La intención de configuración siempre llega como datos de la capa técnica, nunca en la sintaxis del fabricante. Estos datos están disponibles para cada elemento del inventario incluido en la operación. Convertirlos a la sintaxis de cada dispositivo es tarea del adaptador, como veremos en la sección Generación a partir de plantillas y traducción.
¿Debe el propio Ejecutor obtener los datos de intención o debe proporcionárselos el componente que lo invoca (por ejemplo, la Orquestación)? Ambas opciones funcionan. Obtener la intención directamente vincula la ejecución a tu Fuente de Verdad, pero garantiza que los datos estén siempre actualizados. Recibir la intención como parámetros hace que la ejecución sea más genérica, pero exige que la Orquestación se encargue de obtener los datos.
Un artefacto generado a partir de una plantilla puede quedar obsoleto entre su generación y su despliegue. Si los datos de la SoT cambian después de generar y aprobar el artefacto, al desplegarlo se aplica una configuración desactualizada. La ventana en la que el artefacto puede quedar obsoleto es el intervalo entre la generación y el despliegue. Si la automatización genera el artefacto en el momento de la activación, ese intervalo es mínimo. En los flujos de trabajo que lo generan durante la validación y lo despliegan en una ventana de mantenimiento posterior, el intervalo puede llegar a ser de horas o días. Antes de desplegar, comprueba que sigue vigente la versión de la intención con la que se generó el artefacto. Si ha cambiado, genera el artefacto de nuevo y somete la nueva versión a otra revisión.
Comparar el estado deseado con el estado real forma parte del análisis que realiza la Observabilidad. Decidir qué hacer con el resultado corresponde al Orquestador. La comparación que hace el propio Ejecutor es más acotada: simula en tiempo real el cambio que está a punto de aplicar y muestra las diferencias. Sin embargo, cuando transcurre un tiempo entre la decisión y la ejecución, puede que el Ejecutor necesite comprobar los datos reales justo antes de proceder. Por ejemplo:
- Validación previa a la ejecución: ¿se puede acceder al dispositivo? ¿Hay suficiente espacio en disco para una actualización? ¿Hay sesiones activas que se interrumpirían?
- Degradación controlada: antes de reiniciar un switch, consulta los datos de observabilidad para comprobar si hay conectividad redundante. Si no la hay, aplaza o cancela el reinicio.
- Lógica condicional: aplica una configuración solo si se cumplen determinadas condiciones, como que el uso de la unidad central de procesamiento (CPU) esté por debajo del umbral, que no haya alarmas activas o que la hora esté dentro de la ventana prevista.
- Capacidad para desviar el tráfico: antes de iniciar una operación de desvío de tráfico, comprueba que la capacidad disponible sea suficiente para absorber el cambio sin incumplir los objetivos de nivel de servicio (SLO).
Un patrón habitual consiste en utilizar módulos de recursos de Ansible en estado gathered o tareas de Nornir que recopilan datos de los dispositivos para consultar los datos de observabilidad antes y después de la ejecución y comparar los resultados en busca de cambios inesperados. Tomar una instantánea antes y otra después permite detectar regresiones que de otro modo pasarían inadvertidas. Una vez más, la misma herramienta que actúa como Ejecutor podría actuar como Recolector, pero incluso en ese caso las responsabilidades siguen separadas.
¿Qué pone en marcha el Ejecutor? Puede ser un cambio en la Fuente de Verdad, una acción de autorrecuperación o una persona que, durante una demostración, necesita simular la caída de una interfaz. De una forma u otra, algo tiene que poner en marcha el Ejecutor.
Activación#
La ejecución no empieza por sí sola. Algo tiene que activarla. Hay dos patrones principales:
Síncronos (inmediatos y bloqueantes):
- Llamadas a la API: Un sistema externo o un usuario invoca un punto de acceso de la API. La tarea se ejecuta y la respuesta incluye los resultados. Así de sencillo y directo.
- La capa de Presentación mediante comandos de la CLI o llamadas a la API: Los ingenieros lanzan comandos que inician directamente la ejecución (
ansible-playbook,terraform apply, scripts propios). Estos comandos de la CLI forman parte de la capa de presentación ligera que ofrecen estas herramientas (más detalles en el capítulo 9).
Asíncronos (diferidos o activados por eventos):
- Webhooks: Los sistemas externos (Git, sistemas de gestión de incidencias, CI/CD) envían peticiones Hypertext Transfer Protocol (HTTP) cuando se produce un evento, sin esperar a que termine el despliegue. Un patrón habitual: un push en Git desencadena el despliegue de la configuración.
- Procesos de escucha de eventos: Reaccionan a eventos procedentes de la observabilidad (caída de un dispositivo, superación de un umbral), de colas de mensajes o de sistemas externos. Event-Driven Ansible (EDA) incorpora este patrón de forma explícita: escucha los eventos, comprueba qué reglas se cumplen y lanza automáticamente los playbooks correspondientes.
- Colas de mensajes: Las tareas se envían a una cola (RabbitMQ, Kafka, AWS SQS) y los procesos de trabajo las extraen y las ejecutan. Así puedes almacenar tareas temporalmente, gestionarlas en colas con prioridades y limitar el ritmo de ejecución.
El enfoque adecuado depende de tu caso de uso. Los cambios inmediatos (como resolver un problema en producción) requieren desencadenantes síncronos. La automatización reactiva (como responder a alertas) utiliza procesos de escucha de eventos. La escala también influye, como veremos en el capítulo 12.
Normalmente, la Orquestación inicia la ejecución. Si no dispones de ese bloque, otros pueden iniciarla directamente. Por ejemplo, puedes iniciarla desde la capa de Presentación mediante una tarea que el usuario puede lanzar, o desde el bloque de la Fuente de Verdad.
La ejecución puede consistir en una tarea dirigida a un único dispositivo, pero esa misma tarea también puede ejecutarse en paralelo en varios dispositivos. En ese caso, hay que coordinar el estado.
Gestión del estado#
Gestionar el estado consiste en llevar la cuenta de en qué punto de la ejecución estás y cómo está el entorno para que puedas tomar decisiones con criterio.
Hay varios tipos de datos de estado que conviene seguir:
- ¿Qué dispositivos se han procesado ya?
- ¿Qué tareas han terminado con éxito, cuáles han fallado y cuáles siguen pendientes?
- Si una tarea ha fallado por un error transitorio, ¿podemos volver a intentarlo?
- Si la ejecución se ha interrumpido, ¿podemos reanudarla donde la dejamos?
- ¿Qué configuración tiene ahora mismo la infraestructura?
Puedes responder a la mayoría de estas preguntas dentro de una sola ejecución. La última corresponde al bloque de Observabilidad, aunque la funcionalidad que permite responderla suele implementarse aquí. Hay dos formas de abordarla:
Sin estado (p. ej., Ansible). Cada ejecución es independiente. El estado no persiste entre ejecuciones. Cada vez empiezas de cero: obtienes el estado actual, calculas las diferencias y aplicas los cambios. Es más sencillo de operar (no hay una base de datos de estado), pero menos eficiente (tienes que volver a descubrirlo todo cada vez) y carece de reversión integrada.
Con estado (p. ej., Terraform). El sistema conserva un archivo de estado persistente que registra qué se desplegó por última vez. En cada ejecución, compara el estado deseado (tu configuración), el estado registrado (lo que desplegaste la última vez) y el estado real (lo que hay en el dispositivo). Así puedes planificar los cambios con precisión, ejecutarlos de forma eficiente (solo cambias lo que difiere) y revertirlos (volver al estado anterior). A cambio, tienes que proteger y bloquear el archivo de estado y mantenerlo sincronizado entre varios operadores.
El seguimiento con estado parece ideal, pero solo funciona si todos los cambios pasan por la herramienta. Basta con que un ingeniero corrija algo a mano a las 02:00 para que el archivo de estado deje de reflejar la realidad. A partir de ahí, en vez de desplegar recursos, te toca importarlos y volver a sincronizarlos. Por eso Terraform funciona bien en la nube, donde la API es la única vía de acceso, y mal en los switches, donde la consola siempre está disponible.
La ejecución transaccional es el siguiente paso si buscas garantías de seguridad más firmes que las de una ejecución que se limita a hacer lo que puede. Una transacción agrupa varios cambios en dispositivos en una sola unidad: o se aplican y validan todos, o el sistema vuelve al estado anterior. Para ello hacen falta tres cosas:
- Un límite claro (qué operaciones forman parte de la transacción)
- Un registro duradero del estado previo al cambio (para la reversión)
- Un mecanismo de bloqueo o de concesión temporal que impida que los cambios concurrentes rompan la atomicidad
La automatización de redes suele conformarse con un comportamiento «similar al de una transacción» en lugar de aplicar estrictamente la semántica Atomicidad, consistencia, aislamiento y durabilidad (ACID), es decir, las garantías que ofrece una base de datos a una transacción. El motivo es que no todos los dispositivos admiten de forma nativa la confirmación y la reversión de cambios. Aun así, puedes aproximarte al comportamiento de una transacción si tomas instantáneas, utilizas configuraciones candidatas (cuando el dispositivo las admite), impones bloqueos exclusivos e incorporas las vías de reversión como parte fundamental del flujo de ejecución.
Cuando intervienen varios dispositivos, «revertir» suele significar compensar: el patrón Saga (Saga Pattern) del capítulo 8 deshace los pasos completados en orden inverso. Restaurar la configuración no borra todos los efectos: una sesión Border Gateway Protocol (BGP) puede haber caído y vuelto a establecerse, y el tráfico perdido durante el cambio no se recupera. Por eso, además de intentar evitar los cambios parciales, el flujo de ejecución debe detectarlos y registrarlos.
¿Dónde está la dificultad? En compartir el estado y mantenerlo sincronizado. Si varias personas o sistemas modifican los dispositivos de red, el estado registrado se queda obsoleto. Terraform aborda el problema con almacenamiento remoto del estado y bloqueos. Ansible lo evita al no conservar el estado, pero pierde eficiencia. Hay un término medio: guardar el estado actual temporalmente en caché, validarlo antes de cada operación y aplicar patrones de «consistencia eventual» (eventual consistency) allí donde se admitan discrepancias breves.
Como vimos en los principios de diseño, la idempotencia es fundamental para que puedas confiar en tu sistema de automatización de redes. Y es aquí, en el Ejecutor, donde se consigue en gran medida.
La idempotencia significa que, por muchas veces que ejecutes la misma automatización, obtendrás el mismo resultado. Aplica una vez la configuración de una VLAN: se crea la VLAN. Vuelve a aplicarla: nada cambia (la VLAN ya existe). Si la ejecución falla a mitad de camino, puedes repetirla con seguridad, sin crear duplicados ni estropear nada. De eso depende la fiabilidad.
Cómo consiguen las herramientas la idempotencia:
Módulos integrados (p. ej., Ansible): La mayoría de los módulos de Ansible son idempotentes por diseño. El módulo
cisco.ios.ios_vlanscomprueba si la VLAN existe antes de crearla. Si ya existe y tiene la configuración correcta, Ansible indica «ok» (sin cambios). Para ello, el autor del módulo tiene que implementar la lógica de comprobación.Comparación de estados (p. ej., Terraform): Terraform compara el estado deseado con el actual, calcula las diferencias y aplica solo esas diferencias. Si ejecutas
terraform applydos veces sin modificar la configuración, la segunda ejecución no hace nada.API declarativas (p. ej., NETCONF con modelos Yet Another Next Generation (YANG)): Algunos protocolos incorporan la idempotencia de forma nativa. Envía dos veces la misma operación
<edit-config>de NETCONF conmergey el almacén de datos quedará en el mismo estado: la operación merge crea o actualiza lo que haga falta. La garantía, sin embargo, tiene un alcance limitado. La operación merge nunca elimina nada, por lo que no puede retirar aquello que la intención ya no incluye. Volveremos sobre esta limitación en el capítulo 10.Comprobación manual (p. ej., con scripts escritos desde cero): Es el último recurso. Si escribes scripts en Python o Go, tú mismo implementas la idempotencia: consultas el estado actual, lo comparas con el deseado y cambias solo lo que difiere. Eso implica analizar cada salida, tratar cada caso límite y mantener todo ese código con cada nueva versión de firmware. Elige esta opción solo cuando ningún módulo ni ninguna interfaz declarativa sean compatibles con el dispositivo.
La idempotencia es más difícil de lo que parece. ¿Y si la VLAN existe, pero tiene una configuración incorrecta? ¿Deberías actualizarla (con el riesgo de interrumpir el tráfico) o informar de un conflicto? ¿Y los fallos transitorios (por ejemplo, cuando un dispositivo está temporalmente inaccesible)? La lógica de reintento debe distinguir entre «la operación ya se ha realizado» (éxito por idempotencia) y «la operación ha fallado» (error real).
La idempotencia tiene un coste, y el trabajo adicional depende de quién haga la comparación. Con la operación merge de NETCONF, el propio dispositivo concilia el estado, por lo que no hace falta una lectura adicional. Un módulo declarativo de recursos también lee primero el estado del dispositivo, pero lo hace una vez por tarea, no una vez por línea. Con scripts escritos desde cero, asumes el coste de cada comprobación: una lectura por dispositivo antes de cada escritura (por eso las herramientas declarativas escalan mejor).
Por último, el Motor determina qué lógica admite y cómo puedes definirla.
Motor#
El motor de ejecución es la lógica central que recibe una tarea («configura esta VLAN en estos 50 switches») y la ejecuta de forma segura y eficiente. Esto no es Orquestación. El bloque de Orquestación coordina en el tiempo varias tareas de ejecución y tiene en cuenta sus dependencias. El motor se limita a ejecutar bien una tarea (o una cadena sencilla de tareas).
El motor recibe la definición de una tarea, la descompone en operaciones para cada dispositivo, las ejecuta con el grado de concurrencia adecuado, gestiona los fallos e informa de lo ocurrido. De ahí surgen las seis preguntas de diseño a las que dedicamos el resto de esta sección. ¿Cómo expresas la lógica, cuántas operaciones se ejecutan a la vez y desde dónde se ejecutan? ¿Qué puedes ver antes de confirmar los cambios, cómo compruebas el resultado y qué ocurre si falla una parte?
Un motor puede configurar 100 routers en paralelo, pero la Orquestación decide cuándo hacerlo, qué configuración aplicar y qué hacer después. La Ejecución hace el trabajo y la Orquestación lo dirige.
Dicho esto, los motores de ejecución suelen permitir encadenar tareas sencillas: «ejecuta la tarea A y después la tarea B en los mismos dispositivos». Eso es una secuencia básica, no una Orquestación completa. Cuando necesitas flujos de trabajo complejos (esperar una aprobación externa, seguir una rama u otra según los resultados o coordinar varios sistemas), necesitas una verdadera capa de Orquestación (más detalles en el capítulo 8). Por ejemplo, esta secuencia puede constituir un único flujo de ejecución: actualizar el firmware, esperar a que se reinicie un dispositivo, verificar su funcionamiento y actualizar el inventario. Pero si requiere validación humana o si el camino que se siga depende de una validación más amplia, corresponde al bloque de Orquestación.
Lo primero que define el Motor es cómo expresas la lógica de ejecución. Cada estilo de lenguaje tiene sus ventajas y sus limitaciones, como muestra la Tabla 6.1:
| Estilo | Ejemplos | Ventajas | Limitaciones |
|---|---|---|---|
| Lenguajes específicos de dominio (DSL) | Ansible (YAML), Terraform (HCL) | Más fáciles de aprender, la intención queda documentada en el propio código, semántica de ejecución integrada | Flexibilidad limitada, depuración más difícil en situaciones complejas, la lógica condicional puede resultar engorrosa |
| Programación de propósito general | Nornir (Python), scripts propios en Python o Go | Flexibilidad total, buenas herramientas de depuración, facilidad para reutilizar bibliotecas | Exige más conocimientos, hay más código que mantener y menos uniformidad entre equipos |
Muchos equipos utilizan DSL (como los de Ansible) para los patrones habituales y recurren a código propio (módulos de Python, plugins) para los casos límite complejos. Así equilibran la facilidad de uso y la potencia. El factor humano suele decidir qué enfoque se impone. Lo veremos con más detalle en el capítulo 14.
Sea cual sea el lenguaje, hay dos patrones básicos para definir acciones.
Enfoque imperativo frente a enfoque declarativo#
Como ya vimos al definirlos en el capítulo 2, hay dos patrones para definir acciones:
Imperativo (Imperative): Especificas cómo hacer algo, paso a paso.
Declarativo (Declarative): Especificas cuál debe ser el estado final y la herramienta determina cómo conseguirlo.
El enfoque declarativo es más sencillo para quien escribe la tarea y es el camino más corto hacia la idempotencia. Pero no hay ningún truco: el trabajo no desaparece, cambia de manos. Alguien tiene que escribir el módulo que lee el estado actual, calcula las diferencias y resuelve los casos límite para que, a partir de ahí, quienes lo usen solo tengan que declarar el estado final. Si nadie ha hecho ese trabajo para tu entorno, vuelves al enfoque imperativo.
A menudo, ese mismo módulo también traduce la intención a la sintaxis propia del dispositivo o del servicio. Es, por tanto, la mitad del adaptador que se encarga de la traducción (véase la sección Generación a partir de plantillas y traducción). El módulo necesita conocer el estado actual del dispositivo para calcular la diferencia, por lo que se ejecuta cerca de él. La Tabla 6.2 compara ambos enfoques.
| Enfoque | Ventajas | Limitaciones |
|---|---|---|
| Declarativo | Es idempotente cuando el módulo o el protocolo lo son. La intención es más fácil de leer y el operador comete menos errores porque la herramienta se ocupa de los casos límite | Depende mucho de la calidad del módulo o del proveedor. Tienes menos control sobre los pasos de ejecución y puede resultar más difícil diagnosticar problemas cuando la herramienta oculta los detalles internos |
| Imperativo | Tienes pleno control sobre cada paso. El flujo de ejecución es explícito y funciona en casi cualquier entorno con acceso a la CLI | Exige más código y más esfuerzo de prueba. La idempotencia depende de ti y, a largo plazo, el esfuerzo de mantenimiento aumenta rápidamente a medida que se acumulan los casos límite |
Una buena forma de ver la diferencia es fijarse en Ansible, que admite ambos enfoques:
Con Ansible en modo imperativo, le indicas literalmente a Ansible qué comandos debe ejecutar. Aunque la VLAN ya exista, los comandos se ejecutan de todos modos (si bien la operación puede ser idempotente según el módulo).
- name: Create VLAN 412
  cisco.ios.ios_config:
    parents: vlan 412
    lines:
- name app-paymentsCon Ansible en modo declarativo, describes el estado deseado. Ansible determina qué comandos debe ejecutar. Si la VLAN 412 ya existe y tiene el nombre correcto, Ansible no hace nada.
- name: Ensure VLAN 412 exists
  cisco.ios.ios_vlans:
    config:
      - vlan_id: 412
        name: app-payments
state: mergedLa mayoría de los equipos usan el enfoque declarativo cuando pueden y el imperativo cuando lo necesitan. Recuerda que, con el enfoque declarativo, alguien más asume la complejidad, aunque desde fuera parezca sencillo.
Otro aspecto importante de la lógica del motor es cómo ejecuta las tareas.
Ejecución en serie frente a ejecución en paralelo#
Simplificando un poco, hay dos formas de ejecutar las tareas. La Figura 6.2 las compara:
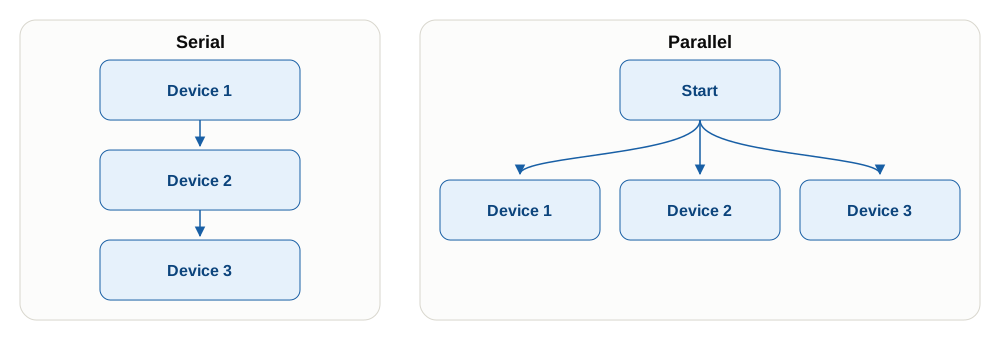
Ejecución en serie: procesa los dispositivos de uno en uno. Configura el dispositivo 1, espera a que termine y configura el dispositivo 2, y así sucesivamente. Es una opción segura (ves los fallos de inmediato y puedes parar), pero lenta (100 dispositivos = 100 veces el tiempo que tarda uno).
Ejecución en paralelo: procesa varios dispositivos a la vez. Configura a la vez los dispositivos del 1 al 10, luego los del 11 al 20, y así sucesivamente.
Por qué existe Nornir. Ansible siempre ha ejecutado cada tarea en varios hosts en paralelo, hasta el límite que marca
forks(cinco por defecto, y es lo primero que conviene aumentar). Con la estrategia predeterminadalinear, Ansible añade una barrera entre tareas: ningún host empieza el paso 2 hasta que el más lento termina el paso 1. Con 800 switches, basta con que un dispositivo no responda para que marque el ritmo de cada paso del play de Ansible. La estrategiafreeelimina esa barrera y permite que cada host avance a su ritmo. Nornir parte del extremo opuesto: es un marco de trabajo de Python con un grupo de hilos de ejecución. Cada dispositivo ejecuta su flujo de trabajo completo de forma independiente y tú defines la concurrencia en el código. No ganas siempre la misma velocidad. Lo que consigues es que un dispositivo lento deje de retrasar cada paso.
La ejecución en paralelo parece la opción evidente cuando el orden es indiferente, pero plantea sus propias dificultades:
- Impacto en el plano de control: acceder a 1000 dispositivos a la vez puede sobrecargar las redes de gestión, las fuentes de datos, los sistemas de autenticación o los planos de control de los dispositivos.
- Gestión de dependencias: si unos dispositivos dependen de otros (los spine antes que los leaf), necesitas seguir un orden. El paralelismo puro no funciona.
- Alcance del impacto de un error: si tu automatización contiene un error, la ejecución en paralelo lo propaga a muchos dispositivos antes de que te des cuenta. La ejecución en serie falla en el dispositivo 1 y puedes parar antes de causar daños en los dispositivos del 2 al 100.
Te recomiendo ejecutar en paralelo por lotes. Procesa los dispositivos en grupos de 10 a 50, u oleadas, y comprueba que cada lote se ha completado con éxito antes de continuar. Así equilibras velocidad y seguridad. Elegir el tamaño del lote es la parte fácil. Lo que limita los daños es qué dispositivos comparten una oleada. Coloca los dos miembros de cada par redundante en oleadas distintas. Si unos niveles dependen de otros, trátalos como oleadas consecutivas en vez de como lotes paralelos: empieza por los spine, verifícalos y pasa después a los leaf. El capítulo 8 llama a este método despliegue progresivo por oleadas (progressive wave rollout) y explica cómo comprobar el estado de la red antes de pasar a la siguiente oleada. El capítulo 11 explica cómo se lleva a cabo el despliegue.
Antes de tener en cuenta todo lo anterior, hay una restricción que determina el tamaño del lote: la ventana de cambio. Procesar dieciséis lotes de 50, cada uno con su espera de convergencia y su verificación, supone algo muy distinto en una ventana de cuatro horas un sábado que en una plataforma de automatización de redes (NAP) que despliega bajo demanda. Haz las cuentas antes de elegir la cifra, porque la alternativa es descubrir a las 05:00 que la ventana se ha cerrado con 300 switches modificados y 500 pendientes. Si el cambio completo no cabe en la ventana, lo que debes ajustar es el alcance, no el tamaño del lote. Elige por dónde dividir el cambio entre varias ventanas, de modo que la red quede en un estado coherente al final de cada una.
La concurrencia es uno de los dos aspectos que determinan cómo se reparte el trabajo. El otro es desde dónde se ejecuta.
Agentes y procesos de ejecución#
Dos cuestiones de topología determinan cómo llega la ejecución a la red: quién inicia la conexión y dónde se ejecuta el trabajo.
La ejecución sin agentes es la opción habitual en redes por una razón sencilla: en la mayoría de los dispositivos de red no puedes instalar software. El Ejecutor se conecta al dispositivo, hace el trabajo y se desconecta sin dejar ningún agente en él. El coste es que cada operación requiere establecer una conexión y que el Ejecutor necesita conectividad y credenciales para cada dispositivo que gestiona.
La ejecución con agentes invierte el sentido de la conexión. Un componente situado en el propio dispositivo o cerca de él mantiene abierta una conexión hacia el exterior y la utiliza para recoger trabajos del sistema central. En los servidores es lo habitual. En redes, puede tomar la forma de un agente que se ejecuta en el propio dispositivo si su sistema operativo admite contenedores. Es más frecuente encontrar un proceso de ejecución que actúa como intermediario: un pequeño ejecutor en una sede remota que recoge trabajos del sistema central y los ejecuta allí mismo. La ventaja está en la conectividad: como el agente inicia la conexión hacia el exterior, no necesitas una ruta de entrada hasta cada dispositivo. Esto importa en sedes que usan NAT o tienen una política de cortafuegos estricta. El coste es que tienes un componente más que desplegar, monitorizar y actualizar. Si un agente deja de funcionar, sus dispositivos quedan fuera del alcance de la automatización, aunque la red funcione correctamente.
La ubicación de los procesos de ejecución depende de esa elección. Lo más sencillo es tener un único grupo centralizado de procesos de ejecución, y funciona hasta que la latencia o la falta de conectividad lo impiden. Los procesos regionales están cerca de sus dispositivos. Esa cercanía importa sobre todo en las sesiones de la CLI, donde una sola tarea requiere decenas de intercambios de ida y vuelta y cada milisegundo de latencia se multiplica. La contrapartida es la gestión del estado distribuido: hay muchos procesos de ejecución y un solo lugar donde registrar lo ocurrido. De este escenario distribuido advertía la sección «Gestión del estado». El capítulo 12 explica cómo abordarlo a escala.
Al igual que la idempotencia, la posibilidad de hacer una simulación es uno de los principios de diseño del capítulo 2 que ayudan a generar confianza.
Simulación#
La simulación es la fase de «planificación» del motor de ejecución: el motor simula los cambios sin tocar los dispositivos y después muestra las diferencias concretas y los riesgos. Una buena simulación obtiene el estado actual, calcula exactamente qué operaciones se ejecutarían en cada dispositivo y comprueba los requisitos previos (conectividad, esquema y orden de ejecución según las dependencias). Debe ser rápida, determinista y reproducible para que quienes la revisen puedan confiar en ella.
Deja a un lado la sintaxis. Este plan de Terraform para una VPC de AWS muestra qué aspecto tiene un cambio que puedes revisar:
Terraform will perform the following actions:

  # aws_vpc.main will be created
  + resource "aws_vpc" "main" {
      + cidr_block           = "10.10.0.0/16"
      + enable_dns_support   = true
      + enable_dns_hostnames = true
      + tags = {
          + "Name" = "core-vpc"
        }
    }

Plan: 1 to add, 0 to change, 0 to destroy.Quien revisa el cambio valida las diferencias: ve exactamente qué recursos y atributos cambiarían, sin tocar la infraestructura real.
Una simulación permite aprobar los cambios con conocimiento de causa y reduce la probabilidad de tener que revertirlos. Las personas ven con claridad qué va a ocurrir y el motor tiene la oportunidad de rechazar a tiempo los cambios inseguros o incoherentes. Si el sistema operativo del dispositivo o el servicio en la nube admite configuraciones candidatas o la comprobación commit-check, el motor debería aprovechar esas funciones. En caso contrario, la simulación calcula las diferencias y realiza comprobaciones previas, pero no ofrece garantías (aun así, es mejor que nada).
En mi experiencia, ofrecer la posibilidad de hacer simulaciones al principio de un proyecto de automatización ayuda mucho a ganarse el apoyo de los ingenieros de redes. Con el tiempo, el equipo deja de leer a mano todas las simulaciones, pero sigue generándolas: sus resultados aportan las pruebas en las que se apoyan la revisión y el registro de auditoría.
He leído por encima más resultados de simulación de los que me gustaría admitir. Suelen ser los más largos, que son precisamente los que importan. Después del tercer café, un listado de diferencias de 400 líneas se parece mucho a uno de 40. Así que dejé de confiar en mi capacidad de atención e hice que el propio resultado me llamara la atención cuando hiciera falta. Cuando una simulación afecta a algo delicado, como una política de enrutamiento, una interfaz de gestión o más dispositivos de los que especificaba la solicitud, el resumen empieza con una advertencia difícil de pasar por alto. Esa advertencia no está ahí para el ingeniero que empieza. Está ahí para mí.
Un buen motor te permite parar antes de aplicar el cambio. Cada cambio tiene cinco pasos y solo el último modifica el dispositivo. Obtén de la SoT los datos de la capa técnica. A partir de esos datos, genera la configuración con plantillas o traduce los datos a la sintaxis del dispositivo. Recupera la configuración actual del dispositivo y compara las dos configuraciones. Después, aplica la diferencia o sustituye la configuración si es posible. Poder ejecutar los cuatro primeros pasos por separado del último es lo que permite revisar el cambio. La simulación utiliza ese mismo mecanismo.
En la fase de aplicación hay varios grados, ordenados por el alcance del impacto. Al fusionar, añades tu configuración a la que ya existe. Al sustituir, reemplazas una sección y dejas intacto el resto. Al sobrescribir, haces que toda la configuración del dispositivo coincida con la intención, lo que también elimina todo aquello que la intención no menciona. Las herramientas declarativas ofrecen estas opciones como estados con nombre propio. Los nombres varían de una herramienta a otra, pero el alcance del impacto de cada opción es el mismo. Elige la opción de menor alcance que consiga el cambio y asegúrate de saber cuál usa tu módulo por defecto.
La simulación cubre la mitad del cambio que aún no ha ocurrido. La otra mitad hay que comprobarla después.
Verificación#
La simulación pregunta qué ocurrirá y la verificación pregunta qué ha ocurrido. No son simétricas. Una simulación sin incidencias es una predicción. Una verificación sin incidencias aporta pruebas, y el cambio no termina hasta que las tienes. Conviene comprobar tres cosas, en orden creciente tanto por lo que demuestran como por lo que cuesta comprobarlas. La Figura 6.3 muestra las tres junto con la cuarta comprobación que añade el control entre oleadas del capítulo 8 cuando el siguiente paso es ampliar el alcance.
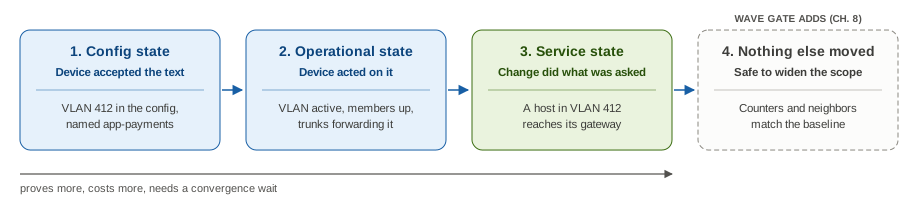
- Estado de la configuración: vuelve a leer la configuración del dispositivo y confirma que coincide con la intención. Es una comprobación de bajo coste e inmediata, pero solo demuestra que el dispositivo ha aceptado el texto. Una VLAN puede figurar en la configuración y no transportar tráfico.
- Estado operativo: comprueba qué resultado indica el propio dispositivo. La VLAN está activa, la interfaz está operativa, la sesión BGP está establecida. Esto demuestra que el dispositivo ha actuado conforme a la configuración.
- Estado del servicio: comprueba aquello para lo que se hizo el cambio. Un host de la nueva VLAN obtiene una dirección y llega a su puerta de enlace. Esta es la única comprobación que demuestra que el cambio ha conseguido lo que se pidió.
Las tres comprobaciones leen datos del Recolector y de Observabilidad, los bloques que recopilan el estado de los dispositivos y permiten consultarlo (capítulo 7). Los consulta el Ejecutor o el bloque de Orquestación, según lo cerca que esté la comprobación del punto de ejecución.
El momento de la comprobación importa tanto como la elección de qué comprobar. Los protocolos necesitan tiempo para converger. Si verificas el resultado justo después de aplicar el cambio, detectarás falsos fallos: una sesión que aún se está estableciendo o una interfaz que todavía no se ha estabilizado. Antes de dar por bueno el resultado, espera a que la red converja y fija un tiempo máximo para esa espera.
Para todo esto necesitas un «antes» con el que comparar el resultado. Para eso sirve el patrón de instantáneas antes y después (before/after snapshot pattern) de la sección «Integración de datos». Sin la primera instantánea no puedes distinguir un problema que has causado tú de otro que ya existía.
La última gran responsabilidad del motor del Ejecutor es gestionar los problemas que podrían afectar a la resiliencia operativa.
Resiliencia#
Todo falla, todo el tiempo.
Werner Vogels
Vogels también tiene razón en lo que respecta a la ejecución en red: los dispositivos se reinician, la conectividad sufre cortes momentáneos y los planos de control se saturan. Otras dependencias, como el bloque de Intención, también pueden tener problemas temporales. Una ejecución resiliente permite gestionar estas situaciones de forma controlada mediante siete estrategias que el capítulo 12 desarrolla con más detalle:
La lógica de reintentos gestiona los fallos transitorios. Si se agota el tiempo de espera de una conexión o se produce un pico temporal de uso de la CPU, conviene reintentar la operación con un intervalo de espera que crezca de forma exponencial. Un fallo de autenticación o un error de sintaxis no debería provocar un reintento: la operación fallará igual cada vez. Limita el número de intentos o un dispositivo que haya quedado definitivamente fuera de servicio mantendrá el trabajo abierto indefinidamente.
La limitación de la tasa de solicitudes protege los sistemas de los que dependes, no los que estás modificando. Un trabajo que abre 150 sesiones con dispositivos a la vez también hace 150 solicitudes de autenticación, 150 consultas al inventario y 150 lecturas de secretos. Los dispositivos funcionan bien, pero el servidor RADIUS se satura. Limita la concurrencia por separado para cada dependencia compartida, porque sus límites difieren en un orden de magnitud. Un servidor AAA puede admitir unas decenas de inicios de sesión simultáneos, la API de una Fuente de Verdad puede atender unos cientos de solicitudes por segundo y un gestor de secretos admite menos que cualquiera de los dos. Los reintentos multiplican esa carga en el peor momento, cuando la dependencia ya tiene dificultades. Por eso, el intervalo de espera debe crecer de forma exponencial e incorporar una variación aleatoria que impida que los reintentos vuelvan a sincronizarse en una segunda oleada.
Los tiempos de espera máximos se aplican en tres niveles. El tiempo máximo de conexión limita cuánto esperas a que responda un dispositivo. El tiempo máximo de tarea limita la duración de una operación completa, para que un dispositivo bloqueado no paralice la ejecución. El tiempo máximo global limita la duración del trabajo entero. Sin los tres, un solo switch que no responda puede bloquear un despliegue en 800 switches.
Gestión de errores: aquí decides qué política seguir. ¿Qué pasa con los demás dispositivos cuando falla uno? Si optas por detenerte al primer fallo, se cancela todo. Es seguro, pero se pierde el trabajo ya hecho. Si optas por continuar, se registra el fallo y el trabajo sigue adelante. Es eficiente, pero puede extender un cambio erróneo a todo el parque de dispositivos.
Fijar un umbral para detener el trabajo cuando los fallos superan un límite suele ser la opción más adecuada. El límite lo determina el cambio, no la herramienta, así que viene definido con el cambio y se pasa al trabajo. El capítulo 8 explica cómo elegirlo y por qué un cambio de reenvío o de seguridad debe aplicarse por completo o no aplicarse, mientras que para un cambio de monitorización puede bastar un 95 % de éxito. Elijas la política que elijas, aplícala de forma coherente: si no puedes prever qué ocurrirá ante un fallo parcial, perderás la confianza más rápido que ante un fallo total.
Reversión: necesitas una instantánea tomada antes del cambio, no después de detectar el problema. Guarda la configuración actual de cada dispositivo y, si algo falla, restáurala automáticamente solo en los dispositivos afectados. Esto es una reversión de la ejecución: una tarea deshace sus propios cambios. Cuando hay que deshacer tareas ya completadas porque ha fallado un paso posterior del flujo de trabajo, se trata de una compensación del patrón Saga (Saga Pattern), que ejecuta el Orquestador. La reversión y la simulación tienen un elemento en común: la instantánea de la configuración actual. La simulación la utiliza como referencia para comparar y la reversión la restaura.
Los interruptores de circuito (Circuit Breakers) evitan que el trabajo pierda tiempo con dispositivos que no responden. Cuando un dispositivo falle repetidamente, márcalo como no operativo y omítelo durante un tiempo. De lo contrario, cada lote tendrá que agotar el tiempo de espera de conexión a un switch que lleva apagado desde el martes pasado.
Los puntos de control guardan el avance del trabajo durante la ejecución. Si el motor se bloquea al llegar al dispositivo 600 de un total de 800, puedes reanudar el trabajo desde el punto de control sin volver a empezar. Esto es lo que le faltaba al equipo de la historia inicial.
Implementar todo esto es difícil. La mayoría de los equipos empieza con una lógica básica de reintentos y añade complejidad a medida que se encuentra con fallos en producción.
Y la última responsabilidad del Ejecutor es proporcionar una interfaz de escritura reutilizable para la infraestructura de red.
Adaptador de red#
Los dispositivos de red esperan distintas sintaxis y se comunican mediante distintos protocolos. La capa de adaptadores de red se encarga de ambas diferencias, de modo que a las capas superiores les da igual si configuran un switch de Cisco por SSH o uno de Arista mediante una API Representational State Transfer (REST).
El Ejecutor accede a cada dispositivo mediante el Patrón Adaptador (Adapter Pattern): hay un adaptador por plataforma y todos aceptan la misma entrada, los datos de la capa técnica. Es la forma más extendida de gestionar las diferencias entre los dispositivos de un parque con varios fabricantes. Como muestra la Figura 6.4, cada adaptador consta de dos partes: la generación a partir de plantillas o la traducción convierte el registro a la sintaxis de la plataforma, y la parte encargada de la entrega se comunica con el dispositivo a través de su interfaz e interpreta su respuesta.
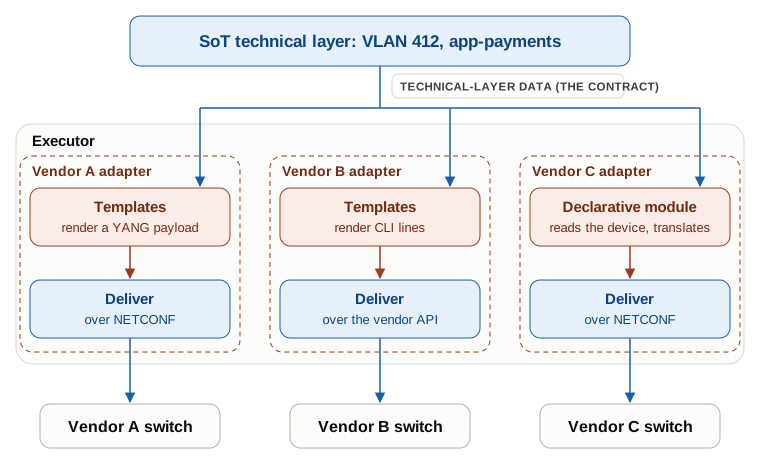
En la figura, al igual que en el Ejemplo de implementación que encontrarás más adelante en este capítulo, los adaptadores de los fabricantes A y B generan la configuración con tus plantillas y el del fabricante C la traduce mediante un módulo declarativo. Los tres parten del mismo registro de la capa técnica y ninguna capa superior a los adaptadores necesita saber qué sintaxis o interfaz utiliza un dispositivo. Los dos apartados siguientes describen ambas partes: primero la generación a partir de plantillas y la traducción, y después la entrega.
El Recolector aplica el mismo principio a la lectura: hay un módulo de recogida por fabricante o protocolo, y el Procesador normaliza los datos que entregan esos módulos (capítulo 7).
Este patrón es fácil de implementar y su funcionamiento se conoce bien. El esfuerzo de mantenimiento aumenta a medida que se diversifica el inventario de dispositivos: cada nuevo fabricante o versión del sistema operativo requiere un adaptador nuevo o una versión nueva de uno existente. El patrón escala bien para un conjunto definido de fabricantes, pero su mantenimiento se complica cuando la red es muy heterogénea. Al menos, la complejidad queda limitada a este componente y la Intención se mantiene independiente de todos esos cambios.
Aun así, el patrón escala más de lo que parece. Robotron, de Facebook (Sung, Tie, Wong y Zeng, SIGCOMM 2016), describe esta misma estructura aplicada a decenas de miles de dispositivos que conectan cientos de miles de servidores. Un almacén de objetos llamado FBNet representa la red mediante objetos y relaciones entre ellos. A partir de esos objetos se generan las configuraciones específicas de cada fabricante mediante plantillas por tipo de dispositivo. El equipo amplía el conjunto de plantillas a medida que entran en producción nuevos tipos de dispositivos. La intención, independiente del fabricante, reside en un sistema. A partir de ella se genera la configuración por tipo de dispositivo y un paso de despliegue independiente envía el resultado. Es la misma división que propone este apartado, en una red cuyo tamaño la mayoría de las empresas nunca llegará a igualar.
Robotron resuelve la cuestión de la escala y deja abierta la de la diversidad, porque un proveedor de servicios a hiperescala tiene un catálogo de dispositivos más reducido y lo controla mucho más de cerca que una empresa. Facebook eligió sus plataformas. No tuvo esa opción una empresa con equipos de campus de cuatro fabricantes, una WAN de un quinto, un centro de datos heredado de una adquisición y tres generaciones de firmware en cada entorno.
El punto débil del patrón es la amplitud del catálogo, no el número de dispositivos que contiene, y el artículo no pone a prueba ese aspecto. Lo que sí te explica es algo que la descripción del patrón pasa por alto: cómo se mantiene un conjunto de plantillas a medida que cambia el catálogo de dispositivos al que deben dar soporte. Ese trabajo es lo que encarece la traducción por plataforma.
Generación a partir de plantillas y traducción#
El adaptador recibe datos de la capa técnica, como el registro de la VLAN del capítulo 4. Su primera tarea es convertir ese registro a la sintaxis que acepta su plataforma, ya sean líneas de la CLI, una carga útil en YANG o un modelo de una API REST. Aquí es donde la sintaxis del fabricante entra en la NAP, y es responsabilidad del Ejecutor, no del bloque de Intención (el capítulo 4 delimita las responsabilidades).
Hay dos formas de hacerlo:
- Generación a partir de plantillas: tus propias plantillas se rellenan con los datos y producen un artefacto de configuración completo. Jinja2 es la opción más popular para configurar dispositivos mediante la CLI porque sus plantillas son fáciles de leer y se integra con Python y Ansible. Las interfaces que reciben cargas útiles (API REST, gRPC Network Management Interface (gNMI)) suelen utilizar estructuras de datos creadas con un lenguaje de programación.
- Traducción: un módulo escrito por otra persona convierte los datos a la sintaxis del dispositivo, a menudo tras consultar su estado. Así funcionan los módulos declarativos de recursos, como
cisco.ios.ios_vlansde Ansible, los proveedores de nube de las herramientas de infraestructura como código y los controladores de dispositivos que incorporan los productos de orquestación de redes.
No confundas ninguna de las dos opciones con las copias de seguridad de la configuración. Una copia de seguridad corresponde al bloque de Observabilidad: recoge la configuración que está en ejecución y te indica cuál pudo ser tu intención en el pasado, no cuál es ahora. Tanto la generación a partir de plantillas como la traducción producen el resultado en el momento, a partir de la intención actual.
Generación con plantillas
Las plantillas convierten los datos de la capa técnica («VLAN 412, de nombre app-payments») en artefactos de configuración concretos (por ejemplo, comandos de la CLI). Pero ten presente que las plantillas contienen lógica, no datos. La plantilla dice: «Toma el ID de la VLAN del modelo de datos e insértalo aquí». El valor concreto del ID de la VLAN procede de los datos, no de la plantilla. Así se separan los datos de los detalles de implementación, lo que te permite reutilizarlos en muchos casos y comprobar fácilmente que se ajustan a un esquema común.
Por ejemplo, dados estos datos de interfaces de la capa técnica:
interfaces:
  - name: Ethernet1
    description: Uplink to core
    enabled: true
  - name: Ethernet2
    description: Server port
enabled: falseY esta plantilla Jinja2 del adaptador:
# Interfaces
{% for iface in interfaces %}
interface {{ iface.name }}
  description {{ iface.description }}
  {% if iface.enabled %}
  no shutdown
  {% else %}
  shutdown
  {% endif %}
{% endfor %}La plantilla genera la siguiente salida para la CLI:
# Interfaces
interface Ethernet1
  description Uplink to core
  no shutdown
interface Ethernet2
  description Server port
shutdownLos datos proceden de la capa técnica, la plantilla pertenece al adaptador y el artefacto de configuración es el resultado. Cada uno de los tres puede cambiar sin que tengas que editar los demás.
Las constantes también son datos. Es bastante habitual empezar con valores fijos en las plantillas, como la MTU cuando todas las interfaces de tu red usan la misma, porque es la forma más rápida de generar la primera configuración. Pero esto te dará problemas antes de lo que crees. El día que una interfaz necesite otro valor, por ejemplo, un túnel GRE con una MTU de 1476, la constante ya estará copiada en la plantilla de cada adaptador y nada en la intención te indicará dónde. Por eso, procura separar la intención del adaptador. Conserva el valor en la intención como único valor predeterminado, defínelo una sola vez en el diseño en lugar de repetirlo en miles de objetos y permite que la excepción lo sustituya donde haga falta. Así se modela el túnel en el Listado 4.4 del capítulo 4. La plantilla conserva únicamente la lógica que convierte los datos a la sintaxis del fabricante.
Una alternativa interesante a Jinja es CUE, un lenguaje declarativo de configuración que reúne la representación de datos en bruto (como YAML), la validación (como JSON Schema) y la generación (como Jinja). Trata la configuración como datos con tipos definidos que se pueden combinar y que deben cumplir ciertas condiciones en todo momento, en lugar de tratarla como texto con una estructura poco rígida. Su función de validación corresponde a la aplicación del esquema en el bloque de Intención (capítulo 4), y su función de generación corresponde a la generación a partir de plantillas. Si adoptas CUE, mantén el esquema junto a la intención y el código de generación en el adaptador, aunque ambos estén escritos en CUE.
Generación a partir de plantillas o traducción
La generación a partir de plantillas y la traducción cumplen la misma función. Se diferencian en quién escribe el código y en qué necesita ese código para funcionar. La Tabla 6.3 compara ambas opciones.
| Generación a partir de plantillas | Traducción | |
|---|---|---|
| Quién escribe el código | Tú, en forma de plantillas | El autor del módulo |
| ¿Necesita el estado del dispositivo? | No | A menudo, para calcular las diferencias |
| ¿Se puede revisar el cambio antes de aplicarlo? | Sí, en el artefacto generado | Solo mediante las diferencias que muestra el módulo en la simulación |
| Casos más adecuados | Interfaces que permiten la sustitución completa | CLI que solo permiten fusionar cambios, API de nube y controladores |
| Riesgo principal | Proliferación de plantillas | Comportamiento ligado a una versión del módulo |
Para elegir, hazte una pregunta: ¿hace falta conocer el estado actual del dispositivo? La generación a partir de plantillas recibe el estado deseado completo y produce la carga útil completa, por lo que no necesita obtener nada del dispositivo. Encaja con cualquier interfaz que permita sustituir una sección entera de la configuración, como NETCONF o gNMI cuando se usan operaciones de sustitución. En la traducción, el módulo puede consultar primero el dispositivo, y a veces necesita hacerlo. Para eliminar la VLAN 412 mediante una CLI que solo permite fusionar cambios, hay que enviar no vlan 412, y solo un componente que haya consultado el dispositivo sabe que debe enviarlo.
Una regla se aplica a ambas opciones: el cambio es visible antes de aplicarlo. En la generación a partir de plantillas, el artefacto permite ver el cambio. En la traducción, lo muestran las diferencias que devuelve el módulo en la simulación. El apartado anterior, Simulación, explica cómo incorporar esa comparación al motor. Un módulo que no pueda mostrar sus diferencias no debería ejecutarse sin supervisión.
Genera primero y despliega después
La generación a partir de plantillas es una operación por derecho propio, no solo un paso del despliegue. El Orquestador la invoca durante la validación, antes de que nadie apruebe el cambio: el Ejecutor genera un artefacto para cada dispositivo incluido en el cambio y lo envía al almacén de artefactos. La simulación se ejecuta sobre ese artefacto y los revisores lo leen. Más tarde, el paso de despliegue envía exactamente esos mismos bytes sin volver a generar el artefacto. Así, lo que se ha aprobado es lo que llega al dispositivo (en el capítulo 11 todo esto se ejecuta dentro del flujo de trabajo de cambio).
En el caso de la traducción, lo que se guarda como evidencia es el plan de simulación del módulo. Más tarde, el despliegue ejecuta la misma versión del módulo. Si el dispositivo ha cambiado entre tanto, el plan ya no concuerda con su estado y la ejecución se detiene.
Versiones y contratos
Cada plataforma tiene su propio adaptador, que se distribuye como paquete. Si el comportamiento de la plataforma varía según la versión del sistema operativo, hay un paquete por versión (capítulo 10). El paquete reúne las plantillas o el módulo fijado a una versión concreta y el código de entrega que se describe a continuación. Se publica como una sola unidad con versionado semántico, al igual que todo lo que publica la NAP. Los clientes de transporte, como los de SSH, NETCONF y gNMI, son bibliotecas compartidas que utilizan todos los adaptadores y no forman parte de ninguno en particular.
El esquema de la capa técnica es el contrato entre los adaptadores y el bloque de Intención, y este bloque gestiona sus versiones. Cada adaptador declara qué versiones del esquema acepta y su CI ejecuta pruebas de contrato: el adaptador procesa datos de prueba generados a partir del esquema y las pruebas comparan la salida con la configuración esperada. Un cambio incompatible en el esquema solo se publica cuando todos los adaptadores que lo utilizan disponen ya de una versión publicada que lo acepta. Cada ejecución registra la versión del adaptador junto a la del esquema, de modo que siempre puedes identificar con qué versiones se generó cada artefacto.
Esa disciplina explica por qué la generación a partir de plantillas corresponde al Ejecutor. Las plantillas son código que adapta el modelo independiente de la plataforma a otro específico para ella. Si las guardas en la intención, tendrás que modificarla cuando una nueva versión del sistema operativo cambie algún detalle de la sintaxis de configuración. En realidad, tu intención sigue siendo la misma y solo tiene que cambiar el artefacto. Como es lógico, el adaptador debe gestionar las versiones de las plantillas o de cualquier otra lógica de traducción y hacer un seguimiento de sus cambios, en consonancia con el contrato de datos que ofrece la intención.
Dicho esto, muchos productos que sirven de Fuente de Verdad incluyen funciones de generación a partir de plantillas, como plantillas de configuración o artefactos generados. Puedes usarlas si aplicas al código de las plantillas los mismos criterios de control de versiones y pruebas. En ese caso, la herramienta que hace de SoT aloja parte del Ejecutor.
Entrega#
Las interfaces que ofrece un dispositivo, para qué sirve cada una y cuál conviene elegir para cada dispositivo son propiedades de la red que se tratan en el capítulo 10. La parte del adaptador encargada de la entrega se comunica a través de esas interfaces. Además de la CLI tradicional sobre SSH (o Telnet), el sector ha desarrollado interfaces que devuelven datos estructurados en lugar del texto que aparece en pantalla. La Tabla 6.4 enumera las bibliotecas que implementan adaptadores para las interfaces más utilizadas:
| Interfaz | Ejemplos de bibliotecas y herramientas |
|---|---|
| SSH / CLI | Netmiko (Python), Paramiko (Python), scrapli (Python), scrapligo (Go) |
| NETCONF / RESTCONF | ncclient (Python), scrapli-netconf (Python), nemith/netconf (Go) |
| gNMI / gNOI | pygnmi (Python), gnmic (CLI en Go), openconfig/gnmi (Go) |
| API REST | requests/httpx (Python), net/http + clientes generados a partir de OpenAPI (Go) |
| JSON-RPC / gRPC del fabricante | Arista eAPI (JSON-RPC), SDK de gRPC de los fabricantes |
Todas las bibliotecas anteriores son de código abierto, aunque las empresas que desarrollan algunas de ellas también ofrecen soporte comercial.
Algunas de estas interfaces siguen exponiendo modelos de datos específicos de cada fabricante. Para que puedas reutilizar el código, otras bibliotecas y productos ofrecen una capa de abstracción con una interfaz común a distintas plataformas. Dos ejemplos son:
- NAPALM (Network Automation and Programmability Abstraction Layer with Multivendor support): biblioteca de Python que ofrece una API unificada para equipos de distintos fabricantes.
- Es compatible con equipos de Cisco, Arista y Juniper, entre otros fabricantes
- Internamente utiliza el protocolo o la interfaz que corresponda (SSH, API, NETCONF)
- Caso de uso: entornos con varios fabricantes en los que quieres utilizar el mismo código de automatización
- Cisco NSO (Network Services Orchestrator): es un producto comercial, no una biblioteca. Sus controladores de elementos de red (Network Element Drivers, NED) permiten acceder a cualquier dispositivo, sea cual sea su interfaz, a través de una única API modelada con YANG.
- Calcula las diferencias respecto a la configuración del propio dispositivo y confirma los cambios en múltiples dispositivos como una sola transacción, con posibilidad de reversión
- Los paquetes de servicios pueden traducir un modelo de servicio independiente del fabricante a la configuración de cada dispositivo. Así, NSO incorpora toda una capa de adaptación en un único producto que se encarga tanto de la traducción como de la entrega. Si lo adoptas, tus adaptadores pasan a formar parte del producto
- Caso de uso: aprovisionamiento de servicios en entornos con varios fabricantes donde el equipo acepta el modelo de un producto comercial a cambio de disponer de transacciones y controladores listos para usar
¿Por qué utilizar una capa de abstracción? NAPALM te ofrece una única API y te ahorra escribir código distinto para Cisco y Juniper. Llama a get_facts() y NAPALM determina cómo obtener los datos básicos del dispositivo, tanto si utiliza Cisco IOS (por SSH) como Arista EOS (por eAPI) o Juniper Junos (por NETCONF).
La contrapartida es que la abstracción oculta funciones específicas de cada fabricante. Para operaciones habituales, como consultar la configuración, enviar una configuración u obtener los datos básicos del dispositivo, funciona muy bien. Para operaciones más avanzadas o funciones poco habituales de un fabricante, tienes que volver a las interfaces nativas, porque es probable que la capa de abstracción no las implemente.
Una biblioteca como NAPALM oculta la interfaz. Un módulo declarativo de recursos va un paso más allá y oculta también la sintaxis. Recibe datos de la capa técnica y genera por sí mismo la configuración del sistema de destino, por lo que desempeña la función de traducción del adaptador. Tres prácticas te permiten usarlo con seguridad: envíale datos independientes del fabricante y nunca instrucciones preparadas de antemano en una sintaxis concreta, fija la versión del módulo en cada versión del adaptador y exige que te muestre las diferencias en una simulación antes de que aplique ningún cambio.
Comunicarse mediante el protocolo es la parte visible de la entrega. La otra parte es el ciclo de vida de la conexión, y ahí aparecen los problemas de escala. Una sesión de la CLI sobre SSH tiene un coste elevado: hay que establecer la conexión TCP, intercambiar claves, autenticarse y, después, interactuar con un intérprete de comandos y analizar su salida. Si un ejecutor incurre en ese coste por cada tarea en cientos de dispositivos, acaba saturando los sistemas de los que depende. Por eso el adaptador mantiene y reutiliza sus conexiones:
- Reutilización de conexiones: abre una sesión por dispositivo y ejecuta en ella todas las tareas del trabajo para evitar una nueva conexión por tarea.
- Agrupación y límites de conexiones: limita el número de sesiones simultáneas, tanto por dispositivo como en total, para que un trabajo que se ejecute en paralelo no pueda abrir 800 a la vez. El límite protege el plano de control del dispositivo y el sistema de autenticación que lo respalda.
- Estado de la sesión: una sesión de la CLI tiene varios modos (enable, config, commit). El adaptador lleva la cuenta del modo activo para que ninguna tarea envíe una línea de configuración a un indicador de comandos que no pueda aceptarla.
- Cierre de sesiones: cierra las sesiones de forma explícita. Los dispositivos suelen admitir menos de diez sesiones de gestión simultáneas. Si un ejecutor deja sesiones abiertas y agota ese límite, los ingenieros que necesitan acceder al dispositivo se quedan fuera.
Con las interfaces estructuradas cambian los costes, pero el principio sigue siendo el mismo. Por diseño, NETCONF y gNMI mantienen abierto un canal de larga duración. Una API REST trata cada solicitud sin conservar estado entre solicitudes, pero aun así conviene reutilizar una conexión HTTP de un grupo de conexiones y un token almacenado en caché para evitar un nuevo inicio de sesión en cada llamada.
Además, la ejecución en la red va más allá de la gestión de la configuración. Puede que necesites realizar otros tipos de operaciones, como recoge la Tabla 6.5:
| Tipo de operación | Qué abarca | Observaciones |
|---|---|---|
| Cambios de configuración | Envío de configuraciones completas, fragmentos o estado declarativo en los modos de combinación, sustitución o eliminación | Es el tipo de operación más habitual y el que mejor cubren las herramientas |
| Aprovisionamiento sin intervención (Zero Touch Provisioning) | Incorporación automática en el primer arranque | Patrón de ejecución con características propias que se detalla más adelante en este capítulo |
| Transferencias de archivos | Carga de imágenes y descarga de registros o copias de seguridad | Protocolos habituales: SCP, SFTP, TFTP, HTTP |
| Actualizaciones de software | Preparación de la imagen en el dispositivo, instalación, reinicio y comprobación de la versión en ejecución | Comprobaciones previas (espacio en disco, redundancia) y posteriores, una imagen para la reversión y coexistencia de versiones durante el despliegue (Capítulo 10) |
| Operaciones en dispositivos | Reinicio o recarga, comandos operativos (ping/traceroute) y copias de seguridad | Habituales en la operación posterior al despliegue y en la corrección de problemas |
| Reversión | Restablecimiento de una configuración anterior cuyo buen funcionamiento se ha comprobado | Algunos sistemas admiten la reversión nativa y en otros hay que restaurar una copia de seguridad |
Cada tipo de operación puede fallar de formas distintas y necesita un tratamiento específico. Ejecución debe poner los resultados a disposición de Orquestación para que esta tome decisiones, aunque puede seguir encargándose de los controles de seguridad locales y los reintentos.
A quién corresponden la generación a partir de plantillas y la validación: El bloque de Intención es responsable de la intención y la valida cuando se registra. Ejecución se encarga de convertir esa intención en la sintaxis del sistema de destino a través de los adaptadores, mediante plantillas o por traducción. También le corresponden las comprobaciones de seguridad de cada dispositivo y la validación operativa (conectividad, comprobaciones previas y posteriores) cuando es necesario validar justo antes de la ejecución. Orquestación decide cuándo validar y qué hacer con los resultados (aprobar, pausar, revertir o escalar). Si quieres una regla sencilla, la validación que modifica el flujo de trabajo corresponde a Orquestación y la que modifica las acciones sobre el dispositivo corresponde a Ejecución.
El bloque de Ejecución es uno de los más populares en cualquier estrategia de automatización de redes porque es el que lleva las acciones a la práctica. Casi cualquier producto de automatización de redes que se te ocurra, incluso uno centrado en la observabilidad, ofrece alguna función de ejecución.
Consideraciones prácticas#
Tres factores complican lo que acabamos de ver: hay dispositivos que aún no tienen configuración, hay destinos que no son dispositivos y el acceso de escritura hace que proteger este bloque tenga más repercusión que proteger cualquier otro.
Aprovisionamiento sin intervención#
El aprovisionamiento sin intervención manual (ZTP) es un patrón de ejecución con características propias: cuando un dispositivo arranca por primera vez, obtiene y aplica automáticamente toda su configuración sin que nadie tenga que intervenir en el propio dispositivo. Su flujo de datos difiere lo suficiente del de las operaciones posteriores al despliegue como para merecer un diseño propio.
El flujo del ZTP
El flujo consta de cinco pasos que se muestran en la Figura 6.5.
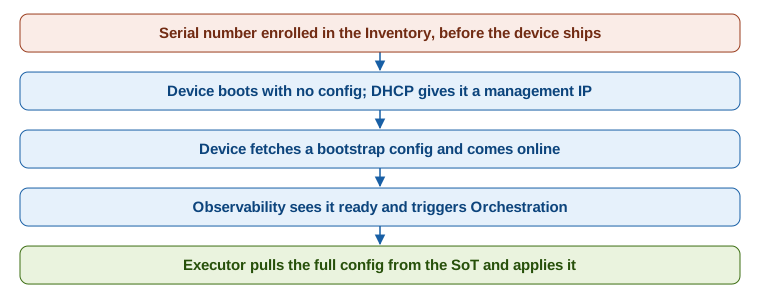
Antes de enviar el dispositivo, se registra en la Fuente de Verdad, normalmente por su número de serie, que en ese momento es el único dato que se conoce de él. El dispositivo arranca sin configuración y DHCP le proporciona una dirección de gestión y una referencia a un servidor de arranque. De ese servidor obtiene una configuración inicial mínima que el Ejecutor ha generado a partir de plantillas con los datos de su registro de alta en la Fuente de Verdad. Con ella se conecta a la red de gestión. Observabilidad detecta que el dispositivo está accesible y en el estado esperado, y avisa a Orquestación. A continuación, el Ejecutor obtiene la intención completa de la Fuente de Verdad, genera la configuración a partir de plantillas y la aplica.
La fase de arranque es mínima por diseño. Solo incluye la configuración necesaria para que el dispositivo se conecte a la red de gestión y pueda autenticarse. El aprovisionamiento completo tiene lugar después, como un trabajo normal del Ejecutor que obtiene la intención completa de la Fuente de Verdad. Así, el ZTP utiliza la misma ruta de ejecución que las operaciones posteriores al despliegue, sin necesidad de un sistema de aprovisionamiento independiente.
Patrones habituales de ZTP
La Tabla 6.6 compara los patrones habituales.
| Patrón | Cómo funciona | Ventajas y limitaciones |
|---|---|---|
| DHCP + archivo estático | DHCP indica la ubicación de un archivo de configuración estático específico de cada dispositivo, identificado por su dirección MAC o su número de serie | Es sencillo de implementar, pero no obtiene los datos de la SoT y falla a gran escala |
| DHCP + generación dinámica | Cuando recibe la solicitud, el servidor de arranque pide al Ejecutor que genere a partir de plantillas la configuración inicial específica del dispositivo con los datos de su registro en la SoT | La SoT guía el aprovisionamiento desde el día cero, pero el dispositivo debe figurar en ella antes de arrancar |
| Imagen del sistema operativo + configuración | El dispositivo descarga tanto la imagen del sistema operativo como la configuración durante el arranque (necesario en los dispositivos que requieren el aprovisionamiento del sistema operativo) | Permite aprovisionar equipos sin sistema operativo o restablecidos a los valores de fábrica, pero aumenta la complejidad del servidor de arranque |
Con el ZTP, el orden de los pasos importa: el dispositivo debe figurar en la Fuente de Verdad antes de su arranque físico. De lo contrario, el servidor de arranque no puede confirmar que se trate de un dispositivo esperado ni dispone de datos para generar su configuración.
La confianza en el primer arranque
El registro indica al servidor de arranque qué dispositivo debe esperar. No demuestra que el dispositivo que envía la solicitud sea el que figura en el registro, ni demuestra al dispositivo que el servidor sea tuyo. Un número de serie se puede copiar y cualquiera que esté en el segmento de arranque puede responder a una solicitud DHCP. El ZTP clásico confía en ambas partes de ese intercambio.
El aprovisionamiento seguro sin intervención (Secure Zero Touch Provisioning, SZTP, RFC 8572) subsana ambas carencias. El dispositivo demuestra su identidad con un certificado que el fabricante instaló en fábrica y que se conoce como IDevID. Solo acepta datos de arranque si están firmados y van acompañados de un comprobante de titularidad: una declaración del fabricante que acredita que el dispositivo te pertenece. Si tus sistemas aún no admiten el SZTP, toma medidas para contener el riesgo. Utiliza para el arranque una VLAN desde la que solo se pueda acceder al servidor de arranque, excluye los secretos de larga duración de la configuración inicial y sustituye la credencial inicial durante la primera ejecución del aprovisionamiento completo.
Un aspecto importante para el Ejecutor es su capacidad de trabajar bien con dos tipos de infraestructura de red muy distintos: la infraestructura física y la infraestructura en la nube.
Ejecución híbrida#
Hoy en día, en muchos casos el Ejecutor debe operar en dos entornos muy distintos: los dispositivos de red tradicionales y las plataformas nativas de la nube. Cada entorno tiene sus propios paradigmas de API, modelos de autenticación y modos de fallo. Tratar ambos por igual da lugar a una automatización frágil, pero abordarlos como sistemas totalmente independientes duplica el esfuerzo y genera incoherencias en la operación.
El problema de las diferencias entre entornos
La Tabla 6.7 muestra en qué se diferencian los dispositivos de red y las plataformas en la nube.
| Aspecto | Dispositivos de red | Plataformas en la nube |
|---|---|---|
| Estilo de API | SSH, NETCONF, gNMI (conexiones con estado y de larga duración) | REST/HTTP (solicitudes sin estado y de corta duración) |
| Modelo de autenticación | Credenciales compartidas (nombre de usuario y contraseña, claves SSH) | Tokens temporales, cuentas de servicio y roles de instancia (AWS SigV4, Azure AD, cuentas de servicio de GCP) |
| Finalización de la operación | Suele ser síncrona (el comando se ejecuta correctamente o falla antes de que termine la sesión) | A menudo es asíncrona (la API responde que ha aceptado la solicitud y hay que hacer consultas periódicas para conocer el estado final) |
| Incertidumbre ante un fallo | Si la sesión se interrumpe durante un commit, el cambio puede haberse aplicado o no. Un commit con confirmación o una nueva lectura de la configuración despejan la duda | Si vence el tiempo de espera de una llamada a una API en la nube, el cambio puede haberse aplicado o no. Tienes que consultar el estado para averiguarlo |
| Enfoque de la idempotencia | Imperativo por defecto. El enfoque declarativo exige diseñar los módulos con cuidado | Declarativo mediante herramientas de infraestructura como código (Terraform, CloudFormation, Pulumi) que utilizan API REST imperativas |
Recomiendo mantener unificadas la Intención y la Orquestación para toda la infraestructura de red. La misma solicitud de servicio que crea una VLAN en los switches del campus puede requerir también la creación de un grupo de seguridad en AWS. La Fuente de Verdad contiene las definiciones de ambos recursos. El Orquestador coordina ambas operaciones. Los caminos de ejecución solo se separan al llegar a la capa del Adaptador de red: un adaptador utiliza NETCONF/Ansible para operar sobre los switches del campus y otro utiliza Terraform o las API del proveedor para operar sobre el entorno de nube.
Así, un cambio realizado a través de una API de nube y otro realizado en un dispositivo de red pasan por el mismo proceso de aprobación y quedan en el mismo registro de auditoría, aunque los protocolos sean completamente distintos.
La estrategia de gestión de secretos debe contemplar tanto las credenciales de larga duración de los dispositivos de red como los tokens de corta duración de la nube. El Ejecutor debe tener en cuenta este aspecto de la seguridad porque es el bloque de la arquitectura que modifica la red real.
Consideraciones de seguridad#
El Ejecutor es el componente de tu arquitectura que tiene acceso de escritura a la red. Puede enviar configuraciones, reiniciar servicios, actualizar el firmware y modificar políticas de encaminamiento en cientos de dispositivos a la vez. Por eso, la seguridad del Ejecutor tiene más consecuencias que la de casi cualquier otro componente y, sin embargo, suele ser la que menos atención recibe al diseñar la arquitectura. Si alguien compromete el Ejecutor, existe el riesgo de que se filtren datos, como en cualquier otro sistema. Además, existe un riesgo de interrupción del servicio que la mayoría de los sistemas no entrañan.
El capítulo 13 aborda el modelo de seguridad de toda la NAP: las identidades, los secretos, el principio de mínimo privilegio, la separación de funciones y las evidencias que pide un auditor. Hay cuatro puntos específicos del bloque que escribe en la red.
Las credenciales se obtienen en tiempo de ejecución y se descartan al terminar el trabajo. Las credenciales de los dispositivos nunca figuran en los playbooks, las plantillas, las definiciones de trabajos ni el control de versiones. El Ejecutor las obtiene del almacén de secretos al iniciar el trabajo y las descarta al terminar (el capítulo 13 describe el almacén).
Para los recursos de nube, la regla es más estricta: genera la credencial al iniciar el trabajo con el mecanismo propio del proveedor (perfiles de instancia de AWS, identidades administradas de Azure o identidad de carga de trabajo de GCP) y no la almacenes en ningún momento. Así, la rotación deja de ser un acontecimiento: programa la rotación de las contraseñas de los dispositivos y la siguiente ejecución utilizará el nuevo valor, sin que haya un intervalo en el que la mitad del parque de dispositivos siga aceptando el anterior.
El alcance de las credenciales de los dispositivos se limita según la operación. Las operaciones de lectura (recopilación de datos de los dispositivos, comprobaciones en modo de simulación y validación previa al despliegue) utilizan credenciales de solo lectura. Las operaciones de escritura utilizan credenciales con permisos limitados al tipo de cambio: un trabajo que despliega cambios de VLAN carece de credenciales que permitan modificar la configuración de BGP. Si el sistema operativo del dispositivo admite el control de acceso basado en roles (roles de Arista, niveles de privilegio de Cisco o control de acceso de NETCONF), utilízalo para limitar el alcance del impacto si se compromete una sola sesión.
Quien lanza un trabajo es una persona distinta de quien lo escribió. Un operador que lanza un despliegue de VLAN no necesita ni debe tener acceso a los roles o las plantillas que lo implementan. En AWX y AAP, por ejemplo, el rol Execute sobre una plantilla de trabajo permite al operador lanzar el trabajo, mientras que para modificar los playbooks que utiliza la plantilla hace falta un rol sobre el proyecto. La persona que inicia una actualización de firmware en 800 switches debe ser distinta de quien escribió el playbook de actualización. Un segundo revisor aprueba el playbook antes de que esté disponible para su uso en producción.
El Ejecutor reside en la red de gestión. El Ejecutor y su plano de control (AWX, nodos de control de Ansible) se encuentran en un segmento de gestión. Cuando existe una red de gestión fuera de banda, el tráfico de ejecución llega a los dispositivos por esa red para evitar el plano de datos que el propio Ejecutor podría estar modificando. El acceso entrante para lanzar trabajos requiere autenticación y está fuera del alcance de las redes que no son de confianza: si se puede acceder al Ejecutor desde la VLAN de usuarios de producción, cualquier host comprometido de esa VLAN puede desencadenar cambios en la red.
Cada ejecución también deja constancia de quién la inició, qué plantilla y qué parámetros utilizó, sobre qué dispositivos actuó y qué resultado obtuvo en cada uno. El capítulo 8 incorpora esos datos al registro de auditoría del flujo de trabajo y el capítulo 13 los convierte en evidencias. Incorpora ese registro al diseño del Ejecutor desde el principio. Añadirlo después cuesta mucho más.
Una vez vistas las funciones y lo que implica llevarlas a la práctica, queda una pregunta antes de pasar al ejemplo: ¿qué herramientas las implementan?
Panorama de soluciones#
La lista de soluciones de Ejecución es muy larga. Estas son las más populares, aunque algunas también implementan otras funciones de la arquitectura.
Las herramientas que se enumeran aquí sirven de ejemplo para la explicación y no constituyen recomendaciones. Evalúalas en función de las capacidades de tu equipo, las herramientas que ya utiliza y las plataformas de tu parque de dispositivos.
Marcos de trabajo y motores
- Ansible: utiliza un lenguaje específico de dominio (DSL) en YAML, funciona sin agentes y cuenta con un amplio ecosistema de módulos tanto para servidores como para dispositivos de red. Permite a la mayoría de los equipos obtener resultados rápidos. A gran escala requiere ajustes, y la lógica compleja resulta difícil de mantener en YAML.
- Terraform: permite definir infraestructura como código de forma declarativa en HCL. Cuenta con un potente motor para planificar cambios y mostrar diferencias, y con flujos de trabajo que conservan el estado. Es excelente para la nube. La madurez de los proveedores de Terraform para redes varía, el archivo de estado añade trabajo operativo y las operaciones posteriores al despliegue son su punto débil.
- Salt: se basa en Python, funciona con o sin agentes y cuenta con una arquitectura basada en eventos que escala bien. Encaja en equipos que ya utilizan Salt y en operaciones con un gran volumen de eventos. Su comunidad de automatización de redes es más pequeña y la curva de aprendizaje inicial es más pronunciada.
- Nornir: marco de trabajo en Python que permite ejecutar tareas en paralelo mediante hilos. Es flexible y fácil de depurar. Está pensado para equipos que dominan Python y necesitan soluciones a medida o para los que el rendimiento es crítico. Incluye menos componentes listos para usar, por lo que tu equipo asume una parte mayor del trabajo de ingeniería.
Soluciones comerciales y específicas de cada fabricante
- Cisco NSO: se basa en modelos, utiliza modelos de servicio YANG y un Network Element Driver por plataforma, y permite confirmar cambios en varios dispositivos en una sola transacción con posibilidad de reversión. Es habitual en las redes de los proveedores de servicios para aprovisionar servicios en equipos de distintos fabricantes. La licencia es comercial y tanto los modelos de los dispositivos como la lógica de los servicios residen en el propio producto, por lo que dejar de utilizarlo obliga a reconstruirlos.
- Controladores de los fabricantes (Cisco Catalyst Center, Aruba Central, Juniper Mist): gestionan la intención y las políticas con flujos de trabajo propios del fabricante. Funcionan bien si estandarizas tu red en torno a un solo fabricante y su controlador ofrece buenas API. Estos patrones no se trasladan a un parque de dispositivos de varios fabricantes.
Siempre puedes desarrollar tu propia solución en Python o Go. Así tienes el máximo control sobre la lógica específica de tu ámbito, los casos límite y los flujos de trabajo especializados. El precio es que te responsabilizas de todo: los estándares, los patrones de fiabilidad, las pruebas y el ciclo de vida.
Muchos equipos utilizan varias herramientas según el caso de uso y la infraestructura de red. No subestimes las ventajas de adoptar una herramienta existente frente a desarrollar una desde cero. Es probable que ya incluya la mayoría de las funciones que necesitas y, si la herramienta admite extensiones, el resto está a tu alcance.
Para cerrar el capítulo, veamos un ejemplo.
Ejemplo de implementación#
Seguimos con la red de campus del capítulo 4. La Fuente de Verdad ya almacena la definición del servicio de VLAN (su ID, su subred y los grupos de switches de destino) como datos de la capa técnica. Este ejemplo se centra en cómo el bloque de Ejecución expresa esa intención en la sintaxis propia de cada una de las tres plataformas y la despliega de forma fiable en todo el campus. Para ello utiliza las dos vías de las que dispone un adaptador: la generación a partir de plantillas y la traducción.
Escenario: El servicio de VLAN del equipo de aplicaciones, app-payments, entró en producción primero en el edificio B. La solicitud llegó a través de un sistema de tickets (nombre del servicio, edificio, perfil y aprobación) y se desarrolló en detalle al pasar de la capa de servicio a la capa técnica. Un mes después, el equipo pide el servicio para todos los edificios. El trabajo abarca los 800 switches de acceso y distribución, de tres fabricantes. Los 24 del edificio B ya tienen el servicio.
Requisitos:
- Desplegar la configuración de VLAN en varios switches en paralelo
- Utilizar el mismo registro de la capa técnica para generar la configuración a partir de plantillas o traducirlo para tres plataformas, y almacenar cada artefacto generado a partir de una plantilla antes del despliegue
- Comprobar las condiciones previas (se puede acceder a los switches y, donde la VLAN ya existe, esta coincide con la intención)
- Realizar una simulación para mostrar qué cambiaría
- Ejecutar el despliegue real con posibilidad de reversión si se producen fallos
- Verificar el resultado en tres niveles: al volver a leer la configuración, esta coincide con lo previsto, la VLAN está activa en el dispositivo y un host de la nueva VLAN puede alcanzar su puerta de enlace
Bloques que intervienen:
- Fuente de Verdad: contiene el inventario y la definición del servicio de VLAN
- Orquestación: coordina las fases y se encarga de los mecanismos de inicio (API, webhook o programación) y del control de aprobación
- Observabilidad: proporciona los datos anteriores y posteriores al cambio que consultan los controles de validación
- Ejecución:
- Integración de datos: una fuente de inventario dinámico que consulta la Fuente de Verdad al iniciar el trabajo, el registro de la capa técnica de cada dispositivo y un servicio de gestión de secretos que inyecta las credenciales
- Inicio de la ejecución: una llamada a la API desde el Orquestador, que está suscrito a los eventos de cambio de la Fuente de Verdad, además de puntos de entrada para la ejecución manual y programada
- Motor: cinco fases (comprobación previa, simulación, despliegue, verificación y reversión) que se ejecutan en lotes de 50, con un límite de concurrencia independiente para el sistema de autenticación
- Gestión del estado: seguimiento del estado por fase y por dispositivo, con un punto de reversión registrado para cada dispositivo
- Adaptador de red: un adaptador por plataforma. Los adaptadores de los fabricantes A y B generan la configuración a partir del registro con tus plantillas. El adaptador del fabricante C traduce el registro con un módulo declarativo. Cada adaptador entrega la configuración a través de la interfaz de su dispositivo y lee las respuestas que este devuelve
- Procesos de ejecución: un proceso por edificio del campus, cerca de sus dispositivos. El estado de ejecución se mantiene centralizado
Este ejemplo omite deliberadamente los nombres de los productos de automatización. Varias herramientas pueden desempeñar cada función, y nombrarlas haría que el capítulo quedase anticuado antes que por cualquier otro motivo. Por la misma razón, las plataformas de los dispositivos se describen de forma genérica: lo que importa es que hay tres y que cada una utiliza una sintaxis de configuración distinta.
El parque de dispositivos utiliza ambos métodos. Para elegir el de cada plataforma, se plantea la pregunta de la sección Generación a partir de plantillas y traducción: ¿necesita conocer el estado actual del dispositivo?
- Fabricantes A y B: generación a partir de plantillas. Sus interfaces admiten la sustitución completa de la sección de VLAN, por lo que para generar la configuración no hace falta consultar ningún dato del dispositivo. Las plantillas de sus adaptadores generan un artefacto completo por switch y el adaptador correspondiente se encarga de entregarlo.
- Fabricante C: traducción. Sus enlaces troncales solo aceptan la lista completa de VLAN permitidas. Etiquetar la VLAN 412 en un enlace ascendente que ya transporta las VLAN 10 y 20 exige enviar
10,20,412. Solo se puede conocer la parte10,20si antes se ha consultado el dispositivo. Una plantilla no puede hacerlo, por lo que el adaptador del fabricante C utiliza un módulo declarativo que primero consulta el enlace troncal.
El Listado 6.7 muestra la plantilla del adaptador del fabricante B aplicada al registro del Listado 4.7 del capítulo 4.
{% for sw in vlan.switches if sw.platform == "vendor-b" %}
! ===== {{ sw.name }} =====
vlan {{ vlan.vlan_id }}
  name {{ vlan.name | upper }}
{% if sw.role == "distribution" %}
interface Vlan{{ vlan.vlan_id }}
  description {{ vlan.name }} gateway
  ip address {{ vlan.gateway.address }} {{ vlan.gateway.mask | to_netmask }}
  mtu {{ vlan.mtu }}
  service-policy input QOS-{{ vlan.qos_class | upper }}-IN
{% endif %}
{% endfor %}Fíjate en el filtro del bucle. Esta plantilla genera la configuración para una sola plataforma. El adaptador del fabricante A tiene su propia plantilla, que se selecciona mediante el mismo campo platform y produce una sintaxis distinta a partir de ese mismo registro.
Vale la pena detenerse en dos detalles. El filtro to_netmask lo aportas tú, ya que Jinja no lo incluye. En la práctica, toda biblioteca de plantillas acaba incorporando unos cuantos filtros de este tipo para hacer cálculos con direcciones. Además, la MTU procede del registro, aunque en todo el campus se hayan adoptado las tramas jumbo como estándar. El valor 9216 se fija una sola vez en el perfil (Listado 4.6), sin codificarlo en la plantilla, tal como recomienda la sección Generación a partir de plantillas y traducción.
Al aplicar la plantilla para sw-b-dst-01 se obtiene el artefacto de configuración que el adaptador almacena y entrega más adelante:
! ===== sw-b-dst-01 =====
vlan 412
  name APP-PAYMENTS
interface Vlan412
  description app-payments gateway
  ip address 10.12.4.1 255.255.255.0
  mtu 9216
service-policy input QOS-AF21-INEl Listado 6.9 muestra los datos de partida de cada adaptador.
# vendor-a, vendor-b: rendering
device: sw-e-acc-07
platform: vendor-a
adapter: vendor-a 4.2.0             # templates; accepts schema 2.x
input: vlan-service app-payments, schema 2.1
artifact: artifacts/REQ-4519/sw-e-acc-07.cfg   # rendered during validation
---
# vendor-c: translation
device: sw-d-acc-03
platform: vendor-c
adapter: vendor-c 2.3.1             # pins module vendor-c-vlans; schema 2.x
input: vlan-service app-payments, schema 2.1
vlan: { id: 412, name: app-payments, tagged_on: [Po1, Po2] }Ninguna de las dos entradas contiene sintaxis de configuración. Si mañana el campus sustituyera los equipos del fabricante C por los de otro fabricante, nada cambiaría en esas entradas: solo cambiaría el adaptador del fabricante C. A partir de aquí, las fases son las mismas para todos los switches. Solo hay diferencias entre adaptadores en dos de ellas: en la simulación y en lo que entrega el adaptador durante el despliegue.
Flujo de implementación#
El trabajo del Ejecutor comienza en cuanto la Fuente de Verdad notifica un cambio y el Orquestador decide que ha llegado el momento de ajustar la red a la nueva intención. La Figura 6.6 agrupa las cinco fases en cuatro pasos y muestra quién se encarga de cada uno. La lista que sigue los recorre en orden.
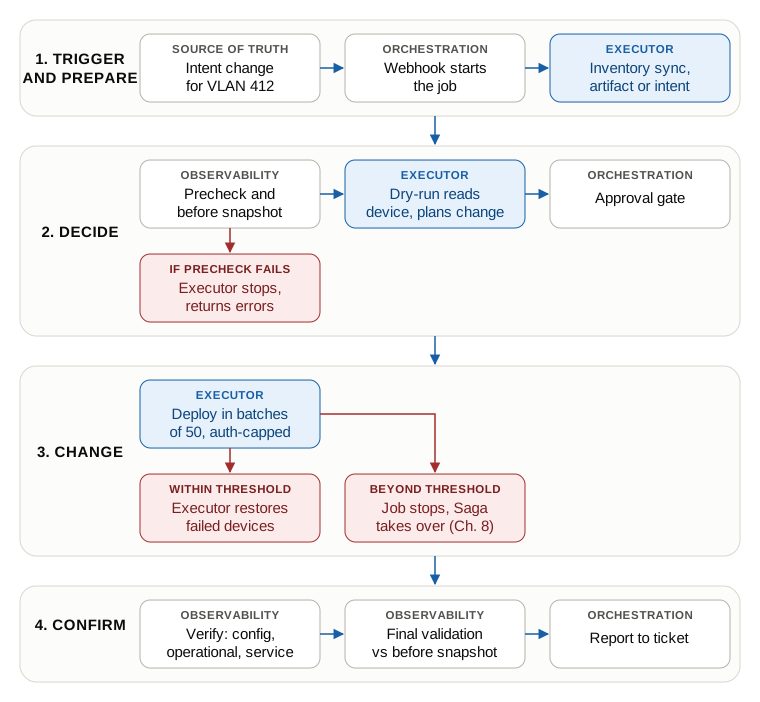
Iniciar y preparar. El evento de cambio de la Fuente de Verdad llega al Orquestador, que inicia el flujo de trabajo. El Orquestador sincroniza el inventario con la Fuente de Verdad para que la lista de destinos refleje los dispositivos registrados en ese momento y no los que había cuando se escribió el trabajo. A continuación, obtiene el registro de la capa técnica de cada switch incluido en el trabajo. Los adaptadores de los fabricantes A y B generan sus artefactos a partir de plantillas y estos se almacenan antes de pasar a cualquier otra operación.
Decidir. La fase de comprobaciones previas verifica que los dispositivos sean accesibles, comprueba el estado actual de las VLAN y el cumplimiento de las restricciones de la sede, y guarda una instantánea del estado inicial que servirá de referencia en la verificación. La fase de simulación consulta cada dispositivo y calcula qué cambiaría sin aplicar ningún cambio. Para los fabricantes A y B, compara el artefacto generado a partir de plantillas con la configuración en ejecución. Para el fabricante C, el módulo lee las listas de VLAN de los enlaces troncales e indica qué comandos enviaría. Ambas vías producen el mismo plan de cambio, por lo que la persona responsable de aprobarlo solo tiene que revisar un formato. A continuación, el flujo se detiene en el punto de aprobación, que corresponde a la Orquestación, y espera a que una persona autorice el cambio. Por diseño, esa persona es distinta de quien escribió la automatización. Todavía no se ha modificado ningún dispositivo, así que, si decides no continuar, no queda nada que deshacer.
Cambiar. La fase de despliegue aplica la intención de la VLAN en lotes de 50 dispositivos, con un límite de concurrencia independiente para el sistema de autenticación. Si fallan algunos dispositivos sin que se supere el umbral del cambio, la fase de reversión restaura solo esos dispositivos. Si se supera el umbral, la tarea se detiene, informa de lo ocurrido y la Saga del Orquestador toma el relevo, como se explica en el capítulo 8.
Confirmar. La fase de verificación comprueba la configuración, el estado operativo y el propio servicio. Espera a que la red converja antes de dar por válido el resultado. Observabilidad aporta los datos posteriores al cambio, la validación final los compara con la instantánea inicial y el resumen de la ejecución se incorpora al ticket.
En cada transición de una fase a la siguiente se entrega un artefacto.
Los artefactos que se intercambian entre fases#
La tarea se apoya en cuatro artefactos. Su estructura importa más que su sintaxis: cualquier herramienta que uses debería producir algo equivalente. Si no lo hace, has detectado una carencia.
La fase de simulación genera un plan de cambio por cada elemento del inventario. Ese plan es lo que se somete a aprobación, así que debe responder a tres preguntas: qué hay ahora, qué cambiaría y qué está en riesgo si algo sale mal. El Listado 6.10 muestra el plan de un switch del fabricante A. El campo source indica de dónde procede la comparación, tal como exige la regla de visibilidad del apartado Generación a partir de plantillas y traducción. El plan de un dispositivo del fabricante C tiene la misma estructura: en ese caso, source identifica la simulación del módulo como origen de la comparación y current incluye además las listas de VLAN de los enlaces troncales que el módulo leyó antes de calcular el cambio.
device: sw-e-acc-07
platform: vendor-a
source: rendered artifact vs running config
reachable: true
current:
  vlan_412: absent
planned:
  - create vlan 412, name app-payments
  - tag vlan 412 on uplinks Po1, Po2
risk:
  users_behind_this_switch: 46
  redundant_uplink: true
rollback_point: cfg-20260414-1431.bakDe manera similar, la fase de despliegue genera un registro de resultados por dispositivo o por elemento del inventario. Fíjate en los dos campos que permiten reintentar la operación con seguridad: attempts te indica que hubo dos intentos en ese dispositivo y rollback_point identifica la configuración que se puede restaurar. Una copia de seguridad de la configuración contiene secretos, así que guarda el punto de reversión con la misma protección que las credenciales o elimina de la copia los secretos que el Ejecutor resuelve en tiempo de ejecución.
A partir de la fase de despliegue, todos los artefactos llevan los mismos dos identificadores. El campo request_id identifica el ticket en el que se solicitó el cambio y el campo job_id identifica esta ejecución concreta. Si repites la ejecución después de un fallo parcial, se conserva el mismo request_id y se asigna un nuevo job_id. Así puedes distinguir entre «lo intentamos dos veces» y «dos personas pidieron lo mismo». Sin ese par de identificadores no puedes reconstruir el registro de auditoría que se describe en el apartado Consideraciones de seguridad: acabas con cambios en los dispositivos que no puedes vincular a ninguna solicitud y con solicitudes sin pruebas de los cambios que produjeron. El Listado 6.11 muestra un registro de despliegue.
{
  "request_id": "REQ-4519",
  "job_id": "JOB-20260414-1431",
  "device": "sw-e-acc-07",
  "phase": "deploy",
  "status": "changed",
  "started": "2026-04-14T14:31:08Z",
  "duration_s": 3.4,
  "attempts": 2,
  "first_error": "connection timeout",
  "rollback_point": "cfg-20260414-1431.bak"
}La fase de verificación genera su propio registro. El campo waited_s permite confiar en él: la comprobación no se ejecutó en el instante en que se aplicó la configuración, sino que esperó a que los protocolos convergieran.
{
  "request_id": "REQ-4519",
  "job_id": "JOB-20260414-1431",
  "device": "sw-e-acc-07",
  "phase": "verify",
  "status": "passed",
  "config": "match",
  "operational": "vlan 412 active, tagged on Po1 and Po2",
  "service": "test host in vlan 412 reached its gateway",
  "waited_s": 12
}El resumen por lotes reúne esos registros mientras la tarea sigue en marcha. Este es el artefacto que faltaba en el caso del principio: en cualquier momento indica con exactitud en qué dispositivos ha terminado el trabajo, en cuáles ha fallado y cuáles siguen pendientes de intervención.
request_id: REQ-4519            # the change ticket
job_id: JOB-20260414-1431       # this execution of it
name: vlan-412-app-payments
batch_size: 50
auth_concurrency_cap: 20   # the AAA server, not the switches, sets this
batches_completed: 11 of 16
devices:
  ok: 24          # already compliant, no change made
  changed: 524
  failed: 2
  pending: 250
failed_devices:
  - sw-c-acc-12   # authentication failure, not retried
  - sw-a-acc-04   # unreachable after 3 attempts
halt_threshold: 5% per batch, not reachedLa distinción entre ok y changed hace visible la idempotencia: los 24 switches del edificio B ya tenían la VLAN 412 y no hizo falta tocarlos. Los otros 524 no la tenían y se configuraron. Si vuelves a ejecutar la tarea, changed baja a cero.
Resumen de la solución#
Esta implementación muestra todas las capacidades esenciales de ejecución:
- Integración de datos: al inicio de la tarea, obtiene el inventario y el registro de la capa técnica de la Fuente de Verdad, y las credenciales del sistema de gestión de secretos
- Activación: el Orquestador realiza una llamada a la API y gestiona el webhook, la programación y el punto de aprobación que preceden a la llamada
- Gestión del estado: el estado de cada fase y de cada dispositivo permite seguir el progreso y delimitar los dominios de fallo. La secuencia de reversión está definida de forma explícita
- Motor: ejecución en paralelo por lotes, gestión de errores y simulación
- Adaptador de red: se utiliza un adaptador por plataforma. Entre los tres convierten un mismo registro en configuraciones con tres sintaxis distintas. Cada adaptador envía la configuración por la interfaz de su plataforma e interpreta las respuestas y los códigos de error. Dos adaptadores generan la configuración a partir de tus plantillas y el tercero utiliza un módulo declarativo
- Verificación: los datos de Observabilidad anteriores y posteriores al cambio sirven de base para la validación final y la elaboración de informes
Características de resiliencia:
- Las comprobaciones previas evitan desplegar cambios en dispositivos inaccesibles o crear VLAN duplicadas
- La simulación muestra los cambios antes de aplicarlos y utiliza el mismo formato de plan de cambio para la generación a partir de plantillas y para la traducción
- Antes de aplicar ningún cambio, los puntos de control de seguridad generan a partir de plantillas el artefacto previsto, lo almacenan y recopilan la configuración actual
- Los adaptadores idempotentes permiten repetir la ejecución con seguridad
- La verificación posterior detecta los fallos silenciosos
- La reversión se ejecuta como una fase independiente y se limita a los dispositivos que han fallado. Si se supera el umbral, la Saga del Orquestador toma el relevo
Consideraciones de escalabilidad:
- La ejecución se realiza en paralelo en lotes de 50 switches y se verifica cada lote antes de iniciar el siguiente
- A esta escala, el Orquestador se encarga de secuenciar los lotes y el motor se centra en ejecutar bien un lote cada vez
- El límite de concurrencia lo fija la dependencia compartida con menor capacidad, en este caso el servidor AAA, y no el número de dispositivos
Nada de esto requirió una herramienta fuera de lo común. Hizo falta conectar las cinco funciones en el orden adecuado, con un artefacto en cada transición y una forma de volver atrás en cada paso.
Resumen#
El Ejecutor hace realidad la automatización. La Intención es el plan y el Ejecutor se encarga de llevarlo a la práctica.
Para ello, el Ejecutor necesita varias funciones (Integración de datos, Activación, Gestión del estado, Motor y Adaptador de red). Estas funciones sustentan los principios de diseño que hacen que la automatización de redes sea fiable e inspire confianza. Además, el Ejecutor se ocupa de los detalles propios de cada plataforma mediante el Patrón Adaptador (Adapter Pattern), es decir, de cómo pasar de una intención independiente de la plataforma a la sintaxis de cada una mediante la generación a partir de plantillas o la traducción.
El Ejecutor se centra en interactuar con cada dispositivo. Deja los flujos de trabajo complejos en manos del bloque de Orquestación, que dirige el proceso de automatización de redes y proporciona al Ejecutor los datos de Intención y Observabilidad que necesita. El Ejecutor debe ser lo más sencillo posible, porque tiene mucha capacidad de actuación y entraña riesgos.
A continuación, en el capítulo 7, veremos la otra cara del Ejecutor (el Recolector) y todo el proceso de validación del resultado que el Ejecutor ha producido en la red.
Referencias#
- Network Programmability and Automation, 2.ª edición, Matt Oswalt, Christian Adell, Scott S. Lowe y Jason Edelman (O’Reilly, 2023). Generación de configuraciones y envío a los dispositivos (capítulos 11 y 13).
- Network Automation Cookbook, 2.ª edición, Christian Adell, Jeffrey Kala y Karim Okasha (Packt, 2025). Ejecución con Ansible en redes con equipos de distintos fabricantes y en redes en la nube.
- Mastering Python Networking, 4.ª edición, Eric Chou (Packt, 2023). NAPALM y Nornir.
- Infrastructure as Code, 2.ª edición, Kief Morris (O’Reilly, 2021). Ejecución idempotente.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo