La Fuente de Verdad#
Se solicitó que un nuevo servicio entrara en producción antes de que terminara la semana. El cambio era sencillo: una VLAN nueva, una subred nueva, una actualización de las reglas del cortafuegos y una comunidad Border Gateway Protocol (BGP) nueva en los routers de borde. El ingeniero de redes sabía qué había que hacer, pero el cambio implicaba a varios sistemas (y equipos), y coordinarlos llevó cuatro días.
Primero, el equipo responsable de la herramienta de IPAM reservó la subred y añadió el nuevo servicio al catálogo de servicios. El equipo de seguridad incorporó la nueva política a la plataforma de gestión de cortafuegos, el equipo de redes añadió la comunidad BGP y, por último, el equipo de monitorización actualizó los umbrales de su plataforma de monitorización. Cada sistema tenía su propia interfaz, su propio modelo de datos y su propio flujo de aprobación, pero los sistemas no estaban interconectados. El ingeniero tenía que trasladar el contexto a mano: copiaba valores de un sistema a otro (con la esperanza de que nada cambiara entre un paso y el siguiente).
Pasó el tiempo y, seis meses después, se retiró ese mismo servicio. Se eliminó la VLAN y se liberó la subred, pero la regla del cortafuegos siguió ahí (nadie recordaba que estaba vinculada a ese servicio). Lo mismo ocurrió con la comunidad BGP en los routers, y el umbral de monitorización siguió generando alertas de baja prioridad que el centro de operaciones de red (NOC) aprendió a ignorar. El resultado fue que la red acumuló varias configuraciones huérfanas porque nadie había hecho un seguimiento completo de los cambios ni los había vinculado a un registro compartido de intención que los relacionara entre sí.
Así es gestionar una red sin una Fuente de Verdad que admita la federación de datos: tramitar una solicitud nueva llevó mucho tiempo y la retirada del servicio dejó configuraciones sin eliminar, así que las incoherencias se acumularon. Nada relacionaba los datos entre sí, de modo que era imposible seguirles la pista.
El problema no estaba en el modelado de datos. Cada sistema contenía datos correctos sobre su propio ámbito: la subred en la herramienta de IPAM, la política en el gestor de cortafuegos y el umbral en la plataforma de monitorización. Lo que faltaba era todo lo que había alrededor de los datos. Un lugar que los relacionara todos. Un registro que indicara a qué servicio pertenecía cada valor.
El capítulo 4 presentó los cinco objetivos de la Fuente de Verdad y después definió los propios datos: qué contiene la intención, cómo se organiza en capas y qué hace que un valor sea válido. Para cumplir el resto de esos objetivos hacen falta mecanismos que aportan tres funcionalidades:
- La persistencia de datos almacena la intención, responde a preguntas que abarcan varios objetos, conserva el historial completo de la intención y registra de dónde procede cada valor. Así puedes saber qué era válido el martes pasado y qué sistema lo determinó.
- El consumo de datos proporciona los datos a las personas y los sistemas que los necesitan, en la forma que necesita cada cual, y regula quién puede leerlos, quién puede escribir en ellos y quién puede modificar el esquema.
- La federación de datos conecta los sistemas que ya contienen datos de referencia según un único principio: para cada dato hay exactamente una fuente autorizada.
Cada funcionalidad explica una parte de la historia. La federación es lo que aquel ingeniero hizo a mano durante cuatro días. El problema de consumo explica por qué, de entrada, no había una única interfaz a la que dirigir las consultas. Los metadatos de linaje que conserva la persistencia habrían dejado constancia de que la regla del cortafuegos pertenecía a ese servicio. El proceso de conciliación que veremos más adelante en este capítulo habría detectado la regla una vez retirado el servicio.
Estas funcionalidades también se apoyan en el esquema del capítulo 4 y unas en otras. La persistencia carece de sentido si los datos nunca fueron válidos. El consumo proporciona los datos que conserva la persistencia. La federación determina qué valores puede aceptar la persistencia en primer lugar. Este capítulo aborda las tres funcionalidades en ese orden. Después examina los aspectos operativos que determinan si la Fuente de Verdad (SoT) sigue siendo fiable tras la puesta en producción y, para terminar, vuelve a la misma red de campus.
Conviene aclarar el alcance del capítulo, porque sus límites generan confusión.
Qué abarca este capítulo
- Dónde se almacena la intención, cómo se mantiene la coherencia cuando hay cambios simultáneos y cómo reconstruir lo que era válido en cualquier momento del pasado
- Cómo accede cada consumidor a los datos, en la forma que necesita y con los controles de acceso correspondientes
- Cómo se conectan a este sistema los que ya son responsables de datos de referencia y cuál prevalece cuando discrepan
- Qué aspectos operativos determinan si la SoT sigue siendo fiable tras la puesta en producción
Qué queda fuera del alcance del capítulo
- Qué contiene la intención y qué hace que un valor sea válido, cuestiones que atañen a los propios datos (capítulo 4, donde la Figura 4.4 muestra cómo se reparten los cinco objetivos de la Fuente de Verdad entre ambos capítulos)
- Cómo genera el Ejecutor la configuración de los dispositivos a partir de la intención mediante plantillas (capítulo 6): el bloque que estudiamos en este capítulo almacena el registro y lo pone a disposición de otros sistemas, pero no lo convierte en comandos
- La interfaz de programación de aplicaciones (API) que la plataforma de automatización de redes (NAP) expone al exterior (capítulo 9). Para los sistemas internos de la NAP, la API de la SoT responde a la pregunta «¿cómo debería estar este dispositivo?». Para los consumidores externos a la NAP, la API de la capa de Presentación atiende la solicitud «despliega este servicio». Ambas son API, cada una con un público y un contrato distintos
- Cómo consume el Ejecutor los datos que proporciona este bloque (capítulo 6)
Empecemos por el lugar donde se almacena la intención.
Funcionalidades#
Persistencia de datos#
La intención de tu red cambia constantemente. Se añaden dispositivos, se actualizan configuraciones, se trasladan servicios y se ajustan políticas. La persistencia de datos almacena esa intención y cumple cuatro funciones distintas que veremos en este orden:
- Capacidad de consulta: obtienes los datos en la forma que necesitas para responder a tus preguntas, incluso cuando exigen recorrer varias relaciones. La persistencia determina qué respuestas cuestan poco de obtener. El consumo de datos determina cómo llegan al consumidor.
- Integridad transaccional: varias partes (personas, controladores, flujos de trabajo o agentes) pueden modificar datos compartidos sin corromperlos ni sobrescribir inadvertidamente los cambios de otras.
- Control de versiones: se registra cada cambio, de modo que puedes seguir la evolución de la intención, comparar versiones y volver a una anterior.
- Linaje: los metadatos que se almacenan junto a la intención indican quién es responsable de cada valor y de dónde procede. Son datos sobre tus datos y hacen posibles la federación y el control de acceso.
Las implementaciones van desde archivos YAML en un repositorio Git hasta una base de datos de grafos diseñada para ese fin. Lo que cada una te ofrece de serie varía enormemente. Empieza por dónde se almacenan los datos.
Elegir cómo almacenar los datos del modelo tiene consecuencias importantes para su coherencia, su rendimiento y su evolución. Esas consecuencias se vuelven críticas cuando tu red pasa de cientos a cientos de miles de objetos gestionados. La Figura 5.1 relaciona los requisitos habituales con el tipo de almacenamiento que mejor encaja en cada caso. La lista siguiente repasa las cuatro opciones.
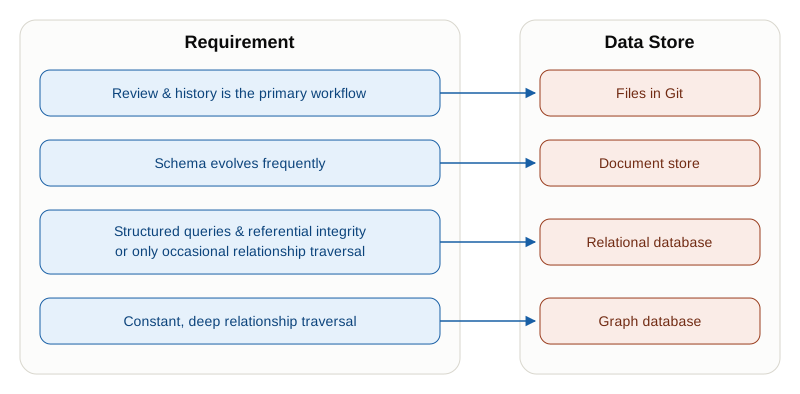
Archivos en Git (por ejemplo, documentos YAML o JavaScript Object Notation (JSON), a veces CSV): es la opción más ligera y la única que ofrece de serie el historial, las ramas, la comparación de cambios y la revisión, porque su motor de almacenamiento se diseñó para ello. Es adecuada para redes pequeñas o que cambian despacio, y así empiezan muchos equipos. Los límites aparecen al crecer: no hay integridad referencial ni consultas indexadas, y cada consumidor tiene que analizar el archivo entero para responder a una pregunta sobre un solo dispositivo.
Bases de datos relacionales (por ejemplo, MySQL o PostgreSQL): son una apuesta segura para la mayoría de los equipos porque se trata de una tecnología probada. Garantizan la coherencia del esquema, ofrecen transacciones Atomicidad, consistencia, aislamiento y durabilidad (ACID) y la mayoría de los ingenieros de tu equipo ya conocen SQL. Destacan a la hora de representar jerarquías normalizadas (VLAN que contienen interfaces) y de evitar anomalías en los datos. La contrapartida es que cambiar el esquema resulta costoso a gran escala y el rendimiento cae en picado cuando se encadenan varias uniones sobre millones de filas.
Bases de datos documentales (por ejemplo, MongoDB o CouchDB): son una muy buena opción si necesitas flexibilidad en el esquema y escalabilidad horizontal. Los documentos permiten modelar estructuras anidadas de forma natural (un dispositivo con todas sus configuraciones y metadatos en un único bloque). La dificultad está en que la coherencia entre documentos depende en gran medida de ti, y el coste de las consultas aumenta rápidamente con su complejidad. Salvo que tengas un motivo concreto para elegir una base de datos documental, quédate con una relacional.
Bases de datos de grafos (por ejemplo, Neo4j): son más adecuadas cuando las relaciones importan más que los objetos: «¿A qué VLAN se conecta esta interfaz? ¿Qué dispositivos encaminan el tráfico entre estas dos ubicaciones?». Recorren con eficiencia relaciones de cualquier profundidad. Pero, salvo que hagas consultas complejas de topología continuamente, estás eligiendo la opción menos habitual. Tu equipo de operaciones no la conoce, las herramientas son menos maduras y el rendimiento de escritura es inferior en las actualizaciones sencillas. Las bases de datos de grafos resuelven problemas reales, pero asegúrate primero de que realmente tienes esos problemas.
La elección de la base de datos es una de las principales diferencias entre los productos de este ámbito. Por ejemplo, NetBox y Nautobot utilizan bases de datos relacionales, mientras que Infrahub utiliza una base de datos de grafos, como puedes ver en la sección Panorama de soluciones.
La mayoría de los despliegues de la Fuente de Verdad empiezan con una sola base de datos relacional y muchos nunca necesitan más. Los de mayor tamaño suelen acabar adoptando la persistencia políglota (polyglot persistence): distintos tipos de datos se guardan en distintos tipos de almacén. Cada almacén se elige por el tipo de datos que mejor gestiona y, juntos, forman una sola Fuente de Verdad. La Figura 5.2 muestra cómo se organiza el conjunto.
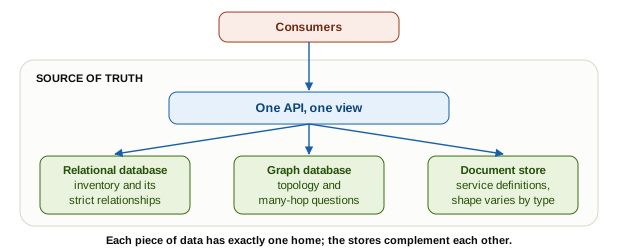
El inventario y sus relaciones estrictas permanecen en una base de datos relacional. La topología, con sus consultas de muchos saltos, encaja en una base de datos de grafos. Las definiciones de servicios encajan en un almacén documental porque su estructura anidada varía según el tipo de servicio (una sede de sucursal, una VLAN de campus o una política de cortafuegos). Los almacenes se complementan en lugar de competir entre sí, por lo que se mantiene la regla de la federación de datos: cada dato sigue teniendo un único lugar de referencia. El coste es el mismo que conlleva la federación, a menor escala: hay más sistemas que mantener en funcionamiento y consultas que combinan datos de varios de ellos.
El capítulo 12 explica cómo se comportan estas opciones a gran escala: las réplicas de lectura de la SoT, la partición de los datos por regiones y hasta qué punto pueden estar desactualizados los datos de una lectura antes de que un flujo de trabajo tenga que repetir la consulta.
Consultas sobre datos relacionados#
Elegir el almacenamiento parece una decisión sobre cómo se escriben los datos. En gran medida, es una decisión sobre cómo se leen, y las consultas que inclinan la balanza son las que recorren relaciones.
Fíjate en las preguntas que tanto los sistemas de automatización como los ingenieros plantean a un modelo de red:
- ¿A qué dispositivos afecta la caída del circuito C-2271? Del circuito a sus terminaciones, de ahí a las interfaces, de estas a los dispositivos y de los dispositivos a las sedes. Cuatro saltos.
- ¿Dónde se utiliza
192.0.2.1? Una dirección a la que hacen referencia una interfaz, un vecino BGP, un extremo de túnel y un servicio. Un salto en cuatro direcciones. - ¿Qué prefijos están activos en los switches de acceso del edificio B que ejecutan un sistema operativo determinado? De la sede a los dispositivos filtrados por función y sistema operativo, de ahí a las interfaces y de estas a los prefijos. Tres saltos con un filtro en cada nivel.
- ¿Qué otros servicios utilizan el enlace ascendente por el que pasa este servicio? Del servicio a sus interfaces, de ahí al enlace ascendente y, desde él, a todos los demás servicios que lo utilizan. La profundidad es desconocida porque la respuesta depende de la topología.
Ninguna de estas preguntas es inusual. La primera sirve para analizar el impacto antes de una ventana de mantenimiento. La segunda es la que te haces antes de reutilizar una dirección, y la última es la que un ingeniero quiere responder antes de retirar el tráfico de un enlace. Una SoT incapaz de responderlas obliga a volver a las sesiones Secure Shell (SSH) y a las hojas de cálculo, y a trasladar el contexto a mano, como hacía el ingeniero de la historia inicial.
La verdadera diferencia entre los tipos de almacén está en lo que cuesta responder a esas preguntas con cada uno:
- Los archivos en Git carecen de índices. Cada consulta exige recorrer el árbol de archivos y, si la pregunta implica relaciones, primero hay que cargar el árbol en memoria. Con 200 dispositivos es viable. Con 20 000 deja de serlo.
- Los almacenes relacionales responden a esas preguntas mediante consultas declarativas. Una unión de cuatro tablas es algo habitual: escribes la consulta una vez, el planificador de consultas determina cómo ejecutarla y los índices permiten que siga siendo rápida. El límite aparece cuando no puedes prever la profundidad. «Todos los dispositivos aguas abajo de este» se convierte en una consulta recursiva que SQL permite expresar, pero que a nadie le gusta escribir.
- Los almacenes documentales responden de inmediato a cualquier consulta que se resuelva dentro de un solo documento. Si la consulta abarca varios documentos, la resuelves en el código de tu aplicación. La unión se convierte en un bucle: primero recuperas los dispositivos, después las interfaces de cada dispositivo y, por último, el prefijo de cada interfaz. Es el patrón de consulta N+1 (N+1 query) y tiene dos costes. Cada consumidor vuelve a implementar la unión y la latencia depende del abanico de llamadas que se desencadenan, no de una sola consulta.
- Los almacenes de grafos admiten de forma nativa los recorridos cuya profundidad no puedes prever. El recorrido de profundidad variable es la operación básica, así que la consulta de análisis de impacto se lee casi como la propia pregunta. El coste se paga en otra parte: hay menos ingenieros que sepan escribir esas consultas y un filtro sencillo por atributo no es más rápido que en un almacén relacional.
Hay dos matices que importan más que la propia comparación.
En primer lugar, la interfaz de acceso limita lo que puedes hacer con el sistema subyacente. La mayoría de los consumidores nunca acceden directamente al almacén, sino que pasan por la API de la propia SoT. Si esa API solo devuelve un tipo de objeto por llamada, te encuentras con el problema N+1 incluso si detrás hay una base de datos relacional. Por eso, en Consumo de datos, la flexibilidad de lectura se trata como una decisión que atañe tanto a la interfaz como al almacenamiento.
En segundo lugar, si hagas lo que hagas sigue siendo costoso responder a una pregunta, calcula la respuesta de antemano. En eso consiste la proyección que se describe en Modelado de datos en función del contexto: ganas velocidad a costa de la actualidad de los datos.
Así que, antes de elegir un almacén, anota las diez preguntas que se harán con más frecuencia tus automatizaciones y tus ingenieros, y cuenta los saltos que exige cada una. Si casi todas parten de un objeto cuyo identificador ya conoces y terminan un salto después, la elección apenas importa. Si varias preguntan «¿a qué más afecta esto?» y la profundidad no es fija, tienes un requisito, no una preferencia: por mucho que trabajes después en el esquema, no añadirás una capacidad que el almacén no tiene.
Uno de los principales retos de la capa de persistencia es la gestión de conflictos.
Datos transaccionales#
Da por hecho que habrá más de un actor con capacidad de escritura. Una SoT en la que solo escribe un actor es una ficción cómoda que se desmorona la primera semana. Un ingeniero edita un dispositivo en la interfaz de usuario mientras una tarea de conciliación sincroniza ese mismo dispositivo con los datos del IPAM. Al mismo tiempo, un controlador actualiza el estado de las interfaces y un agente propone un cambio masivo en toda la sede. Los cuatro pueden modificar el mismo registro en el mismo segundo.
El requisito arquitectónico es que varios actores deben poder escribir en datos compartidos sin sobrescribir silenciosamente la intención de los demás. Silenciosamente es la palabra clave, porque un conflicto que se manifiesta como un error es un inconveniente. Pero un conflicto que se resuelve descartando el cambio de alguien es una futura interrupción del servicio que nadie podrá explicar.
Puedes conseguirlo con distintos mecanismos:
- Concurrencia optimista (optimistic concurrency): cada registro lleva una versión. Envías la versión que leíste. Si ya hay una posterior, el sistema rechaza la escritura y vuelves a intentarlo con el estado actual. El coste es bajo y el fallo resulta visible, justo lo que te interesa en este caso.
- Resolución explícita de conflictos: cuando no se puede decidir automáticamente cómo fusionar los cambios, dejas la fusión pendiente y pides a una persona que decida. El caso típico es la fusión de ramas en Git.
- Transacciones: agrupan escrituras relacionadas para que se confirmen o fallen juntas. Las veremos a continuación.
La otra opción evidente es el bloqueo pesimista, que en esta capa suele ser una trampa. Mientras un actor mantiene el bloqueo, impide que avance precisamente la automatización que intentas habilitar. Si alguien olvida liberarlo, la bloquea indefinidamente.
Esta sección trata la gestión de conflictos dentro de una misma fuente de datos. Los conflictos entre fuentes se abordan en Federación de datos, donde los resuelves declarando qué actor es responsable de escribir cada atributo. El IPAM es responsable de la dirección y la SoT central, de la interfaz a la que se asigna. Ninguno puede sobrescribir los datos del otro, aunque ambos escriban en el mismo objeto.
Las garantías transaccionales preservan la consistencia de los datos cuando varios cambios relacionados deben completarse o fallar juntos. Estas son las cuatro propiedades ACID:
- Atomicidad: una transacción se aplica por completo o no se aplica. Si falla alguna de sus partes, se revierte la transacción entera como si nunca hubiera ocurrido. Nunca te quedas con un cambio a medio aplicar en el que existe la VLAN pero falta el prefijo que necesita.
- Consistencia: una transacción lleva el almacén de un estado válido a otro y respeta todas las restricciones, relaciones y reglas de tipos que hayas definido. Incluso cuando la transacción se completa correctamente, no puede dejar datos que infrinjan esas reglas.
- Aislamiento: las transacciones concurrentes no interfieren entre sí e, idealmente, cada una se comporta como si se ejecutara sola. Las bases de datos ofrecen distintos niveles de aislamiento que equilibran el rigor de las garantías y el volumen de operaciones por segundo. Los niveles menos estrictos permiten que un flujo de trabajo asigne un prefijo que otro aún está intentando reservar. Elige el nivel más estricto que admita tu volumen de escrituras: para asignar prefijos e identificadores de VLAN necesitas un aislamiento serializable o un bloqueo explícito.
- Durabilidad: una vez confirmada una transacción, sus cambios sobreviven a una caída del sistema, un corte de corriente o un reinicio. Normalmente se debe a que los cambios llegan a un registro de escritura anticipada antes de que el sistema comunique la confirmación.
El modelo alternativo es BASE (Basically Available, Soft state, Eventually consistent), que relaja esas garantías a cambio de disponibilidad y capacidad de escalado horizontal. Esa elección tiene sentido para una cadena de procesamiento de telemetría que ingiere millones de puntos de datos por segundo. Para la intención suele ser una mala elección. La razón de ser de una Fuente de Verdad es la consistencia, y BASE no elimina esa necesidad. Traslada el trabajo a cada cliente, que ahora debe conciliar lo que leyó con lo que haya podido cambiar desde entonces. Da preferencia a ACID para la intención y reserva BASE para los datos de observabilidad del capítulo 7.
Datos versionados#
Tu red cambiará, y el cambio empieza en tus datos: un circuito nuevo, la reasignación de una dirección Internet Protocol (IP) o la retirada de una sede. El bloque de persistencia de datos debería ofrecer dos capacidades:
- Un registro de auditoría que te permita ver cuándo cambiaron los datos, quién los cambió y por qué.
- Una instantánea con marca de tiempo de los datos en cualquier momento, que también te sirva como salvaguarda si necesitas revertir un cambio.
Un registro de auditoría deja constancia inmutable de cada cambio y así construye un historial completo. También es el primer eslabón de la cadena de evidencias que pide un auditor. El capítulo 13 enlaza ese registro con la ejecución del flujo de trabajo de cambio y con el cambio posterior en el dispositivo, de modo que puedas seguir un valor desde la solicitud hasta la red. El registro puede adoptar distintas formas. Un registro estructurado de cambios recoge el valor de cada campo antes y después del cambio, quién lo solicitó y por qué:
Change Event:
  timestamp: 2026-02-07T14:32:15Z
  user: engineer@example.net
  action: UPDATE
  resource_type: vlan
  resource_id: vlan-100
  changes:
    description: "Customer VLAN" → "Production Customer VLAN"
    assigned_sites: [site-a, site-b] → [site-a, site-b, site-c]
  reason: "Adding new office location"
request_id: req-12345Un commit de Git cumple la misma función con un mecanismo distinto y, además, permite trabajar con ramas y comparar versiones:
commit 0c0ad51152f9b3be307802badb15eca8d121c576 (HEAD -> new-site, origin/new-site)
Author: Engineer <engineer@example.net>
Date:   Sat Feb 7 09:43:59 2026 +0100

    Adding a new site: BCN01

diff --git a/sites.yaml b/sites.yaml
index ae18c87..dabf6c5 100644
--- a/sites.yaml
+++ b/sites.yaml
@@ -219,3 +219,7 @@ sites:
   MAD01:
     region: emea
     status: active
+  BCN01:
+    region: emea
+    status: planned
+ prefix: 192.0.2.0/24Sea cual sea su forma, el valor del registro está en las preguntas que permite responder. Cada una corresponde a algo que necesitarás en un mal día:
- Viaje en el tiempo: ¿cuál era la intención de red el 7 de febrero? Así puedes devolver una sede al estado que tenía antes de una migración, y un auditor puede ver la intención que estaba vigente durante un incidente en lugar de la que tienes ahora.
- Rendición de cuentas: ¿quién hizo este cambio y por qué? El porqué importa más que el quién. Un registro que solo indica que un ingeniero amplió un prefijo te dice poco. Si incluye la solicitud que motivó el cambio, puedes determinar si fue un error o si simplemente te sorprendió.
- Trazabilidad: ¿qué configuración desplegada corresponde a esta intención? Ese vínculo conecta un dispositivo que se comporta de forma extraña con la decisión que dio lugar a ese comportamiento. Sin él, cada investigación empieza de cero.
- Diferencias y comparación: ¿qué cambió entre la versión Y y la versión Z? Esa comparación es la base de la revisión previa al cambio y del análisis del alcance del impacto posterior. Es lo que convierte «anoche cambió algo» en una lista de los 14 objetos que cambiaron.
Una propiedad clave del registro de auditoría es la inmutabilidad: nadie, ni siquiera los administradores, puede editar una entrada del historial. Así se evitan encubrimientos y el registro sigue siendo fiable. Inmutable no significa permanente, y esa diferencia permite definir plazos de conservación: una entrada nunca se puede reescribir, pero sí puede caducar según una política que hayas publicado de antemano. La propia eliminación se puede auditar si sigue un calendario publicado. La edición directa de una entrada, en cambio, no.
Los registros de auditoría crecen sin cesar (incluso eliminar datos genera una entrada), así que define esa política de forma explícita y sopesa los requisitos de cumplimiento y el coste. Por ejemplo:
- Durante 2 años, conserva todo el detalle: cada cambio en cada campo.
- Entre los 2 y los 7 años, conserva el primer y el último valor de cada campo y descarta los pasos intermedios. Así, una VLAN que haya cambiado 10 veces conserva 2 entradas.
- Traslada los datos de más de 1 año a almacenamiento en frío. Es una decisión independiente del nivel de detalle: conservarlos allí cuesta poco, pero leerlos lleva tiempo.
En relación con los eventos de cambio de los datos, los patrones de reconstrucción del estado a partir de eventos (event sourcing patterns) son potentes: guardan todos los cambios como eventos para poder recrear los datos por completo. Sin embargo, son menos habituales en la gestión de infraestructuras de red. Esto se debe a que la intención de red depende en gran medida del estado. Los datos actuales importan más que la secuencia de cambios que llevó a ellos. Además, los cambios de red suelen implicar un estado externo (configuraciones de dispositivos, asignaciones de direcciones IP en sistemas externos) que no se puede reconstruir por completo solo a partir de los eventos. Aun así, la reconstrucción del estado a partir de eventos puede ser valiosa en casos concretos, como el cumplimiento de requisitos de auditoría o el análisis forense.
Estas propiedades del registro de auditoría te permiten avanzar y retroceder en el tiempo. Para ello, los sistemas modernos de Fuente de Verdad toman muchas ideas del control de versiones de software. Así puedes trabajar en paralelo de forma segura, experimentar con cambios y recuperarte rápidamente de los errores.
Ramas para líneas de trabajo paralelas
Toda organización en la que trabajen en paralelo varios ingenieros o agentes de inteligencia artificial (IA) necesita una forma de que cada uno pueda trabajar sin bloquear a los demás.
Inspirados en el desarrollo de software, los mecanismos de ramificación permiten mantener líneas de trabajo paralelas. Cada participante puede trabajar en ramas de datos paralelas y fusionarlas con la rama «principal» cuando estén listas. Esa fusión es una oportunidad para resolver las inconsistencias que se hayan podido introducir.
Por ejemplo, si usas Git como mecanismo de control de versiones, el flujo de trabajo podría ser el siguiente:
main branch (production intent)
  │
  ├─── feature/add-dallas-office (Engineer A)
  │     • Creates site DAL-01
  │     • Allocates VLANs 2100-2110
  │     • Defines 5 new devices
  │     • Adds an uplink on device-core-01
  │
  └─── feature/upgrade-ntp-servers (Engineer B)
        • Changes NTP config for all devices
• Updates 3,000 device recordsCuando ambas ramas vuelven a fusionarse con main:
- Sin conflicto: las ramas han modificado objetos distintos → fusión automática
- Conflicto detectado: ambas ramas han modificado device-core-01, la A el enlace ascendente y la B el servidor Network Time Protocol (NTP). Que exista un conflicto real depende del nivel de detalle de la fusión: si opera por campos, incorpora ambos cambios. Si opera por objetos, se detiene y pide que alguien decida
- Validación: antes de confirmar la fusión, su resultado debe cumplir todas las reglas de aplicación
Implementar este mecanismo de ramificación en bases de datos tradicionales es de por sí un reto importante. Por ejemplo, NetBox y Nautobot, que utilizan bases de datos relacionales, han adoptado enfoques distintos. NetBox da a cada rama su propia copia del esquema de la base de datos. Nautobot ofrece la aplicación Version Control, basada en Dolt (una base de datos SQL que incorpora control de versiones al estilo de Git). Infrahub se diseñó desde el principio para trabajar con ramas al estilo de Git e implementó este mecanismo con una base de datos de grafos que admite ramas de forma nativa.
Reversión y recuperación
Los errores ocurren. La reversión de datos debe ser rápida y fiable. Ten en cuenta que lo que reviertes son los propios datos de la capa técnica, no la configuración de red generada a partir de ellos mediante plantillas.
Hay tres enfoques para la reversión de datos. La Tabla 5.1 los compara. La mayoría de los sistemas en producción acaban adoptando el tercero:
| Enfoque | Funcionamiento | Espacio de almacenamiento adicional | Velocidad de recuperación | Complejidad |
|---|---|---|---|---|
| Instantáneas | Copias completas y periódicas de todo el conjunto de datos | Alto (una copia completa por instantánea) | Rápida (restauración directa) | Baja |
| Reconstrucción del estado a partir de eventos | Se registran todos los cambios como eventos y se reproducen para reconstruir el estado | Bajo (solo se almacenan las diferencias) | Más lenta (hay que reproducir los eventos) | Alta. Ten en cuenta el matiz anterior: si la intención depende de un estado externo, no se puede reconstruir por completo solo a partir de los eventos |
| Híbrido | Instantáneas cada N horas + registro de eventos entre instantáneas | Medio | Rápida hasta el punto de la instantánea, después se reproducen los eventos | Media |
La reversión puede iniciarse de dos formas:
- Manual: un operador detecta un problema e inicia la reversión
- Automática: el Orquestador decide iniciar la reversión cuando el bloque de Observabilidad informa de un problema tras el despliegue:
- Aumentan las tasas de error
- Falla la validación posterior al despliegue («500 dispositivos inaccesibles tras el cambio»)
- Se supera un umbral de impacto en el negocio («incumplimientos del acuerdo de nivel de servicio (SLA) con los clientes > 10»)
La combinación de las ramas (trabajo en paralelo sin conflictos) y la reversión (recuperación rápida ante errores) aporta la flexibilidad temporal que exigen los escenarios más complejos de automatización de redes.
Como puedes crear una rama de los datos antes de activarlos, los cambios pueden pasar por flujos de trabajo de aprobación de cambios. Una propuesta de cambio pasa por varias etapas antes de entrar en vigor, de forma parecida a lo que ocurre con el código en la integración continua.
Aquí confluyen tres capítulos y conviene saber qué aborda cada uno. Este capítulo se ocupa del mecanismo para cambiar los datos: crear una rama, proponer el cambio, comprobarlo, aprobarlo y fusionar la rama. El capítulo 11 aborda el flujo de trabajo de cambio que ejecuta esas comprobaciones y los controles que, según el resultado, permiten o impiden el paso a la siguiente etapa. Así, una propuesta que no supera la simulación no puede avanzar, lo intente quien lo intente. El capítulo 13 trata la gobernanza: qué cambios puede aprobar por sí solo un control automático y cuáles siguen necesitando la aprobación de una persona. La Figura 5.3 muestra el flujo de trabajo.
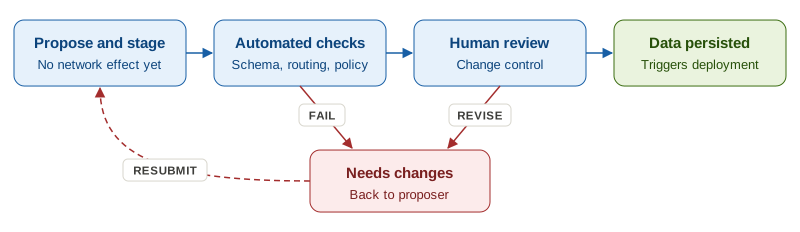
Un flujo de trabajo de cambio de datos podría seguir estos pasos:
Un operador propone un cambio: «Añadir 50 dispositivos nuevos en las sucursales». El cambio pasa al entorno de preproducción (todavía no afecta a la red y puedes previsualizarlo, probarlo y ejecutar una simulación)
Se ejecutan las comprobaciones automáticas (integración continua):
- Validación: ¿respeta el esquema y cumple las restricciones?
- Simulación: ¿interrumpe el enrutamiento o el funcionamiento de MPLS?
- Cumplimiento: ¿infringe alguna política de seguridad?
- Informe: el cambio ha superado todas las comprobaciones
Revisión por pares:
- Un segundo ingeniero, que nunca puede ser quien solicitó el cambio, revisa las diferencias entre la intención vigente y la propuesta, la justificación del cambio y el alcance del impacto
- Aprueba la propuesta o solicita cambios
- Los cambios que quedan fuera de los límites establecidos también pasan por el comité asesor de cambios (CAB)
Almacenamiento de los datos: una vez aprobados, los datos se guardan de forma persistente. Esto puede hacer que el Orquestador despliegue más adelante los cambios correspondientes en la red (es una forma habitual de iniciar los flujos de trabajo de ejecución automatizada)
Sin embargo, no todos los cambios deberían seguir ese camino. Decidir cuáles deben hacerlo es una cuestión de gobernanza. En pocas palabras: establece controles que dejen pasar automáticamente la mayoría de los cambios, que son rutinarios, y reserva la revisión humana para los que queden fuera de esos límites. Un CAB que se reúne cada semana para aprobar el alta de nuevas VLAN sobrevivirá a tu programa de automatización. El capítulo 13 aborda la gobernanza de los cambios, los puntos de aprobación y dónde trazar esos límites.
Otra función importante, que a muchos les pasa desapercibida hasta que la echan en falta, es el linaje de los datos.
Linaje de los datos#
Junto a la intención hay un segundo conjunto de datos, mucho más pequeño, que no forma parte de la intención: son datos sobre los propios datos (lo que solemos llamar metadatos). ¿Quién es el propietario de este registro? ¿De qué sistema procede? ¿Cuándo se sincronizó por última vez? ¿Lo ha modificado alguien desde entonces?
Eso es el linaje. Los equipos suelen descubrir tarde que lo necesitan, por lo general justo después de un incidente en el que nadie ha sabido decir de dónde venía un valor. Merece la pena incorporarlo al diseño desde el principio, porque otras dos funciones dependen de él:
- La federación necesita saber, para cada valor, qué sistema es la referencia y si la copia local es solo eso, una copia. Un prefijo que llegó del IPAM hace dos horas y otro que un ingeniero introdujo a mano son cosas distintas, y solo los metadatos permiten distinguirlos.
- El control de acceso y la auditoría necesitan que la titularidad sea una propiedad de los datos, en vez de una convención que alguien tiene en la cabeza.
Basta con unos pocos atributos en cada objeto. Para los datos que genera la propia SoT:
locations:
  - name: BCN01
    prefix: 192.0.2.0/24
    _metadata:
      owner: "network-eng@example.net"
      source: null                      # authored here
last_modified: "2026-03-14T09:21:00Z"Y para un valor que esta SoT almacena, pero del que no es propietaria:
primary_ip:
  address: 192.0.2.2
  mask: 26
  _metadata:
    owner: null                         # nobody here owns it
    source: "external-ipam"             # this is a copy
last_synced: "2026-03-14T07:55:00Z"La combinación de source y last_synced permite a quien consume los datos decidir si puede utilizarlos. Puedes usar unos datos que se sincronizaron hace cuatro minutos. Si se sincronizaron el trimestre pasado, tienes que actualizarlos antes de usarlos como base para un cambio. Sin la marca de tiempo no hay forma de distinguir los dos casos.
Esto también permite llevar a la práctica la matriz de gobernanza de Federación de datos. La matriz indica qué sistema es la referencia para cada dominio de datos. Los metadatos de linaje dejan constancia de esa decisión en cada registro, de modo que quien lo consulte pueda comprobarla sin tener que saberse la política de memoria.
Si llevas la idea un paso más allá, llegas a la procedencia de los datos, que permite rastrear cada parámetro por separado en vez de limitarse al registro completo. Así puedes averiguar quién o qué estableció por última vez el valor de un campo concreto, igual que git blame responde a esa pregunta para una línea de código. Es la diferencia entre «este registro cambió el martes» y «esta es la ejecución de la automatización que puso aquí la dirección incorrecta».
Una vez almacenados los datos, es hora de empezar a utilizarlos.
Consumo de datos#
De nada sirven unos datos encerrados en una base de datos. El consumo de datos es la forma en que las personas y los sistemas acceden a ellos. Si facilitas el acceso, conseguirás que la gente lo adopte. Si lo complicas, buscará otra vía.
Las lecturas y las escrituras no son simétricas, y diseñar como si lo fueran es un error frecuente. Las escrituras son relativamente poco frecuentes y necesitan todas las garantías de la sección anterior: validación, transacciones y detección de conflictos. En cambio, cada flujo de trabajo, cada panel y cada agente que ejecutes lee datos constantemente. Las lecturas necesitan rapidez y capacidad para expresar consultas, dos exigencias que entran en tensión. GraphQL permite al cliente pedir solo los campos que necesita, pero es el servidor quien ejecuta la consulta. Por eso, la interfaz más flexible puede convertirse en la más lenta bajo carga. Decide qué aspecto vas a optimizar en cada caso de uso. Una sola interfaz rara vez cubre todas las necesidades.
Los usuarios acceden a este bloque a través de la capa de Presentación. Muchos productos de SoT también incorporan una interfaz de usuario, pero el bloque expone sus datos a través de API. La Tabla 5.2 compara los estilos de API más populares.
| Interfaz | Patrón de petición | Caso de uso | Características |
|---|---|---|---|
| Representational State Transfer (REST) | Verbos de Hypertext Transfer Protocol (HTTP) aplicados a las URL de los recursos | Operaciones CRUD de propósito general | Interfaz sencilla, ampliamente conocida y sin estado, aunque puede exigir muchas peticiones y complica la gestión de versiones |
| GraphQL | Un único punto de acceso donde el cliente especifica exactamente qué campos necesita | Consultas complejas sobre varios recursos | Interfaz flexible en la que el cliente decide qué datos recibe, lo que evita recuperar datos de más a costa de un servidor más complejo y del riesgo de incurrir en N+1 consultas |
| gRPC Remote Procedure Call (gRPC) | RPC basadas en Protobuf sobre HTTP/2 | Aplicaciones de alto rendimiento y baja latencia | La codificación binaria y la multiplexación de HTTP/2 reducen la sobrecarga cuando se hacen muchas llamadas pequeñas, a costa de una curva de aprendizaje más pronunciada y un soporte limitado en los navegadores |
| Webhooks | El servidor envía los cambios a los puntos de acceso registrados | Automatización reactiva y sincronización casi en tiempo real | Comunicación asíncrona y desacoplada, sin la sobrecarga del sondeo, aunque la entrega no es fiable y hay que gestionar los reintentos y la seguridad |
La mayoría de las SoT acaban ofreciendo varios de estos estilos a la vez, y eso está bien. Lo que importa en este capítulo es entender qué opciones tienes y qué implica elegir cada una. El capítulo 9 trata en detalle el diseño de API, la documentación y las interfaces disponibles para los clientes.
Salvo en la última interfaz, en todas es el consumidor quien solicita los datos. La excepción ilustra una posibilidad más general. Además de realizar consultas síncronas, un consumidor puede suscribirse a los cambios y recibir un aviso a través de un webhook o de un bus de mensajes cuando cambie la intención. Funciona en ambos sentidos. Los sistemas que reciben datos de la SoT se suscriben para poder actuar en cuanto se apruebe una VLAN, sin esperar al siguiente sondeo. A su vez, la SoT se suscribe a los sistemas que le suministran datos, de modo que un prefijo asignado en el IPAM llega a la SoT sin tener que esperar a que se ejecute una tarea programada. Los mecanismos de entrega y los compromisos que implica la latencia corresponden a la federación y se explican en Federación de datos.
Los agentes de IA acceden a los mismos datos mediante interfaces orientadas a herramientas como el Model Context Protocol (MCP), que permite al agente descubrir las operaciones disponibles e invocarlas en el orden que requiera su razonamiento. Para la SoT, es una interfaz de herramientas más. Quién puede invocarla depende de dónde se ejecute el agente: si se ejecuta dentro de la NAP, accede a través de las interfaces de cada bloque descritas en el capítulo 8. Si lo hace desde fuera, accede a través del servidor MCP de la capa de Presentación descrito en el capítulo 9.
Un punto crítico: aplica la autenticación y la autorización en la propia capa de API, sin delegarlas en los sistemas posteriores. Así evitas brechas de seguridad y permites que la auditoría funcione correctamente. Encontrarás más información sobre las implicaciones de seguridad en el capítulo 13.
Estos datos de intención definen cómo funciona la red, por lo que modificarlos equivale a modificar la red (aunque el efecto llegue más tarde). Aplica el principio de mínimo privilegio como lo harías con el acceso a los dispositivos: nadie debe tener más acceso del que necesita para su función.
Aquí hay tres permisos distintos, aunque los sistemas suelen incluir el tercero en el segundo:
Quién puede leer qué datos. No todos los consumidores deberían ver todos los campos. Las credenciales, las zonas de seguridad y los centros de coste tienen públicos distintos. Este permiso hace efectivos los límites de acceso de las vistas por perfil descritas en Datos incluidos en el alcance. Más adelante, en Modelado de datos según el contexto, verás cómo definir esas vistas.
Quién puede modificar qué datos. El permiso se delimita por tipo de objeto, por atributo y, normalmente, también por sede o por inquilino. La titularidad de cada campo, descrita en Datos transaccionales, es la aplicación de esta misma regla a los datos federados.
Quién puede cambiar el esquema. Es un permiso independiente, mucho más peligroso y el que se concede por error con más frecuencia. Editar el registro de una VLAN afecta a una VLAN. Eliminar un campo obligatorio, flexibilizar una restricción o suprimir una relación afecta a todos los registros de ese tipo y a todos los consumidores que confiaban en ese contrato. Quien pueda relajar la validación puede dar entrada a datos erróneos en todas partes a la vez, sin tener que escribir personalmente un solo valor incorrecto. Trata los cambios de esquema como los cambios de código: exige un permiso específico, una revisión y un despliegue por etapas.
Acompaña los tres permisos de un registro de lo que ha ocurrido realmente. La autorización indica qué se permite, el historial de cambios descrito en Persistencia de los datos indica qué se hizo y los metadatos de linaje indican de dónde procede cada valor. Sin estos dos últimos elementos no es posible auditar la autorización.
Una vez que hayas diseñado y protegido las API, surgen dos cuestiones operativas. Ambas se tratan con más detalle más adelante en el libro.
Evolución: los flujos de trabajo de automatización siguen en uso después de que se retiren las versiones de la API para las que se escribieron. Por tanto, hay que anunciar con meses de antelación los cambios que rompen la compatibilidad. El capítulo 9 explica en detalle cómo gestionar las versiones de las interfaces y por qué la versión debe figurar en la URL.
Escala: leer y escribir los objetos de uno en uno deja de ser viable cuando te acercas a los mil dispositivos. La solución habitual son los puntos de acceso que admiten operaciones por lotes. El resto de las técnicas (paginación, filtrado, uso de caché, réplicas de lectura y limitación de la tasa de peticiones) pertenecen al diseño general de API y no son específicas del diseño de una SoT. El capítulo 12 aborda la recuperación de datos de la SoT a escala, incluido el coste de los puntos de acceso por lotes. La capa de Presentación se ocupa de la limitación de la tasa de peticiones y de los aspectos relativos a la interfaz.
Una tendencia más reciente que mejora la eficacia del consumo de datos consiste en adaptarlo a distintos contextos.
Modelado de datos según el contexto#
Cada perfil tiene necesidades distintas. Los ingenieros de redes quieren buscar y encontrar datos junto con sus relaciones, y editar campos concretos con indicaciones sobre el resultado de la validación. Los flujos de trabajo de automatización necesitan API y webhooks, y el negocio necesita informes sin detalles técnicos.
Ten en cuenta que la interfaz de usuario del bloque de Consumo de datos pertenece a la capa de Presentación.
La representación de los datos debe adaptarse al contexto de cada consumidor. Por ejemplo, no hace falta mostrar todos los detalles de un dispositivo a todos los perfiles. Personalizar las vistas según el contexto permite consumir los datos con más eficiencia y eficacia sin modificar los datos almacenados.
Si piensas en las distintas familias de datos de red que necesitas (detalles del hardware, direcciones IP, etc.), verás que cada consumidor necesita una vista distinta de esos datos. La Tabla 5.3 muestra una clasificación habitual de los contextos y los consumidores de datos sobre dispositivos.
| Consumidor y contexto | Representación de los datos | Atributos clave |
|---|---|---|
| Ingeniero de redes Resolución de problemas de conectividad | Vista centrada en la red | Interfaces, direcciones IP, vecinos BGP, rutas, VLAN, estado de los enlaces ascendentes |
| Equipo financiero Imputación de costes | Vista centrada en el negocio | Centro de coste, calendario de amortización, estado de la garantía, fecha de compra, proveedor |
| Equipo de seguridad Auditoría de cumplimiento | Vista centrada en la seguridad | Zona de cumplimiento, políticas de acceso, último análisis de seguridad, nivel de parches, vulnerabilidades pendientes de resolver |
| Flujo de trabajo de automatización Despliegue de configuración | Vista centrada en la ejecución | IP de gestión, referencia a las credenciales, plataforma del dispositivo, versión del sistema operativo |
| Catálogo de servicios Análisis del impacto en los clientes | Vista centrada en el servicio | Clientes a los que se presta servicio, servicios alojados, nivel de SLA, grupo de redundancia |
Hay varias formas de adaptar los datos al contexto. Veamos las opciones con los datos de los dispositivos como ejemplo:
Las transformaciones basadas en vistas (view-based transformations) calculan la estructura de los datos para cada petición, bajo demanda, a partir de un registro o de un conjunto filtrado de registros del mismo tipo. El servidor mantiene una única representación y le da la forma adecuada al responder. La consulta a la API indica el contexto que solicita:
GET /api/devices/router-core-01?view=network-engineer
→ Returns: {interfaces: [...], bgp_peers: [...], vlans: [...]}

GET /api/devices/router-core-01?view=finance
→ Returns: {cost_center: "...", warranty_expiry: "...", purchase_cost: ...}Las capas de proyección (projection layers) funcionan al revés. La estructura se calcula y se almacena antes de recibir la petición. Abarca muchos registros y, por lo general, varios tipos de objetos. Hay que mantenerla al día a medida que cambian los datos de origen. Un grafo de topología con todos los dispositivos y cables, un árbol de dependencias entre servicios o una matriz de cumplimiento por zona: cada uno responde a una pregunta que, de otro modo, obligaría a correlacionar miles de registros en el momento de la lectura.
Es la misma distinción que hay en una base de datos entre una vista y una vista materializada, y tiene las mismas consecuencias. Una proyección responde rápido, pero puede quedar desactualizada. Por eso necesita una regla de invalidación: puedes recalcularla con cada escritura, recalcularla a intervalos programados o aceptar un periodo conocido de desfase y darlo a conocer. Crear una proyección es, por tanto, una decisión sobre los datos. Por eso se trata aquí y no en la capa de Presentación.
Las otras dos formas de dar estructura a los datos son decisiones sobre la interfaz. Una permite que los propios consumidores elijan los campos, como ocurre con GraphQL: en su consulta, el ingeniero de redes pide las interfaces y los vecinos BGP, y el equipo de finanzas pide el centro de costes y la fecha de vencimiento de la garantía. Ambas consultas se refieren al mismo dispositivo.
La otra opción ofrece a cada grupo de usuarios un lenguaje de consulta específico de su dominio. Las interfaces basadas en Modelos de lenguaje de gran tamaño (LLM) han abaratado mucho el desarrollo de estos lenguajes. Esta opción se adapta mejor a la investigación que a la automatización, porque los flujos de trabajo se construyen sobre interfaces estructuradas. La SoT ofrece estas opciones a los bloques de la NAP. El capítulo 9 aplica las mismas opciones a los consumidores externos a la NAP.
Elijas el mecanismo que elijas, el coste es el mismo. Tienes que definir, probar y documentar cada vista, además de mantener la coherencia entre todas ellas. Los consumidores tienen que descubrir qué vistas existen antes de poder usarlas. Una proyección añade un coste más: cuando almacenas un resultado derivado de tus datos, hay un segundo elemento que puede contener errores.
La IA también ayuda en la lectura, por la misma razón que ayuda en la escritura: el modelo es extenso y nadie lo tiene entero en la cabeza. Hay dos patrones recurrentes. Las sugerencias contextuales (contextual suggestions) completan el nombre de un dispositivo a partir de los nombres que has editado en esa ubicación, o proponen parámetros de servicio a partir del tipo de servicio. Así reducen los errores al introducir datos sin complicar la validación. Los avisos de anomalías (anomaly warnings) ponen en cuestión una operación que se aparta de las anteriores. Así, si una reasignación masiva de VLAN suele afectar a diez dispositivos y esta vez va a afectar a cuatrocientos, se añade un paso de confirmación.
Ambos patrones comparten la misma base que las técnicas de escritura: un historial de operaciones y un esquema lo bastante bien modelado como para que la IA pueda razonar sobre él. La sección Aplicación del esquema y de las restricciones aborda este aspecto.
Por último, nos queda por ver cómo coordinar varios sistemas para formar un único bloque de Intención coherente.
Federación de datos#
Un hombre con un reloj sabe qué hora es. Un hombre con dos relojes nunca está seguro.
Segal’s Law
Los datos de tu red no existen en el vacío. Es muy probable que ya dispongas de parte de los datos que necesitas. Gestión de activos conoce los detalles de los dispositivos y las fechas de vencimiento de las garantías. Los sistemas IPAM son responsables de las asignaciones de direcciones IP. Los proveedores de circuitos tienen la información de conectividad. Los equipos de servicios tienen los detalles de los SLA. Si federas los datos sin asignar un único responsable a cada campo, acabas con dos relojes.
No crees otro silo de datos. Tu organización ya tiene demasiados. Si tu Fuente de Verdad no puede obtener datos de distintas fuentes, solo estás creando una hoja de cálculo 2.0 con una API. Nadie la mantendrá. Te pasarás la vida rogando a la gente que «por favor, actualice la SoT», mientras te ignoran y siguen usando sus herramientas de siempre.
La federación de datos no es opcional: incorpora los datos de los sistemas existentes, sincronízalos en el sentido que indique cada responsable y ofrece una vista unificada. La Fuente de Verdad debe ser una capa de federación, no una base de datos que sustituya a las existentes.
En este libro, «la Fuente de Verdad» da nombre a un bloque, y un bloque puede abarcar varios sistemas. Varias de sus fuentes de datos ya existen en tu organización y ya tienen responsables: el IPAM que asigna direcciones o la base de datos de activos que lleva el registro de los componentes de red. Cada una de esas fuentes es lo que el capítulo 3 llama un sistema de registro (System of Record, SoR): el sistema responsable de un dato. Esos sistemas forman parte de la Fuente de Verdad.
Lo que despliegas es una fuente de datos más dentro del mismo bloque y la única que alberga el modelo de red que las demás no pueden representar. Llamémosla la SoT central. Su segunda función es la federación: reúne todas las fuentes del bloque en una vista coherente. Así que, cuando este capítulo dice que la SoT no sustituye a tu IPAM, está delimitando las responsabilidades de cada uno.
La palabra «única» provoca buena parte de la confusión que queda. Suele interpretarse como todos los datos residen en un solo sistema. Puede ocurrir, pero es poco frecuente y no es eso lo que significa «única». La propiedad que importa es más concreta: para cada dato, uno y solo un sistema decide su valor. No se trata de tener un sistema para todo, sino una autoridad para cada dato. Otros sistemas pueden hacer referencia a ese valor, guardarlo en caché o conservar una copia, pero no pueden definirlo por su cuenta. En cuanto dos sistemas creen que les corresponde decidir la dirección de gestión de un dispositivo, tienes dos valores con la misma autoridad y ninguna regla para elegir entre ellos. Así no puedes resolver el conflicto.
Por eso conviene planificar con cuidado la federación de datos, en vez de decidir cómo hacerla cuando surge el primer problema. Al identificar a los distintos equipos, verás que cada uno suele ser responsable de fuentes de datos distintas dentro de su ámbito. Por la ley de Conway, tus datos siguen esos límites, lo hayas previsto o no. La arquitectura debe dejar claro quién tiene autoridad en cada caso y ofrece dos formas de reunir las fuentes: referenciar los datos allí donde los mantiene su responsable o consolidar una copia en la SoT central. Son, respectivamente, los modelos distribuido y centralizado de la sección Arquitectura de federación.
Cada sistema de registro tiene autoridad sobre su propio dominio: un tipo de datos o un subconjunto claramente delimitado de ese tipo. La SoT reúne los sistemas detrás de una única interfaz, de modo que las aplicaciones cliente nunca tengan que correlacionar por su cuenta los datos de cinco fuentes.
Esta es una lista general de las fuentes de datos con las que quizá necesites integrar tu sistema:
Organización:
- Sistema de recursos humanos: departamentos, equipos, funciones, matriz de responsabilidades
Infraestructura:
- Sistema de gestión de activos: detalles del hardware, números de serie, compras, garantías, historial de mantenimiento
- Plataforma en la nube: VPC, subredes, grupos de seguridad
- Proveedor de circuitos: estado del aprovisionamiento, caudal comprometido
- IPAM: asignaciones de direcciones IP, ámbitos DHCP, entradas DNS
Servicios:
- Catálogo de servicios: definiciones de los servicios, SLA, clientes
- Sistema de facturación: repercusión de costes, planificación de la capacidad
Quizá te preguntes dónde encaja la base de datos de gestión de la configuración (CMDB). A menudo se confunde con la propia SoT. La duda surge porque los nombres se solapan: una SoT es, literalmente, una base de datos de gestión de la configuración. Sin embargo, la diferencia está en el sentido en que fluye la información. La CMDB registra lo que hay en la red y se nutre en gran medida del descubrimiento y del análisis posterior. La SoT declara lo que debería haber en la red, y la red se construye a partir de lo que declara. Por eso, a mi juicio, la CMDB pertenece al bloque de Observabilidad, y allí la trataremos.
Cuando varios sistemas se coordinan, tienes que ocuparte de la resolución de conflictos. Por ejemplo:
- Según el sistema IPAM centralizado, el prefijo 192.0.2.0/24 está asignado al cliente X
- Según el catálogo de servicios, el prefijo 192.0.2.0/24 está asignado al servicio A, que pertenece al cliente Y
¿Quién tiene razón? Depende de la designación de la autoridad: una decisión de gobernanza que establece a qué sistema le corresponde determinar ese valor. Sin esa designación, la pregunta no tiene respuesta, solo hay opiniones.
Esa designación cumple dos funciones que conviene distinguir. Primero, se hace cumplir en el punto de escritura: si una tarea de sincronización del catálogo de servicios intenta establecer un prefijo, el sistema la rechaza porque el catálogo no es responsable de los prefijos. Segundo, queda documentada en el propio registro mediante los metadatos de linaje de los datos, de modo que cualquiera que lo consulte después pueda ver de qué fuente procede el valor. La primera función impide que el conflicto llegue a los datos. La segunda permite explicar el valor meses después. Si solo implementas la segunda, tendrás constancia de un problema que podrías haber evitado.
Por ejemplo, una estrategia que asigne responsabilidades por dominio de recursos podría establecer lo siguiente:
- El IPAM centralizado es el sistema de registro de las asignaciones de direcciones IP, los tamaños de las subredes y los ámbitos DHCP.
- El sistema de gestión de activos es el sistema de registro de los metadatos de los activos, su ubicación y su modelo de hardware.
- La SoT central es el sistema de registro de las interfaces y su estado administrativo, las VLAN, la correspondencia entre VLAN y subredes, y los diseños.
Fíjate en dónde queda el límite en esa última línea. El estado administrativo es aquel en el que debe estar una interfaz. Por tanto, expresa intención y su sitio está junto al resto de la intención. El estado operativo es el que comunica la red en la práctica y corresponde a Observabilidad, a menudo en forma de una CMDB.
Entre las estrategias de resolución de conflictos se encuentran las siguientes:
- Autoridad de la fuente (Source Authority, la más habitual): una decisión de gobernanza designa el sistema que tiene autoridad sobre un dato. Por ejemplo, el sistema de gestión de activos tiene autoridad sobre el modelo de hardware y el número de serie de un dispositivo.
- Resolución por marca de tiempo (Timestamp-based): usa la marca de tiempo de la última modificación. Prevalece el cambio más reciente. El riesgo es que no distingue entre una corrección y un error.
- Resolución contextual (Contextual resolution): evalúa el contexto y aplica una regla de precedencia que hayas definido de antemano.
- Escalado manual (Manual escalation): si ninguna de las reglas anteriores resuelve el conflicto, remítelo a una persona para que lo revise.
Arquitectura de federación#
Hay dos formas de federar los datos. La Figura 5.4 las muestra una junto a la otra.
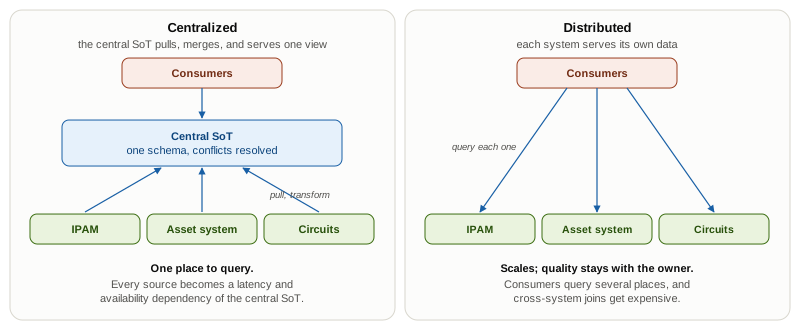
En el modelo centralizado, la SoT obtiene datos de cada fuente, los transforma para ajustarlos a un único esquema, resuelve los conflictos y ofrece una sola vista. Resulta fácil consultarla, pero tanto la latencia como la disponibilidad pasan a depender de cada fuente. En el modelo distribuido, cada sistema conserva y sirve sus propios datos, y la SoT central es uno más. Este modelo escala mejor y deja la calidad de los datos en manos del dominio responsable, pero los consumidores tienen que consultar varias fuentes y resulta costoso cruzar datos entre sistemas. La mayoría de los despliegues reales se sitúan entre ambos modelos. El capítulo 12 trata la elección entre centralización y federación como una decisión de escalado por derecho propio.
Además de resolver conflictos, el reto principal de la federación consiste en mantener la coherencia de los datos entre sistemas. La arquitectura que hayas elegido determina qué mecanismo de sincronización de la Tabla 5.4 encaja mejor:
| Mecanismo | Cómo fluyen los datos | Ventajas e inconvenientes |
|---|---|---|
| Sincronización periódica (consulta programada) | Cada 6 horas, la SoT lee los datos del IPAM, compara el resultado con su caché local, aplica las diferencias y publica sus propios cambios de vuelta en el IPAM. | De minutos a horas. Es sencilla, predecible y barata de ejecutar, pero los datos pueden permanecer incoherentes durante horas y es fácil que surjan conflictos al procesar los cambios por lotes |
| Sincronización por eventos (bus de mensajes) | El IPAM modifica la subred 10.0.0.0/24 y publica un evento «Subnet:Changed» en el bus. La SoT consume el evento y actualiza su caché. | Segundos. Responde con rapidez, casi en tiempo real, a costa de una coreografía de eventos compleja de diseñar y aún más difícil de depurar |
| Webhooks (envío directo) | La SoT registra un webhook en el IPAM. Cuando el IPAM asigna 10.0.2.5/32, envía el cambio a ese webhook y la SoT lo valida y lo almacena. | De menos de un segundo a varios segundos. El envío es directo y no tienes que gestionar un bus de mensajes, pero la fuente debe admitir webhooks y la fiabilidad de la red pasa a ser responsabilidad tuya |
No existe ningún sistema de sincronización en tiempo real. En el mejor de los casos, los datos acaban siendo coherentes. Cuánto tardan en serlo es algo que debes evaluar para cada caso de uso. Acéptalo y tenlo en cuenta en el diseño.
Una federación eficaz requiere un gobierno de los datos bien definido, con una decisión explícita y documentada para cada dominio de datos.
Los límites de autoridad no tienen por qué coincidir con los de un dominio entero. Una matriz de gobierno suele definir la autoridad por dominio porque es el caso más habitual, pero tú eliges el nivel de detalle, y una división más fina suele ser más precisa. Un IPAM puede tener autoridad sobre los prefijos mientras otro sistema se encarga de las asignaciones de direcciones individuales. La autoridad se puede repartir por rango de direcciones, por inquilino, por sede o por etapa del ciclo de vida: el IPAM controla el conjunto de direcciones libres y la SoT controla las asignaciones estáticas que ha hecho ella misma. Cualquiera de estas opciones es válida. La única regla es que, para cada dato, quede claro quién tiene la autoridad y que alguien pueda decirlo sin ambigüedades.
Cuando nadie sabe decirlo, la conclusión es: «En cierto modo, los dos sistemas se encargan de ese dato». Esa es la situación que intentas eliminar. Rellenar una matriz de gobierno te permite detectar dónde sigue ocurriendo: dedica una fila a cada tipo de dato e indica qué sistema tiene la autoridad, cómo y con qué frecuencia se sincroniza el dato y qué valor prevalece en caso de conflicto. En el ejemplo del campus, al final de este capítulo, rellenamos una de estas matrices (Tabla 5.5).
La federación se apoya en los metadatos de linaje de los datos para determinar, en cada caso, quién decide el valor y hasta qué punto está actualizada la copia. Para cada elemento de datos, estos metadatos de autoridad deben recoger:
- Sistema de origen: ¿de dónde procede el dato?
- Hora de la última sincronización: ¿cuándo se verificó?
- Método de actualización: ¿consulta periódica, envío desde el origen o webhook?
- Nivel de autoridad: ¿qué grado de confianza merece el dato?
Con estos metadatos, el sistema puede tomar decisiones fundamentadas sobre cómo gestionar los datos. Esos cuatro puntos son los requisitos. El bloque _metadata es una forma de representarlos: owner y source indican conjuntamente quién tiene la autoridad, y el mecanismo de sincronización se define en la integración, no en cada registro. La persistencia almacena ese bloque y la federación es lo que lo hace necesario.
Y cuando dependas de varios sistemas, prepárate para los fallos. Los sistemas externos sufrirán caídas. Cuando una fuente federada deja de estar disponible (por ejemplo, si el IPAM se cae durante 30 minutos), hay varias estrategias posibles. Elige con qué inconveniente prefieres lidiar:
- Bloquear las operaciones: «No se pueden asignar direcciones IP sin el IPAM».
- Usar los datos de la caché + marcarlos como desactualizados: «Se están usando datos del IPAM almacenados en caché hace 2 horas. Puede que ya no sean coherentes».
- Degradación controlada: «Se pueden seguir aprovisionando dispositivos, omitir la asignación de direcciones IP y dejarla en cola hasta que se recupere el IPAM».
La federación aporta todo lo descrito, pero nada de ello sale gratis, y quienes asumen los costes no suelen ser quienes obtienen los beneficios.
- Cada integración es un componente que puede fallar. Los webhooks fallan sin avisar, las API cambian de versión y hay que monitorizar el estado de cada conexión por separado.
- Los atributos que se solapan necesitan reglas de autoridad explícitas. Si nadie deja por escrito quién decide sobre un atributo, la duda resurge más tarde en forma de conflicto, normalmente durante un incidente.
- La fiabilidad de una respuesta que abarca varios dominios depende de su fuente menos fiable. Una base de datos de activos desactualizada falsea los resultados de todas las consultas que la utilizan, y nada en la consulta te avisa de que ha ocurrido.
- El linaje y el historial de cambios crecen sin límite. Necesitan una política de retención propia. Defínela antes de que la factura de almacenamiento decida por ti.
Una vez vistas las funcionalidades, vamos a examinar algunas situaciones que muy probablemente te encontrarás y para las que conviene estar preparado.
Consideraciones prácticas#
Las funcionalidades anteriores describen cómo funciona una SoT una vez que contiene datos y el equipo confía en ella. Que siga siendo así depende de dos cuestiones operativas: cómo mantienes la exactitud de los datos con el tiempo y qué deja de funcionar cuando la SoT no está disponible. Ninguna de las dos encaja del todo en una sola funcionalidad, y resolver ambas es un requisito previo para operar el bloque de Intención. La tercera cuestión, cómo cargar los datos por primera vez, se aborda en la incorporación de un entorno brownfield en el capítulo 4.
Ciclo de vida de los datos y conciliación#
Los datos se quedan desactualizados. Se retira un switch sin eliminarlo de la SoT. Alguien reasigna a mano una dirección IP durante un incidente. Un contratista añade una VLAN a un puerto troncal durante una intervención de emergencia. Tres meses después, nadie se acuerda y la SoT refleja un estado que dejó de corresponderse con la red hace semanas.
La estructura de datos valida los datos al introducirlos, pero eso no basta. Un registro que era correcto cuando se creó puede dejar de serlo sencillamente porque ha cambiado la realidad que describe. Sin un proceso continuo de conciliación, la SoT pierde credibilidad poco a poco. Y cuando esto ocurre, los equipos dejan de confiar en ella, empiezan a buscar alternativas y la automatización de redes empieza a morir.
Aunque pienses que en tu red todos los cambios pasarán siempre por la automatización, te puedo asegurar que la realidad es otra. Habrá desviaciones, así que prepárate para conciliarlas y mantener tu Intención al día.
El patrón de conciliación (reconciliation pattern) consiste en comparar periódicamente el estado real de la red con la SoT y clasificar cada discrepancia. Hay dos clases:
- Divergencia: el dispositivo y la SoT discrepan sobre algo que existe en ambos. Una IP que la SoT asigna al dispositivo A responde en el dispositivo B porque alguien la reasignó a mano durante un incidente. Una VLAN desplegada en un conjunto concreto de switches se ha extendido a otros dos enlaces troncales mientras se diagnosticaba un problema. Detectar cualquiera de estas discrepancias es una tarea mecánica. Interpretarla exige criterio: puede que la SoT sea correcta y la red se haya desviado, o que el cambio haya sido deliberado y correcto y la SoT se haya quedado desactualizada. La comparación por sí sola no te dice cuál de las dos cosas ha ocurrido.
- Registro huérfano: la SoT contiene un objeto (un dispositivo, un prefijo o una VLAN) que representa algo que ya no existe en la red. El registro de un dispositivo aún conserva una IP de gestión, pero hace meses que se retiró el equipo del bastidor. Una operación automatizada dirigida a esa dirección fallará por completo o, peor aún, llegará al equipo que se haya desplegado en su lugar.
Cada clase requiere un tratamiento distinto, y la divergencia es la que exige más reflexión. Decidir qué parte tiene razón exige criterio y es el único paso de la conciliación que no se puede automatizar por completo. Si la SoT tiene la autoridad y el cambio fue involuntario, el bloque de Observabilidad alerta de la desviación y la automatización puede corregir el dispositivo dentro de unos límites definidos. Si el cambio fue deliberado, alguien tiene que responder a otra pregunta: ¿fue una corrección de emergencia que ahora debe formalizarse en la intención o un cambio no autorizado que debe revertirse?
Una política puede resolver de antemano los casos sencillos por clase de atributo o por sede, pero siempre quedarán algunos que requieran la intervención de una persona. Los registros huérfanos son más sencillos, aunque tampoco conviene eliminarlos automáticamente: señala el registro que se propone eliminar y deja que alguien confirme que lo que representa ya no existe.
Fíjate en qué comprueba realmente la conciliación. La SoT y el IPAM pueden coincidir por completo y, aun así, estar ambos equivocados. La coherencia interna entre tus sistemas no te dice si alguno de ellos refleja la realidad de la red. Solo puedes saberlo si comparas sus datos con la red en funcionamiento. Por eso, la conciliación tiene que leer los datos de los dispositivos, sin limitarse a cotejar una base de datos con otra.
La incorporación de un entorno brownfield es una migración que se realiza una sola vez. La conciliación es el proceso operativo que mantiene la credibilidad de la SoT después de la puesta en producción. Los equipos que se saltan la conciliación verán cómo, en cuestión de meses, se deteriora la confianza en la SoT y la automatización que se apoya en ella empieza a dar resultados incorrectos sin que nadie se dé cuenta.
La conciliación es también el primer bucle cerrado de este libro: observa el estado de la red, compáralo con la intención, decide y actúa. En el capítulo 16 construimos ese bucle de principio a fin, incluida la política que define qué desviaciones puede corregir por sí solo.
La SoT como dependencia en cada paso#
Hay una diferencia estructural entre usar la SoT como referencia y consultarla una sola vez al inicio de un flujo de trabajo, y depender de ella en cada paso, consultándola cada vez y confiando en que esté al día. Ambos patrones son válidos. Decide desde el principio cuál vas a implementar.
El segundo patrón convierte la vigencia de los datos y la disponibilidad de la SoT en requisitos operativos que el primero no exige. Un flujo de trabajo que actúa sobre cientos de dispositivos a partir de una única lectura de una instantánea utilizará datos desactualizados si entretanto cambia algo en la red. Y si toda la automatización depende de una SoT cuyo diseño no contempla la alta disponibilidad, esa SoT constituye un punto único de fallo para toda la NAP. El capítulo 12 aborda el intervalo durante el que los datos pueden quedar desactualizados, cómo gestionarlo y qué diseño de disponibilidad se deriva de ello.
Cualquier Fuente de Verdad tiene que poder afrontar estas situaciones, sea cual sea el producto en el que se apoye. A continuación veremos los productos, que importan menos de lo que quizá esperes.
Panorama de soluciones#
Hay muchos productos que cubren todo el bloque de Intención o parte de él. Algunos son de código abierto y otros son comerciales. Los hay de propósito general y también especializados en un único dominio, como la gestión de direcciones IP.
Este panorama refleja la situación a finales de 2026. Como cambia constantemente, comprueba siempre qué ofrece cada solución en ese momento y a qué ritmo evoluciona antes de elegir. Tampoco pretende ser exhaustivo: sirve de referencia general.
Soluciones de código abierto
- NetBox: IPAM, DCIM, circuitos, dispositivos, virtualización e inventario. Es la más popular de estas soluciones y la que cuenta con el mayor ecosistema de complementos.
- Nautobot: IPAM, DCIM, circuitos, dispositivos e inventario. Esta bifurcación de NetBox añade un marco de ejecución de tareas que permite ejecutar los flujos de trabajo de automatización dentro de la propia SoT.
- Infrahub: topología de red, dispositivos, IPAM, esquemas y relaciones. Tanto la gestión de ramas al estilo de Git como la revisión del estado propuesto forman parte del núcleo del producto, sin necesidad de complementos.
- phpIPAM: direcciones IP, subredes y VLAN. Un IPAM sencillo sobre una pila LAMP, sin las funciones de DCIM de las demás soluciones.
Detrás de la mayoría de estas soluciones hay una empresa que también vende una versión comercial y servicios de soporte. phpIPAM es la excepción: lo mantiene la comunidad.
Soluciones comerciales
- ServiceNow: elementos de configuración, servicios, activos y cambios. Es la base de datos de propósito general de la que ya dispone la mayoría de las organizaciones, con flujos de trabajo de cambio alineados con ITIL.
- Device42: activos de centros de datos, dependencias, mapeo de aplicaciones e IPAM. Se basa en el descubrimiento automático sin agentes, lo que agiliza la incorporación de una infraestructura brownfield.
- Infoblox: DNS, DHCP e IPAM. El sistema que ejerce la autoridad sobre DNS, DHCP e IPAM en la empresa, con replicación entre varias sedes.
- SolarWinds IPAM: direcciones IP, DHCP y DNS. Merece la pena considerarlo sobre todo si ya utilizas el conjunto de herramientas de monitorización de SolarWinds con el que se integra.
Al evaluar soluciones de Fuente de Verdad, ten en cuenta estos factores para determinar cuál encaja con tus necesidades:
- Requisitos de escala: número de dispositivos (cientos o cientos de miles), frecuencia de los cambios y volumen de consultas
- Necesidades del modelo de datos: estructura basada en Git, estructura relacional, relaciones en forma de grafo o almacén documental flexible
- Ecosistema de integración: herramientas existentes (de monitorización, de ITSM o plataformas en la nube) que deben federar sus datos
- Experiencia del equipo: familiaridad con Python/Django, preferencia por plataformas de desarrollo con poco código y soltura con los flujos de trabajo de Git
- Modelo operativo: alojamiento propio o SaaS, procesos de aprobación de cambios y requisitos de Control de acceso basado en roles (RBAC)
- Evolución prevista: vía de migración desde un entorno brownfield, extensibilidad del esquema y estabilidad de la API
- Coste de salida: ¿puedes exportar los datos, el esquema y el historial de cambios en un formato que otro sistema pueda importar? Las relaciones y el linaje son lo que peor exportan los productos y lo que más cuesta reconstruir
Más importante que el producto que elijas es que puedas responder, para tu propia red, a las preguntas que hemos planteado a lo largo de estos dos capítulos. ¿Qué datos entran en el alcance y qué hace que un valor sea válido? ¿Dónde se guardan esos datos y cómo se conservan cuando hay cambios? ¿Quién accede a ellos, cómo lo hace y qué sistema decide cada valor? Ninguna herramienta responde a esas preguntas por ti. Solo te permite llevar tus respuestas a la práctica a menor coste. Por eso, en el resto del capítulo tomamos una red concreta y respondemos a esas preguntas de principio a fin.
Ejemplo de implementación#
Seguimos con la red de campus del capítulo 4: unos 800 switches de tres fabricantes repartidos entre seis edificios, de la A a la F. En el capítulo 4 cargamos los datos iniciales en una única SoT mediante una importación puntual, lo que nos permitió centrarnos en el modelo de datos. La realidad del campus no es tan ordenada. Dos sistemas ya tienen autoridad sobre parte de los datos, así que el conjunto consta de cuatro piezas:
- El IPAM, que es la fuente de referencia para la asignación de direcciones, los prefijos y el DNS.
- La base de datos de activos, que es la fuente de referencia para la ubicación de los switches, los modelos de hardware y el historial de mantenimiento.
- Los propios switches, que conservan el único registro de lo que está realmente desplegado.
- La SoT central, que federa las dos primeras fuentes y aporta el modelo de red del que carecen todas ellas.
El problema. En el capítulo 4 seguimos una solicitud habitual a través de los datos: una nueva VLAN llamada app-payments en el edificio B. A partir de tres campos de la capa de servicio se obtuvieron los objetos técnicos que el Ejecutor utiliza para generar la configuración. Ya tenemos los datos modelados, pero aún no hay dónde guardarlos. Retoma aquí la misma solicitud, en el punto en que hay que almacenar el registro, ponerlo a disposición de quien lo necesite y dejar constancia de su autoría.
Requisitos:
- Almacenar el registro de modo que dos ingenieros que modifiquen el mismo servicio no puedan corromperlo
- Conservar el historial completo y poder decir, meses después, quién cambió qué, cuándo y por qué
- Proporcionar a cada consumidor los datos en la forma que necesita, a partir de un único registro
- Federar el IPAM y la base de datos de activos en lugar de sustituirlos: conservar copias identificadas como tales donde hagan falta y designar un único responsable por tipo de dato
- Seguir funcionando cuando el despliegue depende directamente de la SoT: si no se puede acceder a ella, el despliegue debe fallar de forma segura
- Revertir los datos sin revertir los cambios en la red y saber distinguir ambas operaciones
Las funcionalidades en la práctica#
Persistencia de datos: el registro, su historial y su linaje
El objeto, una vez confirmada la escritura, contiene algo más que la intención:
- name: app-payments
  vlan_id: 412
  # ... intent fields omitted ...
  _version: 1
  _metadata:
    owner: "network-eng@example.net"
    source: null
    created: "2026-03-14T09:21:04Z"
    created_by: "svc-design-expander"
change_request: "REQ-4471"_version: 1 es lo que hace posible el control de concurrencia optimista: el siguiente proceso que escribe envía la versión que leyó. Si el registro ha cambiado desde entonces, se rechaza la escritura para evitar que sobrescriba sin aviso los cambios de otra persona. source: null indica que la SoT central creó el registro. Una vez que la capa de servicio se encarga de la expansión, lo normal es que created_by identifique una cuenta de servicio en lugar de una persona. Por eso hay que conservar la información de procedencia incluso cuando el autor es una máquina.
Consumo de datos: cómo entran y salen los datos
La solicitud tiene que entrar en el sistema por algún sitio. Un operador rellena un formulario o un cliente envía una petición POST en su nombre. En ambos casos, esa interfaz de usuario corresponde a la capa de Presentación (capítulo 9). Lo que llega a la SoT es una simple operación de escritura a través de su propia interfaz:
POST /api/vlan-services HTTP/1.1
Content-Type: application/json

{ "name": "app-payments", "building": "B", "profile": "standard" }

201 Created
Location: /api/vlan-services/9c2f1b74Fíjate en que la operación de escritura recibe los tres campos de la capa de servicio, no el registro expandido. Como la expansión tiene lugar dentro de la SoT, las salvaguardas se aplican a todos los que llaman a la interfaz, incluso a quienes no toman precauciones por su cuenta.
Ningún componente consulta periódicamente si ya existe ese identificador. Cuando se confirma la escritura del registro, la SoT emite un evento de cambio que incluye el identificador. El Orquestador está suscrito a esos eventos. Es la vía de suscripción a cambios descrita en Consumo de datos: la SoT anuncia que 9c2f1b74 existe y está listo para el despliegue. El Orquestador programa el trabajo y, a continuación, el Ejecutor lee solo lo que necesita:
GET /api/vlan-services/9c2f1b74?view=executor HTTP/1.1

{
  "schema_version": "2.1",
  "vlan_id": 412,
  "name": "app-payments",
  "gateway": { "address": "10.12.4.1", "mask": 24 },
  "qos_class": "af21",
  "mtu": 9216,
  "switches": [
    { "name": "sw-b-dst-01", "role": "distribution", "platform": "vendor-b" }
  ]
}El parámetro view=executor adapta los datos al perfil del consumidor, como vimos antes: el Ejecutor no necesita ni el centro de costes ni la solicitud de cambio, así que no los recibe. Sí recibe la clase de calidad de servicio (QoS) y la MTU, porque la plantilla del proveedor B incorpora ambas a la configuración. Por su parte, schema_version indica a cada adaptador qué contrato sigue el registro.
Federación de datos: las partes que no son responsabilidad de la SoT central
El prefijo no procede de aquí. El IPAM del campus es el responsable del espacio de direcciones, así que la SoT central le pidió un prefijo y conserva una copia, claramente identificada como tal:
prefix:
  value: 10.12.4.0/24
  _metadata:
    owner: null
    source: "campus-ipam"
last_synced: "2026-03-14T09:21:03Z"La Tabla 5.5 indica, en un solo sitio, quién decide cada valor en este campus. Cuando hay que cambiar un prefijo, solo hay un lugar donde hacerlo, y source indica cuál es a cualquiera que consulte el registro.
Este es el recorrido completo por la Fuente de Verdad: entran tres campos, se valida y se versiona el registro y sale una vista adaptada a cada consumidor. Cada valor se puede rastrear hasta el sistema que tiene autoridad para decidirlo. Generar a partir de ese registro la configuración de cada dispositivo mediante plantillas es tarea del Ejecutor (capítulo 6).
El camino de vuelta. La regla de cortafuegos del ejemplo inicial siguió vigente después de la retirada de su servicio porque nada los vinculaba. Para retirar app-payments se recorre el mismo camino en sentido inverso. El solicitante elimina el servicio en la capa de servicio mediante el mismo registro de tres campos con el que lo creó. La SoT encuentra todos los objetos que produjo la expansión porque en el linaje de cada uno consta el servicio al que pertenece: la VLAN, el prefijo, la puerta de enlace y los switches en los que se aplicó el servicio. En vez de eliminar esos objetos, los marca como en proceso de retirada, de modo que la retirada se revisa como cualquier otro cambio.
A continuación, el Orquestador encarga la retirada al Ejecutor. En un sistema que solo admite la fusión de configuraciones, eso implica enviar no vlan 412, el caso que requiere conocer el estado previo descrito en el capítulo 6. Una vez que los dispositivos confirman el cambio, la SoT pide al IPAM que libere el prefijo y devuelve la VLAN 412 al conjunto de VLAN disponibles del edificio. Observabilidad deja de esperar datos de los elementos que monitorizaba para ese servicio. Cualquier resto de la configuración que conserve un dispositivo aparecerá como discrepancia en la siguiente conciliación. Así, seis meses después, nadie tendrá que preguntarse qué hace ahí esa regla de cortafuegos.
En el ejemplo hemos seguido una solicitud a través de los datos. Si amplías la perspectiva, verás cómo encajan los componentes en la Figura 5.5:
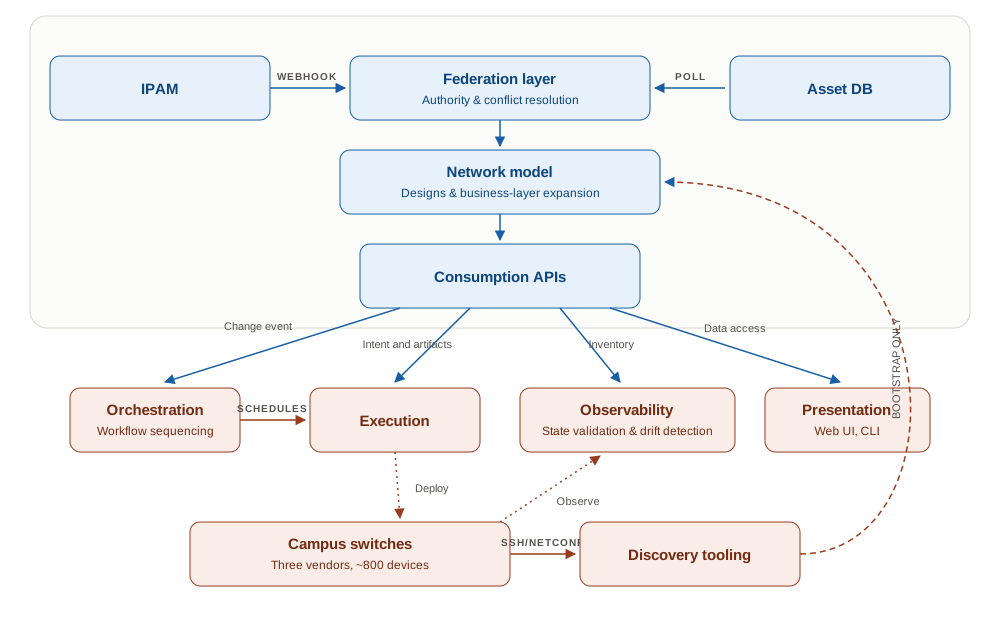
Responsabilidad sobre los datos y conflictos#
La idea fundamental es que una SoT centralizada se suma al IPAM y a la base de datos de activos sin sustituirlos. Los tres sistemas son fuentes de datos dentro de la Fuente de Verdad del campus, y la SoT central federa los otros dos. Resuelve los conflictos entre ambos, aporta el modelo de red del que ambos carecen y se convierte en la única interfaz que consultan Ejecución, Observabilidad y Presentación. Cada equipo conserva el ámbito que ya conoce.
Para que todo esto funcione, primero hay que dejar claro quién tiene autoridad sobre cada dato. En este campus basta la Tabla 5.5 para recogerlo:
| Datos | Fuente con autoridad | Sentido y frecuencia de la sincronización | En caso de conflicto |
|---|---|---|---|
| Prefijos, direcciones, DNS | El IPAM | Del IPAM → a la SoT mediante un webhook, en cuestión de segundos tras un cambio; de la SoT → al IPAM cuando cambia alguna de las asignaciones que realiza la SoT | Prevalece el IPAM para el conjunto de direcciones libres y la SoT para las asignaciones estáticas que haya realizado |
| Metadatos de activos, ubicación, modelo de hardware | La base de datos de activos | De la base de datos de activos → a la SoT mediante una consulta programada cada 4 horas; datos de solo lectura en la SoT | Prevalece la base de datos de activos |
| VLAN, diseños, solicitudes de servicio | La SoT central | Se crean en la SoT y se envían a los consumidores cuando hay cambios | No procede |
| Estado observado de los dispositivos | Los dispositivos | De los dispositivos → a la SoT mediante descubrimiento, solo durante la puesta en marcha inicial | Nunca sobrescribe la intención |
Dos filas de esa tabla explican buena parte del diseño. Las direcciones llegan mediante un webhook porque una asignación es urgente y una vista del espacio libre de hace cuatro horas da lugar a asignaciones duplicadas. Los metadatos de los activos se consultan periódicamente porque a nadie le perjudica que la fecha de una garantía lleve cuatro horas sin actualizarse. Elige el mecanismo en función del coste de equivocarte, no simplemente de lo que admita la fuente.
Dejar clara la autoridad de cada fuente también permite responder preguntas que ninguno de los tres sistemas podría resolver por separado porque abarcan varios ámbitos. ¿Qué dispositivos de un edificio de alta seguridad tienen la garantía caducada? La consulta combina los datos de la base de datos de activos con el modelo propio de la SoT central, que describe qué contiene un edificio de alta seguridad. Solo se puede responder porque ambos se consultan a través de una misma interfaz y conservan la información sobre su procedencia.
La otra pieza fundamental es el descubrimiento de datos en un entorno brownfield, que se realiza solo durante la puesta en marcha inicial, siguiendo la secuencia descrita en Incorporación de un entorno brownfield. La primera pasada sacará a la luz conflictos: un dispositivo que responde en una dirección que el IPAM ha asignado a otro, o una VLAN que aparece en enlaces troncales sin que nadie haya registrado su presencia. Son las personas quienes resuelven esos conflictos una sola vez, con una regla explícita como fíate del dispositivo para los puertos de acceso y del IPAM para las direcciones de infraestructura. Después se invierte el sentido del flujo. Saltarse esa inversión es la forma más habitual de que una SoT vuelva a ser un mero informe.
Fíjate en que, en la figura, el descubrimiento alimenta directamente el modelo de red, sin pasar por la capa de federación. Es deliberado. La federación sirve para arbitrar entre sistemas que siguen siendo responsables de sus datos. El descubrimiento, en cambio, produce una instantánea única de la que nadie se responsabiliza después. Hacerla pasar por la federación daría a los dispositivos autoridad permanente sobre la intención, precisamente lo que se evita al invertir el sentido del flujo.
Cuando una fuente deja de estar disponible
Con la federación, tu disponibilidad depende en parte de la de otros sistemas. Decide cómo debe funcionar el tuyo en modo degradado antes de que haga falta. En este campus:
- La SoT sigue ofreciendo la última copia conocida de los datos del IPAM e indica su antigüedad.
- Los operadores ven la antigüedad de los datos sin tener que consultarla: «Los datos de direcciones son de hace 2 horas, no se puede acceder al IPAM y se aplazan las nuevas asignaciones».
- Las solicitudes que necesitan una asignación nueva quedan en cola para evitar asignaciones a ciegas y se procesan cuando el IPAM vuelve a estar disponible.
- Todo lo que no necesita una dirección nueva sigue adelante: incorporar un switch, editar un diseño o generar una configuración a partir de una plantilla con los datos ya disponibles.
Ese último punto merece especial atención al diseñar la federación. Si la federación se detiene por completo cada vez que falla una fuente, la disponibilidad de varios sistemas pasa a depender de un único punto de fallo compartido, justo lo que se pretendía evitar.
Otros campus adoptarán otras arquitecturas, y es razonable. El diagrama no se podrá trasladar tal cual. La secuencia en la que se basa, sí: identifica los datos y a su responsable, elige un mecanismo de sincronización acorde con el coste de trabajar con datos desactualizados y decide de antemano qué ocurrirá cuando una fuente que no controlas deje de responder.
Primeros pasos#
El capítulo 4 cubrió los tres primeros pasos, centrados en los datos: elegir los objetos que necesitas, modelarlos sin partir de una página en blanco y decidir qué nivel de abstracción debe ofrecer el punto de entrada. A estos se suman los tres pasos de este capítulo.
Define cómo se accede a los datos y quién puede modificarlos. Determina qué sistemas leen, cuáles escriben y a través de qué interfaz lo hacen. Después, aborda los permisos: quién puede editar los datos y, por separado, quién puede editar el esquema. Resolverlo sobre el papel lleva menos tiempo que averiguarlo a raíz de un incidente.
Designa un responsable para cada elemento y federa el resto. Enumera los sistemas que ya contienen datos de referencia y anota cuál prevalece para cada tipo de dato. Si una fuente resulta ser una hoja de cálculo que nadie mantiene, retírala ahora en vez de integrarla. Hacerlo al principio cuesta poco.
Y luego úsala de verdad. Aquí comprobarás si los cinco pasos anteriores han servido de algo. Una SoT de la que nada depende acaba convertida en una página de documentación que poco a poco se queda desactualizada. Elige una operación real y haz que su configuración proceda de la SoT, aunque todavía no exista el Ejecutor y alguien tenga que generarla a partir de una plantilla con un script y pegar el resultado a mano. Para que los datos sigan siendo fieles a la realidad, algo tiene que depender de ellos.
Estos seis pasos te llevan de un modelo vacío a una SoT de la que dependen operaciones reales. Veamos qué aportan los dos capítulos en conjunto.
Resumen#
Junto con el capítulo 4, este capítulo presenta tres nuevas funcionalidades del bloque de Intención.
La persistencia de datos protege los datos de intención durante las operaciones concurrentes, registra los cambios, permite revertirlos y conserva los metadatos de linaje necesarios para rastrear los datos. Hay distintas tecnologías y opciones, cada una con sus ventajas e inconvenientes. A continuación, el consumo de datos ofrece a las personas y a los agentes los medios para integrarse con la SoT. Por último, la federación de datos permite integrar varias fuentes, cada una con autoridad sobre una parte de los datos de Intención, para ofrecer una vista coherente de toda la Intención como si procediera de una sola fuente.
Los datos de Intención que proporciona la Fuente de Verdad son el punto de partida de la automatización de redes. Guían a todos los demás bloques, como el Ejecutor del capítulo 6, que toma esa intención y la convierte en acciones. El Ejecutor lee la Intención y modifica la infraestructura de red casi a ciegas. Por su parte, Observabilidad comparará el estado real de la configuración con el previsto y señalará las desviaciones para que se concilien.
Por eso es tan importante cuidar los datos de Intención. Como dije en el capítulo 4, la calidad de tu automatización dependerá de la calidad de tus datos. Mantenerlos disponibles y en buen estado se convierte en un requisito para la disponibilidad de la NAP en su conjunto.
Referencias#
- Designing Data-Intensive Applications, Martin Kleppmann (O’Reilly, 2017). Compromisos de diseño en materia de consistencia, replicación y modelado de datos.
- Enterprise Integration Patterns, Gregor Hohpe y Bobby Woolf (Addison-Wesley, 2003). Patrones de integración y agregación de datos para federar varias fuentes de referencia en una SoT coherente.
- Master Data Management, David Loshin (Morgan Kaufmann, 2008). Gobernanza federada, responsabilidad sobre los datos y diseño de fuentes de referencia.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo