Intención de red#
Llegó una solicitud de servicio para un inquilino: una nueva VLAN en 60 switches repartidos entre dos edificios. El ingeniero rellenó el ticket a mano: identificador de VLAN 4192, puerta de enlace 10.2.30.283. Con tu buen ojo, seguro que ya has detectado las dos erratas: el identificador de VLAN era 4092 y la puerta de enlace era 10.2.30.238.
Los dos errores entraron en el sistema porque el formulario del ticket admitía texto libre. Del ticket pasaron a una hoja de cálculo, y una hoja de cálculo no tiene ni idea de qué es un identificador de VLAN (ni una dirección IP). Al siguiente ingeniero que revisó la solicitud se le escaparon los errores: parecía una solicitud como cualquier otra y, a primera vista, una cifra fuera de sitio no llama la atención. La plantilla generó la configuración y dejó pasar los errores. Se limitó a sustituir el texto sin evaluar su contenido.
Cuando se abrió la ventana de mantenimiento a las 02:00, todos los switches rechazaron la primera línea de la configuración (cada uno con su propio mensaje, según la lógica de validación del fabricante). No se desplegó nada, y esa resultó ser la mejor noticia de la noche, porque al menos no se rompió nada. Aun así, el ingeniero pasó casi una hora leyendo los distintos mensajes de error hasta dar con su origen en el formulario. Allí corrigió las dos cifras y volvió a ejecutar el proceso. Al final, la red quedó actualizada una hora y media después.
Dos medidas habrían evitado el problema aquella noche. En este capítulo veremos ambas. La primera es estructurar y validar los datos: un identificador de VLAN es un número entero entre 1 y 4094, una dirección IP es una dirección IP y hay estándares que documentan ambos tipos de datos. Si los datos incumplen las reglas (el contrato), no se pueden guardar. La segunda es reducir al mínimo los datos que se piden al principio y codificar en la Intención la lógica que permite obtener el resto a partir de ellos.
Todo sistema de automatización parte de una pregunta: ¿Qué voy a hacer exactamente? Tanto si despliegas una regla de cortafuegos como si añades una dirección Internet Protocol (IP) o configuras una VLAN, deberías hacerlo de acuerdo con una intención. El sistema que contiene esa intención es la Fuente de Verdad: la representación fiable de cómo debe ser tu red.
La intención son los datos. La Fuente de Verdad es el sistema que los almacena y los pone a disposición de quien los necesita. Este capítulo trata de los datos: qué contiene la intención y cómo comprobar que es correcta. El capítulo 5 trata del sistema que almacena esos datos, los pone a disposición de otros y determina cómo combinar varias fuentes de datos de forma coherente.
Sin una Fuente de Verdad fiable, las operaciones de red dependen de conocimientos dispersos que solo manejan quienes trabajan en ella. Los ingenieros no se ponen de acuerdo sobre qué está desplegado. Las hojas de cálculo contradicen lo que está en funcionamiento. El resultado es un sistema de automatización que no sabe qué hacer. Además de ofrecer datos coherentes, la Fuente de Verdad debería responder a otras preguntas sobre ellos: «¿Por qué era esta la intención original? ¿Quién la aprobó? ¿Cuándo cambió?».
Este capítulo se centra en los propios datos: cuáles debe recoger tu intención, cómo modelarlos con el nivel de abstracción adecuado y cómo asegurarte de que estén libres de errores antes de que el resto del sistema de automatización dependa de ellos. Si fallas en esta parte, nada de lo que construyas sobre ella podrá estar bien, por muy buenos que sean los mecanismos que la rodean.
Lo primero es definir para qué sirven la intención de red y la Fuente de Verdad y dónde están sus límites.
Fundamentos#
Todos los demás componentes del sistema de automatización leen los datos de la Fuente de Verdad (SoT), por lo que esta debe cumplir cinco objetivos:
Recoger todo lo que necesitas con distintos niveles de abstracción. Representa y almacena la definición completa de la intención de tu red, con el grado de detalle que necesites. Esa definición empieza en la capa de servicio («añadir una nueva sucursal» o «configurar un servicio MPLS») y llega hasta los datos técnicos independientes del fabricante (direcciones IP, circuitos, especificaciones de los dispositivos, referencias a credenciales, ventanas de mantenimiento). La configuración de cada dispositivo queda fuera de la intención: el Ejecutor la genera a partir de esos datos. Los datos pueden ser muy diversos. Además, la SoT debe abarcar todo el ciclo de vida de los datos e incluir tanto lo que está en funcionamiento hoy como lo que tienes previsto y lo que estás retirando. En resumen, la SoT debería proporcionar datos suficientes para que puedas reconstruir tu red desde cero.
Mantener la integridad de los datos y permitir que se representen de forma flexible. Valídalo todo: comprueba que los tipos de datos sean correctos, que las relaciones tengan sentido, que las VLAN estén dentro de los rangos válidos y que no haya direcciones IP duplicadas. Lleva un registro de quién cambió qué y cuándo. Permite que las personas responsables aprueben los cambios importantes antes de que sean definitivos. Si algo sale mal, puedes revertirlos. Tu sistema de automatización necesita poder confiar en la exactitud de los datos, porque los datos erróneos llevan la red a estados incorrectos y provocan interrupciones del servicio.
Permitir que varias personas trabajen en paralelo sin interferir unas con otras. Varios equipos deberían poder proponer cambios al mismo tiempo. Los cambios se agrupan en conjuntos atómicos: o se aplican todos o fallan todos, sin estados intermedios. Puedes probarlos en un entorno de preproducción antes de pasarlos a producción. Para las grandes migraciones, puedes crear una rama, trabajar en ella y volver a integrarla en la rama de origen. En todo momento sabes qué intención está en uso y cuál se propone.
Facilitar a las personas y a las máquinas un acceso sencillo y seguro a los datos. Tu sistema necesita interfaces de programación de aplicaciones (API), como Representational State Transfer (REST) o GraphQL, para que la automatización pueda obtener y modificar datos. Las personas también necesitan consultarlos y editarlos a través de las interfaces web de usuario y de las herramientas de interfaz de línea de comandos (CLI) de la capa de Presentación, que muchos productos de SoT llevan integrada. Todos necesitan controles de acceso sólidos para ver solo lo que les corresponde. Puedes tener cien flujos de trabajo de automatización en ejecución al mismo tiempo, decenas de personas editando datos y sistemas externos sincronizando sus datos con los tuyos. Incluso así, el conjunto debe mantener la coherencia y responder con agilidad.
Consolidar datos procedentes de otros sistemas. Puede que ya cuentes con un sistema de gestión de activos para el hardware, sistemas IP para gestionar las direcciones o proveedores de circuitos para la conectividad. No vuelvas a crear esos datos a mano. Haz referencia a ellos en su sistema de origen o incorpora una copia sincronizada. Define reglas claras sobre qué sistema es responsable de cada dato. Mantén los datos sincronizados en el sentido que marque el sistema responsable. Así tendrás una visión unificada de todo sin reinventar la rueda.
Antes de entrar en los detalles de implementación, conviene entender de qué se encarga la Fuente de Verdad y qué queda fuera de su responsabilidad. Así estarán claros sus límites.
Qué entra en su ámbito
La Fuente de Verdad gestiona todos los datos de intención: la definición completa de cómo debe ser tu red. Esto incluye configuraciones de producción, entornos de preproducción, ramas de desarrollo y escenarios de prueba. Aquí se recoge todo lo que describe «lo que quieres».
Qué queda fuera de su ámbito
Hay varias funciones que pueden parecer afines, pero de las que no se encarga la Fuente de Verdad:
Datos de observabilidad: la Fuente de Verdad no almacena métricas, registros ni el estado en tiempo de ejecución. Sí define los valores esperados con los que compararás tus observaciones, como los umbrales de las alertas o los valores de referencia del rendimiento. Los datos de observabilidad propiamente dichos se almacenan en otro lugar (lo veremos en el capítulo 7).
Interacción con la red: la Fuente de Verdad no se comunica con los dispositivos ni les envía configuraciones. Proporciona los datos de la capa técnica que necesita el Ejecutor, pero no los traduce a la sintaxis del dispositivo ni aplica la configuración resultante. Ambas tareas corresponden al Ejecutor (capítulo 6).
Lógica de orquestación: la Fuente de Verdad no define la secuencia de pasos ni los flujos de trabajo para desplegar cambios. Define el estado final deseado. El Orquestador se encarga de cómo llegar a él (por qué dispositivos empezar, qué pasos de validación seguir y qué procedimientos de reversión utilizar) (capítulo 8).
La Fuente de Verdad da la respuesta de referencia a la pregunta «¿Cómo debe ser la red?». Todo lo demás en tu sistema de automatización (ejecución, monitorización, orquestación) toma esa respuesta como referencia para hacer su trabajo. Cuando la realidad se desvía de la intención, la Fuente de Verdad te indica cuál debería ser el estado de la red.
Hay una segunda ventaja, menos evidente. Rara vez consiste la automatización en construir algo una sola vez. Las redes pasan continuamente de un estado al siguiente. Pasar del estado A al estado B es más fácil si el estado A está documentado. Si se conocen tanto la intención actual como la nueva, el sistema de automatización puede compararlas, determinar qué hace falta cambiar y tocar solo eso. Sin un punto de partida definido, cada cambio empieza por averiguar de nuevo qué hay ya en la red.
Esos cinco objetivos se reparten entre dos capítulos. Este trata de los datos y el capítulo 5, de los mecanismos que los rodean. Los objetivos y límites anteriores se aplican a ambos.
Así que empieza por los datos. Sobre ellos se construye todo lo demás.
Qué datos abarca la intención#
«Datos» suena genérico, y lo es. La intención que recoge una Fuente de Verdad se expresa en distintos niveles de abstracción, cada uno con su propio propósito. Ningún nivel es mejor que otro: los que necesites dependerán de tus casos de uso. A lo largo de los años que he dedicado a construir soluciones completas de automatización de redes, he comprobado que dos capas cubren esos casos, desde lo más abstracto hasta lo más concreto, como muestra la Figura 4.1:
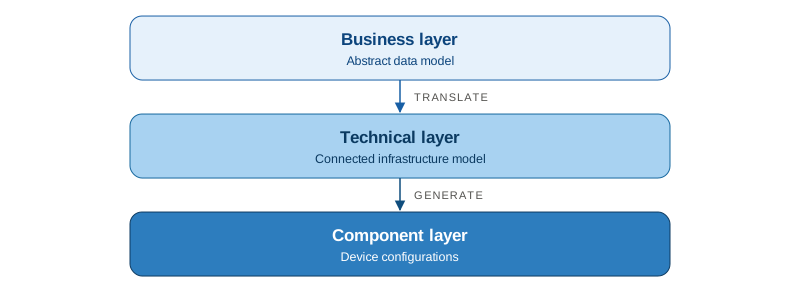
- Capa de servicio: recoge las abstracciones de alto nivel que facilitan el uso del sistema y ocultan detalles de bajo nivel que pueden ser irrelevantes para algunos perfiles de usuario. Por ejemplo: «configurar una L3VPN MPLS para la sucursal X».
- Capa técnica: recoge las abstracciones de bajo nivel, es decir, los datos de infraestructura que necesita tu red, expresados en términos independientes del fabricante. Por ejemplo: «AS de BGP 65001, route targets 65001:100, estado administrativo de la interfaz, etc.».
La intención termina en la capa técnica. La configuración que recibe cada dispositivo, por ejemplo «interface xe-0/0/0; unit 100;…», es el resultado que produce el Ejecutor al generar la configuración a partir de plantillas o al traducir los datos de la capa técnica, como explica la sección Dónde termina la intención.
Una buena estrategia de datos de intención conecta estas capas. Puedes empezar en la capa de servicio y generar después los datos técnicos de forma automática. Pero no siempre necesitas las dos capas: depende de lo que estés construyendo.
Hay otra forma de abordar la misma cuestión: fijarte en quién hace la petición en vez de centrarte en el nivel de abstracción. Cada persona o sistema trabaja con la misma intención, pero a un nivel de detalle distinto.
- Un ingeniero de redes solicita los cambios rutinarios a través de la capa de servicio, como cualquier otra persona, y trabaja en la capa técnica (interfaces, direcciones IP, atributos de enrutamiento, VLAN) para resolver las excepciones. Revisa la configuración que genera el Ejecutor a partir de plantillas antes de que llegue al dispositivo, pero no debería editar a mano la configuración de cada dispositivo.
- Quien tiene a su cargo un servicio solo quiere indicar qué servicio necesita, dónde y con qué características. Para eso está la capa de servicio.
- Un flujo de trabajo de automatización o un agente de inteligencia artificial (IA) necesita una vista estructurada y predecible que le permita actuar.
Pensar en los perfiles de usuario te ayuda a saber qué datos hacen falta, quién los necesita y con qué grado de detalle. También evita que muestres los 500 campos del objeto que representa un dispositivo a alguien que solo necesita cinco. Si mantienes una copia de la intención para cada público, acabarás con cinco fuentes de verdad. El objetivo es tener una sola intención y ofrecer a cada consumidor la vista que necesita. La sección Consumo de datos explica cómo construir esas vistas.
No siempre necesitas la capa de servicio, pero siempre necesitas la capa técnica. A los demás bloques arquitectónicos les cuesta trabajar únicamente con datos abstractos, y la sintaxis propia de cada dispositivo es responsabilidad del Ejecutor. La capa técnica es el contrato entre ellos, así que empieza por ahí.
Capa técnica#
La capa técnica es el modelo de los elementos que componen la red: dispositivos, interfaces, VLAN, prefijos, circuitos y mucho más. El modelo determina qué puedes representar y con qué facilidad puedes utilizarlo. Como señaló George Box: «Todos los modelos son erróneos, pero algunos son útiles». No hay un modelo perfecto que sirva a todo el mundo, pero aun así necesitas uno. En mi experiencia, el modelado de datos tiene más de arte que de ciencia, aunque ciertos patrones se repiten en los proyectos que dan buenos resultados.
El primer patrón es el conjunto de familias de datos que encontramos en la mayoría de las redes. A continuación las veremos una por una.
Familias de datos#
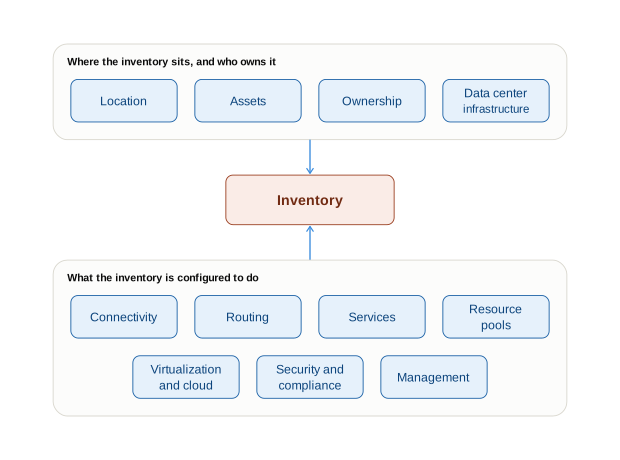
Las implementaciones completas de una Fuente de Verdad suelen modelar varias familias de datos, pero el Inventario es la piedra angular. Define los objetos que gestionas y a los que hacen referencia todas las demás familias. Adopta dos formas según lo que gestiones:
- Dispositivos físicos y virtuales, con los atributos que identifican a cada uno: nombre, tipo, modelo, plataforma y otros.
- Servicios en la nube que constituyen por sí mismos una unidad de gestión, como una red virtual. Se registran el tipo de servicio y el proveedor de nube, entre otros datos.
Puede que suelas pensar en el inventario solo en términos de dispositivos. Incluyo aquí los servicios en la nube sobre los que construyes la infraestructura en la nube, como otro tipo de inventario al que las demás familias de datos hacen referencia del mismo modo.
Las familias que se organizan en torno al inventario se dividen en dos grupos. El primero describe dónde están los elementos del inventario y a quién pertenecen:
- Ubicación: indica dónde se encuentra cada elemento del inventario según tu jerarquía real, ya sea por continentes, países, regiones, ciudades, edificios, plantas, salas o los niveles que correspondan.
- Activos: componentes de hardware que solo tienen sentido como parte de un dispositivo del inventario y que pueden encajar unos dentro de otros en varios niveles. Por ejemplo, un módulo de expansión aloja tarjetas que, a su vez, alojan módulos ópticos. Aquí se registran los números de serie, las fechas de adquisición y las condiciones de garantía, en el componente al que corresponde el número de serie.
- Titularidad: los inquilinos, usuarios o cuentas a los que pertenece un elemento del inventario. Esta información suele estar vinculada al mecanismo de autenticación.
- Infraestructura del centro de datos: racks y unidades de rack, líneas de alimentación, PDU y circuitos, zonas de refrigeración, así como el cableado físico y los paneles de parcheo que los interconectan. Esta familia es pertinente si construyes centros de datos. Si no es tu caso, puedes omitirla sin problema.
El segundo grupo describe las funciones para las que se configuran los elementos del inventario:
- Reservas de recursos: los rangos de los que asignas recursos (p. ej., prefijos IP, identificadores de VLAN, ASN y ámbitos DHCP) y las asignaciones que haces a partir de ellos.
- Conectividad: circuitos físicos (MPLS, Ethernet), túneles virtuales, asignaciones de ancho de banda y políticas de calidad de servicio (QoS).
- Enrutamiento: comunidades de Border Gateway Protocol (BGP), sistemas autónomos, políticas de enrutamiento, listas de prefijos y route targets para servicios L3VPN.
- Servicios: definiciones lógicas de servicios (L3VPN, L2VPN, paso a través de cortafuegos), correspondencias entre servicios y dispositivos, y acuerdos de nivel de servicio (SLA).
- Virtualización y nube: lo que se ejecuta dentro de un elemento del inventario en la nube, como subredes u otros servicios.
- Seguridad y cumplimiento: listas de control de acceso, reglas de cortafuegos, seguridad en la nube, zonas de seguridad, etiquetas de cumplimiento y requisitos de auditoría.
- Gestión: detalles de Simple Network Management Protocol (SNMP), suscripciones de gRPC Network Management Interface (gNMI), fuentes de Network Time Protocol (NTP), destinos de syslog e integración con TACACS+/RADIUS.
Estas familias dependen unas de otras, como muestra la Figura 4.2. Todas hacen referencia al inventario, y por eso es la piedra angular: un prefijo se asigna a una interfaz de un dispositivo, un servicio abarca varios dispositivos y un rack los aloja. Una SoT bien diseñada modela esas relaciones de forma explícita, y la estructura de datos debe permitirlo.
Como ves, además de los datos específicos de la red, hacen falta muchas otras familias de datos, como las de usuarios, ubicaciones o secretos. No todos los datos pertenecen al dominio de la red, pero la intención de red debe relacionarlos de forma coherente, incluso cuando no los gestiona todos en un único almacén de datos.
A veces, el valor que se guarda es solo una referencia al valor real. Por ejemplo, las credenciales secretas deben guardarse únicamente en un sistema diseñado para ello y nunca deben persistir en ningún otro lugar. Hay dos casos de uso generales:
- La credencial que necesita el Ejecutor o el Recolector para abrir una sesión con un dispositivo se mantiene como referencia de extremo a extremo: la SoT guarda algo como
vault://campus/switch-adminy el Ejecutor resuelve la referencia consultando directamente el almacén de secretos. - Un secreto que deba aparecer dentro de la configuración, como una clave MD5 de BGP, una comunidad SNMP o un secreto compartido de RADIUS, tiene que llegar al dispositivo como una cadena de caracteres con su valor real. El Ejecutor resuelve la referencia al generar la configuración a partir de plantillas, inserta el valor en el artefacto y no vuelve a escribir nada de ello en la Fuente de Verdad.
A menudo me preguntan qué les aporta una fuente de datos específica para redes como NetBox frente a otra de propósito general como ServiceNow. En mi experiencia, ambas permiten obtener resultados similares, pero un sistema genérico se utiliza en toda la empresa. Por eso cuesta más adaptarlo para que represente los datos de red que necesitas, y el proceso lleva más tiempo. Esto retrasa el momento en que el equipo de red puede usar el sistema para representar la red por completo.
Una vez vistos los tipos de datos que necesita una red, en la siguiente sección veremos las reglas generales para modelarlos.
Cómo modelar los datos#
Las familias anteriores indican qué hay que modelar. Las siguientes reglas indican cómo hacerlo y se aplican a cualquier familia con la que trabajes.
Limita los datos a tu caso de uso, sin intentar abarcar todo lo que existe. Al empezar con una SoT, es tentador modelar toda la red hasta el último detalle. Resiste la tentación. Incluye los datos que utilizas en tus operaciones. Esos datos varían mucho según el caso de uso:
- Para desplegar un centro de datos necesitas detalles físicos: ubicaciones, racks, posiciones de los dispositivos y ramificaciones de los cables.
- En una red de borde o troncal necesitas registrar todas las sesiones de tránsito y de peering, con suficientes atributos para establecer cada adyacencia.
- Para gestionar la configuración necesitas los datos de inventario imprescindibles para abrir una sesión: dirección de gestión, tipo de plataforma y credenciales.
- Para monitorizar la red necesitas distinguir un puerto conectado a un nodo de un enlace ascendente y conocer el umbral de utilización que corresponde a cada uno.
Modelar datos que nadie consulta tiene un coste. Complica el esquema, exige reglas de validación y requiere que alguien dedique tiempo a mantener los datos correctos. Un dato obsoleto es peor que uno ausente: basta con que alguien se fíe de él una vez para que deje de confiar en todos los demás.
Reutiliza un mismo modelo cuando los objetos compartan la mayoría de sus atributos. Si dos tipos de objetos difieren en uno o dos atributos, resulta tentador tomar el atajo de crear un modelo para cada uno. Evítalo por el mismo motivo por el que evitas crear un modelo por fabricante: tendrías que definir, consultar y validar dos veces cada relación con esos objetos. Añade al modelo compartido un atributo que recoja la diferencia.
Las direcciones son el ejemplo clásico. Hoy en día, casi todas las redes transportan tráfico de ambas familias de direcciones, y la trampa más evidente es crear un modelo para v4 y otro paralelo para v6. Tanto una interfaz como un prefijo o un vecino BGP necesitan relacionarse con una dirección, sea cual sea su familia. Define un único objeto de dirección con un atributo que indique la familia y permite que un servicio de doble pila tenga un prefijo de cada familia. Por eso los ejemplos de esquemas que verás más adelante en este capítulo admiten cualquiera de las dos familias.
Mantén la capa técnica independiente del fabricante. De esta regla depende que la capa sobreviva a tu próxima renovación de hardware. Una interfaz es una interfaz, sea quien sea el fabricante del equipo. Modélala una sola vez en términos neutros. En cuanto incorpores a la capa técnica la sintaxis de una plataforma, necesitarás un modelo paralelo por fabricante. La misma intención figurará entonces en tres sitios, con tres posibilidades de discrepancia. E incorporar un cuarto fabricante supondrá volver a modelar la red desde cero. Evita esa dependencia y deja que los adaptadores del Ejecutor se ocupen de las particularidades de cada fabricante al convertir el modelo neutro al formato de cada plataforma.
La independencia del fabricante es la opción por defecto, pero algunas funciones solo existen en una plataforma. En esos casos no hay nada que abstraer, y forzar un modelo común añade complejidad sin aportar nada. Modélalas como atributos específicos de esa plataforma, identifícalos con claridad y trátalos como excepciones (el capítulo 10 explica las opciones).
¿Qué grado de detalle necesita tu modelo? Modela un objeto por separado cuando algún proceso lo consulte por separado. Un puerto con un cable conectado, un extremo conocido o una política propia necesita su propio registro, porque las comprobaciones de cableado, la validación de vecinos y el seguimiento de los extremos parten de ese puerto. Una serie de puertos de acceso idénticos que ningún proceso consulta uno por uno no necesita registros individuales. Basta con indicar «las interfaces 1-40 usan esta plantilla estándar» y llevar un registro solo de las excepciones. Así tienes que mantener al día 2 objetos en lugar de 40, y el Ejecutor sigue generando la configuración de cada puerto.
El coste de un modelo con demasiado detalle no está en el tamaño de la base de datos, porque un almacén relacional admite millones de filas sin dificultad. Está en la atención que exige mantener cada registro fiel a la realidad.
Utiliza atributos de clasificación transversales. Cada uno de los modelos de datos anteriores tiene sus propios atributos, pero hay patrones de clasificación que se repiten en todos los datos de red. Los modelos bien diseñados incluyen estos atributos básicos para que puedas tratar los datos de forma coherente:
- Función: ¿qué cometido tiene este objeto? (núcleo, distribución, acceso; primario, secundario)
- Estado: ¿está activo, previsto, en proceso de retirada o retirado?
- Tipo: ¿de qué tipo de objeto se trata? (VLAN, dispositivo, circuito, servicio)
Dónde termina la intención#
La capa técnica es la última capa de la intención. Los dispositivos no la entienden: cada uno espera su propia sintaxis, ya sean líneas de la CLI, una carga útil de Yet Another Next Generation (YANG) o un modelo de una API REST. Convertir el registro independiente del fabricante a esa sintaxis queda fuera del ámbito de la intención y del cometido del bloque de Intención. Se encarga el Ejecutor mediante un adaptador por plataforma, ya sea generando la configuración a partir de tus propias plantillas o traduciéndola con un módulo del fabricante (capítulo 6).
Ese límite convierte el esquema de la capa técnica en un contrato. El bloque de Intención lo publica y mantiene sus versiones. Cada adaptador del Ejecutor declara qué versiones admite y comprueba su compatibilidad con ellas mediante pruebas. La sintaxis del fabricante nunca se incorpora a la capa técnica, ni las plantillas a los datos de intención. El capítulo 6 explica por qué y en qué casos sigue siendo adecuado utilizar la función de generación a partir de plantillas que ofrece un producto de Fuente de Verdad.
Capa de servicio#
Cuando tienes 50 dispositivos y 30 VLAN, puedes gestionarlos uno por uno: crear cada VLAN, configurar cada interfaz y asignar cada IP a mano. Es tedioso, pero manejable.
Cuando tienes 5000 dispositivos y cientos de servicios, la gestión manual es imposible. Añadir una sucursal supondría especificar a mano más de 100 elementos de configuración por ubicación. La capa de servicio lo resuelve: los operadores describen lo que quieren en términos de servicio («añadir una sucursal») y el sistema desarrolla esa petición hasta obtener las especificaciones técnicas completas.
La ventaja evidente es que reduces los datos que hay que introducir. Lo que quizá no resulte tan evidente es que la capa de servicio hace cumplir los límites que has fijado sin esfuerzo adicional. Cuando el sistema genera los datos técnicos a partir de reglas que has escrito una sola vez, ya no queda ningún campo que alguien pueda rellenar mal. El prefijo procede de la reserva correcta porque la lógica de expansión lo toma de esa reserva, sin depender de que el usuario acierte al elegirla o de que alguien detecte un error. Compáralo con pedirle a un operador 100 valores y validar después los 100: la capa de servicio evita el error en lugar de detectarlo más tarde mediante la validación.
Hay otros términos para referirse al concepto de capa de servicio. Uno que el sector utiliza con frecuencia es la automatización guiada por el diseño (design-driven).
Veamos cómo funciona con un ejemplo de traducción de la capa de servicio a la capa técnica. El siguiente fragmento en JavaScript Object Notation (JSON) recoge los datos básicos necesarios para poner en marcha una nueva sucursal.
{
  "type": "branch_office",
  "location": "Dallas, TX",
  "size": "small"
}La capa de servicio aporta la lógica de transformación que toma estos datos y los desarrolla hasta obtener los de la capa técnica, en dos fases: generación a partir de plantillas y construcción. Las dos fases se pueden desglosar en cinco pasos. Los tres primeros (generación a partir de plantillas) no reservan ningún recurso y puedes repetirlos libremente. Los dos últimos (construcción) reservan recursos reales y registran las reservas.
- Valida la solicitud. Comprueba que se admiten el tipo y el tamaño solicitados y que la ubicación existe.
- Carga los transformadores asociados. Por ejemplo, el tipo «branch_office» define tres servicios distintos (datos, voz e invitados) y requiere circuitos externos. El tamaño «small», asociado al tipo «branch_office», determina cuántos dispositivos hacen falta y de qué tipo, el tamaño del prefijo IPv4 y cuántas VLAN se necesitan para los servicios.
- Convierte los datos de entrada en datos de la capa técnica. Enumera todos los objetos que hay que crear para definir el estado deseado de la red, incluidos los recursos dinámicos que aún no se han asignado. Entre ellos figuran la nueva ubicación (con un código que se crea a partir de su nombre), los dispositivos con su tipo correspondiente, los futuros prefijos y direcciones IP, etc.
- Asigna los recursos dinámicos. Reserva recursos únicos que nadie haya reservado todavía. A partir de los requisitos (un prefijo /22 y 3 VLAN), asigna las VLAN disponibles, el prefijo padre /22, un prefijo hijo /24 por VLAN y las direcciones IP de cada interfaz de puerta de enlace predeterminada.
- Confirma y guarda los objetos. Una vez que tengas el plan completo para toda la capa técnica, confírmalo y crea todos los objetos (probablemente cientos, a partir de solo tres datos de entrada).
No confundas esta generación del plan con la generación de la configuración de los dispositivos a partir de plantillas que realiza el Ejecutor (Capítulo 6): aquí se generan objetos de la capa técnica en lugar de artefactos de configuración.
Esta separación en dos etapas, que muestra la Figura 4.3, permite al equipo revisar y aprobar los datos antes de confirmar nada:
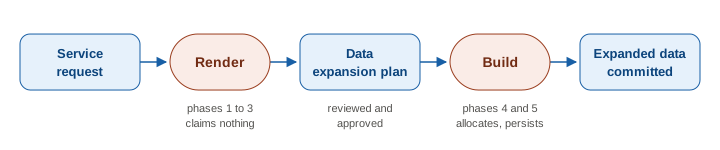
- La generación del plan abarca los pasos 1 a 3. Produce una propuesta de plan con los objetos de la capa técnica necesarios para aplicar el patrón de diseño a los datos de entrada, pero no reserva recursos dinámicos ni guarda nada. El ID de VLAN y el prefijo que figuran en el plan son propuestas, no reservas. Sirve de simulación: te muestra cómo se crearán los datos antes de que los crees.
- La construcción abarca los pasos 4 y 5. A partir del plan generado, solicita los recursos reales y guarda los objetos de la capa técnica. En ese momento los datos quedan listos para su uso y, por primera vez, se retiran recursos de un conjunto de recursos disponibles.
Situar ahí el límite entre las etapas plantea el siguiente problema. Como la generación del plan no reserva nada, es perfectamente posible obtener dos respuestas distintas al generar dos planes para la misma solicitud. Esto complica la idempotencia de esa etapa. Por ejemplo, el lunes preparas el despliegue de una sede y el plan asigna la VLAN 100 porque es la que está disponible en ese momento. Pero, si no pulsas «commit», puede que vuelvas a generar el plan unos minutos después y te toque la VLAN 101 porque alguien ya ha tomado la VLAN 100 del conjunto de recursos disponibles. Eso no es idempotente.
Esa falta de idempotencia es real y hay dos formas de convivir con ella:
Mantén pura la generación y fija el plan. Se acepta que dos planes generados puedan diferir. Lo que se revisa es un plan concreto, identificado por un hash de sus entradas y salidas. Por eso muchos sistemas de diseño almacenan los planes usando su contenido como dirección. La etapa de construcción aplica ese plan sin volver a generarlo: si entretanto alguien ha tomado uno de sus recursos, la construcción falla con un error explícito y vuelves a generar el plan. Generarlo sigue teniendo un coste bajo y no exige mantener estado. La garantía pasa a ser «construir lo que se ha revisado o detenerse».
Permite que la generación del plan mantenga una reserva temporal. Al generar el plan se reservan los recursos propuestos con un plazo de caducidad. Si repites la misma solicitud, obtienes la misma VLAN porque la reserva sigue vigente. Si se abandona un plan, sus recursos se liberan cuando caduca la reserva. Así se consigue la idempotencia, pero generar un plan deja de salir gratis: las reservas consumen inventario y debes ajustar el plazo de caducidad en función de lo que tarden las aprobaciones.
La primera opción mantiene una separación clara entre las etapas y es preferible por defecto. La segunda compensa cuando pasa tanto tiempo entre la generación del plan y la construcción que es habitual perder recursos durante la aprobación.
En definitiva, la capa de servicio es una biblioteca de tus patrones de diseño de red: los bloques reutilizables que expanden los datos. La Tabla 4.1 ilustra cómo podría ser:
| Patrón | Componentes |
|---|---|
| Sucursal pequeña (Small Branch Office) | • Un único router de borde, una VPN MPLS con un vecino BGP de respaldo • 2-3 VLAN (datos, voz, invitados), QoS para la voz • El cortafuegos solo permite tráfico de ERP y VoIP |
| Nodo regional mediano (Medium Regional Hub) | • Routers de borde redundantes (activo y en espera), varias VPN MPLS • 10-15 VLAN (por departamento, de invitados y para OOB), QoS con 6 clases • Políticas de cortafuegos en la capa de aplicación |
| Pod de centro de datos (Data Center Pod) | • Dos switches spine, cada leaf conectado a ambos, red subyacente con eBGP sin numerar • Red superpuesta EVPN/VXLAN, una VRF y un VNI por inquilino • Asignación automática de los ASN, las interfaces de loopback y los VNI |
Por supuesto, esta definición de los patrones es demasiado general para usarla tal cual. Hay que codificarla y, aunque hay muchas formas de hacerlo, todas exigen algo de programación. Y como es código, exige el mismo rigor en las pruebas que cualquier otro código: modificar un diseño supone un cambio para todas las sedes construidas a partir de él, así que te interesa saber qué produce antes de publicarlo. El capítulo 11 explica la estrategia de pruebas. Cada patrón codifica decisiones de arquitectura contrastadas. Apartarse de ellas requiere aprobación explícita, pero desplegar los patrones debería considerarse una operación normal porque la transformación es determinista. La misma solicitud y el mismo diseño siempre producen el mismo plan mientras sigan disponibles los mismos recursos en cada conjunto. Por eso la etapa de construcción aplica el plan fijado.
En el ejemplo de la sucursal se añade una sede a una red que ya existe. Donde más trabajo hace la capa de servicio es en una fabric de centro de datos greenfield, porque todavía no hay nada que conciliar: todos los valores de la fabric proceden del diseño. Para definir un pod solo hacen falta cuatro campos de entrada: la sede, el nombre del pod, el número de switches leaf y un perfil. Los mismos cinco pasos expanden esos datos.
La validación comprueba que la sede dispone de espacio en los racks y de potencia eléctrica para 16 switches leaf. El perfil «estándar» carga la topología de la fila Pod de centro de datos de la Tabla 4.1: dos spines, cada leaf conectado a ambos y una red subyacente sin numerar. La etapa de generación enumera los objetos: 18 switches con sus funciones, 32 enlaces punto a punto que en este perfil no necesitan direcciones, una interfaz de loopback por switch, un ASN por leaf y otro que comparten los spines.
La etapa de construcción los asigna a partir de los conjuntos de recursos disponibles en la sede. Cuatro campos se convierten en varios cientos de objetos, y del mismo registro sale el plano de cableado que sigue el equipo del centro de datos al montar los equipos en los racks. Cuando se encienden los switches, el aprovisionamiento sin intervención (Zero Touch Provisioning, Capítulo 6) entrega a cada uno su configuración, generada a partir de esos objetos mediante plantillas, sin que nadie tenga que teclear un solo valor.
Los inquilinos siguen el mismo patrón un nivel por encima. La solicitud de un nuevo inquilino parte de un nombre y un perfil y se expande para definir una VRF, un VNI y los switches leaf que transportan su tráfico.
Entonces, ¿quién escribe los patrones? Los arquitectos de red. Parece obvio, pero los equipos suelen equivocarse en este punto. Como un diseño es código, la responsabilidad tiende a recaer en quienes se sienten más cómodos escribiendo código, que suelen ser los miembros del equipo de automatización de redes. Esa responsabilidad no les corresponde. Un patrón de diseño codifica decisiones de arquitectura: cómo se construye una sucursal, qué modelo de redundancia se aplica y dónde se sitúa el límite de seguridad. Quienes responden de esas decisiones deben ser quienes las plasmen por escrito. El equipo de automatización de redes es responsable de los mecanismos que ejecutan los diseños y los arquitectos, de lo que esos diseños especifican.
Aquí la arquitectura de red deja de ser un documento alojado en una wiki que cada cual interpreta de una forma ligeramente distinta y se convierte en un artefacto que establece un patrón de diseño. El arquitecto define con datos las reglas a partir de las cuales se construye la red, y cualquier desviación queda a la vista. Espero que aprecies cómo cambia el trabajo del arquitecto y qué repercusión tiene ese cambio. La Parte 4 explica qué exige esto de la organización.
A todos nos gusta la estandarización, pero también tenemos que reconocer que es casi imposible abarcar todas las variantes de tu red con unos pocos patrones de diseño. Tener un diseño por sede no es una opción. Entonces, ¿cómo lo resuelves?
Hay tres formas de resolverlo:
- Añade nuevas dimensiones al patrón de diseño. Cuando detectes un factor que varía con frecuencia de un caso de uso a otro, codifícalo. En nuestro ejemplo, si la sucursal pequeña usa por defecto el cortafuegos del fabricante A, pero también podría usar el del fabricante B o el del C, añade un campo de entrada que permita elegir el fabricante. El patrón de diseño usará ese campo para crear los dispositivos.
- Utiliza patrones de desviación (deviation patterns). Estos patrones se aplican junto con los estándar y los complementan para mantener las desviaciones bajo control. Si una sucursal pequeña tiene necesidades especiales y requiere una topología distinta con un respaldo adicional, selecciona, además del diseño de «sucursal pequeña», un diseño de desviación que añada ese respaldo. La misma desviación también sirve para los demás diseños.
- Permite personalizar la capa técnica. Es el último recurso: si la excepción es realmente un caso aislado, quizá no merezca la pena dedicar esfuerzo a estandarizar un patrón. En esos casos, siempre puedes acceder a los datos técnicos de nivel inferior y ajustarlos según sea necesario.
Por último, y no por ello menos importante, los patrones de diseño tienen que evolucionar. Surgen nuevos patrones, las herramientas mejoran y la sucursal que tomaste como estándar en 2022 (un router, dos VLAN) no es la que tomarías como estándar hoy (dos routers, cuatro VLAN y medidas de seguridad más estrictas). El problema es que las sedes construidas a partir del diseño anterior siguen utilizándolo.
La respuesta es el diseño como código con control de versiones (design-as-code with versioning): conserva todas las versiones de un diseño y registra en cada sede la versión con la que se construyó. Ese único dato hace posible todo lo demás. Puedes migrar sede por sede en lugar de hacerlo de golpe, revertir una versión si resulta ser incorrecta y probar la siguiente en preproducción mientras el entorno de producción sigue utilizando la versión actual. Las sedes que utilizan el diseño anterior siguen funcionando con él y arrastran la deuda que eso suponga hasta que les llegue el turno.
Espero que veas las ventajas del enfoque guiado por el diseño. Es la forma de gestionar los datos cuando la automatización alcanza una escala en la que gestionarlos objeto por objeto se convierte en una pesadilla. Sin embargo, tengo que advertirte de que podrías encontrar resistencia entre los equipos acostumbrados a construir cada sede a mano. La objeción no es solo cultural: algunas de esas excepciones son reales. Reconócelo desde el principio. No todo se puede abstraer y, si la capa de servicio parte de la premisa contraria, en menos de un trimestre los equipos empezarán a saltársela.
Recuerda la regla del 80/20. Céntrate en la parte de tu red que ofrezca el mayor beneficio con el menor esfuerzo y crea una buena abstracción para ella. Para el resto, ofrece dos vías de escape: diseños secundarios codificados para las excepciones recurrentes y acceso directo, sin más, a la capa técnica para los casos realmente aislados. Ambas opciones mantienen el trabajo dentro de la SoT. Un diseño que prohíbe las excepciones no las elimina. Solo las traslada a la sesión de consola de alguien, donde no queda constancia de que se hayan producido.
Con esto se completa la descripción de las dos capas: qué expresa la intención en cada nivel de detalle. Lo que las capas no explican es cómo se garantiza que los datos sigan siendo correctos, cómo se almacenan, cómo se accede a ellos y cómo se integran con los que ya contienen otros sistemas. De eso se encargan las funcionalidades.
Funcionalidades#
Las dos capas describen los datos como si pudieran existir sin más. No es así. En ambas hemos dado por supuestos mecanismos que aún no hemos presentado. Para separar la generación del plan de la construcción, la capa de servicio necesita un lugar donde guardar el plan y su historial. Las referencias entre dispositivos, prefijos y VLAN en la capa técnica solo conservan su validez si algún mecanismo la garantiza. Y las fuentes externas que mencionamos al principio del capítulo solo forman parte de la Fuente de Verdad si algún mecanismo las integra con el resto.
Cuatro funcionalidades aportan esos mecanismos, y cada una responde a una pregunta distinta: qué forma se da a los datos, cómo se conservan a pesar de los cambios, cómo se accede a ellos y de dónde proceden. La Figura 4.4 muestra cómo se relacionan con los cinco objetivos.
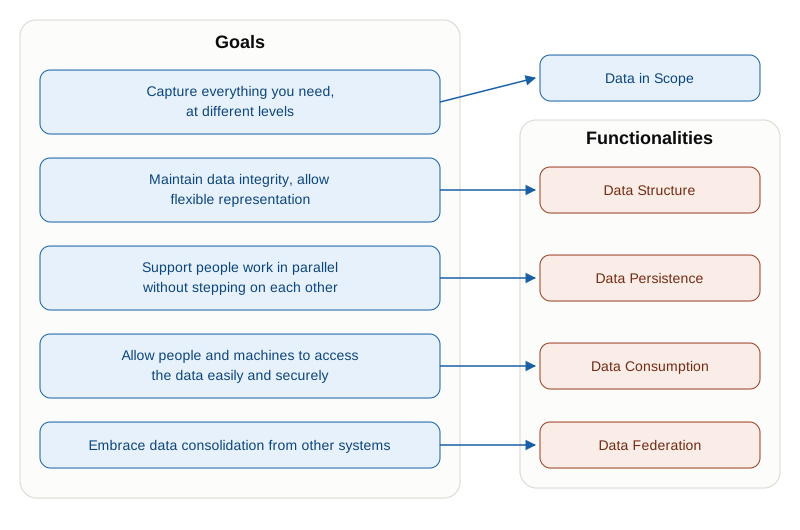
Estructura de los datos: define el esquema y las restricciones que impiden introducir datos incorrectos. Incluye la validación, las comprobaciones de unicidad y la integridad referencial. Ofrece mensajes de error claros.
Persistencia de los datos: almacena la intención, responde a consultas sobre ella y conserva el historial completo de quién cambió qué, cuándo y por qué. Permite revertir los cambios cuando sea necesario.
Consumo de los datos: describe cómo las personas y los sistemas obtienen y utilizan los datos. El bloque ofrece API. Las personas acceden a él a través de las interfaces de usuario web y las interfaces de línea de comandos de la capa de Presentación, que muchos productos de SoT llevan integrada. Cada cual cuenta con un control de acceso adecuado a su función.
Federación de datos: Obtiene los datos de los sistemas que ya se encargan de gestionarlos (la base de datos de circuitos, el IPAM, etc.) y los mantiene sincronizados.
Estas cuatro funciones se apoyan unas en otras. La estructura de datos determina qué se considera válido. La persistencia de datos protege los datos válidos y su historial incluso cuando varios procesos escriben a la vez. El consumo de datos los pone a disposición de quienes los necesitan. La federación de datos evita que la SoT se convierta en otro silo al respetar la autoridad de los sistemas que ya son la referencia para cada dato.
La primera de las cuatro tiene su sitio aquí, junto a los datos, porque determina qué datos se admiten. Las otras tres se tratan en el capítulo 5.
Estructura de datos#
Los malos programadores se preocupan por el código. Los buenos programadores se preocupan por las estructuras de datos y por las relaciones entre ellas.
Linus Torvalds
Torvalds hablaba del código. En la automatización de redes, la estructura de datos forma parte del programa. Los datos importan tanto que de ellos depende que la automatización sea buena o mala. Definir mal la intención puede provocar fallos de red o brechas de seguridad. La estructura de datos, es decir, las restricciones que impone el esquema, te protege: impide que entren datos incorrectos y explica con claridad por qué los rechaza.
Un esquema hace algo más que describir la forma de los datos. Define qué significa válido: qué valores se admiten, qué campos son obligatorios, cómo se relacionan los objetos entre sí y qué restricciones deben cumplirse. Esto convierte el esquema en un contrato: si los datos se ajustan al esquema, puedes confiar en que cumplen las reglas que este expresa. La corrección de los datos se comprueba una sola vez, en el punto de escritura, sin que cada consumidor tenga que volver a comprobarla después.
Esta distinción importa más de lo que parece. Sin el contrato, cada flujo de trabajo que lee un objeto de dispositivo tiene que protegerse: debe comprobar que la dirección de gestión sea realmente una dirección, que reconozca el rol y que la referencia a la sede siga apuntando a una sede que exista. Con diez consumidores tienes diez implementaciones de las mismas comprobaciones. Con el tiempo divergen y cada una falla de forma distinta ante el mismo registro incorrecto. Con el contrato, los consumidores hacen su trabajo y pueden confiar en los datos que reciben. Por tanto, incorpora al esquema todo lo que sepas sobre la validez de los datos, hasta donde sea razonable.
Cuatro propiedades distinguen un esquema con el que puedes convivir de otro con el que tendrás que pelearte:
Extensible. Los modelos existentes cubren la mayor parte de lo que necesitas, pero nunca todo. El modelo que hoy te encaja deja de hacerlo cuando llega el siguiente caso de uso. Necesitas margen para añadir campos y objetos, además de una vía realista para hacer evolucionar el modelo y migrar los datos existentes sin perderlos ni romper el funcionamiento de los consumidores. En Extensibilidad, polimorfismo y migraciones se explica cómo hacerlo.
Reutilizable. Modela cada elemento una sola vez y haz referencia a él allí donde aparezca. Una dirección IP pertenece a una interfaz y esta, a un dispositivo. Esa misma dirección aparece también como dirección de un vecino BGP, extremo de un túnel y dirección de un servicio. Si anidas una copia de la estructura de la dirección en cada caso, tendrás que mantener la coherencia entre cuatro definiciones y no podrás responder a la pregunta «¿dónde se usa 192.0.2.1?». Define la dirección una sola vez como objeto independiente y relaciona los demás objetos con él. La facilidad para hacerlo depende en gran medida de cómo elijas almacenar los datos: las referencias resultan naturales en las bases de datos relacionales y de grafos, mientras que las documentales favorecen el anidamiento y te obligan a mantener a mano las referencias cruzadas (en Consultas sobre datos conectados se explican las ventajas e inconvenientes).
Validable. Un esquema que no puede rechazar nada se queda en documentación. Hay dos tipos de restricciones y necesitas ambos:
- La validación estructural comprueba si los datos se ajustan al esquema: si los tipos son correctos, si están presentes los campos obligatorios y si los valores respetan los formatos. ¿Es
mgmt_ipuna dirección o la cadena"TBD"? - La validación semántica comprueba si los datos tienen sentido: que los prefijos no se solapen, que las referencias apunten a objetos existentes, que los campos inmutables conserven el valor que se les asignó y que el ID de la VLAN esté dentro del rango que se usa de verdad en esa sede.
Las comprobaciones estructurales tienen un coste bajo y son locales, porque basta con examinar el propio registro. Las comprobaciones semánticas son las que detectan problemas que pueden provocar caídas del servicio. Su coste es mayor porque exigen consultar el resto de los datos.
- La validación estructural comprueba si los datos se ajustan al esquema: si los tipos son correctos, si están presentes los campos obligatorios y si los valores respetan los formatos. ¿Es
Flexible. Toda red tiene un estándar y un conjunto de desviaciones controladas. Si el esquema solo admite el estándar, las desviaciones no desaparecen: se trasladan a un lugar donde no puedes verlas. Supón que el 70 % de tus sedes se ajusta a un mismo diseño de la capa de servicio y que el 30 % restante presenta pequeñas diferencias recurrentes. Deberías poder expresar esas excepciones como parches que se aplican sobre el estándar, para que este siga vigente allí donde sea posible. La misma necesidad aparece en la capa técnica, donde todos los tipos de interfaz comparten la mayoría de los atributos y cada tecnología añade unos pocos propios. Esto es el polimorfismo, que veremos más adelante.
Lenguajes de definición de esquemas#
Importa cómo defines tus datos. Un lenguaje de definición de esquemas te permite expresar qué significa válido de forma que una máquina pueda comprobarlo: los tipos, los campos obligatorios, las relaciones y las restricciones. Hay varios lenguajes y ninguno es el mejor en todos los casos. La elección depende sobre todo de dónde tienes ya los datos y de quién tiene que leerlos. La Tabla 4.2 compara los más habituales.
| Lenguaje | Uso más adecuado | Ventajas | Inconvenientes |
|---|---|---|---|
| SQL (DDL) | Datos que ya residen en una base de datos relacional | Es maduro, ampliamente conocido y la propia base de datos impone el esquema sin necesidad de un paso adicional | Modificar el esquema exige una migración, lo que complica el trabajo con modelos que evolucionan deprisa |
| JSON Schema | Validación de documentos y de los datos que se intercambian a través de una API | Es legible, cuenta con excelentes herramientas y permite componer esquemas mediante referencias a otros esquemas | format: ipv4 y otras indicaciones similares son meras anotaciones por defecto, así que debes configurar el validador para que exija su cumplimiento |
| YANG | Modelos para interactuar con dispositivos | Está diseñado expresamente para redes y funciona directamente con NETCONF, RESTCONF y gNMI | Cuesta dominarlo, requiere un conjunto complejo de herramientas y los modelos de los fabricantes difieren entre sí |
| GraphQL (lenguaje de definición de esquemas, SDL) | Ofrecer un único modelo tipado a muchos consumidores distintos | Tiene tipado fuerte, el propio esquema sirve de documentación y cada cliente puede obtener exactamente los campos que necesita | Requiere una capa GraphQL delante del sistema que almacene los datos |
| CUE | Mantener juntos el esquema, la validación y la generación | Valida y genera a partir de las mismas definiciones y exige que se cumplan los invariantes en vez de limitarse a documentarlos | Su ecosistema es pequeño y la mayoría de los equipos de redes lo desconoce |
Dos observaciones antes de continuar. En primer lugar, elegir el formato de serialización (YAML, JSON, XML, Protocol Buffers) y elegir el lenguaje de definición de esquemas son decisiones distintas, aunque se confunden a menudo. YAML resulta fácil de leer, pero por sí solo no valida nada. En segundo lugar, la mayoría de los productos de SoT ni siquiera te dan acceso directo a un lenguaje de definición de esquemas. Ofrecen su propia capa de modelado y generan el resto. Esto suele ser una ventaja, siempre que sigas pudiendo explicar qué permite el modelo y cómo modificarlo.
Al elegir un lenguaje, determinas qué puedes expresar. Aplicar las restricciones es el paso práctico: las conviertes en comprobaciones que se ejecutan en cada escritura para que el contrato anterior se cumpla de verdad.
Aplicación del esquema y sus restricciones#
Los tipos de validación de la Tabla 4.3 abarcan las dos categorías que acabamos de ver. La validación del esquema y la de rangos son estructurales: basta con examinar el propio registro. La unicidad, la integridad referencial y las reglas de negocio son semánticas: para comprobarlas hay que consultar el resto de los datos.
| Tipo de validación | Ejemplos de reglas | Ejemplo de error |
|---|---|---|
| Validación del esquema Exigir que se respeten los tipos y formatos de datos | ID de la VLAN: entero entre 1 y 4094 Nombre de la VLAN: cadena de 32 caracteres como máximo Sedes de la VLAN: lista de referencias a sedes Estado de la VLAN: enum(active, planned, deprecated) | { "id": 5000, "name": "CUSTOMER-VLAN" }→ Error: el ID de la VLAN, 5000, supera el máximo de 4094 |
| Restricciones de unicidad Evitar entradas duplicadas | VLAN 100: única por sede IP 192.0.2.1: única en todo el IPAM Nombre de equipo “pe-01”: único por región | Intento de crear un segundo “pe-01” en la misma región → Error: el nombre de equipo ya existe |
| Integridad referencial Garantizar que las relaciones sigan siendo válidas | Referencias del circuito: site_a y site_b (deben existir en Sites) y vendor (debe existir en Vendors) | Eliminación de la sede site_a a la que hace referencia un circuito → Opciones: rechazar la eliminación, eliminar en cascada o dejar el circuito sin sede con la indicación “sede desconocida” |
| Validación de rangos Aplicar restricciones numéricas y de patrón | AS de BGP: 1-4294967294, excepto 23456 (AS_TRANS) IPv4: format: ipv4 en lugar de una expresión escrita a mano como ^(\d{1,3}\.){3}\d{1,3}$, que acepta 999.999.999.999Velocidad de la interfaz: {1G, 10G, 25G, 40G, 100G} | Velocidad de la interfaz “5G” → Error: velocidad no válida. Debe ser una de las siguientes: {1G, 10G, 25G, 40G, 100G} |
| Validación de reglas de negocio Aplicar las políticas de la organización | Si el estado de la VLAN es ‘active’ → debe tener ≥1 sede Si el tipo de dispositivo es ‘firewall’ → debe tener el campo security_zone Si el tipo de servicio es ‘L3VPN’ → el valor de route_distinguisher debe ser único por VRF | VLAN activa sin sedes → Error: las VLAN activas deben estar asignadas al menos a una sede |
Por ejemplo, con JSON Schema puedes validar tus datos en JSON (o YAML). Este esquema en JSON Schema define algunos atributos de un dispositivo:
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "type": "object",
  "required": ["hostname", "mgmt_ip", "interfaces"],
  "additionalProperties": false,
  "properties": {
    "hostname": {
      "type": "string",
      "pattern": "^[a-z0-9-]+$"
    },
    "mgmt_ip": {
      "type": "string",
      "anyOf": [
        { "format": "ipv4" },
        { "format": "ipv6" }
      ]
    },
    "interfaces": {
      "type": "array",
      "minItems": 1,
      "items": {
        "type": "object",
        "required": ["name", "enabled", "vlan"],
        "additionalProperties": false,
        "properties": {
          "name": {
            "type": "string",
            "pattern": "^Ethernet[0-9]+$"
          },
          "enabled": {
            "type": "boolean"
          },
          "vlan": {
            "type": "integer",
            "minimum": 1,
            "maximum": 4094
          }
        }
      }
    }
  }
}Estas dos restricciones son las reglas que faltaban en la historia inicial, expresadas de forma que una máquina pueda exigir su cumplimiento: vlan es un entero con un valor máximo de 4094 y mgmt_ip debe ser una dirección de una de las dos familias. No basta con una cadena que parezca una dirección.
Y el Listado 4.3 muestra un registro de dispositivo concreto que se ajusta al esquema del Listado 4.2:
{
  "hostname": "sw-core-01",
  "mgmt_ip": "192.0.2.10",
  "interfaces": [
    {
      "name": "Ethernet1",
      "enabled": true,
      "vlan": 100
    },
    {
      "name": "Ethernet2",
      "enabled": false,
      "vlan": 200
    }
  ]
}Mi consejo: rechaza los datos incorrectos. Punto. He visto demasiados sistemas de «validación permisiva» convertidos en vertederos porque «solo por esta vez» acaba siendo la forma habitual de trabajar. Si una regla es lo bastante importante como para comprobarla, también lo es como para exigir que se cumpla.
Pero, como de costumbre, hay excepciones. En las siguientes situaciones puede estar justificado aplicar la validación con menos rigor:
Directrices de actuación (no son reglas): «Estás usando una subred /22 cuando lo habitual es que usemos /24» es una advertencia, no un error. Avisa al usuario, deja constancia en el registro y permítele continuar si confirma la excepción.
Comprobaciones costosas entre objetos: Si la validación tarda más de unos segundos, acepta el cambio y valídalo de forma asíncrona. Aun así, actúa en función del resultado: señala el incumplimiento, avisa al usuario y exige que lo corrija.
Descubrimiento de redes brownfield: Cuando importes configuraciones existentes, encontrarás incumplimientos por todas partes. Señálalos, pero no bloquees la importación. El objetivo es precisamente descubrir qué hay en realidad, aunque se aparte de tu modelo ideal.
¿Y todo lo demás? Recházalo. Tu automatización depende de que los datos sean fiables. Los datos incorrectos provocan caídas del servicio.
Ahora bien, validar tiene un coste. Las diferencias de coste entre unas comprobaciones y otras influyen en las decisiones de diseño. En la práctica, los sistemas fijan un objetivo de rendimiento y limitan las comprobaciones que se ejecutan durante una escritura síncrona a las que caben dentro de ese objetivo. De ese presupuesto de tiempo se derivan tres enfoques:
- La validación síncrona realiza las comprobaciones antes de aceptar la escritura. Comprobar tipos y patrones o consultar un índice local lleva menos de 10 ms. Comprobar la unicidad y la integridad referencial lleva menos de 100 ms. El usuario obtiene una respuesta inmediata y los datos mantienen la coherencia, pero cada comprobación añade latencia a la respuesta de la API y ralentiza las automatizaciones que procesan muchas operaciones por unidad de tiempo. Úsala para las comprobaciones de integridad críticas y los flujos de trabajo interactivos.
- La validación asíncrona acepta primero la escritura y la valida después, en comprobaciones de coherencia que se ejecutan en segundo plano entre unos segundos y varias horas más tarde. La API sigue respondiendo con rapidez, pero los datos pueden ser incoherentes durante un tiempo y resulta difícil comunicar el error: «La escritura se completó correctamente, pero cinco minutos después falló la validación». Úsala para operaciones masivas y automatizaciones de gran volumen.
- La validación híbrida ejecuta las comprobaciones de bajo coste como parte de la propia escritura, en menos de 100 ms, y aplaza las reglas costosas que implican a varios objetos y la lógica de negocio. Un punto de acceso de la API informa del estado de la validación. Este enfoque exige una implementación más compleja y un seguimiento del estado. Es el que utiliza la mayoría de los sistemas en producción.
También en el ámbito de la validación, el aprendizaje automático puede detectar lo que las reglas estáticas pasan por alto: valores inusuales. Hay tres patrones habituales:
- La detección de anomalías (Anomaly Detection) compara un cambio con los anteriores y pone en duda el valor atípico: si las VLAN de las sucursales siempre han estado en el rango 1000-1999, una solicitud para la VLAN 2500 requiere confirmación en vez de rechazarse directamente.
- La autocorrección propone el valor que probablemente querías introducir cuando escribiste uno no válido. Por ejemplo, si escribes /33, sugiere /24 porque todas las demás subredes de esa sede son /24.
- La comparación de representaciones vectoriales señala un dispositivo cuya configuración difiere de la de otros que desempeñan la misma función. Así detecta el servidor NTP que alguien olvidó configurar.
Las tres técnicas ofrecen sugerencias sin bloquear el proceso. Muestra solo los hallazgos con un nivel de confianza alto o acabarás saturando al equipo de alertas. Muestra siempre el patrón que ha motivado el aviso: si el operador no entiende el razonamiento, la próxima vez no se fiará de la herramienta. Deja también que los usuarios marquen los falsos positivos. Es una cortesía y una forma de mejorar el modelo. Las puntuaciones de confianza importan por la misma razón: indican a quien lee la recomendación cuánto peso darle cuando nadie está obligado a seguirla.
Una vez vista la validación, pasemos a cómo hacer que el esquema sea extensible.
Extensibilidad, polimorfismo y migraciones#
Los productos que sirven de Fuente de Verdad abarcan todo un espectro. En un extremo están los que incorporan modelos con criterios de diseño ya definidos, como NetBox o Nautobot. Se despliegan rápido porque las decisiones ya están tomadas, pero dan quebraderos de cabeza si tu red no encaja en el molde. En el otro extremo están los modelos totalmente a medida, como los de Infrahub, donde tú defines el esquema. Encajan a la perfección, sin campos de sobra, pero a cambio tienes que dedicar tiempo al diseño, avanzar por ensayo y error y trabajar sin un modelo ajeno que puedas copiar. Por eso, incluso los productos pensados para crear modelos a medida incluyen modelos predefinidos que sirven de punto de partida.
Empieza con un modelo que ya incorpore decisiones de diseño. Me da igual lo especial que creas que es tu red. Los equipos que se propusieron crear su propio modelo perfecto siguen modelando dos años después. Los que adoptaron un modelo existente pusieron en producción algo válido hace meses. Probablemente no estés construyendo una nube a hiperescala. Aprovecha lo que ya existe, amplíalo cuando encuentres un límite real y no uno imaginario, y ponlo en producción.
Por eso, la extensibilidad es lo que debe guiar tu decisión. Si para registrar un nuevo campo «centro de costes» tienes que rehacer el esquema, descarta la herramienta. Si puedes añadirlo como atributo personalizado en veinte minutos, has dado con la herramienta adecuada. Aspira a estandarizar el 80 % y deja un 20 % de margen para las particularidades de tu red. Tómate la expresión «infinitamente flexible» como una advertencia: suele significar que tendrás que configurar infinidad de cosas antes de que funcione algo.
Muchos modelos de datos se parecen sin ser idénticos. Eso te deja dos opciones evidentes, ambas malas: sobrecargar un modelo con campos que solo se aplican a algunos de sus objetos o crear varios modelos específicos que luego cuesta relacionar. La salida es el polimorfismo: un modelo con múltiples variantes.
No todas las interfaces son iguales. Un puerto óptico físico y una interfaz de túnel comparten algunas propiedades, pero funcionan de formas muy distintas. Podrías crear modelos totalmente independientes para cada uno, pero enseguida se complican las cosas y los modelos resultan más difíciles de usar.
Es mejor definir un modelo base que recoja lo que tienen en común y crear después variantes especializadas para los detalles que los distinguen.
# All interfaces share these basics
interfaces:
  - name: "eth0"
    type: "physical"
    enabled: true
    mtu: 1500
    ipv4_address: "192.0.2.1/24"

# But a physical optical port has extra stuff
  - name: "eth49"
    type: "physical_optical"
    enabled: true
    mtu: 1500
    ipv4_address: "192.0.2.5/30"
    optics_module: "100GBASE-LR4"
    wavelength_nm: 1310
    fec: "rs-fec"

# And a tunnel looks totally different under the covers
  - name: "tun-vpn-dallas"
    type: "tunnel_gre"
    enabled: true
    mtu: 1476
    ipv4_address: "10.0.0.1/30"
    tunnel_source: "203.0.113.1"
    tunnel_destination: "198.51.100.5"
    tunnel_encap: "GRE"
tunnel_key: 100Así, tus scripts pueden consultar «todas las interfaces de este dispositivo» sin tener que distinguir entre puertos ópticos y túneles, porque ambos comparten los mismos campos básicos. Cuando necesites detalles propios de un puerto óptico (el tipo de módulo óptico previsto y el modo FEC), podrás consultar los campos especializados. ¿Más adelante necesitas añadir un nuevo tipo de interfaz? Basta con añadir otra variante.
Por último, la extensibilidad también se aplica al ciclo de vida de los propios modelos. Los modelos cambian, así que tenlo previsto.
Las redes duran décadas. Tu modelo no permanecerá estático. Añadirás campos, cambiarás las relaciones entre los elementos y marcarás como obsoleto lo que haya dejado de funcionar. Pero no puedes hacer el cambio de golpe y dejar fuera de servicio todo lo que depende del esquema anterior.
Cuando cambia tu modelo, pueden fallar muchos de los componentes que dependen de él. Los validadores necesitan reglas nuevas, las API cambian los datos que devuelven, las consultas a la base de datos dan por hecho que existen ciertas columnas, las plantillas necesitan rutas diferentes para acceder a los campos y los informes se basan en la estructura anterior. Todo eso debe adaptarse o, como mínimo, seguir funcionando sin fallos graves. Así puedes gestionar los cambios sin provocar una avería:
Marca los elementos como obsoletos antes de eliminarlos. Si vas a retirar un campo, avisa a todos con dos o tres versiones de antelación. Dales un plazo para migrar.
Admite alias de campos durante la transición. ¿El código antiguo solicita
device_name? Redirige la consulta internamente ahostname. Tu API seguirá funcionando y los usuarios tendrán tiempo de actualizar su automatización.Crea herramientas de ayuda para la migración. Cuando reestructures los datos (por ejemplo, si pasas de una lista plana de interfaces a agruparlas bajo sus respectivos dispositivos), proporciona scripts que se encarguen del trabajo repetitivo.
Haz pruebas con todo lo que dependa de tus datos. Antes de desplegar cambios en el esquema, comprueba lo siguiente:
- ¿Sigue devolviendo la API los datos como antes gracias a los alias?
- ¿Siguen los adaptadores del Ejecutor generando la configuración a partir de las plantillas? Cada adaptador declara qué versiones del esquema acepta, y sus pruebas de contrato responden a esta pregunta antes del despliegue (capítulo 6).
- ¿Siguen funcionando las consultas SQL?
- ¿Siguen interpretando correctamente los datos que reciben las integraciones con sistemas externos?
Cuenta con que durante un tiempo convivirán varias versiones en producción. En las grandes organizaciones es habitual que haya dispositivos con tres versiones distintas del esquema a la vez:
150 devices on schema 1.9 (old)
300 devices on schema 2.0 (current)
50 devices on schema 2.1 (beta testing)
Tu sistema tiene que admitir las tres versiones sin fallar. Esa complejidad merece la pena: las redes son demasiado importantes como para dejarlas fuera de servicio por un cambio de esquema poco cuidadoso.
La estructura de los datos es fundamental para gestionarlos, pero tarde o temprano tendrás que almacenarlos de forma persistente. El capítulo 5 retoma el tema en ese punto. Antes hay que responder a una pregunta que determina qué aspecto tendrán tus datos el primer día: ¿de dónde los sacas cuando la red ya existe?
Incorporación de redes brownfield#
Cuando despliegas una Fuente de Verdad en una red existente, te enfrentas a un problema delicado: ¿cómo la cargas con el estado actual sin convertir todo lo que la red ha ido arrastrando durante años en una verdad permanente?
El enfoque equivocado: consulta tus dispositivos y da por hecho que «lo que está en ejecución = lo que debería estarlo». Cargarás todos los apaños, los parches improvisados y la deuda técnica directamente en la Fuente de Verdad.
El enfoque correcto: toma el estado actual de la red como punto de partida, sin darlo por bueno. Captura una instantánea, cárgala en la Fuente de Verdad y revisa el diseño hasta que describa lo que realmente quieres. A partir de entonces, la Fuente de Verdad marca el rumbo y la red lo sigue.
El proceso consta de cuatro pasos:
Carga inicial: toma una instantánea de tu red actual (dispositivos, direcciones IP, VLAN y circuitos) y cárgala en la Fuente de Verdad como datos de partida. Puedes utilizar el estado registrado en una base de datos de gestión de la configuración (CMDB) si sus datos reflejan fielmente la realidad (algo que todavía no he visto con mis propios ojos).
Rediseña: durante las semanas y los meses siguientes, pide al equipo que revise esos datos y decida cuál debería ser el estado deseado. Probablemente quieras consolidar las VLAN redundantes, eliminar elementos heredados que ya no sirven, unificar los criterios de nomenclatura y escribir las plantillas de diseño para futuros despliegues.
Invierte el sentido de la sincronización: cuando tengas el diseño que quieres, deja de sincronizar los datos desde la red hacia la Fuente de Verdad. Ahora manda la Fuente de Verdad. La Ejecución (capítulo 6) envía los cambios a la red.
Detecta las desviaciones: la Observabilidad (capítulo 7) vigila si algún dispositivo se desvía del estado que establece la Fuente de Verdad. Cuando se produce una desviación, los operadores deciden: ¿hay que corregir el dispositivo o la Fuente de Verdad?
No tienes que escribir todo esto desde cero. La mayoría de los productos de SoT incluyen herramientas de descubrimiento e incorporación, y también las hay independientes. Usa una de ellas en lugar de escribir tú el analizador.
Este enfoque exige un esfuerzo inicial, pero evita la trampa de tomar el estado desplegado como verdad permanente. Tu SoT va reflejando cada vez mejor la intención del diseño, ya depurada, aunque la red tarde en ajustarse del todo. También puedes seguir ejecutando el descubrimiento en modo de simulación para volver a comprobar que la red no se ha desviado.
Ahora bien, ten claro qué te aporta la instantánea. Te da un punto de partida. No hace nada para que los datos sigan siendo correctos seis meses después, cuando alguien reasigna una dirección durante una incidencia y no avisa a nadie. Mantener la intención y la realidad alineadas después de la puesta en producción es la conciliación, y el capítulo 5 explica cómo llevarla a cabo.
Una vez modelados, validados y cargados los datos, merece la pena ver cómo funcionan ambas capas en una misma red real, hasta el momento en que el Ejecutor recibe los datos.
Ejemplo de implementación#
Volvamos a la red de campus del capítulo 3: unos 800 switches de acceso y distribución de tres fabricantes distintos, repartidos entre seis edificios, de la A a la F. Esta red recibe un flujo constante de solicitudes de servicio para crear VLAN, asignar subredes, actualizar políticas de enrutamiento y modificar controles de acceso.
Hoy, el único registro completo de esta red es la propia red. La configuración que realmente está desplegada se reparte entre los 800 switches, sin una visión de conjunto. El resto está en hojas de cálculo y en la cabeza de la gente.
El problema. Cuando el equipo de aplicaciones pide una VLAN nueva, un ingeniero busca una subred libre, averigua qué switches hay en el edificio en cuestión y abre unas cuantas sesiones de Secure Shell (SSH) para ver qué VLAN existen ya allí. En ningún sitio queda registrado cuál debería ser el estado de cada switch, así que la desviación de la configuración se acumula sin que nadie lo advierta. Añadir un diseño para un nuevo fabricante exige modificar la documentación en varios sitios y confiar en que las distintas versiones sigan siendo coherentes entre sí.
Requisitos:
- Permitir que quien solicita el servicio describa el servicio sin tener que especificar la implementación: ni identificadores de VLAN, ni prefijos, ni listas de switches
- Deducir todos los valores técnicos de esa descripción para que no haya ningún campo en el que un operador pueda introducir uno de esos valores de forma incorrecta
- Validar la estructura una sola vez, en el punto de escritura, sin repetir la validación en cada componente que consuma los datos después
- Mantener la capa técnica independiente del fabricante, de modo que incorporar una nueva plataforma solo requiera un nuevo adaptador del Ejecutor y se pueda conservar el mismo modelo
- Registrar por separado el estado deseado y el desplegado, y poder compararlos
El enfoque. Añade una Fuente de Verdad y haz una única importación inicial siguiendo los pasos de la incorporación de redes brownfield: carga los edificios, los switches con sus funciones y plataformas, y las VLAN y los prefijos que ya estén en uso. A partir de ahí, la SoT contiene el modelo de la red: las definiciones de VLAN, los patrones de diseño de las capas de acceso y distribución, y el modelo de solicitudes de servicio que convierte cada solicitud en los objetos técnicos que necesita el Ejecutor.
Empieza con un solo sistema, y hazlo a propósito. En un campus real, parte de esos datos ya tiene un responsable en otro sistema, como ocurre con las direcciones que gestiona un IPAM. Reunir en una sola vista los datos de esos distintos responsables es la federación. El capítulo 5 incorpora la federación a este mismo campus.
Este ejemplo omite a propósito los nombres de productos. Varios productos podrían desempeñar cada función, y citarlos haría que el capítulo se quedase anticuado antes de que esos nombres te resultaran de ayuda. Lo que puedes trasladar a otras redes es la estructura de la solución: qué datos corresponden a cada capa y qué aspecto tienen esas capas cuando detrás hay una red real. El capítulo 5 retoma este mismo campus para explicar el resto de la arquitectura.
Sigamos una solicitud real que la Fuente de Verdad tiene que implementar y veamos los datos concretos de cada paso. Es una solicitud corriente: el equipo de aplicaciones quiere una VLAN nueva llamada app-payments en el edificio B.
El recorrido de una solicitud por las capas#
La capa de servicio: qué introduce el operador
Esto es todo lo que introduce el operador:
vlan_service:
  name: app-payments
  building: B
profile: standardTres campos. Ni un identificador de VLAN, ni un prefijo, ni una lista de switches. Todos esos valores se pueden deducir, y cualquier valor que puedas deducir es un valor que el operador podría introducir mal.
Puedes deducirlos gracias a un conjunto de reglas de expansión (transformaciones) que solo tienes que escribir una vez:
profiles:
  - name: standard
    mask_length: 24
    qos_class: af21
    mtu: 9216
    applies_to_roles: [access, distribution]
  - name: high-security
    mask_length: 26
    qos_class: af31
    mtu: 9216
    applies_to_roles: [access]
requires_acl: trueA esto se suman las reglas que utilizan esos perfiles. El nombre del servicio debe ajustarse a ^[a-z][a-z0-9-]{2,15}$. El identificador de VLAN es el siguiente que esté libre en el rango reservado para ese edificio. El prefijo se extrae de la superred del edificio con la longitud de máscara que indica el perfil. El servicio se aplica a todos los switches del edificio cuya función figure en applies_to_roles.
Fíjate en lo que ganas además de brevedad. El operador no tiene ningún campo en el que pueda introducir un /26 para un servicio estándar, porque la máscara viene del perfil. Este es un ejemplo concreto de la protección que obtienes sin esfuerzo adicional, como vimos en la sección Capa de servicio.
La capa técnica: qué produce la expansión
El Listado 4.7 muestra el registro que generan las reglas a partir de los tres campos de entrada.
vlans:
  - name: app-payments
    vlan_id: 412
    building: B
    prefix: 10.12.4.0/24
    qos_class: af21
    mtu: 9216
    gateway:
      address: 10.12.4.1
      mask: 24
    switches:
      - { name: sw-b-acc-01, role: access,       platform: vendor-a }
      - { name: sw-b-acc-02, role: access,       platform: vendor-a }
- { name: sw-b-dst-01, role: distribution, platform: vendor-b }Este registro es independiente del fabricante por diseño. El campo platform indica de qué fabricante es cada conmutador, pero ningún detalle sobre cómo expresa ese fabricante una VLAN se filtra a esta capa. Así se cumple la regla de la sección Capa técnica: el mismo registro expandido debe seguir sirviendo aunque cambies de fabricante. El listado muestra tres conmutadores del edificio B que utilizan dos de las tres plataformas del campus. Un conmutador del fabricante C se incorpora al mismo registro con un valor distinto en platform, sin que cambie nada más.
Para que estos listados sean breves, el campus del ejemplo solo utiliza IPv4. En un campus de doble pila, casi todo se mantiene igual. El prefijo y la puerta de enlace pasan a ser listas (una entrada por familia de direcciones) y el perfil incorpora una segunda longitud de máscara. Los prefijos se asignan a partir de la superred del edificio, y las reglas, el esquema y las plantillas recorren ambas familias, IPv4 e IPv6. Esta es la consecuencia de tratar la familia de direcciones como un atributo del prefijo en vez de crear un modelo aparte: para desplegar IPv6 basta con cambiar los datos, sin necesidad de migrar el esquema.
El traspaso: qué recibe el Ejecutor
La Intención llega hasta el Listado 4.7. Ningún paso de este capítulo la convierte en artefactos de configuración que se puedan aplicar a los dispositivos. Esa es la función del Ejecutor, que toma los datos de la capa técnica, independientes del fabricante, y los adapta a cada plataforma (genera la configuración a partir de plantillas o traduce los datos). El capítulo 6 desarrolla esta idea con ejemplos de ambos casos: una plantilla del adaptador del fabricante B genera la configuración del conmutador de distribución a partir de esos datos, y el adaptador del fabricante C los traduce mediante un módulo. Este desacoplamiento delimita la responsabilidad de cada bloque. Para incorporar un fabricante o una plataforma nuevos solo necesitas el adaptador adecuado, sin tener que crear otro modelo de datos.
Así se completa el recorrido de los datos en la escritura, desde los tres campos que rellenó el operador hasta el registro con el que trabaja cada adaptador. Queda una pregunta: ¿qué parte de ese registro puede proteger realmente el esquema?
Qué detecta el esquema y qué se le escapa#
El objeto que representa el servicio de VLAN tiene su propio esquema, que hace referencia a los elementos reutilizables en vez de copiarlos:
{
  "$id": "https://example.net/schemas/vlan-service.json",
  "title": "VlanService",
  "type": "object",
  "required": ["name", "vlan_id", "building", "prefix", "gateway"],
  "additionalProperties": false,
  "properties": {
    "name":      { "type": "string", "pattern": "^[a-z][a-z0-9-]{2,15}$" },
    "vlan_id":   { "type": "integer", "minimum": 1, "maximum": 4094 },
    "building":  { "type": "string" },
    "qos_class": { "type": "string", "enum": ["af21", "af31", "ef"] },
    "mtu":       { "type": "integer", "minimum": 1280, "maximum": 9216 },
    "prefix":    { "$ref": "prefix.json" },
    "gateway":   { "$ref": "ip-address.json" },
    "switches":  { "type": "array", "items": { "$ref": "device-ref.json" } }
  }
}El modelo ip-address.json se define una sola vez. Tanto este esquema como los vecinos BGP, los extremos de túnel y las direcciones de gestión de los dispositivos hacen referencia a él. En eso consiste la reutilización: tienes una única definición de lo que es una dirección y un solo lugar donde consultar en qué sitios se utiliza una dirección concreta. El modelo device-ref.json cumple la misma función para las referencias a los conmutadores.
Fíjate en lo que el esquema no menciona. La declaración additionalProperties: false hace que el esquema rechace cualquier campo que no figure en él. Por eso _version y _metadata, los campos que el almacén de datos añade a cada registro, deben quedar fuera del documento que se valida. El capítulo 5 muestra esos campos en el objeto almacenado. El almacén de datos los escribe y quien haya definido la intención no puede hacerlo. Mantenerlos fuera del esquema impide que un cliente los falsifique.
Lo más ilustrativo es lo que este esquema no puede expresar. Rechazará vlan_id: 5000 y el nombre App_Payments, pero se le escaparán estos tres casos:
- que la VLAN 412 ya esté en uso en el edificio B
- que
10.12.4.0/24quede fuera de la superred del edificio B - que la puerta de enlace sea
10.12.5.1, una dirección válida que queda fuera del prefijo de este servicio
Estas son las comprobaciones semánticas que vimos en Estructura de los datos. Para decidir si un valor es válido, cada una necesita consultar otros registros. El esquema se encarga de la validación estructural y las reglas propias de la SoT se encargan de la validación semántica. Son estas últimas las que evitan las interrupciones del servicio.
Fíjate en cuál de las dos categorías encaja el caso del principio del capítulo. Un identificador de VLAN de 4192 y una dirección como 10.2.30.283 son errores del primer tipo. El esquema rechaza ambos valores en cuanto alguien intenta guardarlos. Los analizadores de tres conmutadores tuvieron que hacer ese trabajo solo porque ninguno de los dos campos tenía un tipo definido. Los tres casos que acabamos de ver son del segundo tipo. No son más difíciles de expresar, pero la SoT tiene que consultar el resto de los datos antes de poder decirte que no. Eso exige una decisión de diseño, no una línea en el esquema.
Primeros pasos#
Leer sobre los datos de intención es fácil. La gente suele atascarse en la primera semana de modelado, porque normalmente hay que tomar todas las decisiones de diseño a la vez. Las decisiones sobre los datos se reducen a tres pasos.
Elige los objetos que necesitas. Parte de las configuraciones de tus dispositivos y recorre el camino a la inversa: cada valor que varía de un dispositivo a otro tiene que salir de algún sitio, y ese sitio es un objeto de tu modelo. Para la mayoría de las redes, un conjunto inicial razonable de objetos es el siguiente: dispositivo, sede, prefijo, VLAN, circuito y política. Lo que no varía también es un dato. Guárdalo en la intención como un único valor global y evita fijarlo en las plantillas del Ejecutor. Estas solo deben contener la lógica que convierte los datos a la sintaxis del fabricante.
Modela los objetos, pero no empieces de cero. Ya existen buenos modelos de red. Adopta uno y adáptalo. Para cada objeto, define tres cosas: qué contiene (campos, tipos y campos obligatorios), cómo se relaciona con los demás (referencias y relaciones de pertenencia) y qué hace que un valor no sea válido. Revisarás los tres aspectos, así que el esquema debe ser extensible desde el primer día.
Elige el nivel de abstracción del punto de entrada. Puedes dejar la capa de servicio para más adelante, pero decide pronto si tienes previsto incorporarla, porque esa decisión condiciona el modelo técnico sobre el que se apoya. Los equipos que añaden la abstracción a posteriori suelen descubrir que su capa técnica ya incorpora supuestos que ahora dificultan esa abstracción.
Si empiezas en una red brownfield, como hace casi todo el mundo, toma primero una instantánea de su estado actual. La sección Incorporación de una red brownfield explica por qué esa instantánea es un punto de partida y no la verdad.
Con esos tres pasos puedes empezar a modelar. Les siguen otros tres, todos relacionados con el sistema que rodea a los datos: cómo se accede a ellos, quién es responsable de cada valor y cómo hacer que algo real dependa de esos datos. El capítulo 5 desarrolla estos pasos y cierra el ejemplo del campus con la arquitectura que resulta de todo ello.
Resumen#
La calidad de tu automatización dependerá de la calidad de tus datos. Este capítulo presenta la Intención y las dos capas de abstracción que puede ofrecer (la capa de servicio, de nivel superior, y la capa técnica, de nivel inferior), y explica cuándo utilizar cada una. La capa de servicio ofrece un modelo de datos más sencillo para las integraciones externas, y la capa técnica proporciona a los bloques internos el detalle que necesitan.
En cualquier caso, hay un principio fundamental: los datos de la Intención deben ser independientes de las plataformas de tu red, y los datos específicos de una plataforma deben identificarse expresamente como excepciones. Debes evitar quedar atado a un fabricante y conservar la definición de cómo es tu red, dejando los detalles de cada plataforma en manos del bloque Ejecutor. Así, las responsabilidades quedan mejor delimitadas y resulta más sencillo hacer evolucionar el sistema.
Sea cual sea el modelo de datos de cada capa, los datos deben ser fiables. Para ello hace falta una estructura de los datos que defina el esquema como un contrato que mantiene los datos limpios.
El capítulo 5 aborda las funciones de la Fuente de Verdad y se centra en cómo guardar los cambios de forma persistente, cómo consumir los datos y cómo integrar varias fuentes de datos de forma coherente.
Referencias#
- Network Programmability and Automation, 2nd Edition, Matt Oswalt, Christian Adell, Scott S. Lowe y Jason Edelman (O’Reilly, 2023). Explica cómo los datos de la Fuente de Verdad determinan la configuración.
- Network Programmability with YANG, Benoit Claise, Joe Clarke y Jan Lindblad (Addison-Wesley, 2019). La obra de referencia sobre los modelos YANG del IETF y de OpenConfig.
💬 ¿Has encontrado algo que se pueda mejorar? Enviar comentarios sobre este capítulo